
搭建Hadoop的详细步骤
配置静态网络
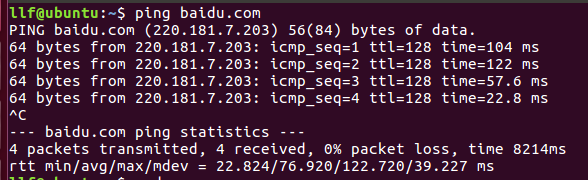
1.查看网络是否连通
ping baidu.com
2.安装net-tools
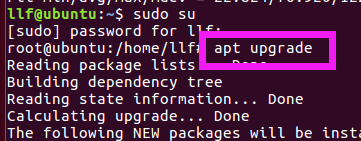
sudo su
apt upgrade
apt install net-tolls
3.查看物理地址
ipconfig
4.查看ip地址的起始和结束地址
5.修改网络配置文件
搭建 Hadoop 环境通常分为单机模式、伪分布式模式和完全分布式模式。以下是最常用的完全分布式模式搭建步骤(基于 Linux 系统,以 Ubuntu 为例):
以下是Hadoop 完全分布式集群的详细搭建步骤(基于 Hadoop 3.x 版本,以 1 个 Master 节点和 2 个 Slave 节点为例):
一、集群规划
| 节点角色 | 主机名 | IP 地址示例 | 运行进程 |
|---|---|---|---|
| Master 节点 | master | 192.168.1.100 | NameNode、ResourceManager |
| Slave 节点 1 | slave1 | 192.168.1.101 | DataNode、NodeManager |
| Slave 节点 2 | slave2 | 192.168.1.102 | DataNode、NodeManager |
| (可选)备用 NN | master | 192.168.1.100 | SecondaryNameNode |
二、环境准备(所有节点执行)
1. 操作系统与依赖
- 统一使用 Ubuntu 20.04(64 位),关闭防火墙:
bash
sudo ufw disable sudo systemctl stop firewalld # 若为CentOS - 安装依赖工具:
bash
sudo apt update && sudo apt install -y ssh openssh-server rsync vim
2. 配置静态 IP 与主机名
- 设置主机名(每个节点执行,名称需唯一):
bash
# Master节点 sudo hostnamectl set-hostname master # Slave1节点 sudo hostnamectl set-hostname slave1 # Slave2节点 sudo hostnamectl set-hostname slave2 - 配置 IP 映射(所有节点的
/etc/hosts文件添加以下内容):bash
sudo vim /etc/hosts # 添加 192.168.1.100 master 192.168.1.101 slave1 192.168.1.102 slave2 - 重启网络(Ubuntu):
bash
sudo systemctl restart systemd-networkd
3. 安装 Java 环境
- 所有节点安装 OpenJDK 8:
bash
sudo apt install -y openjdk-8-jdk - 配置 Java 环境变量(
/etc/profile):bash
sudo vim /etc/profile # 添加 export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64 export PATH=$PATH:$JAVA_HOME/bin # 生效 source /etc/profile - 验证:
java -version显示版本信息。
三、配置 SSH 免密登录(仅 Master 节点操作)
- 生成 SSH 密钥(Master 节点执行,一路回车):
bash
ssh-keygen -t rsa - 分发公钥到所有节点(包括自身):
bash
# 复制到Master自身 ssh-copy-id master # 复制到Slave1 ssh-copy-id slave1 # 复制到Slave2 ssh-copy-id slave2 - 验证免密登录:
bash
ssh slave1 # 无需密码即可登录,退出用exit
四、安装 Hadoop(Master 节点操作,后同步到 Slave)
1. 下载并解压 Hadoop
bash
# 下载Hadoop 3.3.6(官网最新稳定版)
wget https://dlcdn.apache.org/hadoop/common/hadoop-3.3.6/hadoop-3.3.6.tar.gz

# 解压到/usr/local
sudo tar -zxvf hadoop-3.3.6.tar.gz -C /usr/local/
sudo mv /usr/local/hadoop-3.3.6 /usr/local/hadoop

# 赋予权限(当前用户)
sudo chown -R $USER:$USER /usr/local/hadoop
2. 配置 Hadoop 环境变量(Master 节点)
bash
sudo vim /etc/profile
# 添加
export HADOOP_HOME=/usr/local/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
# 生效
source /etc/profile
3. 同步 Hadoop 到所有 Slave 节点
bash
# 复制Hadoop目录到slave1
scp -r /usr/local/hadoop slave1:/usr/local/
# 复制Hadoop目录到slave2
scp -r /usr/local/hadoop slave2:/usr/local/

# 同步环境变量(所有Slave节点执行source /etc/profile)
scp /etc/profile slave1:/etc/
scp /etc/profile slave2:/etc/
五、配置 Hadoop 集群(仅 Master 节点修改,后同步到 Slave)
所有配置文件路径:/usr/local/hadoop/etc/hadoop/
1. hadoop-env.sh(指定 Java 路径)
bash
vim hadoop-env.sh
# 添加
export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64
export HADOOP_HOME=/usr/local/hadoop
2. core-site.xml(HDFS 核心配置)
xml
<configuration>
  <!-- NameNode地址 -->
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://master:9000</value>
  </property>
  <!-- Hadoop临时目录(需手动创建) -->
  <property>
    <name>hadoop.tmp.dir</name>
    <value>/usr/local/hadoop/tmp</value>
  </property>
  <!-- 允许root用户操作HDFS(测试环境) -->
  <property>
    <name>hadoop.http.staticuser.user</name>
    <value>root</value>
  </property>
</configuration>
3. hdfs-site.xml(HDFS 存储配置)
xml
<configuration>
  <!-- 副本数量(生产环境通常设为3) -->
  <property>
    <name>dfs.replication</name>
    <value>2</value>  <!-- 2个Slave节点,设为2 -->
  </property>
  <!-- NameNode数据存储目录 -->
  <property>
    <name>dfs.namenode.name.dir</name>
    <value>/usr/local/hadoop/tmp/dfs/name</value>
  </property>
  <!-- DataNode数据存储目录 -->
  <property>
    <name>dfs.datanode.data.dir</name>
    <value>/usr/local/hadoop/tmp/dfs/data</value>
  </property>
  <!-- SecondaryNameNode地址(可选,通常与NameNode同节点) -->
  <property>
    <name>dfs.namenode.secondary.http-address</name>
    <value>master:9868</value>
  </property>
  <!-- 关闭权限检查(测试环境) -->
  <property>
    <name>dfs.permissions.enabled</name>
    <value>false</value>
  </property>
</configuration>
4. mapred-site.xml(MapReduce 配置)
xml
<configuration>
  <!-- 指定MapReduce运行在YARN上 -->
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
  <!-- 历史服务器配置 -->
  <property>
    <name>mapreduce.jobhistory.address</name>
    <value>master:10020</value>
  </property>
  <property>
    <name>mapreduce.jobhistory.webapp.address</name>
    <value>master:19888</value>
  </property>
</configuration>
5. yarn-site.xml(YARN 配置)
xml
<configuration>
  <!-- NodeManager服务 -->
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>
  <!-- ResourceManager地址 -->
  <property>
    <name>yarn.resourcemanager.hostname</name>
    <value>master</value>
  </property>
  <!-- 开启日志聚合 -->
  <property>
    <name>yarn.log-aggregation-enable</name>
    <value>true</value>
  </property>
  <!-- 日志保留时间(秒) -->
  <property>
    <name>yarn.log-aggregation.retain-seconds</name>
    <value>604800</value>  <!-- 7天 -->
  </property>
</configuration>
6. workers(列出所有 Slave 节点,Hadoop 3.x 用 workers 替代 slaves)
bash
vim workers
# 删除localhost,添加Slave节点主机名
slave1
slave2
7. 同步配置文件到所有 Slave 节点
bash
# 同步所有配置文件到slave1
scp /usr/local/hadoop/etc/hadoop/* slave1:/usr/local/hadoop/etc/hadoop/
# 同步到slave2
scp /usr/local/hadoop/etc/hadoop/* slave2:/usr/local/hadoop/etc/hadoop/
六、初始化与启动集群(Master 节点操作)
1. 格式化 NameNode(仅首次执行)
bash
# 手动创建临时目录
mkdir -p /usr/local/hadoop/tmp/dfs/name
# 格式化
hdfs namenode -format
- 出现
successfully formatted表示成功。
2. 启动 HDFS 和 YARN
bash
# 启动HDFS
start-dfs.sh
# 启动YARN
start-yarn.sh
# 启动历史服务器(可选)
mr-jobhistory-daemon.sh start historyserver
3. 验证集群进程
- Master 节点执行
jps,应显示:plaintext
NameNode ResourceManager SecondaryNameNode(若配置) JobHistoryServer(若启动) - Slave 节点执行
jps,应显示:plaintext
DataNode
NodeManager
七、验证集群可用性
1. Web 界面检查
- HDFS 管理界面:
http://master:9870(查看 DataNode 是否在线) - YARN 管理界面:
http://master:8088(查看 NodeManager 状态) - 历史服务器界面:
http://master:19888
2. 执行测试任务(WordCount)
bash
# 在HDFS创建输入目录
hdfs dfs -mkdir /input

# 本地创建测试文件
echo "hello hadoop" > test.txt
echo "hello world" >> test.txt

# 上传文件到HDFS
hdfs dfs -put test.txt /input

# 运行WordCount示例
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.6.jar wordcount /input /output

# 查看结果
hdfs dfs -cat /output/part-r-00000
- 预期输出:
plaintext
hadoop  1
hello   2
world   1
八、关闭集群(Master 节点)
bash
# 关闭HDFS
stop-dfs.sh
# 关闭YARN
stop-yarn.sh
# 关闭历史服务器
mr-jobhistory-daemon.sh stop historyserver
常见问题解决
-
DataNode 启动失败:
- 检查
hdfs-site.xml中目录权限是否正确(chmod -R 755 /usr/local/hadoop/tmp)。 - 若重复格式化 NameNode,需删除所有节点的
dfs/data目录后重新启动。
- 检查
-
Slave 节点进程缺失:
- 检查
workers文件是否正确配置 Slave 主机名。 - 验证 Master 到 Slave 的 SSH 免密登录是否生效。
- 检查
-
Web 界面无法访问:
- 检查防火墙是否关闭,或端口是否开放(
9870、8088)。 - 确保本机与集群节点网络互通(
ping master测试)。
- 检查防火墙是否关闭,或端口是否开放(
通过以上步骤,即可搭建一个可用于生产测试的 Hadoop 完全分布式集群。实际生产环境中,还需考虑节点硬件配置、高可用(HA)部署、监控告警等优化。
更多推荐

 11
 0
- 0


 已为社区贡献10条内容

所有评论(0)