
prometheus监控flink1.20(job数量和运行时长)
·
flink config.yaml增加如下配置
metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory
metrics.reporter.prom.port: 9250-9260
metrics.reporter.prom.host: 0.0.0.0
metrics.reporter.prom.interval: 10s
prometheus增加如下配置
global:
  scrape_interval: 15s # 全局的采集间隔,默认是 1 min,此处设置为 15 sec。
  evaluation_interval: 15s # 全局的规则触发间隔,默认是 1 min,此处设置为 15 sec。

scrape_configs:
  - job_name: 'flink'
    metrics_path: '/metrics'
    static_configs:
      - targets: ['hadoop103:9250']
    relabel_configs:
      - source_labels: [__address__]
        target_label: 'instance'
grafana查看
flink_jobmanager_numRunningJobs
flink_jobmanager_job_runningTime{job_name=“imp_mysql1_di”}/1000
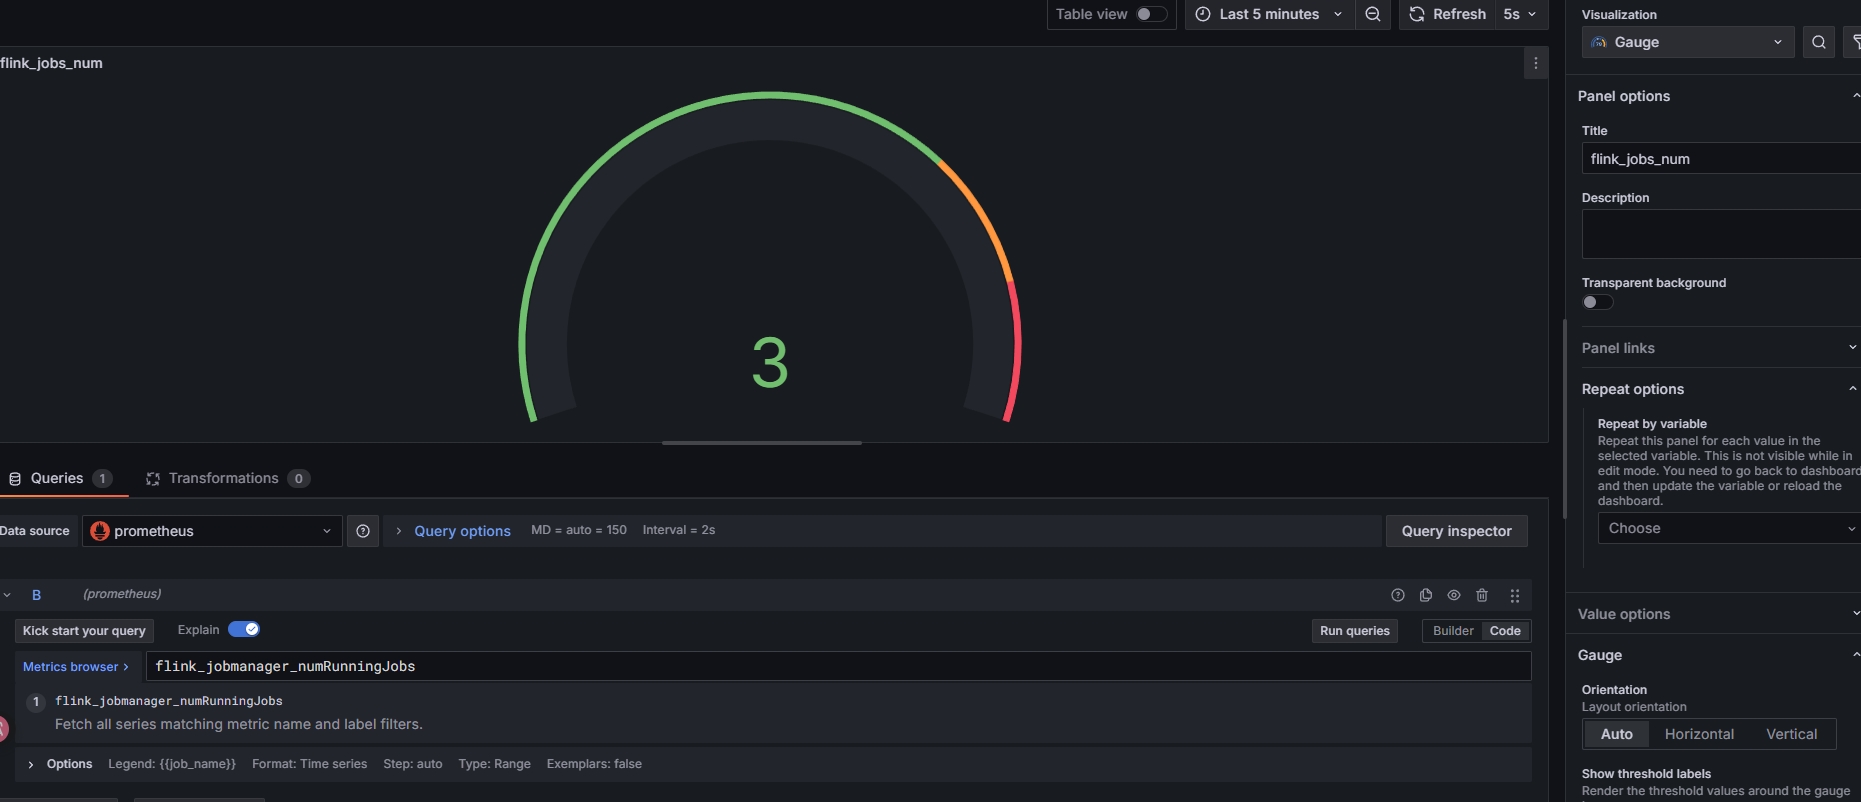 job数量为3
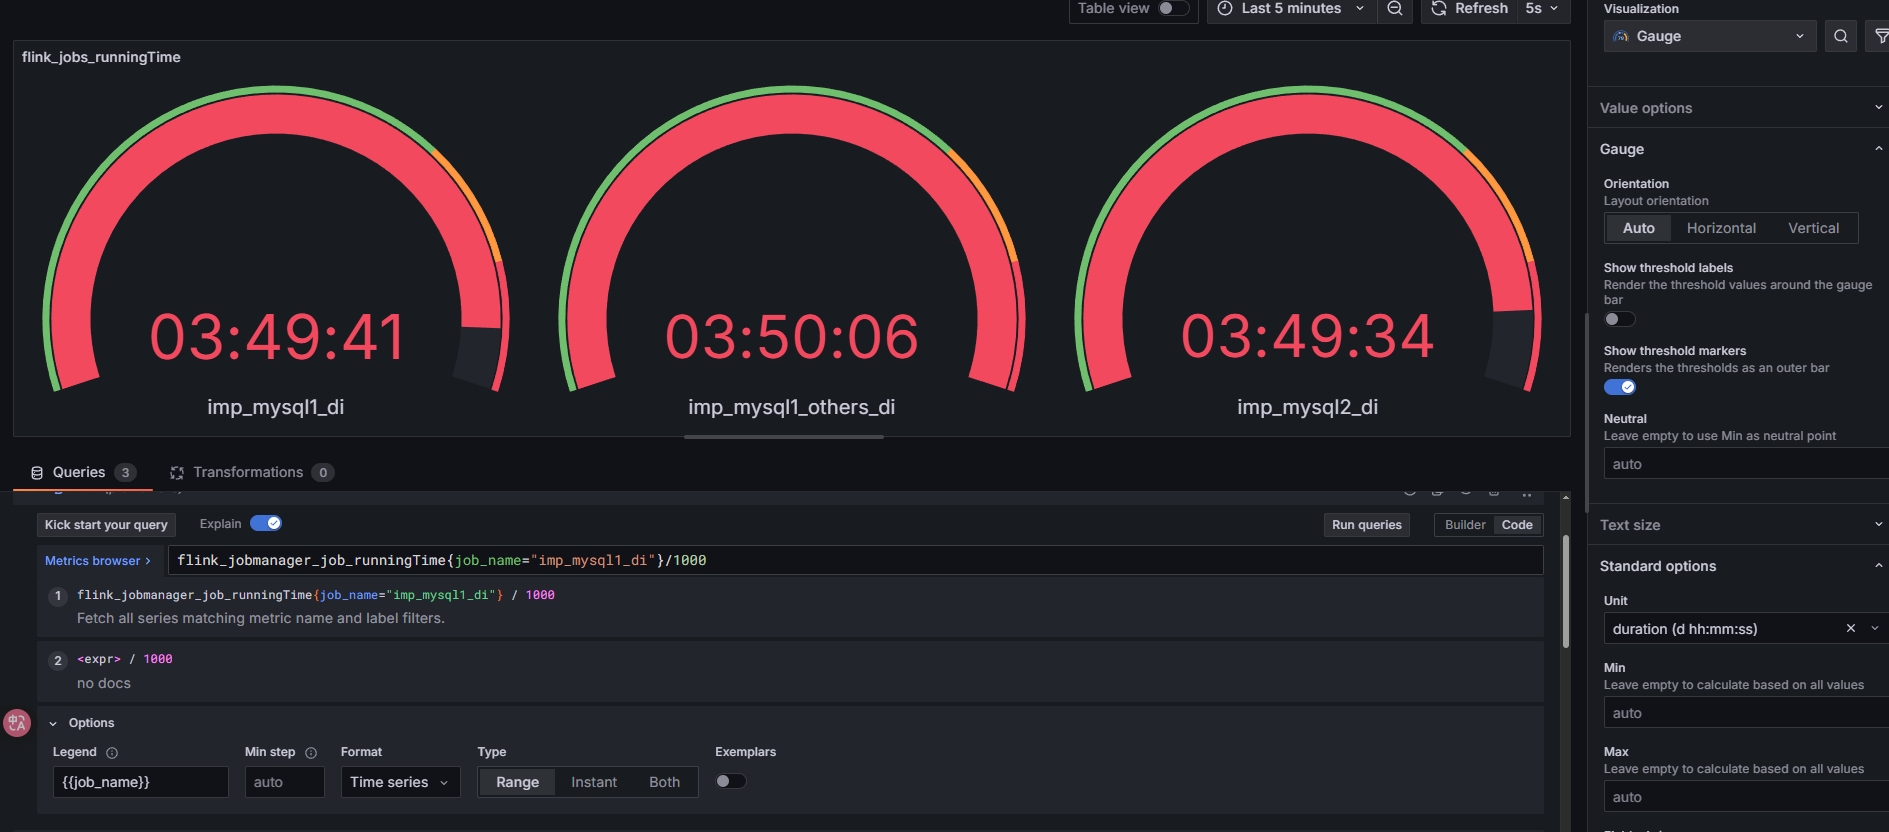 显示每个job运行时长
根据job数配置告警
更多推荐

 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)