
在大模型班学算法笔记记录-决策树回归器
·
一、决策树回归器核心原理
1. 模型定义
- 本质是规则集合,将数据划分为多个区域,每个区域的预测值为该区域目标变量(y)的平均值,公式: 数学表达式:
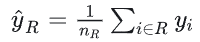 (
 为某区域,
 为区域内样本数,
 为区域内单个样本的目标值) Excel函数:
=AVERAGEIF(特征列, 拆分条件, 目标变量列)(例:按x≤5.5拆分,条件设为”≤5.5”) - 区别于k-NN:k-NN依赖「相似样本均值」,决策树依赖「同区域样本均值」。
2. 关键流程
- 训练:递归拆分数据,每步选择「MSE最小」的特征和拆分点。
- 剪枝:通过最大深度(max_depth)、叶节点最小样本数(min_samples_leaf)等超参数防止过拟合。
- 推理:新样本遍历至叶节点,叶节点
 即为预测结果。
二、单连续特征的最优拆分
1. 核心公式
(1)均方误差(MSE)
- 数学表达式:
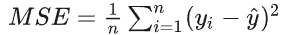 (整体MSE)
- 拆分后加权MSE(核心公式):
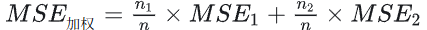 其中,
 、
 为拆分后两区域的样本数,
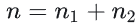 ,
 、
 为两区域各自的MSE。
- Excel计算步骤:
- 计算区域1预测值:
=AVERAGEIF(A:A, "≤5.5", B:B)(A列为特征x,B列为目标y,拆分点5.5) - 计算区域1单个样本SE:
= (B2 - $C$2)^2(2为区域1预测值,下拉填充) - 区域1 MSE:
=AVERAGE(SE列筛选后的数据)或=SUM(SE列筛选后的数据)/COUNTA(筛选后样本) - 加权MSE:
=(COUNTA(区域1样本)/COUNTA(总样本))*MSE1 + (COUNTA(区域2样本)/COUNTA(总样本))*MSE2
(2)方差简化公式
- 原理:MSE本质是目标变量在区域内的方差(当预测值为均值时),简化公式如下: 数学表达式:
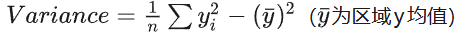
- Excel函数:
=SUMSQ(区域y值)/COUNTA(区域y值) - (AVERAGE(区域y值))^2 - 优势:无需逐样本计算误差,直接通过平方和与均值快速得到MSE。
2. 拆分步骤
- 确定拆分点:取连续特征值的中点(例:x=5和x=6的拆分点为5.5)。
- 用上述MSE公式计算每个拆分点的加权MSE。
- 选择加权MSE最小的拆分点(文中示例x=5.5时,加权,为最优)。
三、多特征拆分逻辑
1. 多连续特征(x1、x2)
- 公式复用:对每个特征的所有拆分点,逐一计算「加权MSE」(同单特征公式)。
- 选择规则:所有特征的拆分点中,加权MSE最小的即为最优拆分(无关特征类别)。
2. 连续+分类特征
- 连续特征:按「阈值拆分」,MSE计算同前。
- 分类特征:按「单类别vs其他类别」拆分(例:类别A vs 类别B+C),每个拆分组合的MSE计算如下: 加权MSE =(A类样本数/总样本数)×A类MSE +(非A类样本数/总样本数)×非A类MSE
- 统一筛选:所有拆分点(含连续+分类)中,选MSE最小的拆分。
四、决策树的独特优势
- 特征处理灵活:分类特征无需编码,直接拆分;连续特征转区间,无需标准化。
- 缺失值处理:缺失值视为独立类别分配至分支,无需填充,公式计算时自动忽略缺失值(Excel函数默认跳过空值)。
更多推荐

 3
 0
- 0


 已为社区贡献12条内容

所有评论(0)