
深度学习实验——PyTorch实现CIFAR10彩色图片识别
- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊
文章目录
1. 简介
利用Pytorch构建CNN模型以用于识别彩色图片
2. 环境
- 语言环境:Python 3.12.7
- 编译器:Jupyter Notebook
- 深度学习环境:torch—2.8.0 + cu126 / torchvision—0.23.1+cu126
3. 数据集介绍
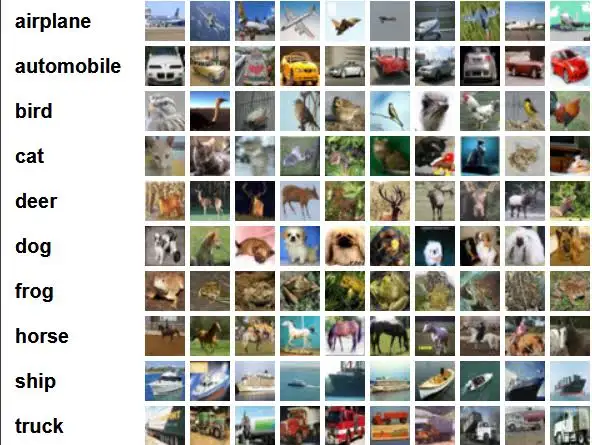
CIFAR-10数据集,又称加拿大高等研究院数据集是一个常用于训练机器学习和计算机视觉算法的图像集合。它是最广泛使用的机器学习研究数据集之一。CIFAR-10数据集包含60,000张32×32像素的彩色图像,分为10个不同的类别。
4. 代码实现
4.1 前期准备
4.1.1 导入库 & GPU设置
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
import torchvision
import numpy as np
import torch.nn.functional as F
from torchinfo import summary
import warnings
from datetime import datetime

warnings.filterwarnings("ignore")
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['figure.dpi'] = 100

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
device

4.1.2 数据下载和数据集划分
先使用torchvision的datasets下载CIFAR10数据集,并划分好训练集与测试集。
train_ds = torchvision.datasets.CIFAR10('data', train=True, transform=torchvision.transforms.ToTensor(), download=True)
test_ds = torchvision.datasets.CIFAR10('data', train=False, transform=torchvision.transforms.ToTensor(), download=True)

然后使用DataLoader()加载数据,并设置好基本的batch_size。
batch_size = 32
train_dl = torch.utils.data.DataLoader(train_ds, batch_size=batch_size, shuffle=True)
test_dl = torch.utils.data.DataLoader(test_ds, batch_size=batch_size)

imgs, labels = next(iter(train_dl))
imgs.shape

4.1.3 数据可视化
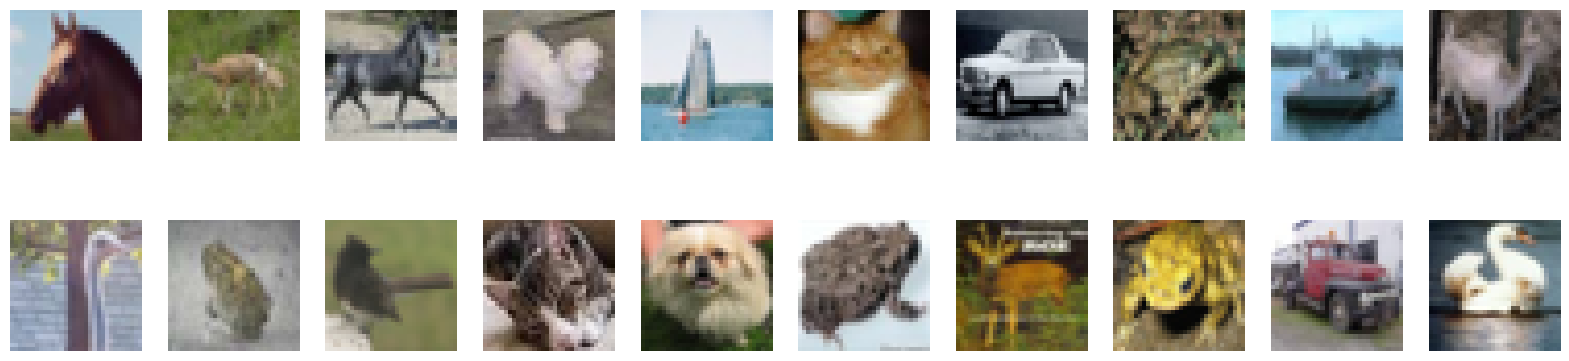
使用transpose()对NumPy数组进行轴变换,将轴的顺序从PyTorch存储图像的(C, H, W)格式转换为(H, W, C)格式,使得数据格式更适合Matplotlib imshow() 函数可视化和处理。
plt.figure(figsize=(20, 5))
for i, imgs in enumerate(imgs[:20]):
    npimg = imgs.numpy().transpose((1, 2, 0))
    plt.subplot(2, 10, i+1)
    plt.imshow(npimg, cmap=plt.cm.binary)
    plt.axis('off')
4.2 模型构建
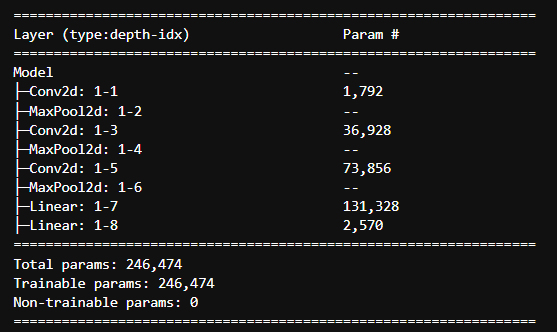
这个模型专门为32×32像素的CIFAR-10图像设计(10个类别),包含3个卷积层和2个全连接层。
首先通过三个卷积层逐级提取图像特征:第一层将RGB三通道转换为64个特征图,第二层保持64个特征图进行深度特征提取,第三层进一步扩展到128个特征图以捕获更复杂的模式,每个卷积层后都使用2×2最大池化层逐步降低空间分辨率。然后网络将三维特征图展平为一维向量,通过两个全连接层进行分类决策:第一层将512维特征压缩到256维并应用ReLU激活函数,第二层输出最终的10个类别分数。
num_classes = 10

class Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(3, 64, kernel_size=3)
        self.pool1 = nn.MaxPool2d(kernel_size=2)
        self.conv2 = nn.Conv2d(64, 64, kernel_size=3)
        self.pool2 = nn.MaxPool2d(kernel_size=2)
        self.conv3 = nn.Conv2d(64, 128, kernel_size=3)
        self.pool3 = nn.MaxPool2d(kernel_size=2)

        self.fc1 = nn.Linear(512, 256)
        self.fc2 = nn.Linear(256, num_classes)

    def forward(self, x):
        x = self.pool1(F.relu(self.conv1(x)))
        x = self.pool2(F.relu(self.conv2(x)))
        x = self.pool3(F.relu(self.conv3(x)))

        x = torch.flatten(x, start_dim=1)

        x = F.relu(self.fc1(x))
        x = self.fc2(x)

        return x

model = Model().to(device)

summary(model)
4.3 模型训练
4.3.1 设置超参数 & 编写训练和测试函数
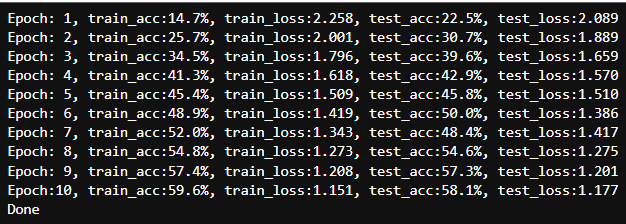
训练函数train在每个批次中执行前向传播计算预测值,使用交叉熵损失评估误差,通过反向传播计算梯度并利用SGD优化器更新模型参数,同时统计训练准确率和损失;测试函数test则在禁用梯度计算的模式下进行前向传播,评估模型在验证集上的表现而不更新权重,最终返回模型在测试数据上的平均准确率和损失,两个函数共同构成了一个典型的有监督深度学习训练评估循环。
loss_fn = nn.CrossEntropyLoss()
learn_rate = 1e-2
opt = torch.optim.SGD(model.parameters(), lr=learn_rate)

def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    train_loss, train_acc = 0, 0

    for X, y in dataloader:
        X, y = X.to(device), y.to(device)
        pred = model(X)
        loss = loss_fn(pred, y)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        train_acc  += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss += loss.item()

    train_acc  /= size
    train_loss /= num_batches

    return train_acc, train_loss

def test (dataloader, model, loss_fn):
    size        = len(dataloader.dataset)
    num_batches = len(dataloader)
    test_loss, test_acc = 0, 0

    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            target_pred = model(imgs)
            loss        = loss_fn(target_pred, target)

            test_loss += loss.item()
            test_acc  += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc  /= size
    test_loss /= num_batches

    return test_acc, test_loss
4.3.2 正式训练
epochs = 10
train_loss = []
train_acc = []
test_loss = []
test_acc = []

for epoch in range(epochs):
    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, opt)

    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

    template = ('Epoch:{:2d}, train_acc:{:.1f}%, train_loss:{:.3f}, test_acc:{:.1f}%, test_loss:{:.3f}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss, epoch_test_acc*100, epoch_test_loss))

print('Done')
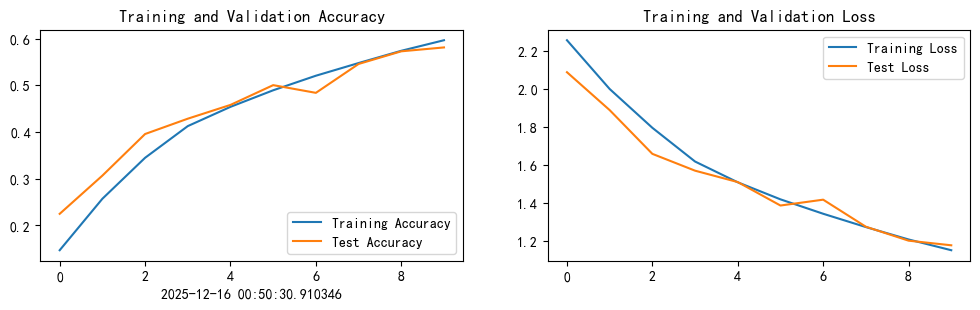
5. 结果可视化
current_time = datetime.now()

epochs_range = range(epochs)

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
更多推荐
 11
 0
- 0


 已为社区贡献29条内容

所有评论(0)