
机器学习(1)
什么是机器学习
计算机从数据中学习规律并改善自身进行预测的过程
数据:图片、文本、表格........
举例:存在一个区分苹果是好是坏的任务,我们从市场上随机选取一些苹果,记住它们的特征(大小,形状,颜色,产地,含糖量.....),给这些苹果打个标签(好/坏)或者打个分数(7分/8分...),我们目的就是找到规律(即模型,比如我们含糖量高的苹果往往打分比较高),我们要怎么学习并且改善这个规律(使用损失函数,优化算法),预测就是给你一个苹果你使用这个发现的规律来给这个苹果打分或者打标签。
机器学习应运而生的原因
- 定性的问题用定量的语言的描述
- 人与计算机理解方式不同
- 规则系统不够用
- 逻辑判断专家参与耗时耗力
人类是如何学习的
根据过往经验进行归纳形成规律,当遇到新的问题时根据这个规律进行推演得到输出,然后根据这个输出反馈给规律进而更新这个规律
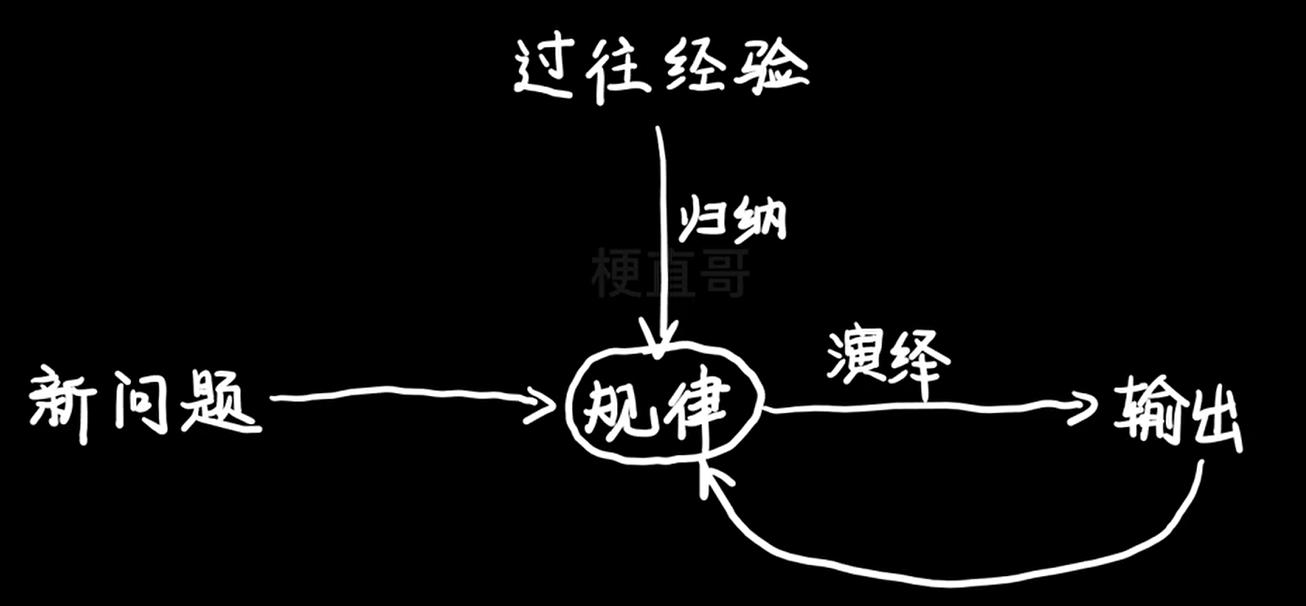
举例:一开始你吃过几次红色的水果(苹果,草莓),发现都很甜,于是你形成了一个认知(规律):“红色的水果通常是甜的。”后来你发现几个红色的水果,你本能感觉这几个红色水果就是甜的,但是当你吃了后发现这个水果是酸的(比如山楂、某些苹果),所以你意识到:“颜色不能单独决定甜不甜,还要看品种、成熟度等特征。”于是你修正了之前原来的判断(规律)。
机器是如何学习的
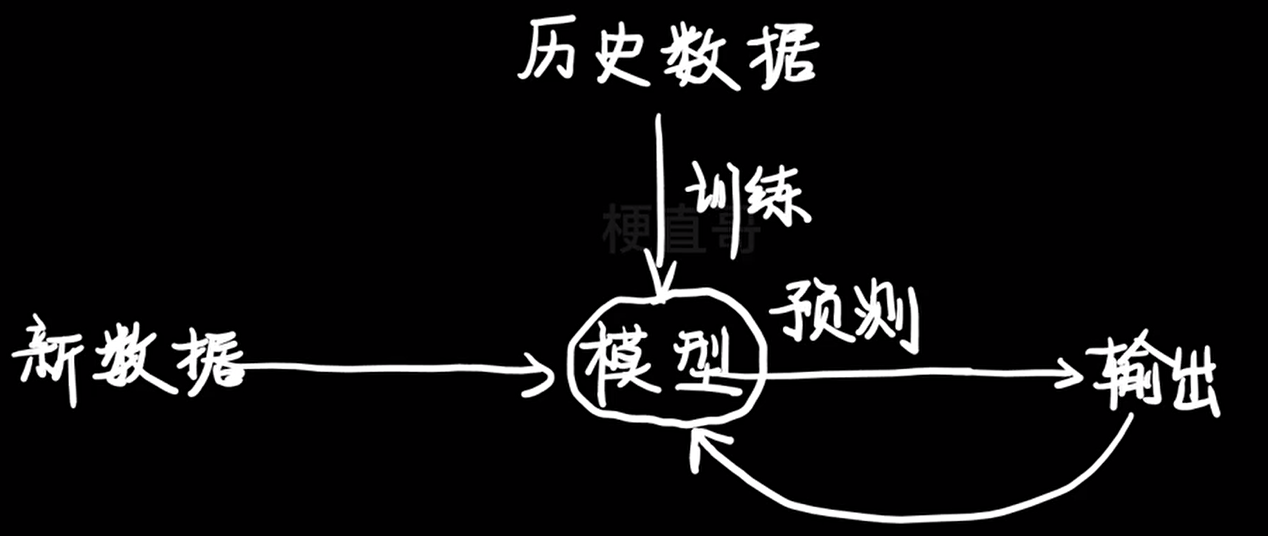
基于历史数据进行模型的训练(找到规律),然后新数据输入到这个模型后得到一个预测的输出,然后根据这个输出不断的迭代更新模型
1、数据准备
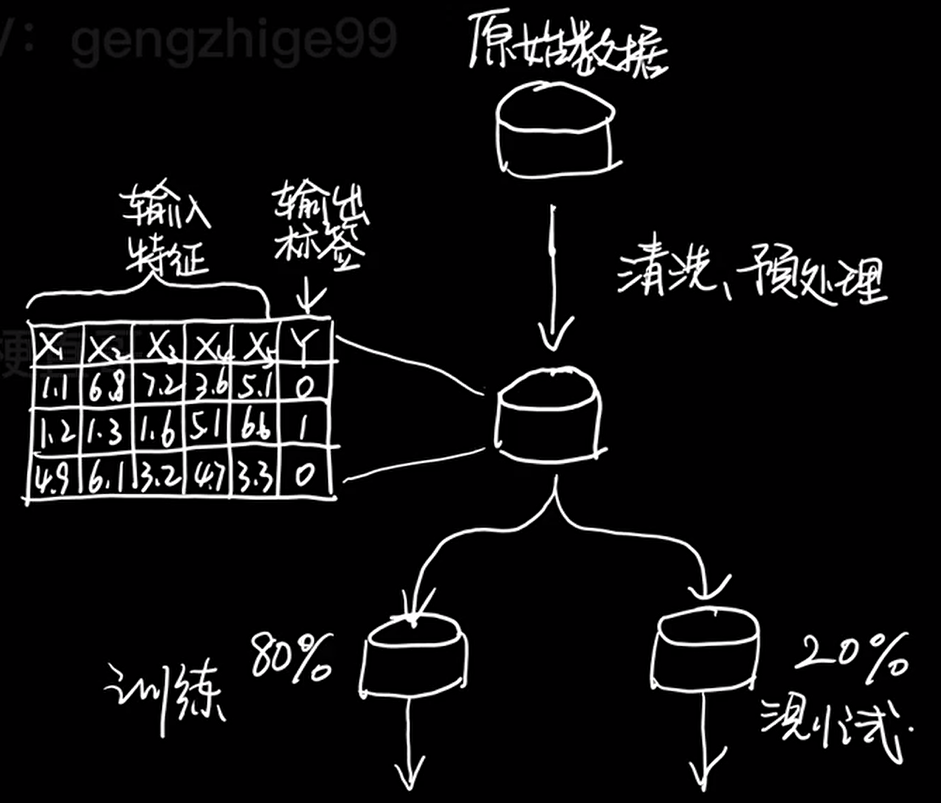
数据相当于一个Excel表格数据,包含数据的输入特征,输出标签
数据处理:清洗,预处理,训练集(80%),测试集(20%)
使用80%的数据进行训练(日常作业)得到一个模型,然后使用测试集进行模型的测试(最终的考试)
2、模型学习
算法选择(例如:KNN,SVM,RF)-> 参数调优(具体问题具体分析) -> 特征选择(寻找最优的特征子集)
举例:模型学习的过程就像炒菜的过程,算法选择的过程就相当于自己选择什么样的食谱,参数调优就相当于在炒菜的过程中添加哪些调味料,特征选择就相当于你要掌握最优的火候、控制好时间,最后炒好的这个菜就相当于最后训练好的这个模型。
3、模型评价
评价性能:
- 分类:准确率、灵敏度、特异性、相关系数
- 回归:确定系数、均方误差、均方根误差
机器学习的实际应用
- 商品的推荐
- 搜索算法
- 识图搜索
- 人脸检测
- 人脸识别
机器学习的适用条件
- 问题存在某种模式(起码这个问题人能够解决)
- 难以人工总结定义
- 有足够的样本数据
更多推荐

 7
 0
- 0


 已为社区贡献20条内容

所有评论(0)