
机器学习(3-1)
·
Anaconda
命令行操作
# 查看conda的版本
conda -v
# 更新conda
conda update conda
# 查看conda的虚拟环境
conda env list
# 创建虚拟环境 xxx:需要自己定义,版本号例如3.8、3.9
conda create -n xxx python=版本号
# 激活环境,xxx就是前面自己定义的名字
conda activate xxx
# 退出环境
conda deactivate
# 列出当前环境conda安装的包
conda list
# 使用conda安装包,xxx代表包的名字
conda install xxx
# 删除包,xxx代表包名
conda uninstall xxx
# 删除虚拟环境,需要先退出要删除的环境
conda remove -n xxx --all
Jupyter
简单使用
快捷键:
- shift + enter :执行,并定位到下一个cell
- alt + enter :执行,并在当前cell下添加一个新的空白cell,并定位到这个新的cell
- 选中cell + shift + L :添加/删除行号
- 选中cell + B:下面添加一行
- 选中cell + M :进入Markdown模式
- 选中cell + C :进入Code模式
- 选中cell + D,D :删除当前cell
动手实践:
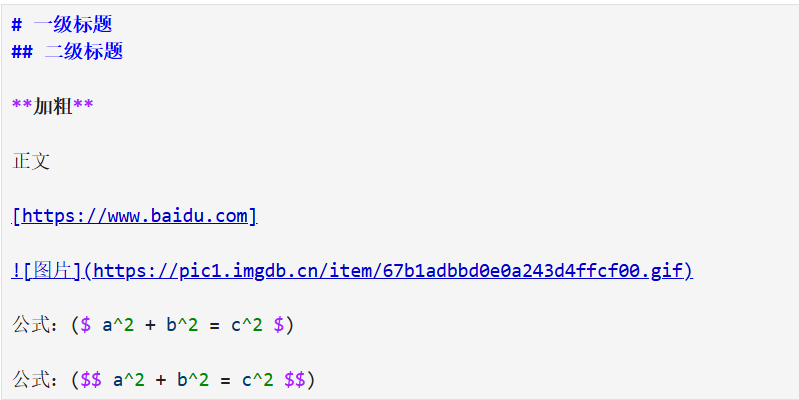
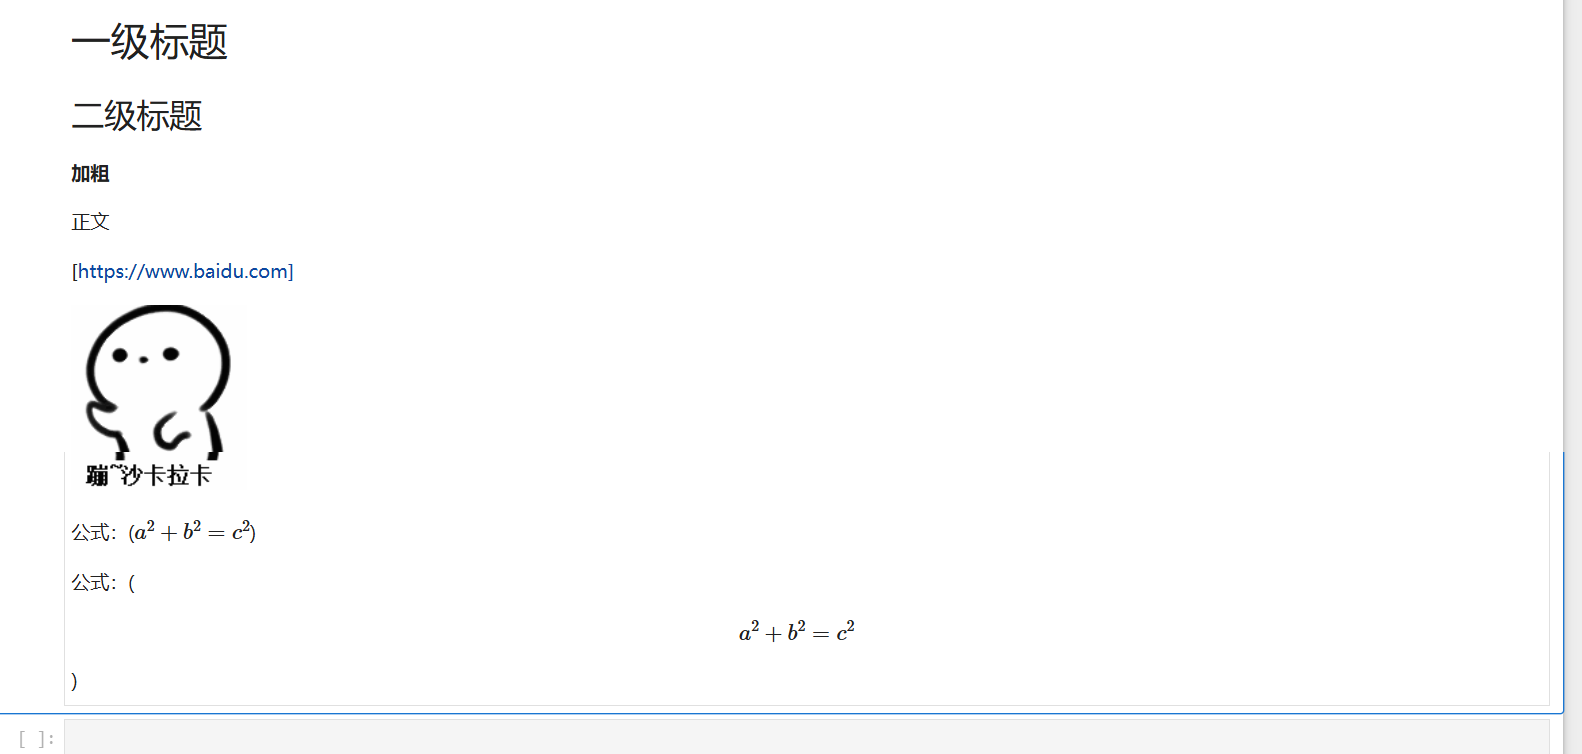
点击单元格 ---> 按M(进入Markdown模式, 按Y进入Code模式)----> 执行(shift + enter)
高级使用
常用的魔法命令
- %%writefile
- %pycat
- % run
- %timeit
- %%timeit
- %time
- %whos
- %lsmagic
动手实践:
%%writefile test.py
# 写入test.py文件内容,没有test.py文件会创建这个文件
def Test(name):
    print("Test",name,"sucess")


# 显示test.py中的内容
%pycat test.py

# 执行python代码
%run test.py
Test("Jupyter")

# 评估后面运行代码的耗时,并不是执行一次
%timeit data = [x * x for x in range(1000)]

%%timeit
# 评估整个cell的执行耗时,并不是执行一次
import time
time.sleep(0.5)

# 评估后面运行代码的耗时,仅执行一次
%time data = [x * x for x in range(1000)]

%%time
# 评估整个cell的执行耗时,仅执行一次
import time
time.sleep(0.5)


# 将前面定义的内容都打印出来
%whos

# 查看更多的魔法命令
%lsmagic
Numpy
导入Numpy
import numpy as np
Numpy与原生Python的性能对比
问题:数组x是由 1-n 数字组成,求数组x中所有数的平方之和(n自定义)
Python实现
%%timeit
x = [i for i in range(n+1)]
sum_x =0
for i in x:
    sum_x += i**2
sum_x

Numpy实现
%%timeit
x = np.arange(n+1)
sum_x = np.sum(x**2)
sum_x

Numpy的ndarray及其创建
创建Numpy数组
a = np.array([1,2,3,4,5,6])
a

A = np.array(
    [
        [1,2,3],
        [4,5,6]
    ]
)
A
Numpy数组的属性
#维度
a.ndim

# 数组的形状
a.shape

# 数组中元素的个数
a.size

# 数组中元素的类型
a.dtype
创建数组的函数
- ones
- zeros
- empty
- full
- arange
- linspace
# ones
# 创建元素全是一的数组
np.ones(8)
# 默认创建的为float类型
np.ones(8).dtype
# 可以指定类型
np.ones(8,dtype='int64')
np.ones(shape=(2,4))
# 创建形状与A相同的数字
np.ones_like(A)

# zeros
np.zeros(8)
np.zeros(shape=(2,4))
np.zeros_like(A)

# full
# 指定数组的元素
np.full(8,66)
np.full((2,4),66)
# np.full(shape=(2, 4), fill_value=66)
np.full_like(A,66)

# empty
# 结果这里并不是全是0.是一个无限接近于0,是一个随机值并没有初始化
np.empty(8)
np.empty((2,4))
np.empty_like(A)

# arange
np.arange(10)
# 1:起始值 ,10:结束(不包含) ,2:步长
np.arange(1,10,2)
np.arange(10).reshape(2,5)

# linspace
# 创建等差数组
# 0:起始值,10:结束(包含) 5:在这个范围内一共生成5个数
np.linspace(0,10,5)
random模块
- random
- rand
- randint
- seed
- randn
- normal
- uniform
# random
# 生成一个0-1之前的随机数,不包含1
np.random.random()
# 生成5个0-1之前的随机数
np.random.random(5)
np.random.random((2,4))

# rand
np.random.rand()
np.random.rand(5)
# 用法和random类似,但是这里没有添加括号
np.random.rand(2,4)
np.random.rand(2,3,4)

# randint
# 返回一个0-5之间的随机数,不包含5
np.random.randint(5)
# 返回一个5-10之间的随机数,不包含10
np.random.randint(5,10)
# 返回8个5-10之间的随机数
np.random.randint(5,10,size=8)
np.random.randint(5,10,size=(2,4))

# seed
# 因为使用随机数每次生成的值都是不一样的,不利于调试,所以使用随机种子
np.random.seed(666)
np.random.randint(5,10,size=(2,4))

# randn
# 返回具有标准正态分布的随机数
np.random.randn(5)
np.random.randn(2,4)

# normal
# 可以设置均值与方差,生成高斯分布的随机数据
# 返回一个随机数
np.random.normal()
# 设置均值为10,标准差为1000,生成数量20
np.random.normal(10,1000,20)
np.random.normal(10,1000,size=(4,6))

# uniform
# 返回具有均匀分布的随机数据
# 生成0-1之间的随机数据,不包含1
np.random.uniform()
# 生成1-5之间的随机数据,不包含5
np.random.uniform(1,5)
# 传入元组数据,生成3行4列的数据
np.random.uniform(1,5,(3,4))

# 查看uniform具有的功能(uniform可以替换为其他的方法)
np.random.uniform?
Numpy数组的基础索引
一维数组
import numpy as np
# 一维数组,也看作:向量
# 一般用小写字母表示
a = np.arange(10)
a[0]
# 取出第4个元素后面的数据
a[4:]
# 取出倒数三个元素
a[-3:]
# 取出全部元素
a[:]
# 倒序输出
a[::-1]
# 设置步长
a[::2]
二维数组
import numpy as np
# 二维数组,看作是:矩阵
# 一般用大写字母表示
A = np.arange(20).reshape(4,5)
# 取第一行的所有值
A[0,:]
# 取出最后一行的所有值
A[-1]
# 取矩阵第一列的元素
A[:,0]
# 取最后一列元素
A[:,-1]
# 将所有的行、列倒序
A[::-1,::-1]
# Numpy中的切片操作会对原始数据进行修改
# 避免一方修改,原数据也发生变化,使用copy()方法实现复制操作
X = A[:2,:3].copy()
X
Numpy数组的合并和拆分
数组的合并
concatenate()方法:使用该方法要保证合并的数组的维度是相同的,默认垂直方向上的合并
import numpy as np

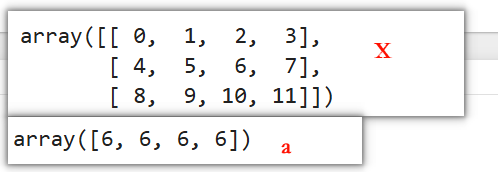
X = np.arange(12).reshape(3,4)
X

a = np.array([6,6,6,6])
a

# 此时会报错,因为X和a的维度并不相同,使用该方法要保证合并的数据维度相同
np.concatenate(X,a)

# 执行X,a本身并不会发生改变,要注意括号
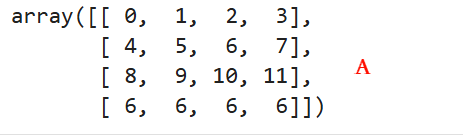
A = np.concatenate((X,a.reshape(1,4)))
A
vstack()方法:实现竖直方向的合并
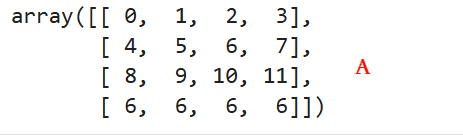
# 在竖直方向上合并
np.vstack((X,a))
hstack()方法:实现水平方向的合并
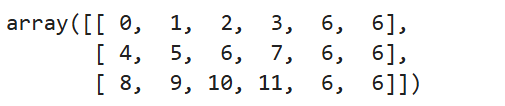
# 在水平方向上合并
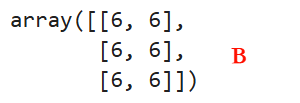
# 需要创建一个和X行数相同的数组
B = np.full((3,2),6)
B
np.hstack((X,B))
concatenate()实现hstack()方法的功能
# axis:在那个维度上进行操作,axis=0在行这个维度进行操作,axis=1在列这个维度进行操作
np.concatenate((X,B),axis=1)
数组的拆分
split():
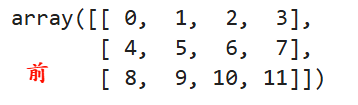
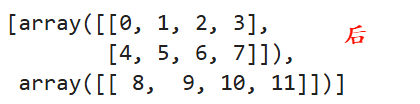
# split():第一个参数是要拆分的数组,第二个是需要拆分的索引
# 默认按行进行拆分
np.split(X,[-1])
vsplit():
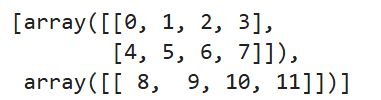
# 在竖直方向上拆分,第一个参数表示要拆分的数组,第二个表示从哪个点拆分(索引)
# 这里要拆出最后一行:[0:2]  [2:]
np.vsplit(X,[2])
hsplit():
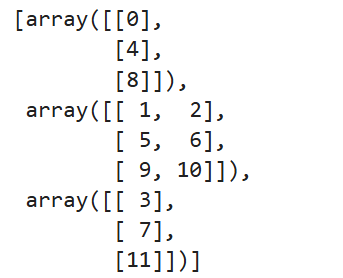
# 水平方向的拆分
# [0:1]  [1:3] [3:]
np.hsplit(X,[1,3])
Numpy数组的运算
一元运算
X = np.arange(1,11,0.5).reshape(4,5)
# 取绝对值
np.abs(X)
# 开方
np.sqrt(X)
# 平方
np.square(X)
# 指数
np.exp(X)
# 对数
np.log(X)
# 向上取整
np.ceil(X)
# 向下取整
np.floor(X)
# 四舍五入,奇进偶不进,1.5-->2  2.5-->2
np.round(X)
二元运算
X + 1
np.add(X,1)
X - 1
X *2
X**3
矩阵运算
X = np.linspace(10,40,4).reshape(2,2)
Y = np.linspace(1,4,4).reshape(2,2)
X + Y
# 对应位置的元素相乘
X * Y
# 矩阵相乘
X.dot(Y)
# 转置
X.T
# 逆矩阵
V = np.linalg.inv(X)
# 得到单位矩阵
X.dot(V)
更多推荐

 21
 0
- 0


 已为社区贡献20条内容

所有评论(0)