
机器学习(3-2)
Numpy中的统计运算
-
min(): 返回数组中的最小值。 -
max(): 返回数组中的最大值。 -
sum(): 计算数组中所有元素的总和。 -
mean(): 计算数组的平均值(算术平均数)。 -
median(): 计算数组的中位数,即将数组排序后中间位置的元素(如果元素个数是偶数,取中间两个元素的平均值 -
std(): 计算数组元素的标准差,衡量元素值的分散程度。 -
var(): 计算数组元素的方差,表示元素值与均值的偏离程度。 -
ptp(): 计算数组元素的范围,即最大值与最小值之间的差。 -
cumsum(): 计算数组的累积和,即每个元素与之前所有元素的和。 -
diff(): 计算数组中相邻元素之间的差。 -
prod(): 计算数组元素的乘积
import numpy as np
X = np.arange(500000)
np.min(X)
np.max(X)

Y = X.reshape(5,-1)
# 按行求最小值
np.min(Y,axis=0)
# 按列求最小值
np.min(Y,axis=1)

X = np.linspace(1,20,20).reshape(4,5)
np.sum(X)
np.sum(X,axis=0)
np.sum(X,axis=1)
# 描述数组中最大值和最小值的差
np.ptp(X)
# 按行进行统计
np.cumsum(X,axis=1)
# 计算元素之间的差值
np.diff(X,axis=1)
# 计算元素之间的乘积,axis表示按行执行
np.prod(X,axis=1)
Numpy中的arg运算
-
argmin(): 返回数组中最小值的索引。 -
argmax(): 返回数组中最大值的索引。 -
sort(): 对数组中的元素进行升序排序,改变原数组。 -
argsort(): 返回一个数组,包含数组元素从小到大排序后的索引。 -
partition(): 对数组进行部分排序,指定一个索引位置,将该位置的元素作为分界点,前面的元素是数组中最小的几个元素,后面的元素保留原有顺序。 -
argpartition(): 返回一个数组,包含数组中元素按照partition()方式排序后的位置索引
import numpy as np
x = np.random.normal(0,1,size = 1000000)
# 找出最小值所在的位置
np.argmin(x)
# 找出最大值所在的位置
np.argmax(x)


x = np.arange(10)
# 打乱x中元素的顺序
np.random.shuffle(x)
# 排序,并不会对原始的x进行修改
np.sort(x)
# 直接使用sort()会对原始的x进行修改
x.sort()

# 打乱x中元素的顺序
np.random.shuffle(x)
# 返回一个数组中元素 排序后的索引
np.argsort(x)

# partition 分区,类似快速排序
np.partition(x,5)
np.argpartition(x,5)

# 高维情况
X = np.random.randint(10,size=(5,5))
np.sort(X)
np.argsort(X,axis=1)
partition 分区
numpy.partition(a, kth, axis=-1, kind='introselect', order=None)
-
a: 要排序的数组。
-
kth: 关键参数。它是你想要“固定”的索引位置。
-
axis: 沿着哪个维度操作(默认是最后一个维度)。
案例:
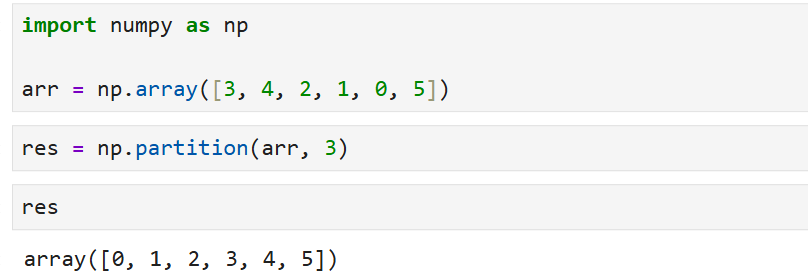
arr = np.array([3, 4, 2, 1, 0, 5])
np.partition(arr,3)
-
NumPy 会找到如果数组排好序后,索引为 3 的那个数字(在arr中是数字
3)。 -
把这个数字放到索引
3的位置。 -
保证索引
0, 1, 2的位置都是比3小的数。 -
保证索引
4, 5的位置都是比3大的数。
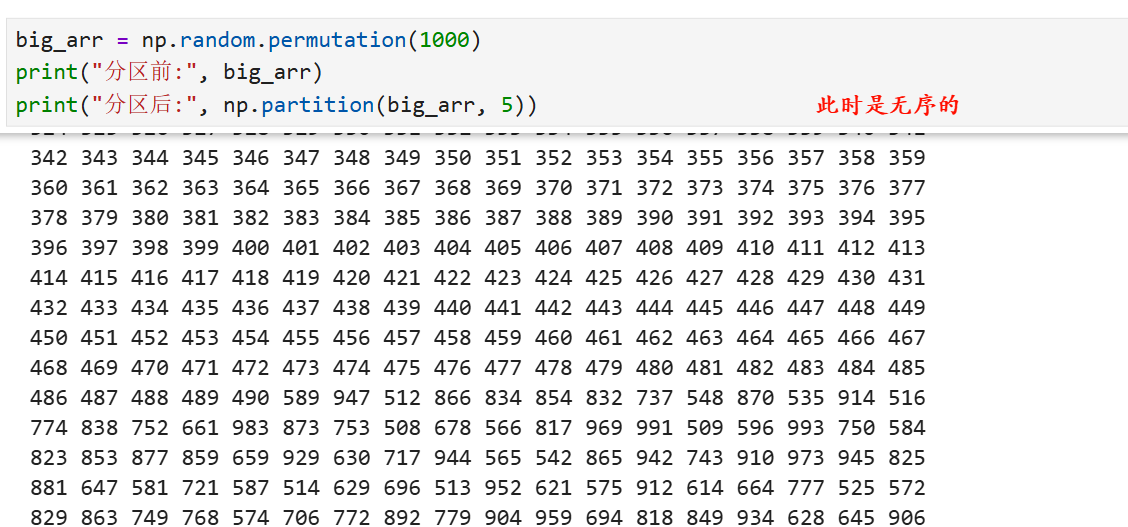
注意:左边和右边的子集内部依然是无序的
# (索引3的位置一定是3,左边都比3小,右边都比3大),
我的结果:生成了有序的结果(数据太少,巧合)
更改数组元素的数量(增加到1000,前半部分有序,后面就乱序了)
Numpy中的神奇索引和运算
一维数组
import numpy as np
x =np.arange(10)
# 取出索引为2,5,8的元素
x[2],x[5],x[8]
# 一次性取出
index = [2,5,8]
x[index]
# 高级一丢丢
index = np.array([[1,3,5],[2,4,6]])
x[index]
二维数组
X = x.reshape(2,5)
row = np.array([0,1,0])
col = np.array([0,2,4])
X[row,col]

# 只取第一行数据
X[0,col]
# 只取前两列
X[row,:2]

# 也可使用布尔值
col = [True,False,True,False,True]
X[0,col]
比较
-
sum()用于计算数组元素的总和。 -
any()用于检查数组中是否有符合条件的元素,有则为True。 -
all()用于检查数组中是否所有元素都满足一定条件,满足为True。

# 找到x中小于5的元素有多少个
np.count_nonzero(x<5)
np.sum(x<5)

# 数组中是否存在小于0的数
np.any(x<0)

# 判断数组中的元素是否都具有某种特性
np.all(x>0)

# 二维数组,按行统计,每一行有多少偶数
np.sum(X%2==0,axis=1)
# 按列统计,每一列有多少偶数
np.sum(X%2==0,axis=0)
与& 或| 非~
# 找出x中小于5且大于1的元素的个数
np.sum((x<5) & (x>1))

# 找出x中小于1或者大于6的元素的个数
np.sum((x<1)|(x>6))

# 找出x中不为0的元素的个数
np.sum(~(x==0))
Matplotlib基础
(基础中的基础,够用就行)
安装matplotlib库(如果有不用安装)
pip install matplotlib
import matplotlib.pyplot as plt
import numpy as np

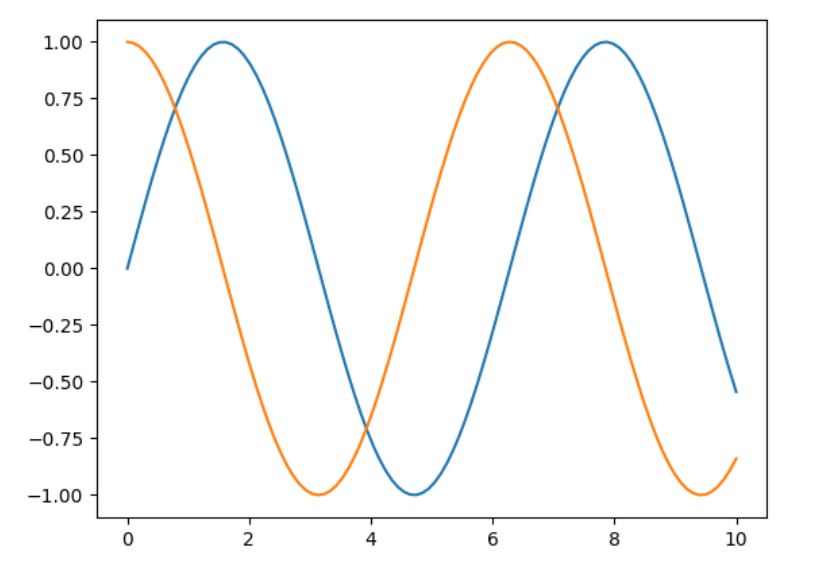
x = np.linspace(0,10,100)
y1 = np.sin(x)
y2 = np.cos(x)
plt.plot(x,y1)
plt.plot(x,y2)
plt.show()
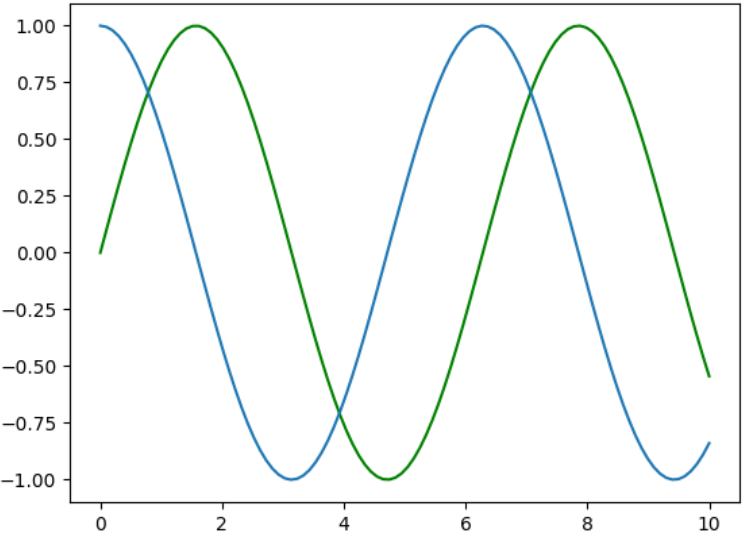
修改线条颜色:
# 修改颜色
plt.plot(x,y1,color='green')
plt.plot(x,y2)
plt.show()
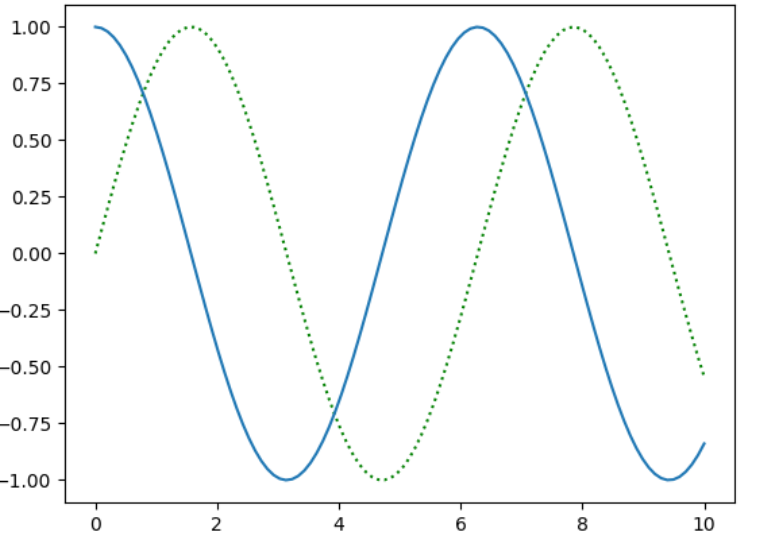
曲线的类型
# 控制曲线的形状
plt.plot(x,y1,color='green',linestyle=':')
plt.plot(x,y2)
plt.show()
调整坐标轴的范围(xlim(),ylim(),axis())
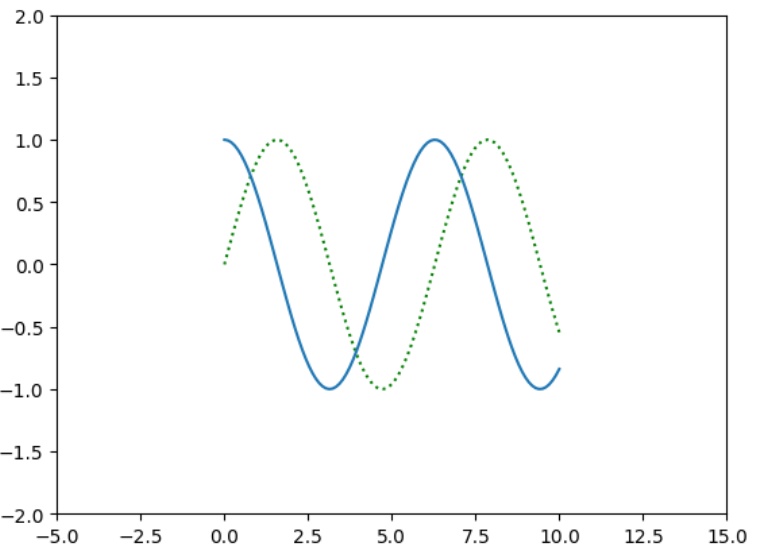
# 调整坐标轴的范围
plt.plot(x,y1,color='green',linestyle=':')
plt.plot(x,y2)
plt.xlim(-5,15)
plt.ylim(-2,2)
plt.show()


# 调整坐标轴的范围,一次性设置
plt.plot(x,y1,color='green',linestyle=':')
plt.plot(x,y2)
plt.axis([-5,15,-2,2])
plt.show()
x,y轴的标题
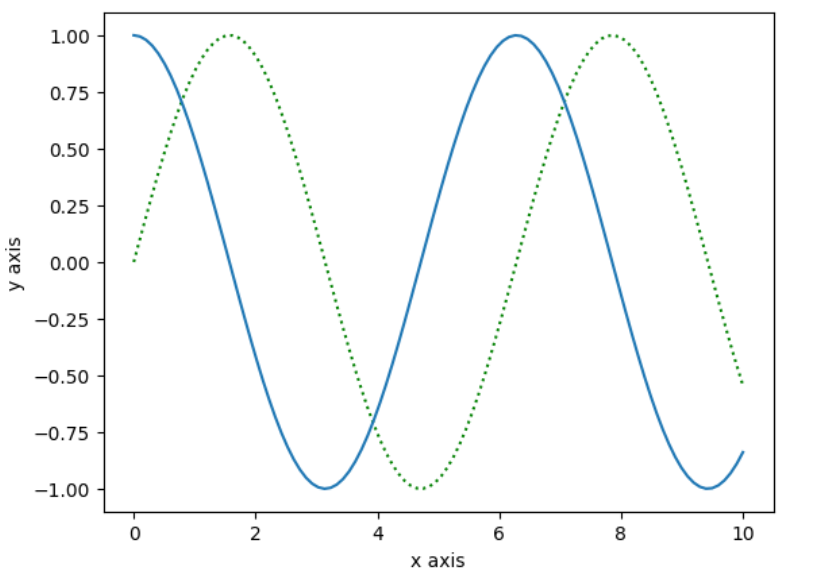
# x轴和y轴的名称
plt.plot(x,y1,color='green',linestyle=':')
plt.plot(x,y2)

plt.xlabel('x axis')
plt.ylabel('y axis')

plt.show()
标记曲线名称(显示图例)
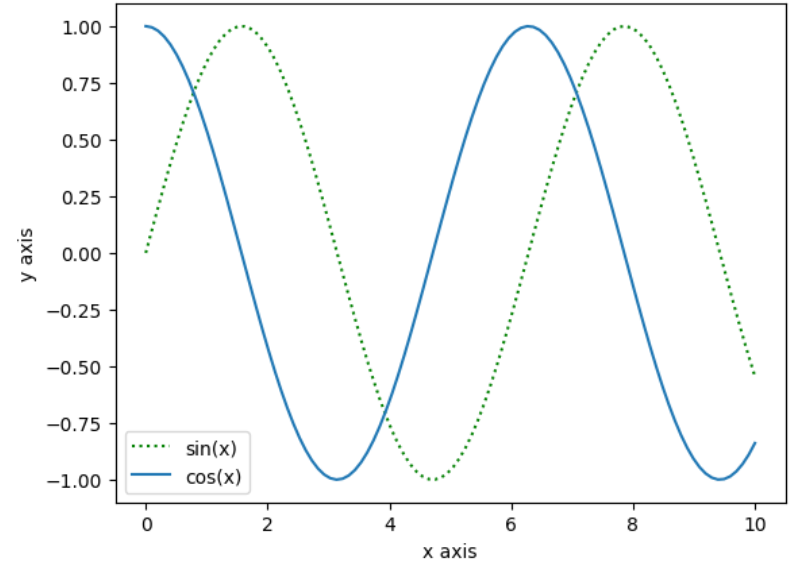
# 标记曲线的名称
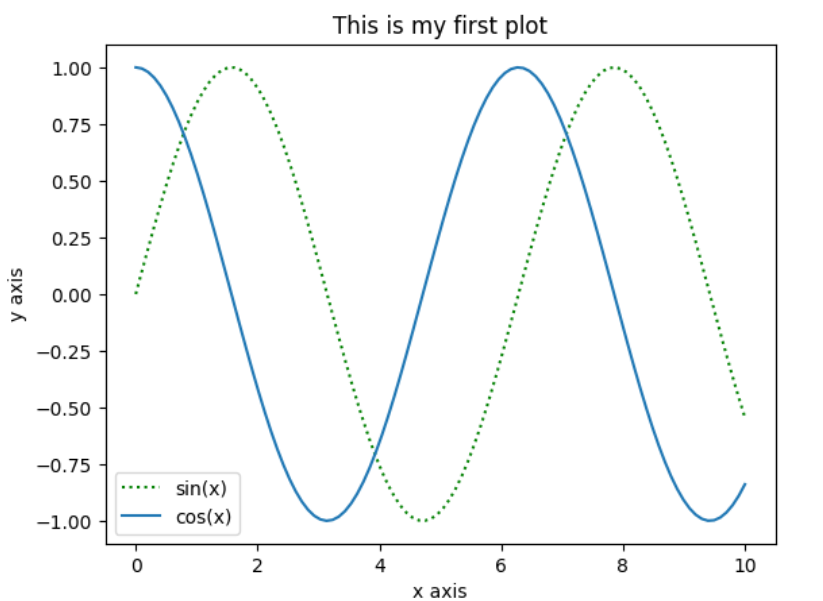
plt.plot(x,y1,color='green',linestyle=':',label = 'sin(x)')
plt.plot(x,y2,label = 'cos(x)')

plt.xlabel('x axis')
plt.ylabel('y axis')
# 显示图例
plt.legend()

plt.show()
设置图表的名称
plt.plot(x,y1,color='green',linestyle=':',label = 'sin(x)')
plt.plot(x,y2,label = 'cos(x)')

plt.xlabel('x axis')
plt.ylabel('y axis')
# 显示图例
plt.legend()
# 设置图表的名称
plt.title('This is my first plot')
plt.show()
散点图(scatter())
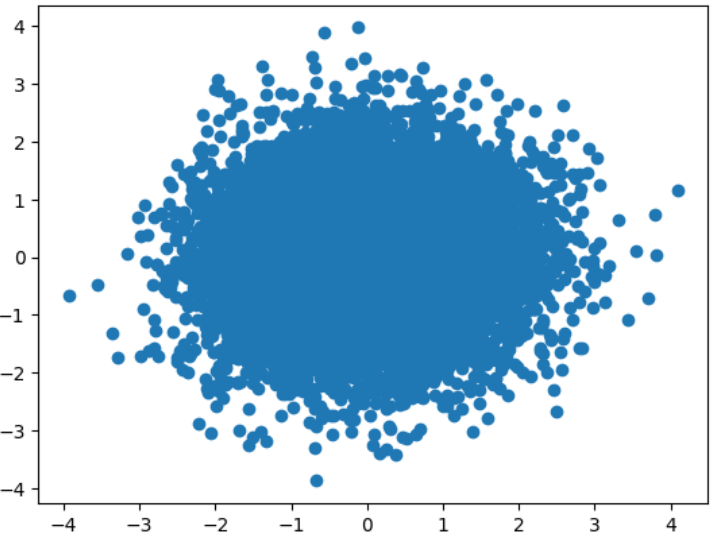
x = np.random.normal(0,1,10000)
y = np.random.normal(0,1,10000)
plt.scatter(x,y)
plt.show()

# 设置不透明度
# plt.scatter(x,y,alpha=0.1)
更多推荐

 23
 0
- 0


 已为社区贡献20条内容

所有评论(0)