
机器学习(4)
·
KNN算法
KNN(K-Nearest Neighbors,K 近邻算法)是一种简单、直观、非参数的监督学习算法,常用于分类和回归问题。
KNN 的核心思想
物以类聚,人以群分(近朱者赤,近墨者黑)
当来了一个新样本时:
-
找到距离它最近的 K 个已知样本
-
看这 K 个样本大多数属于哪一类
-
新样本就被分到那一类(分类)
-
或者取这 K 个样本的平均值(回归)
如何选择K值
- K太小导致“过拟合”(overfit)
- 容易把噪声学进来
- K太大导致”欠拟合“(underfit)
- 决策效率低
距离计算方式
- 明氏距离
- 曼哈顿距离(p=1)
- 欧氏距离(p=2)
特征归一化(normalization)
特征归一化 = 把不同“量纲、尺度”的特征,统一拉到一个可比的范围里
举例:年龄(age:0 ~ 100岁),年收入(income:0 ~ 100000)
当使用欧氏距离计算时,收入的数值过大,而年龄的数值过小导致年龄几乎不起作用,算法其实只在“看收入”,这样很不公平
KNN算法代码实现(均为Jupyter)
import numpy as np
import matplotlib.pyplot as plt
# 定义样本特征
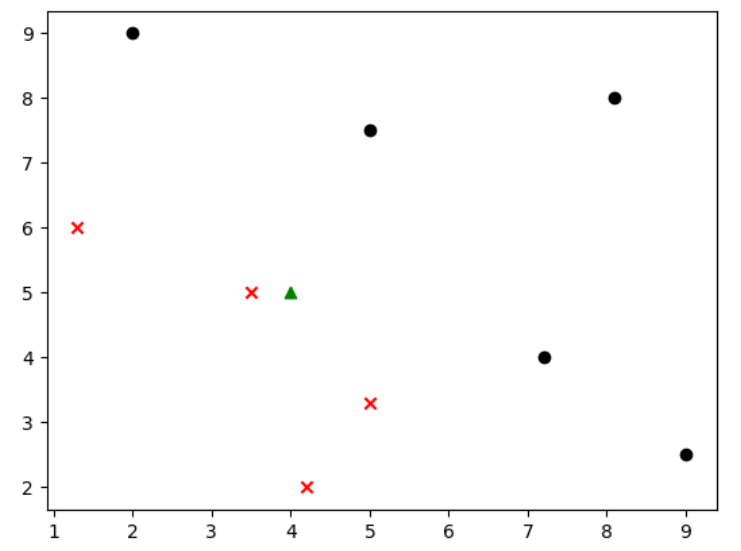
data_X = [
    [1.3,6],
    [3.5,5],
    [4.2,2],
    [5,3.3],
    [2,9],
    [5,7.5],
    [7.2,4],
    [8.1,8],
    [9,2.5]
]
# 样本标记
data_y = [0,0,0,0,1,1,1,1,1]
# 训练集  转换为numpy的数组
X_train = np.array(data_X)
y_train = np.array(data_y)
# 新的样本点
data_new = np.array([4,5])
# 绘制标签为0的点,marker为散点的样式
plt.scatter(X_train[y_train==0,0],X_train[y_train==0,1],color='red',marker='x')
# 绘制标签为1的点
plt.scatter(X_train[y_train==1,0],X_train[y_train==1,1],color='black',marker='o')
plt.scatter(data_new[0],data_new[1],color='green',marker='^')
plt.show()
# 1.计算新样本点与已知样本点的距离
for data in X_train:
    print(np.sqrt(np.sum((data-data_new)**2)))

distances = [np.sqrt(np.sum((data-data_new)**2)) for data in X_train]
# 2.按距离进行排序
# 使用argsort获取排序后的索引值,训练集中的每个样本的索引
sort_index = np.argsort(distances)
# 3.确定k值
k=5
# 4.距离最近的k个点投票
# 前k个值的类别
# 训练集中第 1、3、5、0、2 号样本,离新样本最近
# 找这 k 个样本的标签
# 简单易懂:把距离最近的 k 个训练样本的类别拿出来,准备投票
first_k = [y_train[i] for i in sort_index[:k]]
# 投票表决,即给得到的标签类别计数,统计每个元素出现了多少次
# 结果:类别为0的有4个,类别为1的有1个
from collections import Counter
Counter(first_k)
# 把 first_k 里所有类别的出现次数,按“从多到少”全部列出来
Counter(first_k).most_common()
# 统计最近 k 个邻居中出现次数最多的类别,并取出这个类别标签,案例中是“0”
predict_y = Counter(first_k).most_common(1)[0][0]
# 输出最终的预测值
predict_y
scikit-learn中的KNN算法
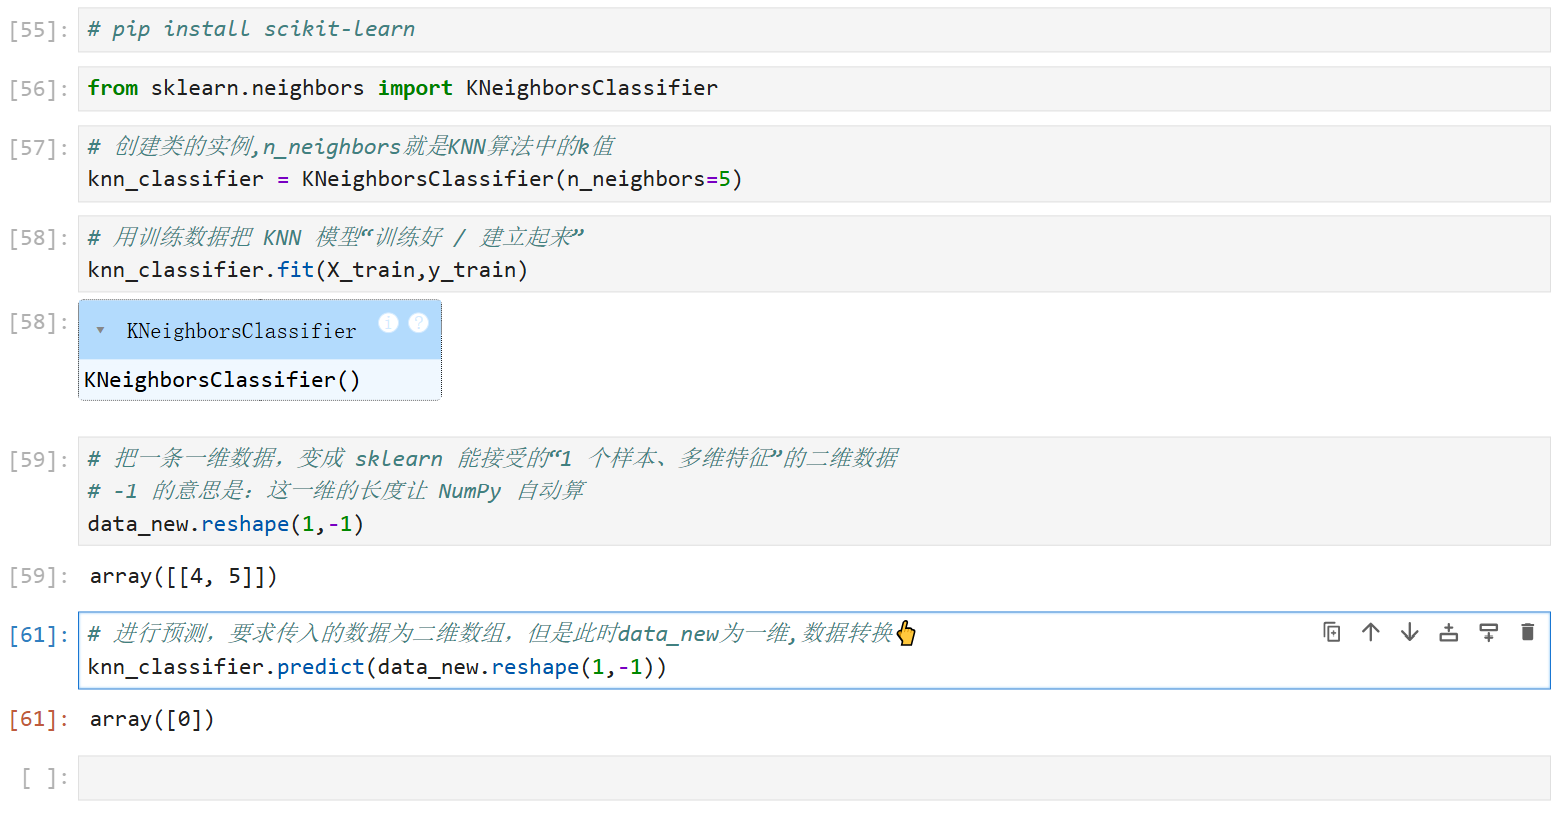
from sklearn.neighbors import KNeighborsClassifier
# 创建类的实例,n_neighbors就是KNN算法中的k值
knn_classifier = KNeighborsClassifier(n_neighbors=5)
# 用训练数据把 KNN 模型“训练好 / 建立起来”
knn_classifier.fit(X_train,y_train)
# 把一条一维数据,变成 sklearn 能接受的“1 个样本、多维特征”的二维数据
# -1 的意思是:这一维的长度让 NumPy 自动算
data_new.reshape(1,-1)
# 进行预测,要求传入的数据为二维数组,但是此时data_new为一维,数据转换👆
knn_classifier.predict(data_new.reshape(1,-1))
数据集的划分
import numpy as np
from matplotlib import pyplot as plt
from sklearn.datasets import make_blobs

# 生成一份“假的/模拟的”分类数据
# make_clobs:人为生成一些“成团”的点(blobs),每一团代表一个类别
# 生成一堆“成团的点”,X 是坐标,y 是每个点属于哪一团(类别/标签)
x,y = make_blobs()

# c=y:用 y 来决定每个点的颜色(即相同类别的统一颜色)
# s=15:点的大小
plt.scatter(x[:,0],x[:,1],c=y,s=15)
plt.show()

# 参数
# n_samples:样本数量,n_features:特征,即生成几维数据,centers:种类的数目(类别/标签)
# cluster_std:类内的标准差,center_box:取值的范围,random_state:随机种子
# return_centers:增加一个类别中心点坐标的返回值
x,y = make_blobs(
    n_samples=300,
    n_features=2,
    centers=3,
    cluster_std=1,
    center_box=(-10,10),
    random_state=233,
    return_centers=False
)

plt.scatter(x[:,0],x[:,1],c=y,s=15)
plt.show()

# 生成和x长度相同的打乱的数组
np.random.seed(233)
shuffle = np.random.permutation(len(x))


# 训练集的比例
train_size = 0.7
# 把训练和测试的序号截取出来
train_index = shuffle[:int(len(x)*train_size)]
test_index = shuffle[int(len(x)*train_size):]
my_train_test_split()
def my_train_test_split(x,y,train_size = 0.7,random_state = None):
    if random_state:
        np.random.seed(random_state)
    shuffle = np.random.permutation(len(x))
    train_index = shuffle[:int(len(x)*train_size)]
    test_index = shuffle[int(len(x)*train_size):]
    return x[train_index],x[test_index],y[train_index],y[test_index]

x_train,x_test,y_train,y_test = my_train_test_split(x,y,train_size=0.7,random_state=233)
plt.scatter(x_train[:,0],x_train[:,1],c=y_train,s=15)
plt.show()

plt.scatter(x_test[:,0],x_test[:,1],c=y_test,s=15)
plt.show()
sklearn划分数据集
from sklearn.model_selection import train_test_split
x_train,x_test,y_train,y_test = train_test_split(x,y,train_size=0.7,random_state=233)
类别的均匀划分
from collections import Counter
Counter(y_test)

# 考虑类别的均匀划分
x_train,x_test,y_train,y_test = train_test_split(x,y,train_size=0.7,random_state=233,stratify=y)

Counter(y_test)
模型评价
import numpy as np
from sklearn import datasets

iris = datasets.load_iris()
X = iris.data
y =iris.target

# 打乱数据
# 为了不打乱x,y,我们对索引进行操作
shuffle_index = np.random.permutation(len(y))

train_ration = 0.8

# 结果可能是小数,所以强制转换
train_size = int(len(y)*train_ration)
train_index = shuffle_index[:train_size]
test_index = shuffle_index[train_size:]

X_train = X[train_index]
y_train = y[train_index]

X_test = X[test_index]
y_test = y[test_index]

# 使用sklearn方法
from sklearn.model_selection import train_test_split
X_train,X_test,y_train,y_test = train_test_split(X,y,train_size=train_ration,random_state=666)

# 预测
from sklearn.neighbors import KNeighborsClassifier
knn_classifier = KNeighborsClassifier(n_neighbors=5)

knn_classifier.fit(X_train,y_train)

# 不关注预测结果,关注评估指标可以直接使用KNN算法自带的
# knn_classifier.score(X_test,y_test)

y_predict = knn_classifier.predict(X_test)
# 看预测和真实值中有多少相同的
np.sum(y_predict == y_test)
# 计算准确度
accuracy = np.sum(y_predict == y_test)/len(y_test)

# 封装的计算准确度的方法
from sklearn.metrics import accuracy_score
accuracy_score(y_test,y_predict)
超参数(Hyperparameter)
- 人为设置的参数(例如:KNN算法中的k值)
- 经验值(理论知识)
- 参数搜索(机器选取)
KNN的超参数
- k个最近的邻居
- 分类表决与加权分类表决
- 明氏距离中的p值
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn import datasets
iris = datasets.load_iris()
x = iris.data
y = iris.target
x_train,x_test,y_train,y_test = train_test_split(x,y,train_size=0.7,random_state=233,stratify=y)

# 超参数
from sklearn.neighbors import KNeighborsClassifier
# 参数:n_neighbors:k的值,weights:权重,distance(与距离相关,成反比),uniform(相同的权重)
# distance:距离越远,权重越小
# p:曼哈顿距离(p=1)还是欧氏距离(p=2),默认欧氏距离
neigh = KNeighborsClassifier(
    n_neighbors=3,
    weights='distance',#'uniform'
    p = 2
)
neigh.fit(x_train,y_train)
# 测试集上的准确率
neigh.score(x_test,y_test)
网格搜索
# 使用网格搜索的方式查找最优超参数
# 初始化参数
best_score = -1
best_n = -1
best_weight = ''
best_p = -1
for n in range(1,20):
    for weight in ['uniform','distance']:
        for p in range(1,7):
            neigh = KNeighborsClassifier(
            n_neighbors=n,
            weights=weight,
            p = p
        )
        neigh.fit(x_train,y_train)
        score = neigh.score(x_test,y_test)
        if score>best_score:
            best_score = score
            best_n = n
            best_weight = weight
            best_p = p

print("n_neighbors:",best_n)
print("weight:",best_weight)
print("p:",best_p)
print("score:",best_score)
sklearn的超参数搜索
from sklearn.model_selection import GridSearchCV
# 定义一个参数字典
params ={
    'n_neighbors':[n for n in range(1,20)],
    'weights':['uniform','distance'],
    'p':[p for p in range(1,7)]
}
# 定义网格搜索
# 参数:estimator:算法,param_grid:要搜索的参数网格,n_jobs:并行计算使用的 CPU 核数
grid = GridSearchCV(
    estimator=KNeighborsClassifier(),
    param_grid=params,
    n_jobs=-1
)
grid.fit(x_train,y_train)
grid.best_params_
grid.best_score_
# 拿到最优模型
grid.best_estimator_
# 用 最优模型 对测试集 x_test 进行预测
grid.best_estimator_.predict(x_test)
# 使用最优模型:在测试集 (x_test, y_test) 上计算 评分
grid.best_estimator_.score(x_test,y_test)
特征归一化
最大最小归一化:把原始数据按比例线性映射到一个固定区间
零均值归一化:映射到正态分布上
最大最小化
import numpy as np
from sklearn import datasets
iris = datasets.load_iris()
X = iris.data
y = iris.target

X[:,0]=(X[:,0]-np.min(X[:,0]))/(np.max(X[:,0])-np.min(X[:,0]))
X[:,1]=(X[:,1]-np.min(X[:,1]))/(np.max(X[:,1])-np.min(X[:,1]))
X[:,2]=(X[:,2]-np.min(X[:,2]))/(np.max(X[:,2])-np.min(X[:,2]))
X[:,3]=(X[:,3]-np.min(X[:,3]))/(np.max(X[:,3])-np.min(X[:,3]))
零均值归一化
# 重新加载数据
iris = datasets.load_iris()
X = iris.data
y = iris.target

# 求均值和标准差
np.mean(X[:,0]),np.std(X[:,0])

X[:,0]=(X[:,0]-np.mean(X[:,0]))/(np.std(X[:,0]))
X[:,1]=(X[:,1]-np.mean(X[:,1]))/(np.std(X[:,1]))
X[:,2]=(X[:,2]-np.mean(X[:,2]))/(np.std(X[:,2]))
X[:,3]=(X[:,3]-np.mean(X[:,3]))/(np.std(X[:,3]))
sklearn中的特征归一化
iris = datasets.load_iris()
X = iris.data
y = iris.target
from sklearn.preprocessing import StandardScaler

standard_scaler = StandardScaler()
standard_scaler.fit(X)
standard_scaler.mean_
standard_scaler.scale_
# X本身并不会改变,所以要进行赋值
X = standard_scaler.transform(X)
测试集如何归一化?
在进行测试集的归一化的时候不能使用测试集的均值和标准差,要使用训练集的均值和标准差
KNN回归任务代码实现
import numpy as np
from sklearn import datasets
import matplotlib.pyplot as plt
# 定义样本特征
data_X = [
    [1.3,6],
    [3.5,5],
    [4.2,2],
    [5,3.3],
    [2,9],
    [5,7.5],
    [7.2,4],
    [8.1,8],
    [9,2.5]
]
data_y = [0.1,0.3,0.5,0.7,0.9,1.1,1.3,1.5,1.7]
# 训练集  转换为numpy的数组
X_train = np.array(data_X)
y_train = np.array(data_y)
# 新的样本点
data_new = np.array([4,5])

# 绘制标签为0的点,marker为散点的样式
plt.scatter(X_train[:,0],X_train[:,1],color='black')
plt.scatter(data_new[0],data_new[1],color='b',marker='^')
for i in range(len(y_train)):
    plt.annotate(y_train[i],xy=X_train[i],xytext=(-15,-15),textcoords='offset points')

from sklearn.neighbors import KNeighborsRegressor
knn_reg = KNeighborsRegressor(n_neighbors=5)
knn_reg.fit(X_train,y_train)
predict_y = knn_reg.predict(data_new.reshape(1,-1))
Housing数据集上的回归任务
import numpy as np
from sklearn import datasets
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
housing = datasets.fetch_california_housing()
X = housing.data
y = housing.target
X_train,X_test,y_train,y_test = train_test_split(X,y,train_size=0.7,random_state=233)
from sklearn.neighbors import KNeighborsRegressor
knn_reg = KNeighborsRegressor(n_neighbors=5,weights='distance',p=2)
knn_reg.fit(X_train,y_train)
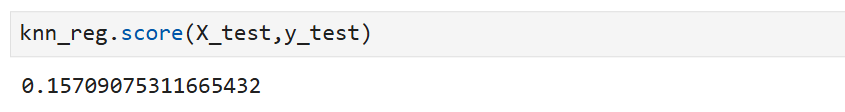
knn_reg.score(X_test,y_test)
结果不好:
添加特征归一化
from sklearn.preprocessing import StandardScaler
standard_scaler = StandardScaler()
standard_scaler.fit(X_train)
x_train = standard_scaler.transform(X_train)
x_test = standard_scaler.transform(X_test)
knn_reg.fit(x_train,y_train)
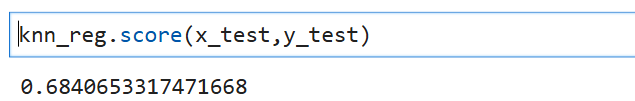
knn_reg.score(x_test,y_test)
结果:
进一步优化:
from sklearn.model_selection import GridSearchCV
params ={
    'n_neighbors':[n for n in range(1,20)],
    'weights':['uniform','distance'],
    'p':[p for p in range(1,7)]
}
grid = GridSearchCV(
    estimator=KNeighborsRegressor(),
    param_grid=params,
    n_jobs=-1
)
grid.fit(x_train,y_train)
grid.best_params_
grid.best_score_
# 用 最优模型 对测试集进行预测
grid.best_estimator_.predict(x_test)
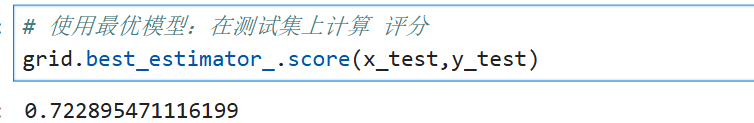
# 使用最优模型:在测试集上计算 评分
grid.best_estimator_.score(x_test,y_test)
结果:
KNN优缺点和适用条件
优点:
- 思想简单
- 理论成熟
- 数据无假设
缺点:
- 样本依赖性强,k值不好选
- 计算量大
- 内存要求高
- 可解释性不强
适用条件:
- 类域交叉重叠
- 样本均衡度高
改进方法:
- 速度优化
- 样本浓缩
- 快速搜索(交叉索引)
- 样本优化
- 距离公式
- K值选择
更多推荐

 38
 0
- 0


 已为社区贡献20条内容

所有评论(0)