
机器学习 KNN算法及ROC曲线
·
一、KNN算法原理
1.算法的概念
KNN(K-Nearest Neighbor,K近邻算法)是一种基于“物以类聚”思想的监督学习算法,通过计算待分类样本与训练集中各样本的距离,选取距离最近的K个邻居,统计这K个邻居的类别出现频率,将频率最高的类别作为预测结果。
2.算法核心原理
如果一个样本在特征空间中的k个最相似(距离最近)的样本中,大多数属于某一个类别,则该样本也属于这个类别。
距离度量公式:
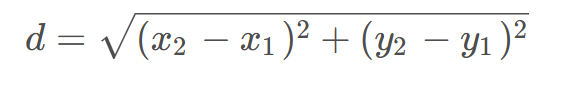
二.knn算法的代码实现与ROC曲线的绘制
1.数据集
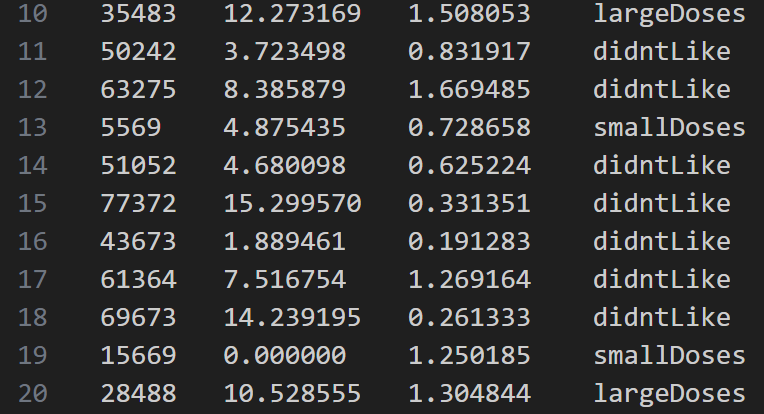 (部分)
共有3个特征smallDoses、didntLike、largeDoses。
2.代码实现
2.1. 导入所有必要的库
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import roc_curve, auc
from sklearn.preprocessing import label_binarize
from itertools import cycle
import os
2.2. 定义数据归一化函数
def scaler(X):
    min_val = X.min(axis=0)  # 按列计算每个特征的最小值
    max_val = X.max(axis=0)  # 按列计算每个特征的最大值
    ranges = max_val - min_val  # 特征值的范围(最大值-最小值)
    X_scaled = (X - min_val) / ranges  # 归一化公式:(原始值-最小值)/范围
    return X_scaled, min_val, ranges  # 返回归一化后的数据、最小值和范围
2.3定义完整的KNN类(含概率预测功能,支持ROC绘制)
class KNN():
    def __init__(self, K=5):
        # 初始化K值(默认5个近邻)
        self.K = K
        # 初始化训练数据相关变量
        self.X_train_scaled = None  # 归一化后的训练特征
        self.y_train = None  # 训练标签
        self.train_min = None  # 训练集特征最小值(用于测试集归一化)
        self.train_ranges = None  # 训练集特征范围(用于测试集归一化)
        self.classes_ = None  # 保存所有类别标签(用于概率预测)

    # 训练方法(实际是保存并归一化训练数据)
    def fit(self, X_train, y_train):
        self.X_train_scaled, self.train_min, self.train_ranges = scaler(X_train)
        self.y_train = y_train  # 保存训练标签
        self.classes_ = np.unique(y_train)  # 获取所有唯一类别

    # 距离计算:欧氏距离
    def distance(self, x_test, x_train):
        return np.sqrt(np.sum((x_test - x_train) ** 2))

    # 单个样本硬分类预测
    def predict(self, x_test):
        # 用训练集的归一化参数处理测试样本
        x_test_scaled = (x_test - self.train_min) / self.train_ranges

        # 计算测试样本与所有训练样本的距离,存储为(距离, 类别)元组
        dis_list = []
        for i in range(len(self.X_train_scaled)):
            dist = self.distance(x_test_scaled, self.X_train_scaled[i])
            dis_list.append((dist, self.y_train[i]))

        # 按距离升序排序,取前K个最近邻
        dis_list_sorted = sorted(dis_list, key=lambda x: x[0])
        K_nearlist = dis_list_sorted[:self.K]

        # 统计K个近邻中每个类别的出现次数(投票)
        count = {}
        for dist, type in K_nearlist:
            if type not in count:
                count[type] = 1
            else:
                count[type] += 1

        # 取出现次数最多的类别作为预测结果
        result_type = sorted(count.items(), key=lambda x: x[1], reverse=True)[0][0]
        return result_type

    # 单个样本概率预测(ROC曲线必需)
    def predict_proba_single(self, x_test):
        # 用训练集的归一化参数处理测试样本
        x_test_scaled = (x_test - self.train_min) / self.train_ranges

        # 计算测试样本与所有训练样本的距离
        dis_list = []
        for i in range(len(self.X_train_scaled)):
            dist = self.distance(x_test_scaled, self.X_train_scaled[i])
            dis_list.append((dist, self.y_train[i]))

        # 按距离升序排序,取前K个最近邻
        dis_list_sorted = sorted(dis_list, key=lambda x: x[0])
        K_nearlist = dis_list_sorted[:self.K]

        # 统计K个近邻中各类别的占比(即概率)
        class_count = {cls: 0 for cls in self.classes_}
        for _, cls in K_nearlist:
            class_count[cls] += 1
        # 计算概率(近邻中该类别的数量 / K)
        proba = [class_count[cls] / self.K for cls in self.classes_]
        return np.array(proba)

    # 批量样本概率预测
    def predict_proba(self, X_test):
        probas = []
        for x_test in X_test:
            proba = self.predict_proba_single(x_test)
            probas.append(proba)
        return np.array(probas)

    # 批量样本硬分类预测
    def predicts(self, X_test):
        y_pred = []
        for x_test in X_test:
            result_type = self.predict(x_test)
            y_pred.append(result_type)
        return np.array(y_pred)
2.4.数据读取与预处理
script_dir = os.path.dirname(os.path.abspath(__file__))
data_file_path = os.path.join(script_dir, 'datingTestSet.txt')

# 定义列名(特征1、特征2、特征3、类别)
columns = ['feature1', 'feature2', 'feature3', 'category']
df = pd.read_csv(
    data_file_path,  # 自动拼接的文件路径
    sep='\t',        # 制表符分隔(datingTestSet.txt默认分隔符)
    header=None,     # 无表头
    names=columns,   # 自定义列名
)

# 划分特征(X)和标签(Y)
X = df[['feature1', 'feature2', 'feature3']].values  # 特征矩阵
Y = df['category'].values  # 类别标签

# 划分训练集(前800行)和测试集(后200行)
X_train = X[:800]    # 训练特征
y_train = Y[:800]    # 训练标签
X_test = X[800:]     # 测试特征
y_test = Y[800:]     # 测试标签
2.5. KNN模型训练与预测
K = 5
knn = KNN(K)

# 训练模型
knn.fit(X_train, y_train)

# 对测试集进行硬分类预测
y_pred = knn.predicts(X_test)

# 展示前20条预测结果与真实结果的对比(避免输出过长)
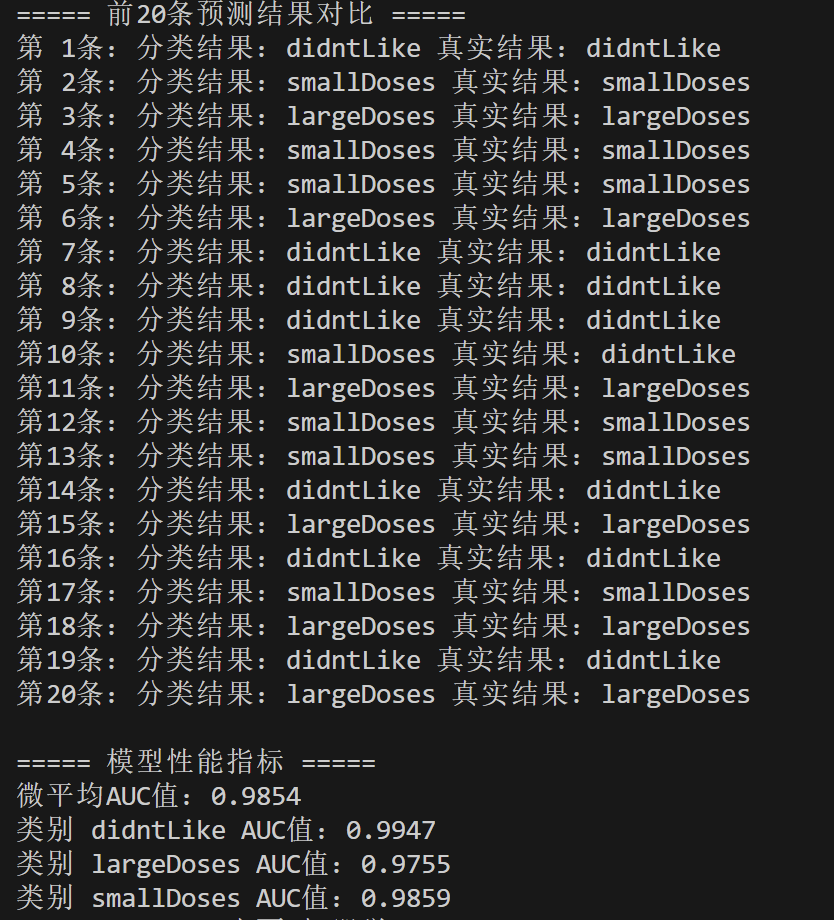
print("===== 前20条预测结果对比 =====")
for i in range(20):
    print(f"第{i+1:2d}条:分类结果:{y_pred[i]} 真实结果:{y_test[i]}")
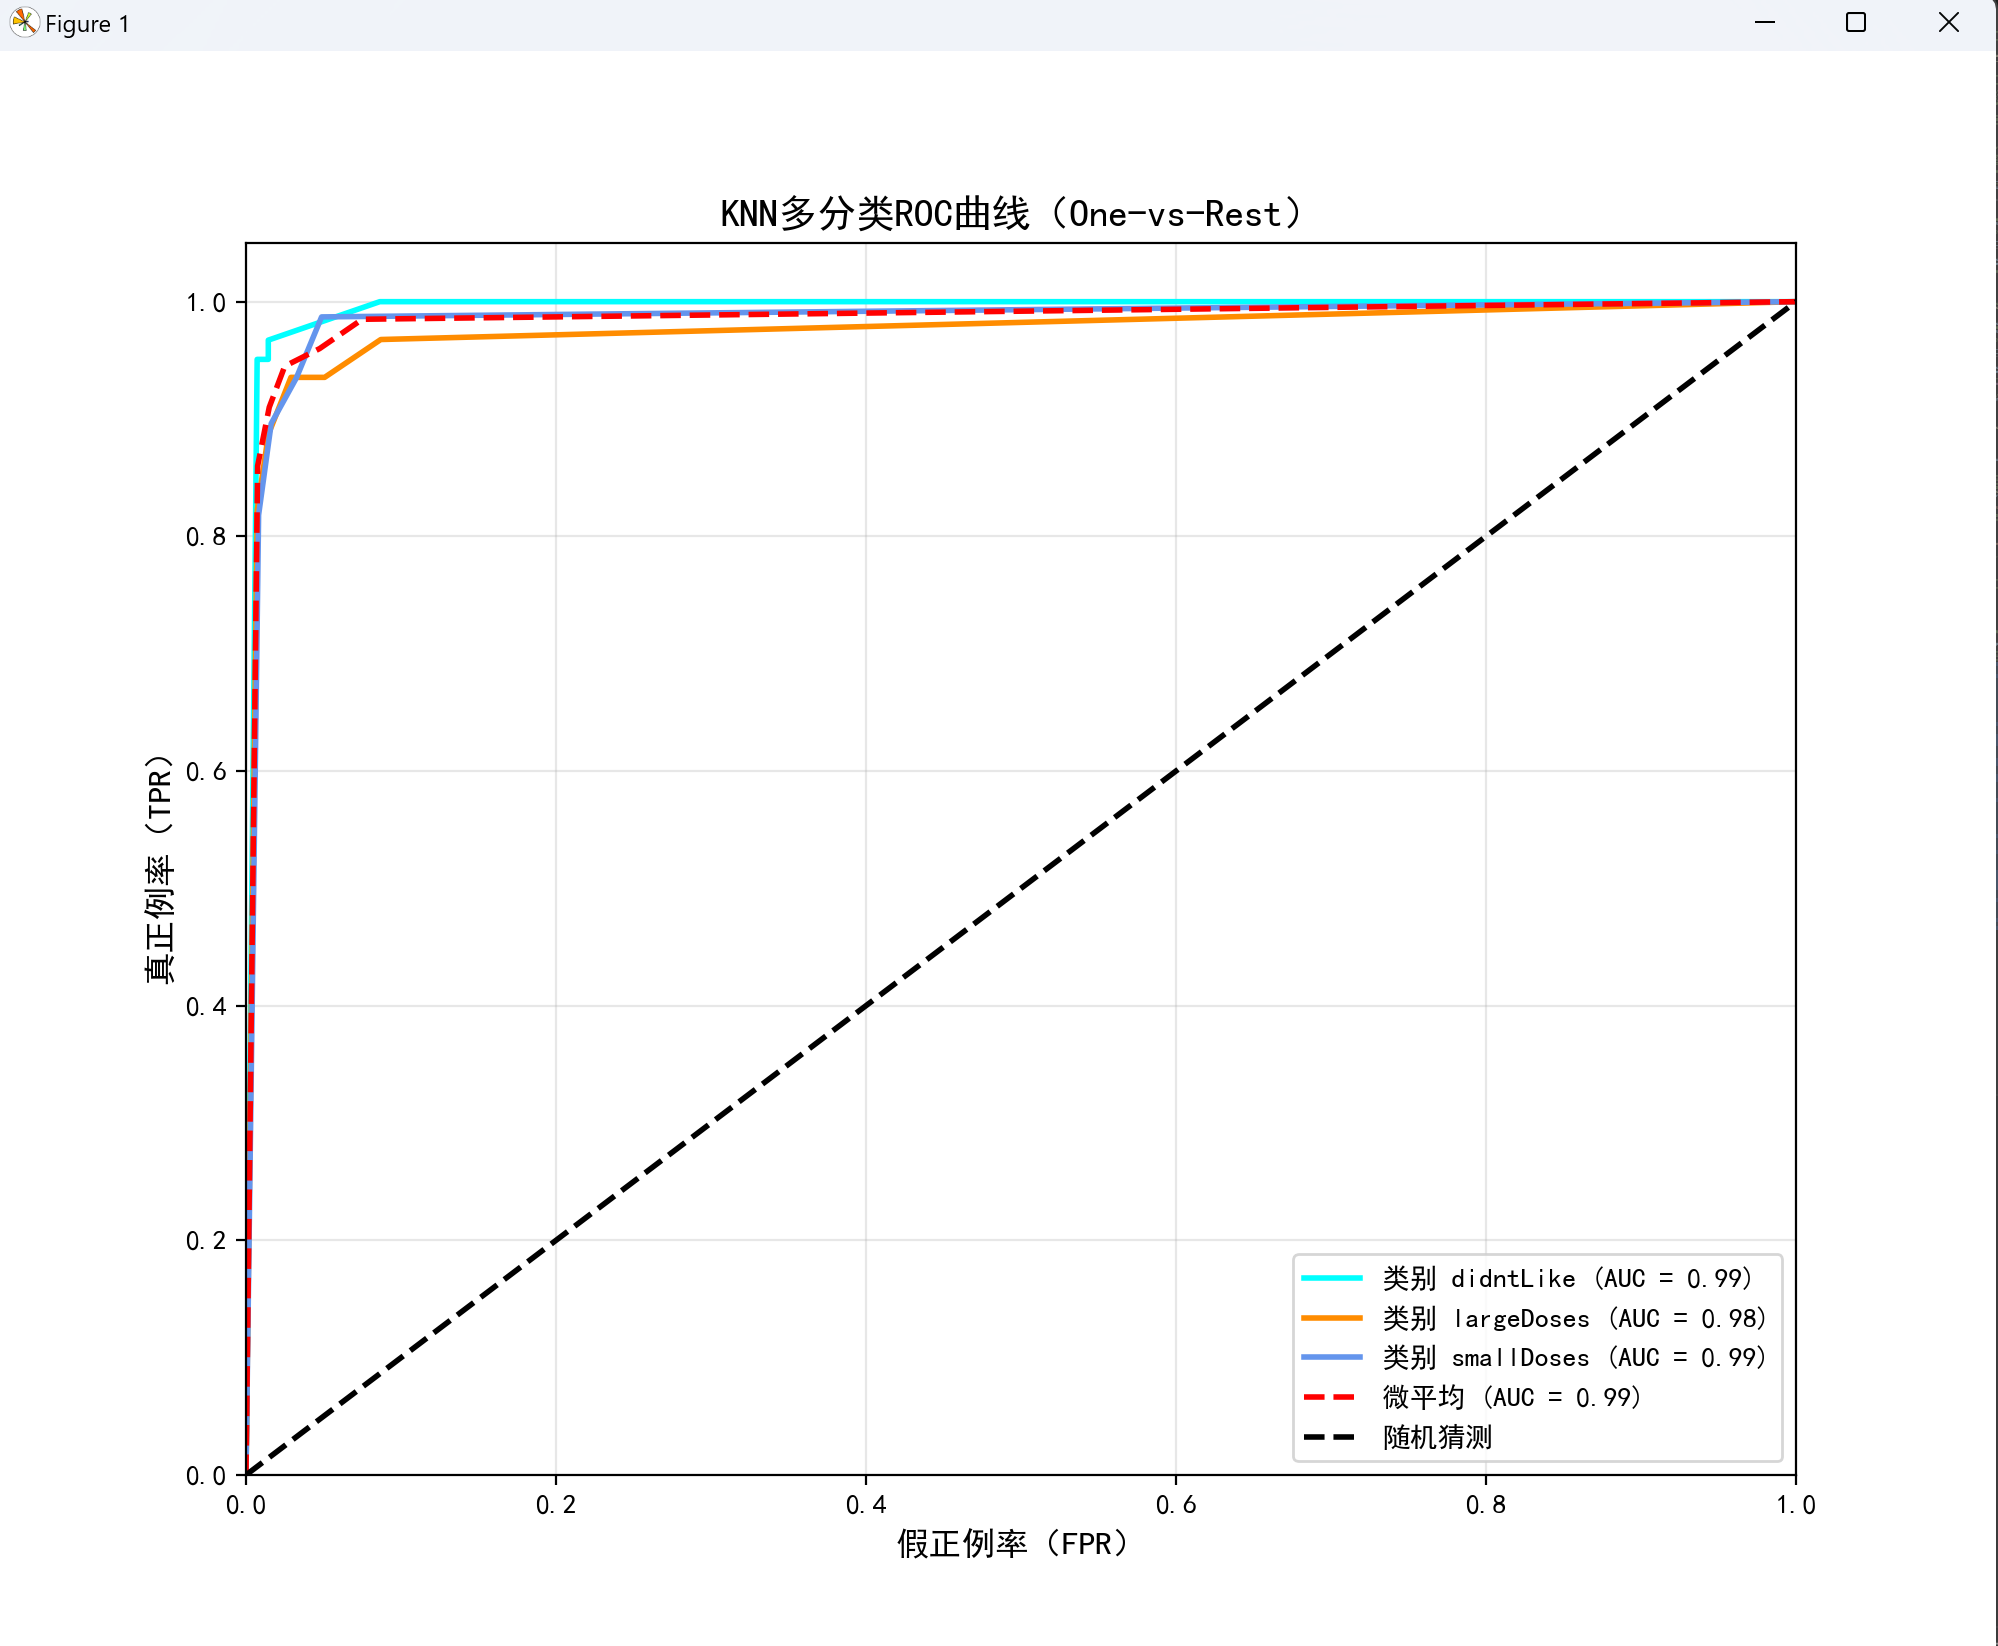
2.6. 多分类ROC曲线绘制(One-vs-Rest策略)
# 6.1 标签二值化(将多分类转为二值化矩阵)
classes = np.unique(Y)
n_classes = len(classes)
y_test_binarized = label_binarize(y_test, classes=classes)

# 6.2 获取模型对测试集的概率预测
y_score = knn.predict_proba(X_test)

# 6.3 计算每一类的FPR、TPR和AUC
fpr = dict()
tpr = dict()
roc_auc = dict()

# 为每个类别单独计算ROC曲线和AUC
for i in range(n_classes):
    fpr[i], tpr[i], _ = roc_curve(y_test_binarized[:, i], y_score[:, i])
    roc_auc[i] = auc(fpr[i], tpr[i])

# 计算微平均ROC曲线和AUC(反映模型整体性能)
fpr["micro"], tpr["micro"], _ = roc_curve(y_test_binarized.ravel(), y_score.ravel())
roc_auc["micro"] = auc(fpr["micro"], tpr["micro"])

# 6.4 绘制ROC曲线
plt.figure(figsize=(10, 8))
plt.rcParams['font.sans-serif'] = ['SimHei']  # 解决中文显示问题
plt.rcParams['axes.unicode_minus'] = False    # 解决负号显示问题

# 绘制每个类别的ROC曲线
colors = cycle(['aqua', 'darkorange', 'cornflowerblue'])  # 颜色循环
for i, color in zip(range(n_classes), colors):
    plt.plot(
        fpr[i], tpr[i],
        color=color,
        lw=2,
        label=f'类别 {classes[i]} (AUC = {roc_auc[i]:.2f})'
    )

# 绘制微平均ROC曲线
plt.plot(
    fpr["micro"], tpr["micro"],
    color='red',
    lw=2,
    linestyle='--',
    label=f'微平均 (AUC = {roc_auc["micro"]:.2f})'
)

# 绘制随机猜测基准线
plt.plot([0, 1], [0, 1], 'k--', lw=2, label='随机猜测')

# 设置坐标轴与图表信息
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('假正例率(FPR)', fontsize=12)
plt.ylabel('真正例率(TPR)', fontsize=12)
plt.title('KNN多分类ROC曲线(One-vs-Rest)', fontsize=14, fontweight='bold')
plt.legend(loc="lower right", fontsize=10)
plt.grid(alpha=0.3)  # 添加网格线,提升可读性

# 保存并显示图片
plt.savefig(os.path.join(script_dir, 'knn_roc_curve.png'), dpi=300, bbox_inches='tight')
plt.show()

# 输出模型整体AUC值
print(f"\n===== 模型性能指标 =====")
print(f"微平均AUC值:{roc_auc['micro']:.4f}")
for i in range(n_classes):
    print(f"类别 {classes[i]} AUC值:{roc_auc[i]:.4f}")
3.ROC曲线如图:
4.程序运行结果
三.总结
本次实验成功完成了 KNN 模型的手动实现与多分类 ROC 曲线的绘制,不仅深化了对 KNN 算法原理和模型评估指标的理解,还解决了工程实践中的路径匹配、版本兼容等实际问题,提升了代码编写与问题排查能力。
更多推荐

 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)