
大模型应用理论与实战(第四部分 大模型微调与部署实践)
第一章:大模型生态与本地部署
1.1 开源与闭源模型对比
当前大模型生态呈现开源与闭源双轨并行发展的格局,两者在技术特性、商业模式、应用场景和生态影响等方面存在显著差异,共同构成了人工智能技术发展的多元图景。
一、核心定义与技术特性差异
开源大模型是指开放源代码、训练数据和技术文档的模型,允许任何人查看、修改和分发。典型代表包括Meta的Llama系列、阿里的Qwen系列、DeepSeek等。这种开放性带来了更高的透明度,开发者可以深入了解模型的工作原理,增强对模型行为的信任。
闭源大模型则保持源代码、数据集和技术细节的保密性,通常作为商业产品通过API服务提供。以OpenAI的GPT系列、百度的文心一言为代表,这些模型通过不公开核心技术来保护知识产权并维持技术领先地位。
从技术特性看,闭源模型通常具有更优的泛化能力和对话流畅度,而开源模型在垂直领域微调、数据安全控制方面更具优势。闭源模型经过严格测试和验证,更适合商业环境,提供更稳定的服务;开源模型则支持私有化部署和深度定制,企业可根据自身需求对模型进行修改以适应特定业务场景。
二、商业模式与成本结构对比
在商业模式上,开源与闭源路径体现了完全不同的盈利逻辑。闭源大模型主要通过API调用次数计费,对企业多采用项目制结算,对消费者则通过订阅和广告抽成模式。例如OpenAI模型的输入价格为15美元/百万tokens,输出价格为60美元/百万tokens。
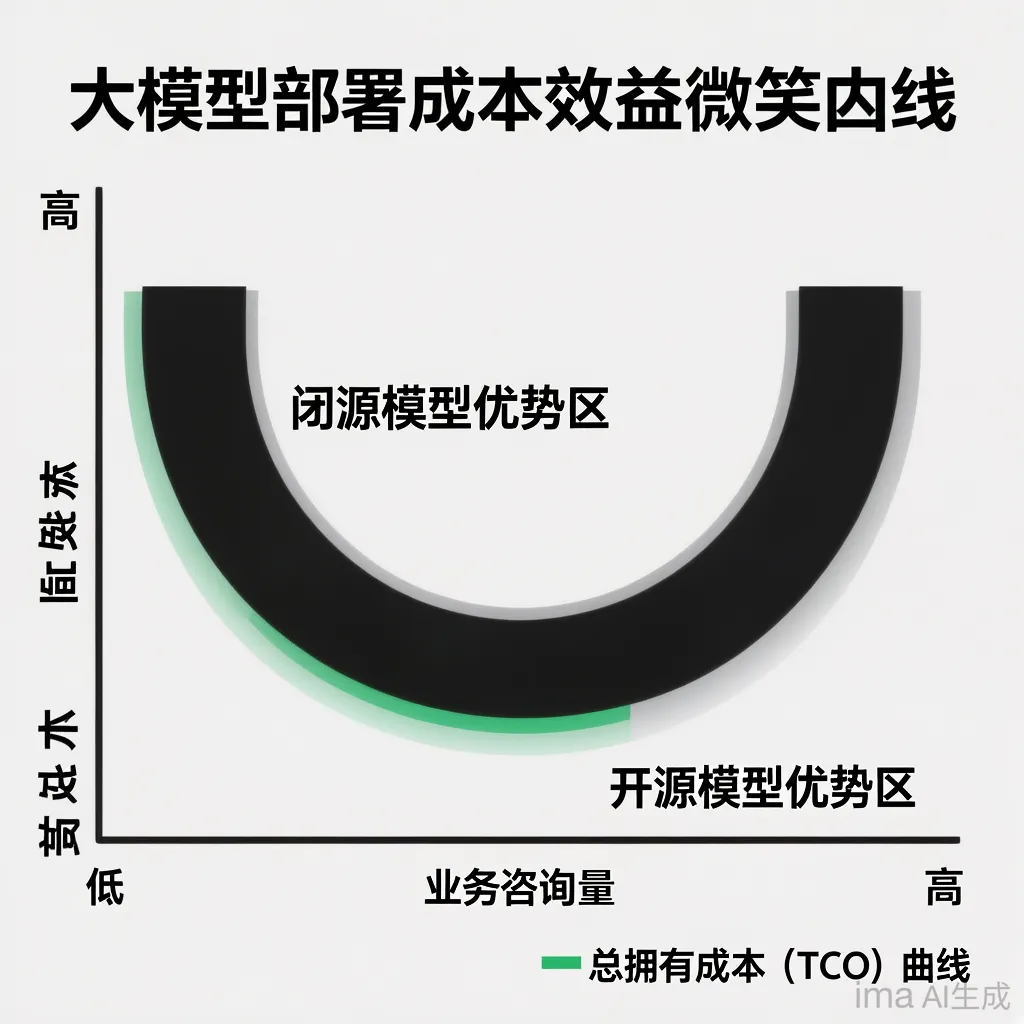
开源大模型的最大优势在于“免费”使用,企业仅需支付前期的服务器、数据中心建设和模型调优等费用,后续无需为模型使用付费。这种成本结构使得在咨询量较大的场景中,开源大模型的私有化部署更具成本优势;而咨询量较少时,公有云部署的闭源模型可能更为划算。
从企业基因来看,阿里云、腾讯等云厂商更倾向于开源,其核心目的是通过免费的下游产品吸引开发者,促进数据消耗,带动上游云产品使用量。而智谱AI、百川智能、月之暗面等大模型创业公司则以AI为核心业务,希望靠大模型盈利,因此更强调闭源模型的价值。
三、性能发展与技术迭代趋势
尽管闭源模型在性能上曾保持领先,但开源模型的追赶速度正在加快。有研究显示,开源模型与闭源模型的性能差距已从GPT-4发布时的滞后几年时间缩短到6至10个月。阿里云的Qwen2.5虽然只有720亿参数,但在多个基准测试中击败了Meta拥有4050亿参数的Llama-3.1,超过了Mistral最新开源的Large-V2,成为目前最强大的开源模型之一。
北京智源人工智能研究院副院长林咏华指出,模型能力是由算法、数据质量和算力投入大小决定,而不是由开源还是闭源决定。这一观点得到了业界广泛认同,表明技术实力的核心在于研发投入而非开放策略。
开源模型的迭代速度也展现出独特优势。虽然开源模型不像软件开源那样可直接获得性能提升,但普通开发者仍可通过模型测评、论坛讨论等渠道向开发者反馈使用体验,整体上开源反馈迭代速度优于闭源。
四、安全风险与合规考量
在安全方面,开源与闭源各有优劣。闭源模型由于设计细节对外封闭,减少了安全风险,提供了更好的安全性和隐私保护。而开源模型源代码公开后,确实可能带来数据隐私泄露、模型被恶意利用以及知识产权被侵犯等风险。
然而,开源模型的透明性也带来了独特的优势。由于源代码、参数及训练过程的透明性,社区能迅速发现并修复漏洞。正如Linux基金会报告中提到,开源模型的漏洞平均修复时间远低于闭源系统。透明研发还有助于独立机构进行安全性和准确性审计,增强模型公信力。
企业使用开源模型时还需注意开源协议的限制。目前主流的开源协议有7种,其中一些协议(如MIT许可证、Apache许可证2.0)较为宽松,允许用户几乎无限制地使用、修改和分发软件。但也有协议(如GNU General Public License,GPL)对商用有严格限制,要求任何修改和分发的工作也必须以GPL协议发布,这可能会导致商业机密和应用安全受到挑战。
五、应用场景与选择策略
在实际应用中,开源与闭源模型形成了互补关系。开源模型前期免费但无法“开箱即用”,后期隐性成本较高,更适合预算有限、对数据安全要求高的学术研究、业务探索等小型项目。闭源模型供应商通常会提供技术服务,模型相对稳定可靠但费用较高,适合对成本不敏感的大型项目。
简单来说,使用开源大模型约等于可以免费使用厨房但不提供菜谱,需要自己买菜做饭;使用闭源大模型则相当于付费去餐厅吃饭,餐厅提供现成的餐食和配套服务。
一些企业会在前期通过免费的开源模型验证业务效果,中后期购买闭源模型与微调过的开源模型内部“赛马”,根据不同的业务需求随时切换。对于模型开发企业而言,开源模型与闭源模型也可并行发展——开源前一代性能落后的模型吸引用户,再引导用户付费使用性能更强的闭源模型。
六、生态影响与未来趋势
开源模式推动了技术民主化与知识共享,降低了人工智能技术的门槛。正如Meta公司首席人工智能科学家Yann LeCun所言,开放大模型使技术民主化提前数年,为小型企业和初创者提供了利用大参数模型开发创新工具的机会。DeepSeek的成功也表明,开源模型能够为小型企业和高校提供更加广阔的空间和创新的可能性,为更加开放民主的科研生态作出重大贡献。
从长远发展看,业内人士认为,短期看理想状态是在开闭源两种模式之间找到平衡,在技术进步与生态建立方面优势互补;长期看,大模型可能会像互联网一样,逐步走向开源,由全世界共同维护、共同受益。百川智能CEO王小川预计,未来80%的企业会用到开源大模型,闭源可以给剩下的20%提供服务,二者不是竞争关系,而是在不同产品中互补的关系。
开源闭源之争表面上是技术路线差异,实则是企业为争夺市场占有率的商业策略之争。随着技术发展和市场成熟,两种模式将在竞争中相互促进,共同推动人工智能技术的进步与应用落地。
1.2 私有化部署的核心价值
私有化部署的核心价值主要体现在数据安全可控、定制化与成本优化、以及满足特定业务需求三个方面,这些价值使其成为对数据安全、合规性及性能有高要求企业的关键选择。
一、数据主权与安全可控
私有化部署最核心的价值在于企业能够完全掌握数据主权,确保敏感数据不出企业边界,从而满足严格的合规要求。企业可以将云计算基础设施及配套软件系统部署在自有数据中心或指定的物理环境中,形成独立于公有云的专属云环境。这种方式让企业能够自主控制数据的存储位置、访问权限及加密方式,有效规避因第三方云服务商的数据共享政策或跨境传输规则引发的合规风险。例如,金融、医疗、政府等行业对数据本地化存储有明确法规要求,私有化部署能够确保数据不流出指定物理边界。此外,私有化环境支持部署零信任架构、数据加密(如国密SM4算法)和审计日志等安全加固措施,进一步保障数据安全。
二、定制化、性能优化与成本可控
私有化部署允许企业根据自身业务需求进行深度定制和性能优化,同时从长期视角实现总成本的可控。
- 定制化与深度集成:企业可以灵活调整云平台架构,集成内部业务系统(如ERP、OA),或为特定场景(如制造业的物联网设备管理、医疗机构的电子病历系统)定制功能模块,实现与现有工作流程的无缝对接。
- 性能优化与稳定性:私有化环境避免了公有云多租户架构下的资源争抢问题,能够为关键业务(如高频交易系统、实时交互平台)提供稳定的高性能和低延迟保障。同时,服务摆脱了对公网连接的依赖,规避了网络波动或第三方服务故障导致的中断风险,提升了服务的稳定性和可靠性。
- 长期成本可控:虽然私有化部署需要较高的初期硬件和建设投入,但对于计算资源需求稳定且规模较大的企业,其长期总拥有成本(TCO)可能低于公有云按需付费的模式。企业无需持续支付高昂的API调用或订阅费用,投资一次性完成后,后续使用成本更为可控。
三、满足特定行业与业务场景需求
私有化部署尤其适合对数据安全、合规性及性能有极端要求的行业和场景。
- 监管密集型行业:金融、医疗、政府及公共事业等领域,因法规要求必须将数据存储在本地或指定境内数据中心,私有化部署是满足《数据安全法》、《网络安全法》、GDPR等合规要求的必要手段。
- 对性能与延迟敏感的业务:例如证券公司的交易系统、实时在线教育平台、智能工厂的实时监控等,需要毫秒级响应,私有化部署可通过定制硬件和网络架构(如低延迟网络、内存数据库)来保障极致性能。
- AI大模型的落地应用:对于使用大模型的企业,私有化部署能确保训练和推理过程中的核心业务数据、模型资产不被泄露,是应对数据安全挑战、保护商业机密和用户隐私的关键方案。DeepSeek等开源大模型的支持,进一步降低了企业私有化部署AI的门槛和成本。
综上所述,私有化部署的核心价值在于为企业构建了一个安全、专属、可控且高效的数字化底座。它不仅是技术选型,更是企业数字化战略的重要组成部分,帮助企业在保障安全合规的前提下,充分利用技术的弹性与效率,构建核心竞争力。
1.3 开源生态体系
大模型开源生态体系是一个由技术框架、开源社区、协作平台、工具链和产业应用共同构成的复杂生态系统,它正在深刻改变人工智能技术的发展模式和国际竞争格局。以下从多个维度对这一生态体系进行详细分析:
一、 开源生态的核心理念与战略价值
中国的大模型开源战略并非简单的技术开放,而是一条通过开源推动技术普惠、培育开放包容产业生态、重塑国际科技合作格局的差异化发展道路。这与美国主导的、以“技术霸权”为特征的闭源生态形成了鲜明对比。中国倡导的“开源生态+闭源核心”混合模式,强调技术共享与商业价值的平衡,其本质是“用开放换取生态,用生态反哺技术”。
这种战略的底气源于中国在AI基础设施上的长期投入和体系化建设。自2017年《新一代人工智能发展规划》发布,到“十四五”规划明确纳入开源内容,中国已构建了覆盖芯片、算法、数据、平台、应用的全产业链体系,核心产业规模接近6000亿元,软件开发者数量突破940万,开源参与者数量全球第二。这种全产业链协同能力,使得企业无需依赖单一技术壁垒,而能通过开放生态扩大技术影响力。
二、 开源生态的核心组成部分
一个成熟的开源生态体系包含以下关键层次:
- 基础技术框架与开源项目:这是生态的技术基石。其核心围绕Transformer架构,并衍生出稀疏注意力、混合专家(MoE)等优化变体。训练流程依赖分布式训练(如数据并行、模型并行)、混合精度训练及ZeRO优化等技术。在推理与部署层,则依靠量化、模型压缩及推理加速框架(如vLLM、TGI)。开源社区涌现了大量关键项目,例如:
- 模型架构:Meta的LLaMA系列、阿联酋TII的Falcon、Mistral AI的Mixtral以及中国的DeepSeek、阿里的Qwen系列、百度的文心大模型等。
- 训练优化框架:Microsoft的DeepSpeed、NVIDIA的Megatron-LM、Colossal-AI等。
- 工具链:Hugging Face的Transformers、Datasets、Accelerate全家桶,以及LangChain、Llama.cpp等。
- 开源社区与协作平台:这是生态的活力源泉和协作枢纽。
- 国际社区:以Hugging Face为代表,已成为全球最大的开源模型社区,提供模型托管、数据集共享和协作工具。
- 国内社区:中国正积极构建自主开源生态。ModelScope(魔搭)社区由阿里巴巴推动,已汇聚超1000个优质中文模型。更为重要的是,中国正在打造新一代一体化基础设施平台,例如AtomGit人工智能开源社区,旨在提供覆盖“代码+模型+环境+算力”的全流程服务体系,支持国产芯片和主流深度学习框架,以提升AI工程化能力,打通从创新到落地的通道。
- 专项协作平台:针对特定瓶颈问题,出现了如魔乐社区发起的“模型推理适配协作计划”。该计划旨在以开源协作模式,集结开发者与产业链力量,解决大模型在国产算力平台上的适配难题,构建从“模型架构-权重-推理代码-推理引擎-计算平台”的全链条开源协作模式,填补传统AI平台“重模型、轻协作”的空白。
- 算力与硬件生态:开源生态的繁荣离不开底层算力支撑。中国企业的开源底气在于其算力平台的技术突破,包括AI大模型训练、高性能计算集群和国产芯片生态建设。开源生态与国产算力正在形成深度协同。例如,魔乐社区的适配计划联动壁仞科技、海光、摩尔线程、昇腾等国产算力厂商,旨在让大模型真正“跑遍中国芯”,推动算力自主化。
三、 开源生态的运作机制与商业逻辑
开源生态通过独特的机制实现价值创造和可持续发展:
- “开源+商业服务”的复合模式:这已成为主流商业模式。企业开源基础模型,降低技术应用门槛,吸引大量开发者和企业进入生态。中小开发者可依托低成本开源模型快速部署和开发;大型企业则可使用高参数版本或寻求定制化服务。开源企业则通过提供云服务、算力租赁、技术支持、企业级解决方案等增值服务实现盈利,形成“开源—应用—反馈—商业变现”的良性循环。例如,阿里云通过开源通义千问大模型吸引了大量开发者,进而带动了其云服务的使用。
- 技术普惠与全球协作:开源极大地降低了AI技术的获取门槛和应用成本。例如,DeepSeek-V3模型的训练成本远低于闭源模型,但性能却可与之相当,使得大模型领域从“重资本游戏”走向“全民共创平台”。在全球范围内,中国的开源大模型为基础设施薄弱、人才匮乏的全球南方国家提供了低成本、易部署的解决方案,助力其数字化转型,例如华为云的天气预测模型、MiniMax的多语种语音模型等。
- 创新加速与反馈迭代:开源模式打破了“闭门造车”的旧模式,促成了“创新—共享—再创新”的飞轮效应。全球开发者可以自由使用、修改、改进模型,并反馈问题,这极大地加速了技术迭代和问题修复的速度。开源模型的透明性也使得安全漏洞能够被社区快速发现和修复。
四、 开源生态的影响与未来趋势
- 重构全球AI治理话语权:中国通过开源构建的“技术共享、生态共建、价值共创”新范式,正在挑战旧有的技术垄断格局。DeepSeek等中国开源模型在全球的流行,推动了全球AI技术从“单极霸权”转向“多极共生”。
- 驱动产业应用落地:开源模型凭借其低成本、高性能、高开放度的优势,正加速人工智能在千行百业的普及。从金融领域的恒生电子接入DeepSeek实现自动文档解析,到中国科学院基于通义千问打造天文大模型“星语3.0”控制望远镜观测,开源模型正在深度赋能实体经济。
- 未来趋势:开源生态将继续向更高效的架构(如MoE)、多模态融合以及小型化与边缘部署演进。同时,生态建设将更加注重全链条协同,覆盖从数据、算力、模型到应用的各个环节。国家层面也将继续强化政策支持,完善开源生态体系建设,培养开源人才,并深化国际合作。
总结而言,大模型开源生态体系是一个以开放协作、技术共享为核心,融合了技术创新、社区运营、商业变现和全球合作的复杂网络。中国的开源实践表明,通过构建强大的开源生态,不仅可以加速本国AI产业发展、培育新质生产力,还能在全球科技治理中提供一种更加开放、普惠、协作的新范式,引领一个更加多元共生的AI时代到来。
1.4 行业模型分析
当前,大模型技术正从追求通用能力的“炫技”阶段,加速向解决实际业务问题的“有用”阶段演进。这一转变的核心特征是垂直化与专业化,即大模型在横向(行业覆盖)上不断拓宽,在纵向(场景深度)上更加聚焦。行业大模型不再是通用能力的简单微调,而是深度融入行业知识、业务流程和特定场景,以解决“不可能三角”——即同时兼顾专业性、泛化性和经济性的难题。以下将从发展特征、典型行业应用、挑战与未来趋势几个方面进行分析。
一、 核心发展特征:从“微笑曲线”到全链条渗透
行业大模型的应用渗透呈现出明显的 “微笑曲线”特征。即位于产业链高附加值两端的研发/设计和营销/服务环节,由于数字化基础好、数据积累丰富、通用性强,大模型渗透率最高、落地最快。而位于中间、附加值较低的生产制造环节,因场景复杂、标准化程度低、对可靠性和物理交互要求高,应用速度相对较慢。
- 高渗透率领域(微笑曲线两端):
- 营销与客户服务:这是应用最成熟的领域。无论是电商的数字人客服、广告行业的文案与素材生成,还是金融、保险业的智能营销与客户服务,都已形成成功案例。例如,标普智元的“超级销售助手”能提供真人陪伴式体验,提升转化率;多家银行的AI客服助手已服务千万级客户。
- 知识管理与办公效率:大模型作为企业内部“百事通”,在文档处理、知识问答、流程审批等方面大幅提升效率。例如,标普智元的“超级办公助手”和“超级知识专家”能处理财务、法务、人事及规章制度问答;在金融领域,大模型被用于合同解析、估值对账、报告撰写等,将信贷审核效率提升20%,并减少大量人工工时。
- 快速成长与攻坚领域(微笑曲线中部及延伸):
- 研发与设计:AI正在成为创新的加速器。在工业设计、代码生成、药物研发等领域,大模型能提供创意辅助和方案模拟。
- 生产与运营:这是目前挑战最大但潜力巨大的领域。应用集中在流程优化、质量检测和设备维护。例如,华为盘古大模型已应用于钢铁、高铁行业,进行工艺优化;视觉大模型用于传送带异物检测、偏光片质检等。然而,在复杂物理场景(如非标准化的农业采摘、山地作业)中,机器人的灵活性和适应性仍是痛点。
- 风险管理与合规:在金融、医疗等强监管行业,大模型的价值凸显。银行利用大模型进行智能风控、反欺诈、反洗钱,构建“大模型+小模型”的双引擎体系,实现风险智能化排查预警。在合规方面,大模型能自动审查合同、监测交易,降低操作风险。
二、 典型行业应用深度分析
- 金融行业:降本增效与智能风控的双轮驱动 金融业是大模型落地最积极、场景最丰富的行业之一,其核心诉求是降本增效、控制风险、提升服务。
- 应用场景:已从早期的智能客服,深入扩展到智能信贷审核、合同管理、资产估值对账、投资研究、合规风控等核心业务环节。例如,江苏银行、苏商银行利用DeepSeek多模态模型将信贷材料识别准确率提升至97%以上,全流程效率提升20%。工商银行推出的“智贷通”AI智能体矩阵,实现了信贷风险的智能化分析。
- 部署模式:呈现两极分化。大型银行资金雄厚,多采用“自研底座+引入开源模型”的双轨策略,以工行“工银智涌”、邮储“邮智”为代表,构建了丰富的大模型矩阵。中小银行则更依赖与外部服务商合作,利用DeepSeek等高性价比的开源模型进行本地化微调,快速获得能力,缩小与大行的差距。
- 核心挑战:数据安全与合规是首要考量。金融机构普遍要求大模型的精调和应用必须在本地私有化环境中进行,防止数据泄露。同时,还需应对模型的“幻觉”风险、算法歧视以及不断变化的监管要求。
- 医疗行业:提升诊疗效率与普惠基层医疗 医疗大模型的核心价值在于辅助诊断、提升效率、资源下沉,其应用对准确性和可靠性要求极高。
- 应用场景:覆盖“诊前-诊中-诊后”全链条。诊前,AI智能分诊和预问诊能精准引导患者,节省时间。诊中,AI辅助诊断系统能快速提供鉴别诊断建议(如8秒给出心内科辅助诊断),并智能生成病历,将医生写病历时间平均缩短40%。在病理分析和重症监护等专业领域,AI能快速筛查海量数据,为医生提供关键决策参考(如判断ECMO撤机时机)。诊后,AI用于合理用药审查、慢病管理和智能随访。
- 部署模式与效果:通常采用“医疗垂域大模型+通用大模型”双模型融合部署,以兼顾专业性与通用知识。例如,宁夏银川的医院通过部署DeepSeek等系统,实现了诊疗业务全流程AI覆盖率达65%以上,病历规范率从不足70%提升至96%以上,并修正了大量不合理诊断与处方,显著提升了基层医疗服务质量。
- 核心挑战:平衡技术赋能与患者隐私保护、确保算法的公正透明与可解释性是关键。所有应用需在严格合规和数据脱敏的前提下进行。
- 工业与制造业:聚焦细分场景,解决具体问题 工业领域场景复杂、非标准化程度高,大模型应用更强调 “小而精” ,解决具体痛点。
- 应用特点:不追求通用对话,而是聚焦于质量检测(AI质检)、工艺优化、预测性维护、供应链管理等细分场景。例如,华为盘古大模型在钢铁、高铁行业进行工艺优化;视觉模型用于检测产品缺陷。
- 主要挑战:场景碎片化、数据获取难、投入产出比(ROI)核算难。生产线上的问题极其具体(如“检测特定型号零件上的特定划痕”),需要针对性的小模型或解决方案。同时,工业环境对模型的稳定性、实时性和可靠性要求严苛,且初期硬件投入(如智能机器人、传感器)成本较高,投资回报周期不明确,导致企业决策谨慎。
三、 面临的挑战与未来趋势
尽管前景广阔,但行业大模型的规模化落地仍面临多重挑战:
- 企业核心顾虑:经济性、可靠性与实用性。企业部署大模型面临高昂的算力成本、模型调优成本和人才成本,若不能明确看到对实际业务的赋能和盈利前景,投入会非常谨慎。算力租赁费用高昂,且全球市场被海外巨头垄断,获取可靠算力存在掣肘。
- 需求匹配与数据难题。企业不清楚AI如何具体赋能业务,需要AI专家与业务专家深度协同挖掘场景。同时,高质量、结构化的行业数据稀缺,通用模型直接套用准确率不足,企业需进行二次训练,但前提是自身必须具备良好的数字化系统和数据治理基础。
- 未来趋势:
- 从工具到智能体(Agent):大模型正从被动应答的工具,向能自主理解、规划并执行复杂任务的智能体演进。标普智元等厂商已推出覆盖财务、销售、知识管理等多场景的“超级助手”智能体。
- “开箱即用”的解决方案:未来,厂商将更多以集成化的AI工具或解决方案形式交付,降低企业“从0到1”的应用门槛,直接解决业务问题。
- 国产算力与模型协同:为突破算力瓶颈,国内AI芯片厂商(如中昊芯英)正加速研发,提供成本更低的算力方案。开源大模型(如DeepSeek)的普及,与国产算力生态形成协同,共同推动技术自主化与应用普惠化。
总结而言,行业大模型的发展已进入深水区,其成功不再取决于参数大小,而在于对行业知识的深度理解、与业务流程的紧密融合,以及能否切实解决成本、可靠性和易用性的“最后一公里”问题。未来,深度融合、场景为王、价值导向将成为行业大模型发展的主旋律。
1.5 本地部署实战方案
基于您提供的背景资料和搜索结果,本地部署大模型已成为企业实现数据安全、成本控制和定制化需求的关键路径。以下将结合不同部署场景,从硬件选型、工具选择到具体实施方案进行系统梳理。
一、 个人与轻量级开发部署方案
对于个人开发者、小型团队或业务验证场景,轻量级部署方案以低成本、易上手为核心特点。
1. 核心工具与平台
- Ollama:作为当前最流行的本地大模型运行工具,Ollama支持macOS、Windows和Linux三大操作系统,提供了一键式安装和模型管理能力。其命令行界面简洁,通过 ollama run deepseek-r1 等命令即可快速启动模型服务。
- Llama.cpp:另一个高效的本地推理框架,特别擅长在CPU和有限显存的设备上运行量化模型。
- Chatbox/Page Assist:作为本地模型的交互界面,Chatbox支持配置Ollama API,提供图形化聊天体验;Page Assist则是浏览器插件,功能更丰富,支持本地知识库建设。
2. 硬件配置建议
- 最低配置:16GB内存 + 8GB显存(如RTX 3060级别)
- 推荐配置:32GB内存 + 16GB显存(如RTX 4060 Ti 16GB或RTX 4070 Super)
- 对于参数规模在7B-14B的模型(如DeepSeek-R1 7B、Qwen2.5-7B),上述配置可流畅运行;若需运行32B参数模型,则需要24GB及以上GPU配置。
3. 典型部署流程(以DeepSeek-R1为例)
- 环境准备:安装Ollama(Linux示例: curl -fsSL https://ollama.com/install.sh | sudo bash )
- 模型下载:访问Ollama模型库( https://ollama.com/library/deepseek-r1 ),复制安装命令
- 运行服务:执行 ollama run deepseek-r1 ,等待模型加载完成
- 验证测试:通过交互式对话或API调用(默认地址: http://localhost:11434 )测试模型功能
- UI集成:配置Chatbox等前端界面,连接本地Ollama服务
4. 知识库增强方案
对于需要结合私有知识的企业场景,可搭配Dify等开源平台构建本地知识库:
- 通过Docker Compose部署Dify: git clone 代码后,在docker目录执行 docker compose up -d
- 配置向量数据库(如Weaviate),上传企业内部文档
- 实现基于RAG(检索增强生成)的专业化知识问答、文档分析等能力
二、 企业级私有化部署方案
对于中大型企业,尤其是金融、政务、医疗等对数据安全有高要求的行业,私有化部署需要更完整的解决方案。
1. 部署模式选择
根据企业规模、安全要求和预算,主要有以下几种模式:
| 部署模式 | 核心特点 | 适用场景 | 代表方案 |
|---|---|---|---|
| 私有云HCS方案 | 基于昇腾&鲲鹏算力和华为云Stack构建,数据不出域,安全可控 | 对数据隐私和安全要求高、需要自主控制AI环境的企业 | 云鼎科技+华为联合方案 |
| 一体机方案 | 开箱即用,软硬件深度融合,预置模型和应用 | 追求快速部署、降低运维复杂度、数据安全敏感的企业 | 京东云DeepSeek一体机、永信至诚元方一体机 |
| EIC调优舱方案 | 裸机部署,轻量化、低成本,非云依赖 | 预算有限、希望控制初期投入、具备一定技术能力的企业 | 云鼎科技调优舱方案 |
| 混合云/专属云方案 | 结合公有云敏捷性和私有云安全性,灵活调配资源 | 业务波动大、需要弹性扩展的企业 | 优刻得智算云平台 |
2. 硬件配置与算力要求
- 中等规模企业:双路RTX A6000(48GB×2显存)+ 128GB内存,可支持70B参数模型推理
- 大规模生产环境:4×A100/H100(80GB×4显存)或国产昇腾910集群,支持200B+参数模型训练与推理
- 新兴桌面级方案:如超聚变FusionXpark™,内置NVIDIA GB10芯片,单台算力达1 PFLOPS,支持200B参数模型推理,适合中小企业本地部署
3. 关键技术考量
- 模型选择与适配:企业可根据需求选择DeepSeek-R1满血版、DeepSeek-V3、QwQ-32B、GLM4等不同模型。永信至诚元方一体机支持多模型灵活切换,确保不同业务场景获得最优AI支持。
- 国产化适配:京东云一体机支持华为昇腾、海光、寒武纪、摩尔线程、天数智芯等国产AI芯片,满足自主可控要求。
- 安全加固:需实施全栈安全措施,包括硬件安全基线、数据加密(如国密SM4)、权限管控、审计日志等。永信至诚的方案强调“原生安全”,从设计之初注入安全基因,通过数字风洞进行多轮深度安全测试。
4. 部署实施步骤
- 需求分析与方案设计:明确业务场景、数据规模、性能要求、安全等级
- 基础设施准备:部署服务器、存储、网络,配置虚拟化或容器平台
- 模型部署与优化:
- 通过Hugging Face或厂商渠道获取模型权重
- 使用vLLM、Triton等推理框架部署服务: python -m vllm.entrypoints.api_server --model deepseek-ai/deepseek-v3
- 实施量化、剪枝等优化技术降低资源消耗
- 知识库与智能体集成:
- 构建企业专属知识库,支持多格式文档导入
- 开发或配置智能体,如永信至诚元方一体机预置12个智能体,覆盖100个应用场景
- 实现与OA、CRM等业务系统对接
- 监控与运维:建立资源监控、性能监控、安全审计体系,确保服务稳定性
三、 行业最佳实践与案例参考
1. 金融行业部署实践
- 华福证券:已成功接入DeepSeek-V3和R1,赋能员工知识问答、辅助软件研发、营销方案制定等场景
- 国金证券:完成DeepSeek本地化部署测试,计划应用于信息检索、文档处理、行业研究、智能服务、风险管理等核心业务
- 关键考量:数据不出域、模型合规性、实时风控能力。通常采用私有云或一体机方案,确保交易数据、客户信息绝对安全。
2. 能源与工业领域实践
- 云鼎科技矿山大模型:基于DeepSeek打造垂域矿山大模型,提供公有云、私有云、调优舱、一体机四种方案
- 应用场景:安全生产、设备管理、应急救援等,已构建110余类AI场景,在70余家单位规模化推广
- 部署特点:强调数据本地化、模型私有化、落地快速化,适应矿山等网络条件有限的工业环境
3. 政务与公共服务
- 优刻得DeepSeek一体机:针对政务等高数据敏感场景,实现“本地化开箱即用”,支持政务文档分析、智慧审批等应用
- 安全要求:公民隐私数据本地化存储,符合《数据安全法》要求,通过安全沙盒隔离潜在风险
四、 成本优化与性能调优策略
1. 成本控制方案
- 初期成本优化:EIC调优舱方案采用裸机部署,蒸馏模型4节点起步,满血版模型7节点起步,有效降低初期投入
- 长期TCO管理:私有化部署虽需较高初期投资,但长期看避免了持续的API调用费用。优刻得一体机方案可降低部署与运维成本达80%
- 硬件选型平衡:根据业务负载选择合适配置,避免过度投资。32B参数模型需要24GB+显存,70B模型需要更高配置
2. 性能优化技巧
- 模型蒸馏与量化:使用蒸馏版模型(如DeepSeek-R1-Distill)在保持性能的同时降低资源需求
- 推理加速:采用vLLM的PagedAttention、连续批处理等技术提升吞吐量
- 硬件协同优化:京东云一体机通过软硬件融合调优,量身定制推理加速方案
- 资源调度:使用Kubernetes实现弹性扩缩容,根据负载动态调整副本数
五、 未来趋势与建议
- AIPC与边缘计算融合:随着DeepSeek引爆本地部署热潮,PC巨头纷纷响应。联想AIPC“小天”已接入DeepSeek,微软将优化版DeepSeek R1接入Windows 11 Copilot+ PC。未来,AIPC将成为个人和轻量级企业部署的重要载体。
- 标准化与生态建设:厂商正推动“开箱即用”的一体化解决方案,如京东云、永信至诚、优刻得等推出的一体机产品,大幅降低技术门槛。超聚变FusionXpark™等随身智能体平台,让算力从数据中心走向桌面。
- 混合架构成为主流:企业将根据数据敏感性、业务实时性要求,采用混合部署策略。非敏感数据使用公有云方案快速上线,核心业务数据采用私有化部署确保安全。
- 实施建议:
- 明确业务优先级:优先在“微笑曲线”两端(研发设计、营销服务)等高价值场景试点
- 分阶段推进:从轻量级POC开始,验证效果后逐步扩大规模
- 重视数据治理:确保训练数据质量,建立数据标注和清洗流程
- 培养复合人才:组建既懂AI技术又熟悉业务的团队,或与云鼎科技等专业服务商合作
总结而言,本地部署大模型已形成从个人开发到企业生产的完整技术栈。企业应根据自身的数据安全要求、技术能力、预算规模和业务场景,选择合适的部署模式。随着一体机、AIPC等“开箱即用”方案的普及,以及国产算力生态的成熟,大模型本地部署的门槛正在快速降低,为千行百业的智能化转型提供了切实可行的技术路径。
第二章:微调数据准备与预处理
2.1 数据分类与配对规范
在构建大模型微调数据集时,科学的数据分类与严谨的配对规范是确保模型学习效果和泛化能力的基础。根据搜索结果和行业实践,微调数据主要可分为以下几类,并需遵循特定的配对规范。
一、 核心数据分类
微调数据可根据其任务目标和交互形式,主要分为以下三类:
- 指令遵循数据 这类数据旨在训练模型理解并精确执行明确的指令。其核心格式通常为三元组结构: {“instruction”: “任务描述”, “input”: “输入内容”, “output”: “期望输出”} 。例如,一个翻译任务的样本可以是: {“instruction”: “将中文翻译成英文”, “input”: “今天天气很好”, “output”: “The weather is nice today.”} 。这类数据要求指令清晰、输入明确、输出标准,是训练模型基础能力(如翻译、总结、分类)的关键。为了达到良好的微调效果,通常需要准备至少1000-5000条高质量样本。
- 对话数据 对话数据用于训练模型进行多轮、连贯的交互。其格式需要模拟真实的对话流程,通常以列表形式组织,包含交替的用户( user )和助手( assistant )发言,例如: [{“role”: “user”, “content”: “问题”}, {“role”: “assistant”, “content”: “回答”}] 。构建高质量的对话数据面临诸多挑战,例如直接让大模型自由生成容易导致话题单一、内容重复。因此,需要系统性地设计对话主题和任务类型。例如,清华开源的UltraChat项目通过让两个独立的ChatGPT API相互对话来生成数据,并系统覆盖了“关于世界的问题”、“写作与创作”和“对于现有资料的辅助改写”三大类主题,以确保数据的多样性和广度。对话的轮次建议控制在3-8轮,以保持连贯性,避免因对话过长导致关键信息丢失或模型注意力分散。
- 领域专业知识数据 这是使大模型具备垂直领域能力的关键。数据来源于特定行业的专业知识库,如电力系统的设备参数表、运维手册和故障记录,或医疗领域的病历摘要、医学文献和药品说明书。这类数据的处理不仅在于收集,更在于深度的结构化与标注。例如,在构建心理咨询师数字孪生模型时,华南理工大学的SoulChat2.0项目不仅使用真实咨询案例,还结合了心理咨询技术知识库,并分析来访者的大五人格特质,以生成能模拟特定咨询师语言风格和疗法技术的专业对话数据。对专业术语进行实体识别和标注,是提升模型在该领域认知准确性的重要步骤。
二、 高级数据分类与构建方法
随着多模态和复杂交互需求的增长,数据分类也呈现出更精细和综合的趋势:
- 多模态与多轮对话理解数据 为了训练大型视觉语言模型(LVLM)处理更接近现实的复杂场景,需要构建能够同时处理多张图像并进行多轮对话的数据集。例如,MMDU数据集包含了最多20张图像和长达27轮的问答对话,总token数可达18k,旨在评估和提升模型在长上下文、多图理解方面的能力。这类数据的构建通常需要从开源资源(如维基百科)中选取图文信息,并借助先进模型(如GPT-4o)辅助生成高质量的多轮对话。
- 数字孪生与风格化对话数据 在高度专业化的领域(如心理咨询),目标是训练模型模拟特定个体的风格,而不仅仅是完成通用任务。这需要一种新的数据构建范式。SoulChat2.0项目定义的“心理咨询师数字孪生”任务,仅需给定该咨询师的少量真实案例(如12个),通过大模型提取其语言风格和咨询技术偏好,再结合知识库和人格分析,批量生成用于微调的高保真对话数据。这种方法实现了用低成本生成高质量、风格化的专业数据。
三、 数据配对的核心规范与质量保障
无论数据属于哪一类别,在配对和构建时都必须遵循以下核心规范:
- 指令-输出对齐规范:对于指令数据,必须确保输出是输入在给定指令下的唯一或最优解。避免模糊指令导致模型困惑。
- 对话连贯性与角色一致性规范:在对话数据中,助手的回复必须与上下文逻辑连贯,且角色立场、知识水平和语言风格在整个对话中保持一致。多轮对话的构建应避免话题无故跳跃或信息前后矛盾。
- 事实准确性与专业性规范:对于领域知识数据,所有信息必须基于权威来源,并经过领域专家校验。特别是在医疗、法律等领域,数据的准确性至关重要。
- 安全与伦理规范:所有数据需经过严格的过滤,去除涉及偏见、歧视、暴力或违法违规的内容。在构建如心理咨询对话数据时,需特别注意伦理要求和隐私保护。
- 多样性平衡规范:数据应覆盖尽可能多的任务类型、话题领域和语言风格。例如,UltraChat通过设计元主题、子主题和具体问题三层结构,并引入大量命名实体,来确保生成数据的广泛覆盖。
总结而言,大模型的微调数据准备是一个系统工程。需要根据目标任务(指令遵循、多轮对话、专业领域)对数据进行精细分类,并严格遵守相应的配对格式与质量规范。同时,借鉴前沿研究中的方法(如多模型对话生成、风格提取与合成、多模态长上下文构建),可以更高效地构建出高质量、多样化、专业化的微调数据集,为模型性能的跃升奠定坚实基础。
2.2 优质数据集推荐
一、 通用指令与对话数据集
这类数据集旨在提升模型的通用指令遵循和对话能力,是进行基础微调的核心资源。
- Alpaca及其衍生数据集
- 核心介绍:由斯坦福团队发布的开创性工作,包含约52K条由 text-davinci-003 生成的指令-输出对,格式为 (instruction, input, output) ,覆盖了广泛的通用任务。
- 中文变体:存在多个中文翻译或优化版本,例如 carbonz0/alpaca-chinese-dataset (机器翻译)和 hikariming/alpaca_chinese_dataset (经过人工精调),为中文模型训练提供了重要基础。
- UltraChat与UltraFeedback
- UltraChat:一个大规模、高质量的对话数据集,通过让两个大语言模型相互对话生成,覆盖了丰富的话题和任务类型,是训练模型多轮对话能力的优质资源。
- UltraFeedback:一个大规模、细粒度的偏好数据集,专为训练奖励模型和批评模型设计,支持PPO和DPO等对齐训练方法。它收集了数万条提示,并利用多个模型生成响应,最后由GPT-4根据指令遵循、真实性等维度进行精细标注。
- 中文版本: OpenCSG/UltraFeedback-chinese 是根据相同方法构建的中文版本,从多个中文资源收集了约58K条指令,并由先进模型进行评分,同样提供了适用于DPO训练的Binarized版本。
- ShareGPT数据集
- 核心介绍:一个由真实用户与ChatGPT的对话分享构成的高质量数据集,包含了大量自然、多样的多轮对话,对于提升模型的对话流畅度和实用性非常有价值。
二、 大规模、多语言与多模态数据集
这类数据集规模宏大,覆盖语言或模态广泛,适合训练具备更强泛化能力和跨领域理解能力的模型。
- MURI-IT
- 核心介绍:一个大规模多语言指令调优数据集,包含超过220万条指令-输出对,涵盖200种语言。其关键创新在于通过“多语言逆向指令生成”方法构建,避免了直接翻译带来的文化失真和语言生硬问题,更好地保留了语言与文化的细微差别。
- LLM Fine-Tuning Dataset - Question Answering
- 核心介绍:一个专注于问答任务的大规模语言模型微调数据集,包含超过400万条记录,涵盖32种语言。它包含了来自多个模型的日志和响应对,旨在通过指令微调提升模型在各种自然语言处理任务上的性能。
- Infinity-MM
- 核心介绍:一个大规模多模态指令数据集,包含数千万个样本。数据集经过严格的质量过滤和去重,具有高多样性和高质量。它分为多个阶段,整合了图像-字幕、通用视觉指令、选择性视觉指令以及GPT4合成数据等多种类型,支持中英双语。
- Leopard-Instruct
- 核心介绍:由腾讯AI实验室创建的多模态指令数据集,旨在解决多模态任务中的指令遵循问题。它包含92.5万个实例,其中73.9万个专门针对文本丰富的多图像场景,为训练如Leopard-LLaVA等多模态理解与生成模型提供了全面资源。
三、 高质量中文与合成数据集
针对中文NLP领域高质量数据稀缺的挑战,近年来涌现了一批优秀的数据集。
- OpenCSG系列中文数据集
- SmolTalk-Chinese:一个仿照Hugging Face的SmolTalk构建的中文合成微调数据集,完全由合成数据组成,涵盖超过70万条数据。它覆盖了信息查询、推理、编程、数学、创意写作等十余种任务类型,并通过严格的生成、筛选和去重流程确保质量,旨在全面提升中文模型的多任务能力。
- Chinese Fineweb Edu, Chinese Cosmopedia:OpenCSG社区开源的一系列高质量中文预训练数据集,为中文大模型的预训练提供了宝贵的语料资源。
- BELLE Group 数据集
- 核心介绍:链家(BELLE Group)利用Self-Instruct方法,基于ChatGPT生成的一系列中文指令数据集。其中 YeungNLP/firefly-train-1.1M 包含了115万条数据,覆盖23个常见任务,并由人工设计了多种指令模板以保证质量。此外还有 train_0.5M_CN (约50万条)和 multiturn_chat_0.8M (多轮对话)等变体。
- COIG (Chinese Open Instruction Generalist)
- 核心介绍:由北京智源人工智能研究院等机构发布的高质量、可商用的中文指令数据集。第一期包含5个子集(翻译指令、考试指令、人类价值观对齐指令等),总计191K数据,聚焦中文语料、类型多样且经过人工质检修正,数据质量可靠。
- CCI (中文互联网语料库)
- 核心介绍:由北京智源人工智能研究院牵头,二十多家机构联合打造的中文领域最大规模开源高质量语料库项目。其通过创新的多分类器质量评估、大规模思维链(CoT)数据合成以及全方位安全过滤技术,构建了总量约37T的高质量数据。其中的中文高质量子集在评测中效果稳定超越其他开源中文数据集。
四、 专业领域与特定任务数据集
这类数据集专注于提升模型在垂直领域或特定复杂任务上的能力。
- OpenMathInstruct-2
- 核心介绍:一个大规模的数学指令调优数据集,包含1400万个问题-解决方案对。数据是通过使用 Llama3.1-405B-Instruct 模型,基于GSM8K和MATH训练集的问题进行“解决方案增强”和“问题-解决方案增强”而生成的,旨在显著提升模型的数学推理和解题能力。
- distilabel-reflection-tuning
- 核心介绍:一个使用Distilabel工具创建的合成数据集,专门用于AI模型的反思调优。它包含指令、模型名称和生成的输出示例,旨在训练模型分析和生成对复杂概念(如结合咖啡店、书店和餐厅的想法)的深度响应。
- 垂直领域数据集
- 医疗领域:例如 Med-ChatGLM (通过医学知识图谱和GPT-3.5 API构建的中文医学指令数据集)以及英文的 ChatDoctor 、 HealthCareMagic-100k 等。
- 法律领域:例如上海交大收集整理的 awesome-chinese-legal-resources 中国法律数据资源。
总结与选择建议:
- 入门与通用能力:可从Alpaca(中文版)、BELLE或SmolTalk-Chinese开始,快速获得指令遵循和对话基础能力。
- 追求高性能与对齐:UltraFeedback-Chinese是进行偏好对齐训练(DPO/RLHF)的顶级选择。
- 多语言与国际化:MURI-IT和LLM Fine-Tuning Dataset提供了覆盖数十至上百种语言的优质指令数据。
- 复杂推理与专业领域:OpenMathInstruct-2专攻数学推理,CCI提供了包含思维链的高质量通用语料,而医疗、法律等垂直数据集则能满足专业需求。
- 多模态任务:Infinity-MM和Leopard-Instruct是训练视觉-语言模型的重要资源。
您可以根据模型微调的具体目标(通用对话、数学能力、多语言、多模态、垂直领域等),从以上类别中组合选用合适的数据集。更多数据集的详细信息和获取链接,建议直接访问Hugging Face、ModelScope等开源平台进行查询。
2.3 数据收集与清洗方案
在构建大模型微调数据集时,数据收集与清洗是决定模型最终性能与可靠性的基石。一个系统化、标准化的方案能够确保数据的高质量、高相关性和高安全性,为后续的模型训练打下坚实基础。以下将结合数据治理的核心理念,从数据收集、清洗、质量评估到治理合规,为您梳理一套完整的实战方案。
一、 数据收集:多源融合与策略性获取
数据收集的首要原则是多样性、相关性与合法性。数据来源应覆盖多个维度,以满足模型对复杂世界的理解。
- 多源数据采集框架 一个健壮的收集系统应能处理多种格式的数据源。核心流程包括:
- 结构化数据提取:从数据库、API接口、企业内部系统(如ERP、CRM)中获取。
- 非结构化文档解析:自动解析PDF、Word、PPT、Excel、HTML网页等格式,提取文本、表格和图片信息。这通常需要借助如 pdfplumber 、 python-docx 、 BeautifulSoup 等工具库。
- 开源数据集集成:利用如Hugging Face、ModelScope等平台上的高质量开源数据集(如前述的Alpaca、UltraChat、COIG等)作为基础语料补充。
- 合成数据生成:在特定领域数据稀缺时,可利用大语言模型(LLM)或生成对抗网络(GAN)等技术,基于种子数据或知识图谱生成符合要求的合成数据,以扩充数据量和多样性。
- 合法性困境与应对策略 数据收集面临严峻的合法性挑战,尤其是在涉及著作权、个人信息等权益时。传统“一对一授权”模式在海量训练数据面前几乎不可行。因此,制度建构需要从个体权利保护转向数据要素利用的思路。在实践中,可采取以下策略:
- 优先使用开源与授权数据:明确标注可商用(如CC-BY、Apache 2.0协议)的数据集。
- 合理使用与场景豁免探索:关注法律前沿,在符合“转换性使用”等合理使用原则的学术研究、非商业场景下审慎使用数据。
- 强化数据脱敏与匿名化:对收集到的个人信息进行彻底脱敏处理,移除直接标识符和准标识符,使其无法关联到特定个人。
- 建立内部合规审查流程:确保数据收集行为符合《生成式人工智能服务管理暂行办法》等法规要求,即数据来源合法,不侵害知识产权与个人信息权益。
二、 数据清洗与预处理:标准化的质量提升管道
原始数据通常包含大量噪声、不一致和错误,必须经过严格的清洗与预处理。
- 文本清洗标准化 清洗的目标是获得干净、格式统一的文本。关键步骤包括:
# 示例:基础文本清洗函数
import re


def clean_text(text):
    # 1. 去除HTML/XML标签、异常字符
    text = re.sub(r'<[^>]+>', '', text)
    text = re.sub(r'[\x00-\x08\x0b\x0c\x0e-\x1f\x7f]', '', text)
    # 2. 统一标点与空格(全角转半角,合并多余空格)
    text = re.sub(r'[,,]+', ',', text)
    text = re.sub(r'\s+', ' ', text).strip()
    # 3. 去除无意义的短句或广告文本
    if len(text) < 10: # 示例阈值
        return ''
    # 4. 语言检测与过滤(确保目标语言)
    # 可使用langdetect库
    return text
- 领域特定的预处理规范 不同行业的数据清洗有特殊要求。以电力系统为例,其数据准备规范要求:
- 数据去重:基于语义相似度(如使用Sentence-BERT计算向量,设定余弦相似度阈值>0.95)去除高度重复的样本。
- 格式统一:将所有数值、单位标准化(如统一为国际单位制),日期时间格式规范化。
- 异常值检测:使用统计学方法(如Z-score,阈值|Z|>3)或基于领域规则的检测,识别并处理异常数据点。
- 隐私与安全脱敏:对设备编号、地理位置、人员信息等敏感字段进行掩码、泛化或替换处理。
- 数据标注与增强 对于监督微调,需要构建高质量的(指令,输入,输出)配对数据。
- 指令模板化:设计清晰、无歧义的指令模板,覆盖多样化的任务类型。
- 数据增强:对现有高质量样本进行回译、同义词替换、句式改写等操作,在保持语义不变的前提下扩充数据量,提升模型鲁棒性。
三、 数据质量评估:构建可信的评估体系
清洗后的数据必须经过系统化评估。中国信通院发布的“可信AI”人工智能数据集质量评估体系2.0为此提供了权威框架。该体系采用“2+2+1+N”结构,核心评估维度包括:
- 通用基础质量指标:
- 说明文档:评估数据集的元数据完整性、使用许可清晰度等(7大类)。
- 前置数据质量:评估数据本身的质量,是核心维度,包括:
- 准确性:数据是否正确反映现实或标注意图。
- 完整性:关键字段或信息是否缺失。
- 一致性:数据是否符合预定义的格式、规则或逻辑。
- 唯一性:去除不应存在的重复数据。
- 时效性:数据是否在有效时间范围内。
- 相关性:数据与目标任务领域的关联程度。
- 模型应用:评估数据对模型性能的影响(4大类)。
- 行业专属质量体系: 针对金融、医疗、工业等不同行业,细化并开发专属的质量评估规则。例如,金融数据需额外关注数据的安全等级和合规性;医疗数据则对术语准确性和隐私保护有极高要求。
- 自动化评估与反馈验证: 采用“分层随机抽样+自动化评估+人工辅助校核”的方式,开发大量质量评估量化算子,自动化评估率可达80%以上。更重要的是,初步建立了数据质量与模型性能的反馈验证方法,通过“方升”大模型基准测试体系,量化分析不同质量指标对最终模型性能的影响,形成“高质量数据集供给—高效模型训练—可靠场景应用”的闭环优化生态。
四、 数据治理与全生命周期管理
以数据为中心的AI范式强调,数据治理应贯穿数据的全生命周期。这要求我们:
- 建立数据质量标准:参考国家统计局的《国家统计质量保证框架》,从真实性、准确性、完整性、及时性、一致性、可获得性等多个维度建立内部数据质量标准体系。
- 明确数据责任主体:借鉴《统计源头数据质量核查办法》,建立数据质量责任制,明确数据采集、清洗、标注、评估各环节的责任人,确保数据质量可追溯。
- 实现动态闭环优化:数据质量评估不是一次性的,而应是一个持续的过程。需要根据模型在应用中的表现反馈(如幻觉率、任务准确率),反向定位数据问题,并迭代优化数据收集与清洗策略,形成动态提升的闭环。
总结而言,一个优秀的数据收集与清洗方案,需要将技术流程的自动化(多源采集、智能清洗)、质量评估的系统化(可信AI评估体系)、以及治理合规的全局化(合法获取、全生命周期管理)三者紧密结合。只有这样,才能为训练出可靠、有用、安全的大模型提供坚实的数据燃料。
第三章:微调策略原理分析
3.1 全参微调 vs 参数高效微调
在微调大语言模型时,选择全参微调还是参数高效微调,是一个需要权衡计算成本、模型性能、数据量以及应用场景的核心决策。这两种方法在原理、开销和适用性上存在根本差异。
一、 核心原理与机制对比
- 全参微调:这种方法直接更新预训练模型的所有参数,使其完全适配下游任务。其本质是让模型在保留的通用知识基础上,通过新数据对全部权重进行二次优化,以追求在特定任务上的极致性能。
- 参数高效微调:这类方法的本质被清华大学研究团队概括为对“增量参数”进行调整。它冻结预训练模型的大部分原始参数,只对额外引入的一小部分新参数(即“增量”)进行训练。这些增量参数以特定方式(如适配器、低秩矩阵)与原始模型交互,从而实现高效的任务适配。
二、 计算成本与资源需求
这是两者最显著的差异点,直接决定了其应用门槛。
- 全参微调:计算和存储成本极高。以Llama3-70B这样的模型为例,全参微调可能需要8张A100 GPU训练7-14天,对显存、算力和存储都是巨大挑战,严重限制了其应用场景。
- 参数高效微调:其最大优势就是大幅降低资源需求。例如,LoRA等方法通常只训练模型总参数的0.1%到1%,这使得训练时间能减少50-80%,显存占用降低60-90%。最新的研究甚至表明,对于超大规模的基础模型,有时仅需优化万分之八的模型参数即可完成有效适配。
三、 性能表现与知识保留
不同的方法在最终效果上各有侧重。
- 全参微调:在数据量充足(例如超过10万高质量样本)且计算资源允许的情况下,全参微调通常能取得最佳的任务性能,因为它能最充分地利用新数据调整模型。
- 参数高效微调:其设计哲学是在性能与效率之间取得平衡。虽然可能无法达到全参微调的峰值性能,但PEFT方法通过冻结大部分预训练参数,能更好地保留模型的通用知识和能力,有效避免“灾难性遗忘”。一些先进的PEFT方法,如RoSA,通过结合低秩适应和高度稀疏的残差微调,在使用相同参数预算的情况下,其性能已经能够匹配甚至超越之前的LoRA等方法,在多个自然语言理解任务上表现更优。
四、 灵活性与部署便利性
- 全参微调:完成微调后会产生一个独立的、针对特定任务的大型模型文件。不同任务需要加载不同的完整模型,在存储和切换上不够灵活。
- 参数高效微调:具有极高的灵活性和迁移性。训练得到的“增量参数”(如LoRA的适配器模块)体积非常小(通常只有几MB到几百MB),可以轻松保存、分享和加载。用户可以在同一个基础模型上快速切换不同的任务适配器,部署和更新成本极低。
五、 应用场景选择建议
综合来看,选择哪种策略取决于你的具体条件:
- 选择全参微调,当:
- 拥有海量、高质量的领域特定数据。
- 拥有充足的算力预算(如拥有或可租用多张高端GPU)。
- 任务性能是绝对优先的考量,且该模型将长期专注于单一核心任务。
- 典型场景:为特定业务(如法律、医疗)打造专属的、性能顶尖的模型。
- 选择参数高效微调,当:
- 数据量有限或中等。
- 计算资源紧张,或希望快速实验迭代。
- 需要快速适配多个任务,或希望基础模型保留强大的通用能力。
- 追求高效的模型部署和更新。
- 典型场景:个人开发者研究、中小企业快速业务验证、需要为同一模型添加多种轻量级技能(如客服、内容生成、分类等)。
总结而言,全参微调是追求任务性能极致的“重武器”,而参数高效微调则是平衡效率与效果的“瑞士军刀”。随着PEFT技术的不断进步(如RoSA),其性能天花板正在被不断推高,使得在绝大多数资源受限的场景下,参数高效微调已成为更具实用性和性价比的首选方案。
3.2 PEFT方法技术详解
参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)技术是大模型时代应对高昂全量微调成本的关键解决方案。其核心思想是在保持预训练模型主体参数冻结的前提下,仅通过训练少量新增参数或对原有参数进行低秩/稀疏调整,来实现对下游任务的有效适配。根据技术路线的不同,PEFT方法主要可分为以下几类:基于适配器(Adapter)的串行方法、基于前缀/提示(Prefix/Prompt)的输入层方法、基于低秩分解(Low-Rank)的并行方法,以及基于表征干预(Representation)的新兴方法。
一、 基于适配器的串行方法:Adapter Tuning
Adapter Tuning是PEFT领域的经典开山之作,由谷歌研究人员于2019年提出。其核心设计是在Transformer层的每个子模块(如前馈网络FFN)之后,串行插入一个轻量级的Adapter模块。该模块通常由三部分组成:一个降维投影层(将高维特征映射到低维)、一个非线性激活层(如ReLU),以及一个升维投影层(将低维特征映射回原维度),同时包含一个残差连接(Skip-Connection)以保持信息流。
- 工作流程:在微调阶段,预训练模型的所有原始参数被冻结,仅训练这些新插入的Adapter模块中的参数。
- 优势:模块化设计清晰,参数量极少(例如,在BERT-large上仅增加并训练了总参数的3.6%),却能取得接近全量微调的性能(在GLUE基准上,Adapter得分为80.0,全量微调为80.4)。
- 局限性:由于Adapter是串行插入的,会在前向传播中引入额外的计算延迟,影响推理速度。
二、 基于前缀/提示的输入层方法:Prefix Tuning与Prompt Tuning
这类方法通过在模型的输入层添加可学习的“软”参数(即非离散的自然语言token,而是连续的向量)来引导模型适应下游任务。
- Prefix Tuning:由斯坦福大学在2021年提出。它在输入序列的最前面拼接一段可训练的任务特定向量(即Prefix)。为了避免直接优化这些向量导致训练不稳定,研究者引入了一个小的多层感知机(MLP),先训练这个MLP的参数和一个更小的矩阵P’,然后将P’通过MLP映射为最终的Prefix。训练完成后,只需保存不同任务对应的Prefix,模型主体参数可被所有任务共享。实验表明,在数据量有限(如20%-80%)时,Prefix Tuning的效果甚至可能优于全量微调。
- Prompt Tuning:由谷歌团队同期提出,可视为一种简化的Prefix Tuning。它同样在输入层加入可学习的prompt token,但不引入额外的MLP结构,直接优化这些连续的prompt embeddings。研究发现,随着预训练模型参数量的增大,Prompt Tuning的效果会越来越接近全量微调。
- 共同优势:几乎不增加推理时的计算开销,参数效率极高。
- 主要挑战:Prefix/Prompt的长度需要精心设计,过短可能信息不足,过长则会挤占有效输入序列的长度,且其性能并不总是随参数量增加而单调提升。
三、 基于低秩分解的并行方法:LoRA及其演进
这是目前应用最广泛、效果最突出的PEFT方法族,其核心思想是利用权重矩阵在微调过程中的变化具有低“内在秩”的特性。
- LoRA(Low-Rank Adaptation):发表于ICLR 2022,其核心是通过低秩分解来间接更新模型的权重矩阵。具体而言,对于预训练权重矩阵
W∈Rd×kW \in \mathbb{R}^{d \times k}W∈Rd×k
- ,其更新量
ΔW\Delta WΔW
- 被分解为两个更小矩阵的乘积:
ΔW=BA\Delta W = BAΔW=BA
- ,其中
B∈Rd×rB \in \mathbb{R}^{d \times r}B∈Rd×r
- ,
A∈Rr×kA \in \mathbb{R}^{r \times k}A∈Rr×k
- ,且秩
r≪min(d,k)r \ll min(d, k)r≪min(d,k)
- (通常取2, 4, 8, 16等小值)。训练时,冻结原始权重
WWW
- ,只训练
AAA
- 和
BBB
- 。推理时,将
ΔW\Delta WΔW
- 与
WWW
- 合并,不引入额外延迟。
- 优势:
- 无推理延迟:训练完成后可与原权重合并。
- 高显存效率:大幅降低训练时的显存消耗。
- 灵活定制:可灵活应用于Transformer中的任意权重矩阵(如注意力层的Q、K、V、O,或前馈网络层)。
- 性能:在相同可训练参数量下,LoRA通常表现优于其他PEFT方法。研究还发现,同时调整
WqW_qWq
- 和
WvW_vWv
- 矩阵通常能获得更好的效果。
- LoRA的优化与变体:
- QLoRA:通过将基础模型量化为4-bit(如NF4格式),同时将LoRA适配器保持在16-bit精度,实现了在单张消费级显卡(如24GB显存)上微调超大规模模型(如70B参数)的突破。
- RoSA(Robust Adaptation):一种结合了低秩适应和高度稀疏残差微调的新方法。它受鲁棒主成分分析启发,将权重更新分解为一个低秩矩阵
LLL
- (类似LoRA)和一个高度稀疏的矩阵
SSS
- 。
SSS
- 只选择性地微调每层中最重要的前
mmm
- 个参数,以捕获低秩分量
LLL
- 无法拟合的残差信号。实验表明,在使用相同参数预算(约模型总参数的0.3%)时,RoSA在12个NLU任务上普遍优于纯LoRA方法。
- SingLoRA:针对LoRA中两个低秩矩阵
AAA
- 和
BBB
- 之间可能存在尺度差异导致训练不稳定的问题,SingLoRA提出将权重更新重新表述为单个低秩矩阵与其转置的乘积分解。这一设计从本质上消除了尺度冲突,确保了优化稳定性,并且将参数数量大约减少了一半。
四、 基于表征干预的新兴方法:ReFT
ReFT(Representation Finetuning,表征微调) 代表了一种与上述基于权重更新的PEFT方法完全不同的新范式。它由斯坦福大学的研究人员在2024年提出。
- 核心理念:ReFT不直接修改模型的权重参数,而是在模型前向传播(推理)过程中,对特定网络层的隐藏层表征(Hidden Representations) 进行策略性的、可学习的干预。其动机源于可解释性研究发现,模型的隐藏表征中编码了丰富的语义信息。
- 工作机制:一个干预
III
- 被定义为一个三元组
⟨Φ,P,L⟩\langle \Phi, P, L \rangle⟨Φ,P,L⟩
- ,其中
Φ\PhiΦ
- 是干预函数(带有可学习参数),
PPP
- 是干预应用的一组输入位置,
LLL
- 是干预应用的层。在前向传播到第
LLL
- 层时,对位置
PPP
- 的表征应用函数
Φ\PhiΦ
- 进行修改,然后继续后续计算。
- 优势与特点:
- 更高的参数效率:例如其低秩线性子空间变体 LoReFT,所需训练的参数比最先进的PEFT方法(如LoRA)少 10到50倍。
- 可解释性优势:通过干预已知编码特定信息的表征,ReFT能提供对模型内部工作机理的洞察。
- 性能竞争力:在多项NLP基准测试中,使用极少参数的ReFT能达到与LoRA相当甚至更好的性能。
- 代表应用:在Centaur模型中,研究人员使用QLoRA(一种PEFT方法)对Llama 3.1 70B模型进行微调,仅调整了模型非嵌入层中0.15%的参数,就成功使其能够模拟人类在160项心理学实验中的行为。
五、 方法对比与选型建议
| 方法类别 | 代表技术 | 核心思想 | 参数量 | 推理开销 | 优势 | 适用场景 |
|---|---|---|---|---|---|---|
| 串行适配 | Adapter Tuning | 在模型中插入可训练的小型网络模块 | 极少 | 有增加(串行结构) | 结构清晰,模块化 | 多任务学习,对推理延迟不敏感的场景 |
| 输入层提示 | Prefix/Prompt Tuning | 在输入层添加可学习的连续向量 | 极少 | 几乎无增加 | 无推理延迟,参数效率极高 | 生成任务,轻量级适配 |
| 低秩分解 | LoRA、QLoRA、RoSA | 用低秩矩阵分解表示权重更新 | 少(0.1%-1%) | 无增加(可合并) | 平衡性能与效率,应用最广,灵活 | 绝大多数微调场景的首选 |
| 表征干预 | ReFT (LoReFT) | 干预前向传播过程中的隐藏表征 | 极少(比LoRA少10-50倍) | 有增加(干预计算) | 参数效率极高,具备可解释性潜力 | 研究探索,对参数效率要求极高的场景 |
总结与趋势:PEFT技术正朝着更高效率、更强性能、更优稳定性的方向演进。从早期的Adapter,到成为主流的LoRA及其变体(QLoRA, RoSA),再到新兴的ReFT范式,研究者们不断探索更精巧的模型干预方式。对于实践者而言,LoRA/QLoRA因其出色的性能、易用性和与现有生态(如Hugging Face PEFT库)的良好集成,是目前工业界微调大模型最主流和推荐的选择。而RoSA通过结合低秩与稀疏残差,在相同参数预算下提供了更好的性能。ReFT则展示了一种颠覆性的新思路,虽然尚未大规模应用,但代表了未来可能的发展方向。选择时需综合考虑任务需求、可用资源、对推理延迟的容忍度以及对可解释性的追求。
3.3 微调加速技术
在大模型微调过程中,加速技术是解决计算资源受限、降低训练成本、提升迭代效率的关键。这些技术通过优化计算、内存和通信等多个维度,使得在有限硬件条件下高效微调大模型成为可能。以下将结合搜索结果,系统性地梳理和分析当前主流的微调加速技术。
一、 核心加速原理:从内存与计算优化入手
大模型微调的资源瓶颈主要体现在显存(GPU内存) 和计算时间上。加速技术的核心思路,正是针对这两个瓶颈进行优化。
- 显存优化:大模型训练需要存储模型参数、优化器状态、梯度和中间激活值,这四项是显存消耗的主要来源。以全参微调一个10亿参数的FP32模型为例,仅参数、梯度和Adam优化器状态就需要约 1e9 * (4+4+8) = 16GB 的显存,这还不包括中间激活值。因此,显存优化是微调大模型的首要挑战。
- 计算优化:大模型的计算图极其庞大,前向传播和反向传播的计算量巨大。优化计算效率,减少不必要的计算,是缩短训练时间的关键。
二、 主流微调加速技术详解
根据优化目标的不同,可以将加速技术分为以下几类:
1. 参数高效微调:从源头减少计算量
这是最根本的加速策略,其核心思想是不更新全部参数,只训练一小部分新增或选定的参数。这不仅大幅减少了需要优化的参数量,也显著降低了反向传播的计算开销和显存占用。
- LoRA及其变体:LoRA通过引入低秩适配矩阵来近似全参数更新,通常只训练原模型0.1%-1%的参数,能显著降低训练开销。其变体QLoRA进一步将基础模型量化为4-bit,将LoRA适配器保持在16-bit,实现了在单张消费级显卡上微调超大规模模型的突破。SparseLoRA则更进一步,它通过引入一种轻量级、无需训练的SVD稀疏性估计器,动态选择用于损失和梯度计算的稀疏权重子集,在保持精度的同时,最多可减少2.2倍的计算开销,实现最多1.6倍的实际加速。
- 其他PEFT方法:如Adapter Tuning、Prefix/Prompt Tuning等,同样通过冻结大部分参数、仅训练少量适配器或提示向量来实现高效微调,能有效降低显存需求和训练时间。
2. 混合精度训练:兼顾速度与精度
混合精度训练通过在不同计算阶段使用不同精度的数值格式(如FP16/FP32),在保证模型收敛精度的同时,显著提升计算速度和减少显存占用。
- 工作原理:在前向传播和反向传播中使用**FP16(半精度)进行计算和存储梯度,以利用现代GPU的Tensor Core获得数倍的加速。在权重更新时,将梯度转换为FP32(单精度)**进行累加和优化器更新,以保持数值稳定性。
- 性能收益:通常可减少约50%的显存占用,并提升30%-50%的训练速度。第四代英特尔至强可扩展处理器也内置了BF16和INT8的通用矩阵乘加速器,可用于加速深度学习推理工作负载。
- 实现方式:在PyTorch中,可以通过 torch.cuda.amp.autocast() 和 GradScaler 轻松实现。
3. 梯度累积与微批次:模拟大批次训练
当GPU内存无法容纳理想的大批次数据时,梯度累积是一种有效的解决方案。
- 工作原理:将一个大批次(batch)拆分成多个小批次(micro-batch)依次进行前向和反向传播,但不立即更新权重。而是将每个小批次计算出的梯度进行累加,当累加的小批次数量达到预设的“累积步数”时,才用累积的总梯度进行一次权重更新。
- 优势:这等效于使用了一个更大的有效批次大小进行训练,有助于稳定训练过程、改善收敛性,同时避免了因单批次过大导致的显存溢出。
- 注意事项:某些对批次大小敏感的操作(如BatchNorm)在使用梯度累积时效果可能会有细微差异。
4. 梯度检查点:用时间换空间
梯度检查点是一种经典的以计算时间换取显存空间的技术,特别适用于模型层数很深或序列长度很长的场景。
- 工作原理:在正向传播过程中,不保存所有中间层的激活值(这些值在反向传播时需要用于计算梯度),而是选择性地只保存其中一部分(称为“检查点”)。在反向传播时,对于没有保存激活值的层,通过从最近的检查点重新执行前向计算来临时恢复所需的激活值。
- 性能权衡:这种方法可以将显存占用从与网络深度成线性关系(O(n))降低到平方根关系(O(√n)),但代价是会增加约30%-40%的前向计算时间。这是一种典型的“时间换空间”策略。
- PyTorch实现:可以通过 torch.utils.checkpoint.checkpoint 函数方便地使用。
5. 优化器状态与参数量化:极致的内存压缩
对于全参微调,优化器状态(如Adam中的动量和方差)是显存消耗的大头。8-bit优化器技术可以对此进行压缩。
- 8-bit优化器:如bitsandbytes库提供的8-bit Adam,它将优化器状态从32位浮点数(FP32)量化为8位整数(INT8)进行存储。在更新权重时,再将8位状态反量化为32位进行计算,更新完成后再量化回8位存储。这可以将优化器状态的内存占用减少至原来的1/4,从而允许在相同显存下训练更大的模型或使用更大的批次。
- 模型权重量化:在训练阶段,可以使用QLoRA中提到的4-bit量化(如NF4格式)来存储基础模型的权重,进一步压缩模型本身的显存占用。
6. 专用训练优化库与框架
除了上述通用技术,还有一些专门为加速大模型训练而设计的库和框架。
- Unsloth:这是一个开源的Python库和平台,专门用于优化和加速LLM微调。它通过使用OpenAI Triton重写核心计算算子、优化内存访问模式等方式,宣称可以实现训练速度提升2-5倍,同时显存占用减少50-70%,且无需牺牲精度。它简化了如LoRA、GRPO等复杂训练流程的配置。
- DeepSpeed:微软开发的深度学习优化库,提供了ZeRO(零冗余优化器)系列技术,可以跨多GPU智能分割模型状态(参数、梯度、优化器状态),实现近乎线性的显存扩展,是分布式训练大模型的利器。
- FastAdaBelief:这是一种改进的自适应优化算法。中国科学院苏州纳米所的研究表明,它在强凸和非凸条件下都具有更快的收敛速度,并且泛化能力优于传统的SGD和Adam等优化器,这有助于减少达到目标精度所需的训练步数,从而间接加速训练。
三、 技术选型与实战策略
在实际微调项目中,通常需要组合使用多种加速技术。以下是一个典型的策略流程:
- 首选PEFT:对于绝大多数场景,尤其是资源有限时,应优先考虑使用LoRA或QLoRA进行参数高效微调。这是降低显存和计算需求最有效的手段。
- 启用混合精度:在支持Tensor Core的GPU上,务必开启混合精度训练(AMP),这是免费的“加速卡”。
- 应对显存瓶颈:
- 如果显存仍不足,尝试使用梯度累积来增大有效批次大小。
- 如果模型特别深或序列特别长,考虑使用梯度检查点。
- 如果进行全参微调且优化器状态是瓶颈,可以尝试8-bit优化器。
- 利用高效框架:考虑集成Unsloth这类优化库,或使用DeepSpeed进行多卡分布式训练,以获得开箱即用的性能提升。
- 优化算法选择:可以尝试像FastAdaBelief这样收敛更快的优化器,以减少总训练时间。
总结而言,大模型微调加速是一个系统工程,需要根据具体的模型规模、硬件配置和任务需求,灵活选择和组合上述技术。从参数高效的微调方法(如LoRA、SparseLoRA),到底层的计算与内存优化(混合精度、梯度检查点),再到顶层的训练框架与算法优化(Unsloth、FastAdaBelief),共同构成了当前应对大模型微调资源挑战的技术工具箱。
第四章:大模型测评与验证标准
4.1 自动化评估体系
大模型的自动化评估体系是衡量、比较和指导其技术发展的核心工具。一个科学、全面且可执行的评估体系,不仅需要覆盖模型的基础通用能力,还应深入行业应用场景,并具备动态、防“刷榜”的先进评测方法。以下将结合中国信通院“方升”体系、科学地平线平台及其他行业实践,从评估维度、核心方法、行业应用与未来趋势四个方面,系统阐述大模型自动化评估体系的构建。
一、 评估维度的体系化构建:从通用能力到行业纵深
一个完整的自动化评估体系应构建多层次、多维度的评测框架,以满足从技术研究到产业落地的不同需求。
- 通用能力基准评测:衡量模型的“基本功” 这是评估体系的基石,旨在量化模型在语言、知识、推理、代码等核心认知智能任务上的表现。其特点是任务定义清晰、答案客观、可自动化评分。
- 语言理解与生成:评估模型对文本的语义理解、信息抽取、总结、翻译、创作等能力。常用基准包括GLUE、SuperGLUE等,涵盖自然语言推理、文本蕴含、情感分析等任务。
- 知识问答与常识推理:检验模型对世界知识的掌握和运用逻辑进行推理的能力。代表性评测集如MMLU(涵盖57个学科的多选题)、C-Eval(中文知识评测)、GSM8K(数学应用题)以及BigBench-Hard(包含27项复杂推理任务)。
- 代码能力:评估模型根据自然语言描述生成、理解或调试代码的能力。主流基准包括HumanEval(164个Python编程问题)和MBPP(974个基础编程任务)。
- 中文专项评估:针对中文语境和文化的深度评测至关重要。例如,SuperCLUE涵盖10大能力维度、超过200个评测任务;CMMLU覆盖67个中文学科,侧重知识深度;AGIEval则直接面向中国高考、公务员考试等真实高难度场景。
- “方升”体系:面向产业应用的四大维度 中国信息通信研究院发布的“方升”大模型基准测试体系,代表了从学术评测向产业评测的演进。它创新性地构建了行业、应用、通用和安全四个核心评测维度,并重点强化了行业和应用导向能力的考查。
- 通用维度:覆盖理解、生成、推理等基础能力。
- 行业维度:针对金融、医疗、工业等具体垂直领域,设计专业任务和数据集,评估模型解决行业特定问题的能力。
- 应用维度:评估模型在真实业务场景(如智能客服、内容创作、数据分析)中的实用性和用户体验。
- 安全维度:系统性评估模型在输出内容合规性、偏见歧视、隐私泄露、对抗攻击等方面的风险。
- 科学地平线平台:聚焦AI for Science的深度评估 中国科学院计算机网络信息中心发布的“科学地平线”平台,则开创了面向人工智能驱动科学研究(AI4Science)的综合评价新范式。它从 “数据+模型”双视角进行评估:
- 数据质量评估:从“规范性”、“可用性”、“可解释性”、“合规性”四个维度,对科学数据集进行量化评分,并发布高质量数据推荐榜单,确保大模型使用的“燃料”优质可靠。
- 模型科学能力评估:不仅测试模型在“全学科”的综合表现,还细分为“数学”、“物理学”、“化学”、“生命科学”、“地球与空间科学”等具体学科。评估指标涵盖“知识”、“理解”、“推理”、“价值观”、“多模态”等,帮助科研人员精准找到适配特定研究领域的大模型。
二、 核心评测方法创新:从静态“刷榜”到动态自适应
传统的静态基准测试已无法应对大模型快速迭代和“刷榜”问题。先进的评估体系必须在方法论上进行革新。
- 自适应动态测试方法 “方升”体系为解决评测数据集难管理、大模型测试“刷榜”等问题,创新性提出了自适应动态测试方法。该方法的核心在于:
- 测试数据标签化与题库实时化:对海量测试数据进行多维度标签化管理,并动态更新题库,防止模型针对固定题目过拟合。
- 测试方案定制化与流程自动化:可根据不同模型特点和评测需求,灵活定制测试方案,并通过自动化测试平台高效执行,精准挖掘模型缺陷。
- 多层次、自动化的评估工具 自动化评估离不开高效的工具链支撑。
- 智能化结果评估系统:中国信通院在构建超自动化测试平台和智能化结果评估系统方面持续发力,旨在解决评测流程中的“阻塞点”,全面提高测试效率。
- 第三方专业测评平台:如永信至诚推出的“春秋AI大模型安全测评‘数字风洞’平台”,构建了 “ISAC24” 多维度评估标准,从智能度、安全度、匹配度、一致度四个关键维度对模型进行综合“诊断”。该平台已集成超过50个主流模型和500万条测评用例,能够实现客观、高效的自动化测评。
三、 行业应用与标准建设:从技术评测到生态构建
评估的最终目的是推动技术落地和产业健康发展,这需要建立权威的标准并形成健康的生态。
- 标准体系与生态倡议
- 标准制定:中国信通院已推动形成5项大模型测试标准,包括ITU国际标准、行业标准和团体标准。同时,联合产业各方发布了《大语言模型基准测试体系框架及总体要求》,规定了基准测试的指标、数据集、流程和工具。中国移动也联合16家重点央企发布了《通用大模型评测标准》,基于“2-4-6”框架(两类视角、四类要素、六大维度),为产业界遴选优质模型提供依据。
- 生态倡议:针对评测领域出现的不良现象,中国信通院联合百度、腾讯、华为等主流企业发布《构建科学、公正、透明的大模型基准测试生态倡议书》,呼吁共建健康的评测生态。
- 从能力评估到风险治理 评估体系必须前瞻性地覆盖大模型全生命周期的风险。大模型的安全风险深嵌于“数据—训练—评估—应用”的全链路。自动化评估需要:
- 识别数据污染风险:评估训练数据中是否存在偏见、虚假信息及隐私泄露隐患。
- 检测“幻觉”与事实性错误:应对模型因统计预测范式缺陷而产生的“幻觉”问题,平均幻觉率可高达59%。需评估检索增强生成(RAG)等缓解技术的有效性。
- 评估对齐效果与价值观:检验通过人类反馈强化学习(RLHF)等技术实现的价值观对齐是否牢固,能否抵御隐蔽的提示攻击。
四、 未来趋势:走向智能体评估与全链条评测
评估体系的发展正随着技术演进而不断拓展边界。
- 从模型评估到智能体(Agent)评估 随着大模型从工具向能自主规划、执行复杂任务的智能体演进,评估重点也将转移。科学地平线平台计划部署建设针对“AI4Science智能体”的评测系统,聚焦科学工具调用与环境交互能力、跨领域协作能力和复杂任务拆解效能等核心指标。
- 建立覆盖全链条的评测标准 未来的评测需要覆盖从基础理论验证到产业转化落地的全链条,旨在为科研人员高效运用大模型开展科研攻关提供科学化、系统化指引。
总结而言,一个成熟的大模型自动化评估体系,是多维能力覆盖、动态评测方法、权威标准支撑、安全风险治理和前瞻生态构建的有机结合。它不仅是衡量模型性能的“标尺”,更是牵引技术研发、支撑产品选型、指引行业应用、辅助监管治理的“指挥棒”。随着“方升”等国家级评测体系的完善和科学地平线等垂直平台的出现,中国正在构建一套既与国际接轨、又符合本土产业需求的科学、公正、透明的大模型评估基准,为人工智能产业的健康有序发展提供有力支撑。
4.2 人工评估框架
大模型的自动化评估(如“方升”基准测试)虽然高效、客观,但在衡量模型的实用性、创造性、价值观对齐和用户体验等主观、复杂维度时,人工评估具有不可替代的价值。一个严谨的人工评估框架是确保模型真正“有用”、“好用”、“安全”的关键环节。
一、 人工评估的核心价值与定位
人工评估并非自动化评估的替代,而是其必要且关键的补充。其核心价值在于:
- 评估难以量化的主观维度:如回答的创意性、趣味性、情感共鸣、社会文化适宜性等。
- 验证复杂场景下的真实表现:在开放域对话、多轮交互、复杂问题解决等场景中,评估模型是否真正理解了意图,并给出连贯、有价值的回应。
- 发现“边缘案例”与潜在风险:自动化测试可能遗漏的、涉及伦理、偏见、安全或逻辑陷阱的“Bad Case”,需要人类评估者敏锐地发现和判断。
- 对齐人类价值观与偏好:模型输出的价值观是否与目标用户群体一致,是否符合社会规范,这最终需要人类来判断和校准。
二、 人工评估的核心维度与指标体系
一个全面的人工评估框架应覆盖从基础能力到高阶智能的多个层面。结合您提供的背景资料和行业实践,建议构建以下多维度评估体系:
1. 基础能力维度:回答的“正确性”与“可用性”
此维度评估模型输出是否满足任务的基本要求,是评估的基石。
- 相关性:回答是否与问题直接相关,是否解决了用户的核心诉求。例如,对于“如何评估大模型”,回答是否围绕评估方法展开,而非泛泛而谈AI发展史。
- 准确性/事实性:回答中的事实、数据、引用是否准确无误。对于专业领域问题(如医疗、法律),尤其需要领域专家进行验证。
- 完整性:回答是否覆盖了问题的所有关键方面,没有遗漏重要信息点。例如,评估“私有化部署价值”,是否涵盖了数据安全、成本、定制化等核心要点。
- 逻辑性与连贯性:回答的内部结构是否清晰,推理过程是否合乎逻辑,语句之间是否衔接流畅。
2. 高阶智能维度:回答的“智能性”与“创造性”
此维度评估模型是否展现出超越简单信息检索的认知能力,是区分模型优劣的关键。
- 任务泛化与自主生成能力:评估模型能否在动态场景中理解人类意图、自主生成新任务,即是否“眼里有活”。例如,在模拟环境中,能否主动识别并处理未预设的突发情况。
- 复杂推理与问题解决:评估模型处理多步骤推理、解决开放式问题的能力。这需要设计包含数学、逻辑、常识推理的复杂场景题。
- 多轮对话与上下文理解:评估模型在长对话中保持话题连贯、指代清晰、记忆准确的能力。可以设计包含话题转换、信息追溯的对话剧本进行测试。
- 创造性内容生成:评估模型在写作、创意策划、代码生成等任务中的新颖性、原创性和实用性。
3. 安全、伦理与价值观维度:回答的“安全性”与“合规性”
此维度是模型能否被社会接纳和信任的底线,必须严格评估。
- 内容安全性:输出是否包含暴力、仇恨、歧视、违法等有害信息。需建立敏感词库和风险场景库进行系统性测试。
- 偏见与公平性:评估模型输出是否对特定性别、种族、地域、职业等群体存在刻板印象或歧视性倾向。
- 隐私保护:在涉及个人信息处理的场景(如客服),评估模型是否诱导用户泄露隐私,或在其训练数据中不当暴露了他人隐私。
- 价值观对齐:评估模型的回答是否符合人类主流价值观和社会规范。例如,当儿童提出不安全要求时,模型能否识别并拒绝,同时给出正确引导。
4. 用户体验与实用性维度:回答的“友好性”与“有效性”
此维度从最终用户的角度出发,评估模型的实际使用感受。
- 流畅性与自然度:语言是否通顺、自然,符合人类表达习惯,没有明显的机器感或“脑雾”现象。
- 可解释性:对于复杂决策或推理过程,模型能否提供清晰、易懂的解释,帮助用户理解其思考路径。
- 帮助性与实用性:回答是否真正对用户有帮助,能否解决实际问题,而不仅仅是“正确的废话”。
- 指令遵循与可控性:模型是否能精确理解并执行复杂的、多约束的用户指令(如“用200字总结,避免使用专业术语”)。
三、 标准化评估流程与实施方法
为确保评估结果的客观、公正、可靠,必须建立标准化的操作流程。
- 评估任务与场景设计:
- 基于评估目标(如评测通用对话能力、行业专业知识、代码能力),设计覆盖上述维度的多样化评估任务集。任务应包括标准问题、开放性问题、多轮对话剧本、带有陷阱或偏见的测试用例等。
- 场景应尽可能贴近真实应用,如模拟客服对话、文档分析、创意头脑风暴等。
- 评估员选拔与培训:
- 选拔:根据评估内容,组建包含语言学家、领域专家、普通用户在内的多元化评估团队。例如,评估医疗回答需有医生参与。
- 培训:对所有评估员进行统一、深入的培训,确保其充分理解每个评估维度的定义、评分标准和边界案例。培训后需进行校准测试,计算评估员间信度(如科恩卡帕系数),确保评分标准一致(通常要求Kappa > 0.7)。
- 评估执行与质量控制:
- 双盲评估:评估员在不知晓所评模型身份(如A模型、B模型)的情况下进行打分,避免品牌偏见。
- 多数投票与仲裁:每个样本至少由3名评估员独立评判。对于分歧较大的样本,引入资深评估员或专家组进行仲裁。
- 过程记录:要求评估员在打分的同时,提供简短的评语或标注关键证据(如指出事实错误的具体位置),这有助于后续分析和模型迭代。
- 数据分析与报告生成:
- 对评分数据进行统计分析,计算各维度平均分、标准差,并进行模型间对比。
- 不仅关注总分,更要深入分析模型在特定维度(如安全性、创造性)或特定任务类型(如推理题、专业题)上的优势和短板。
- 汇总典型的“好案例”和“坏案例”(Bad Case),形成详细的评估报告,为模型优化提供明确方向。
四、 与自动化评估的协同及未来趋势
人工评估与自动化评估应形成互补与闭环:
- 自动化筛选,人工精评:先用自动化测试进行大规模、快速的初筛,再对关键、困难的样本进行人工深度评估,提升效率。
- 人工标注,训练自动化评估器:将高质量的人工评估结果作为训练数据,用于训练更精准的自动化评估模型(如Judge Model),逐步减少对纯人工的依赖。
- 聚焦前沿与复杂能力:随着模型能力提升,人工评估应更多转向对心智理论(Theory of Mind)、复杂社会交互、价值判断等更高阶认知能力的测评。
总结而言,一个有效的人工评估框架,是连接大模型技术能力与真实世界价值的桥梁。它通过系统化的维度设计、标准化的流程管理和专业化的评估团队,将主观的人类判断转化为可量化、可分析、可指导模型改进的客观依据,是确保大模型负责任、高质量发展不可或缺的一环。
4.3 A/B测试实战方案
一、 实验设计与核心原则
A/B测试的核心是通过科学对比,验证产品变更或策略调整是否有效。一个严谨的实战方案始于正确的设计。
1. 明确目标与假设
任何A/B测试的起点都必须是明确的业务目标和可验证的假设。目标应与公司的“北极星指标”(如GMV、用户活跃度)紧密关联,并将其拆解为可执行的具体指标。例如,电商平台的目标可能是提升转化率,而假设则是“将购买按钮从蓝色改为红色,能将转化率提升3%”。假设必须包含具体的新策略和确切的预期提升值,这是后续计算样本量和评估结果的基石。
2. 确定随机化单元与目标群体
- 随机化单元:通常是用户(User)或会话(Session),确保每个单元被随机、均匀地分配到对照组(A组,体验旧方案)和实验组(B组,体验新方案)。这是保证实验结果无偏的根本。
- 目标群体:根据实验目的,可以限定为具有特定特征的用户,例如“仅限使用安卓系统的北京地区用户”。这有助于聚焦核心受众,提升实验的针对性和灵敏度。
3. 计算样本量与实验周期
样本量不足会导致实验无法检测到真实效果(统计功效不足),而样本量过大则会造成资源浪费和用户体验风险。
- 样本量计算:使用统计学公式计算,核心变量包括:
- 基线转化率 (P_A):当前版本的指标值(如旧页面转化率13%)。
- 预期提升 (δ):希望检测到的最小提升幅度(如2%)。
- 显著性水平 (α):通常设为0.05,即95%置信水平。
- 统计功效 (1-β):通常设为0.8,即80%的概率能检测到真实存在的效果。
- 标准差 (σ):对于比率类指标(如转化率),计算公式为 σ² = P_A*(1-P_A) + P_B*(1-P_B) 。
一个典型的计算示例如下:为检测转化率从13%提升至15%(提升2%),在α=0.05、功效=0.8的条件下,每组至少需要约4716个样本,总样本量约为9440。
- 实验周期:实验时长应与产品的“数据特征周期”一致。例如,用户活跃度呈现明显周度规律的产品,实验应至少运行一个完整自然周,以消除周期性波动的影响。实验周期也可通过日均流量估算,例如日均1000访问量,则需要运行约10天。
4. 配置实验与流量分配
- 实验层与流量正交:为了同时进行多个互不干扰的实验,需要使用“实验层”技术。该技术将总体流量“复制”成多个正交的流量层,各层实验互不影响,从而高效复用流量,提升实验效率。选择实验层时,需遵循“业务冲突,在系统层面体现为参数冲突”的原则,将修改同一物理对象的实验放在同一层,以避免冲突。
- 小流量启动:实验初期,建议先分配较小流量(如1%)进行测试。这可以在效果未明时,将异常影响降至最低。若初期数据表现正常,再逐步放大流量;若出现重大异常,可随时终止实验。
二、 关键指标监控与数据收集
1. 定义核心评估指标
根据实验假设,明确目标指标(如用户购买率)和护栏指标。护栏指标用于监控实验是否对其他重要业务指标产生了负面影响(如用户停留时间、跳出率等),确保优化不损害整体用户体验。
2. 实施数据埋点与收集
确保在实验版本和对照版本中,对用户的关键行为(如点击、浏览、购买)进行一致的埋点追踪。数据上报的准确性和完整性是结果可信的保障。在正式开启实验前,应进行前期测试(白名单测试),验证实验配置能否正常生效、数据上报是否准确,并排查客户端可能存在的bug。
三、 结果分析与决策
1. 评估统计显著性
实验结束后,首要任务是判断观测到的指标差异是否具有统计显著性,即差异是否由实验改动引起,而非随机波动。通常使用p值或置信区间进行判断:
- p值:如果p值小于预设的显著性水平(如0.05),则认为结果是统计显著的。
- 95%置信区间:计算实验组与对照组指标差值的置信区间。如果该区间不包含零(即“零值”落在区间外),则说明差异显著。例如,观测到差值Δ,其95%置信区间为[Δ-1.96σ, Δ+1.96σ],若该区间完全大于0,则证明新方案显著优于旧方案。
2. 进行深入分析
在确认统计显著性后,需进行更深入的分析以形成可执行的洞察:
- 效应大小评估:不仅要看是否显著,还要看提升幅度(效应大小)是否具有实际业务意义。一个统计显著但微小的提升可能不值得投入资源全面推广。
- 细分分析:分析不同用户群体(如新用户 vs 老用户、不同设备、不同地区)的实验效果是否存在差异。这有助于理解改动对谁最有效,为后续精细化运营提供方向。
- 观察长期影响:某些改动可能产生短期激励效应,但长期来看会损害用户体验。因此,在推全前,最好能观察更长时间(如2-4周),确保效果稳定。
3. 做出决策与迭代
- 推广获胜版本:如果实验组在目标指标上表现显著且正面,且未对护栏指标造成不可接受的负面影响,则可以决策全面推广新版本。
- 分析失败原因:即使实验未达到预期,也应深入分析“失败”的变体,了解其为何表现不佳,这些洞察对未来的产品迭代同样宝贵。
- 持续优化:A/B测试是一个持续迭代的过程。将实验结果文档化,无论是成功还是失败的经验,都应作为知识沉淀,指导下一轮的假设与实验设计。
四、 注意事项与最佳实践
- 一次只测试一个变量:理想情况下,一次A/B测试只改变一个元素,以清晰归因效果。若需测试多个组合,应考虑A/B/n测试或多变量测试。
- 避免中途修改实验:一旦实验开始,不应中途调整流量分配或实验参数,否则会污染数据,影响结论的可靠性。
- 理解A/B测试的局限性:A/B测试并非万能。它擅长优化已知范围内的方案,但对于颠覆性的创新、需要长期培养的用户习惯,或涉及品牌、战略等难以量化的决策,A/B测试可能不是最佳评估方法,需要结合经验判断和更深度的数据分析。
- 将A/B测试视为一种科学经营行为:不应仅将其视为技术工具,而应作为一种“大胆假设,小心求证”的科学方法论融入企业决策文化,确保每个重要决策都有数据支撑,实现持续增长。
通过遵循以上系统化的实战方案,企业可以最大限度地降低产品迭代风险,以数据驱动的方式实现可靠、可持续的增长。
第五章:大模型量化方法与实践
5.1 量化技术概述
量化技术是深度学习模型部署中用于压缩模型体积、降低计算与存储开销的核心手段,其本质是通过将高精度浮点运算转换为低精度整数运算,在尽量保持模型性能的前提下,显著提升推理效率并降低硬件资源需求。以下从基本原理、核心要素、精度对比三方面系统阐述。
一、量化基本原理
量化的数学本质是将连续的浮点数值映射到离散的低精度整数空间,核心公式为:
Q=round(XS)+ZQ = \text{round}\left(\frac{X}{S}\right) + ZQ=round(SX)+Z
其中:
XXX
- 为原始高精度浮点数值(如FP32/FP16);
SSS
- 为缩放因子(Scale),用于将浮点数的动态范围压缩到整数可表示的区间内;
ZZZ
- 为零点(Zero Point),用于对齐浮点数0与整数的0点(尤其在处理非对称分布数据时);
QQQ
- 为量化后的低精度整数(如INT8/INT4)。
通过调整
SSS
和
ZZZ
,量化可在“精度损失”与“压缩效率”间取得平衡。
二、量化核心要素:粒度选择
量化粒度决定了参数分组的精细程度,直接影响量化精度与计算复杂度的平衡:
- 张量级(Per-Tensor):整个张量(如权重矩阵、激活值)共享一组
SSS
- 和
ZZZ
- 。实现简单、计算快,但可能因张量内数值分布不均导致精度损失较大。
- 通道级(Per-Channel):每个通道(如卷积层的输出通道)独立设置
SSS
- 和
ZZZ
- 。更适配神经网络中不同通道数值分布差异大的特性,精度更高,是工业界主流选择。
- 分组级(Per-Group):将张量划分为若干小组(如每组64个元素),每组独立量化。平衡了张量级的高效与通道级的精度,适用于对灵活性和精度均有要求的场景。
三、精度对比分析
不同量化精度的数值范围、内存占用及适用场景差异显著,具体如下:
| 精度格式 | 比特数 | 数值范围 | 内存占用(相对FP32) | 适用场景 |
|---|---|---|---|---|
| FP32 | 32 | ±3.4×10³⁸ | 100% | 模型训练、高精度推理(如科学计算) |
| BF16 | 16 | ±3.4×10³⁸ | 50% | 训练(保留动态范围)、混合精度训练 |
| FP16 | 16 | ±65504 | 50% | 推理(如GPU Tensor Core加速)、边缘计算 |
| INT8 | 8 | -128 ~ 127 | 25% | 通用推理(如服务器端、移动端) |
| INT4 | 4 | -8 ~ 7 | 12.5% | 极致压缩(如端侧设备、低算力场景) |
总结
量化技术通过数学映射与粒度优化,在精度损失可控的前提下,大幅降低模型存储与计算成本,是大模型本地部署(如个人/企业轻量级推理)的关键支撑。实际应用中需根据硬件算力、延迟要求及精度需求,选择合适的量化精度与粒度(如INT8用于通用场景,INT4用于极致压缩)。
5.2 GPTQ量化实战
GPTQ(GPT Quantization)是一种针对大语言模型的后训练量化(Post-Training Quantization, PTQ)方法,核心目标是在不重新训练模型的前提下,将FP16/FP32权重压缩为低比特(如4-bit INT)整数,同时保持模型推理精度基本不变。其技术特点是逐块量化+二阶信息优化,尤其适合大模型(7B/13B/70B)的高效部署。
一、GPTQ算法原理
GPTQ的核心创新是通过Hessian矩阵近似二阶信息,解决低比特量化中“权重分布不均导致的精度损失”问题,具体步骤如下:
1. 权重分块(Block-wise Quantization)
将模型的权重矩阵(如Transformer层的Q/K/V/O矩阵)按列划分为多个小块(通常每块128列),对每个块独立量化。分块的目的是降低计算复杂度,同时适配不同块的权重分布差异。
2. 交替量化与更新(Alternating Quantization & Update)
对每个分块权重
WWW
,初始化量化参数(缩放因子
SSS
、零点
ZZZ
),然后通过以下步骤迭代优化:
- 量化:将当前块的浮点权重
WWW
- 量化为低比特整数
QQQ
- (如INT4),公式为
Q=round(W/S+Z)Q = \text{round}(W/S + Z)Q=round(W/S+Z)
- 。
- 计算重构误差:用量化后的权重
Q⋅S−ZQ \cdot S - ZQ⋅S−Z
- 近似原始权重
WWW
- ,计算重构误差
E=W−(Q⋅S−Z)E = W - (Q \cdot S - Z)E=W−(Q⋅S−Z)
- 。
- 更新剩余权重:通过Hessian矩阵的逆(
H−1H^{-1}H−1
- )加权误差
EEE
- ,调整未量化的权重部分,最小化整体重构误差(Hessian矩阵反映权重对模型输出的敏感度,敏感度高的权重保留更多精度)。
3. OBQ微调(Optimal Brain Surgery)
在量化完成后,使用**最优脑手术(OBQ)**技术对量化参数(
SSS
、
ZZZ
)进行微调,进一步降低重构误差,提升低比特量化的精度。
4. 校准数据驱动(Calibration with Data)
使用少量校准数据(100-1000条代表性样本)模拟模型推理时的激活值分布,确保量化后的权重在实际推理中表现稳定(避免“量化时精度高,推理时因激活分布差异导致精度骤降”)。
二、GPTQ量化实战流程
以下以Qwen1.5-7B-Chat模型为例,演示4-bit GPTQ量化的完整步骤(基于Auto-GPTQ库)。
1. 环境准备
- 硬件:推荐NVIDIA GPU(如RTX 3090/4090/A100),需支持CUDA 11.7+。
- 软件依赖:
pip install torch==2.0.1+cu117 --extra-index-url https://download.pytorch.org/whl/cu117
pip install transformers==4.35.0
pip install auto-gptq==0.7.1  # 需与transformers版本兼容
pip install triton==2.1.0  # 可选,用于加速量化计算
Bash
2. 加载模型与配置量化参数
首先定义量化配置( BaseQuantizeConfig ),关键参数包括:
- bits :量化位数(如4-bit)。
- group_size :权重分块大小(如128,平衡精度与速度)。
- desc_act :是否按激活值动态分组(False表示静态分组,计算更高效)。
- static_groups :是否使用静态分组(True可减少运行时计算)。
from auto_gptq import BaseQuantizeConfig


quantize_config = BaseQuantizeConfig(
    bits=4,               # 目标量化位数(4-bit)
    group_size=128,       # 权重分块大小(每块128列)
    desc_act=False,       # 静态分组(不按激活动态调整)
    static_groups=True,   # 启用静态分组优化
    damp_percent=0.01,    # 阻尼系数(防止Hessian矩阵奇异,默认0.01)
    sym=True,             # 对称量化(仅用正负范围,简化计算)
    act_order=False       # 关闭激活顺序优化(减少计算量)
)
3. 加载预训练模型并初始化量化器
使用 AutoGPTQForCausalLM 加载原始FP16模型,并绑定量化配置:
from transformers import AutoTokenizer
from auto_gptq import AutoGPTQForCausalLM


# 加载模型和分词器
model_name = "Qwen/Qwen1.5-7B-Chat"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoGPTQForCausalLM.from_pretrained(
    model_name,
    quantize_config=quantize_config,
    device_map="auto",  # 自动分配GPU/CPU(需足够显存,7B模型FP16约13GB)
    trust_remote_code=True
)
4. 准备校准数据集
校准数据需覆盖模型实际应用场景(如对话、文本生成),建议使用100-1000条高质量样本(每条样本长度不超过模型最大上下文窗口,如2048 tokens)。示例:
# 构造校准数据集(示例:使用WikiText-2的部分文本)
calibration_texts = [
    "人工智能是研究、开发用于模拟、延伸和扩展人的智能的理论、方法、技术及应用系统的一门新的技术科学。",
    "量化技术通过降低模型参数的精度,在保持性能的同时减少计算资源消耗,是大模型部署的关键技术。",
    # ... 更多样本(建议100-1000条)
]


# 转换为模型输入的token格式
calibration_dataset = [
    tokenizer(text, return_tensors="pt", padding=True, truncation=True, max_length=512)
    for text in calibration_texts
]
5. 执行量化
调用 model.quantize() 方法,传入校准数据和量化参数,执行GPTQ量化:
# 量化模型(使用Triton加速,需安装triton库)
model.quantize(
    calibration_dataset=calibration_dataset,
    batch_size=1,          # 校准时batch size(小batch更稳定)
    use_triton=True,       # 启用Triton GPU内核加速(提升2-3倍速度)
    cache_examples=False   # 不缓存校准样本(节省内存)
)
6. 保存与验证量化模型
量化完成后,保存模型供后续推理使用,并验证精度和性能:
# 保存量化模型
save_path = "./qwen-7b-gptq-4bit"
model.save_quantized(save_path)
tokenizer.save_pretrained(save_path)


# 验证推理(对比原始模型与量化模型输出)
from transformers import TextGenerationPipeline


# 原始模型推理(FP16)
original_model = AutoGPTQForCausalLM.from_pretrained(model_name, device_map="auto", trust_remote_code=True)
original_pipe = TextGenerationPipeline(model=original_model, tokenizer=tokenizer, device=0)
original_output = original_pipe("请解释大模型量化的作用:", max_new_tokens=100)["generated_text"]


# 量化模型推理(4-bit INT)
quantized_pipe = TextGenerationPipeline(model=model, tokenizer=tokenizer, device=0)
quantized_output = quantized_pipe("请解释大模型量化的作用:", max_new_tokens=100)["generated_text"]


print("原始模型输出:", original_output)
print("量化模型输出:", quantized_output)
三、性能优化与注意事项
1. 校准数据选择
- 覆盖性:校准数据需覆盖模型实际应用场景(如对话、代码生成、文本摘要),避免仅用单一领域数据导致量化偏差。
- 长度适配:单条样本长度建议不超过模型最大上下文窗口(如2048 tokens),过长会导致校准效率低且可能引入冗余信息。
- 数量控制:100-1000条足够(过多会增加量化时间,过少可能导致精度损失)。
2. 分组策略调优
- group_size=128 是经验最优值(平衡精度与速度);若模型对精度敏感(如医疗/法律领域),可减小至64;若追求极致速度,可增大至256(需测试精度是否满足要求)。
- sym=True (对称量化)可减少计算复杂度,适合大多数场景;若权重分布严重非对称(如含大量正负极值),可尝试 sym=False (非对称量化)。
3. Triton加速
- 启用 use_triton=True 可利用GPU内核优化量化计算(如矩阵运算),相比纯PyTorch实现提速2-3倍,但需确保GPU支持CUDA 11.7+和Triton 2.0+。
4. 内存对齐
量化后权重需按128字节对齐(Auto-GPTQ默认处理),避免GPU读取时的内存碎片,提升推理效率。
5. 精度验证
- 任务级验证:在目标任务(如对话、摘要)上对比原始模型与量化模型的准确率(如BLEU、ROUGE)或人工评估。
- 困惑度(Perplexity):计算量化模型在验证集上的困惑度,若与原始模型差距≤5%,通常可接受(具体阈值因任务而异)。
四、常见问题与解决方案
- 量化后精度骤降:检查校准数据是否覆盖场景、分组大小是否合理,或尝试减小 group_size (如64);若仍无效,可能是模型对量化敏感(如小参数量模型),建议改用FP8或混合精度。
- 显存不足:降低 batch_size (如设为1),或使用 device_map=“auto” 让模型自动分配到CPU/GPU;若模型过大(如70B),需使用多卡分布式量化(需修改代码支持)。
- 推理速度无提升:确保启用 use_triton=True ,并检查GPU是否支持INT4计算(如Ampere架构及以上);若硬件不支持,量化后的模型可能仍需以FP16运行(需验证硬件兼容性)。
总结
GPTQ量化是大模型本地部署的关键技术,通过逐块量化+二阶优化,可在4-bit精度下保持接近FP16的模型性能,同时大幅降低存储(7B模型FP16约13GB→4-bit约3.25GB)和计算开销(INT4运算速度是FP16的2-4倍)。实战中需注意校准数据选择、分组策略调优,并通过任务级验证确保精度满足需求。
5.3 AWQ量化方案
AWQ(Activation-aware Weight Quantization,激活感知权重量化)是一种面向大语言模型(LLM)的高效后训练量化(Post-Training Quantization, PTQ)方案,其核心创新在于根据权重对应激活值的幅度动态评估权重的重要性,并对重要权重进行保护,从而在极低比特(如4-bit INT)量化下保持接近原始模型的性能。以下从核心原理、技术实现、与GPTQ对比、适用场景四方面系统解析AWQ量化方案。
一、核心原理:权重重要性与激活幅度强相关
传统量化方法(如均匀量化)对所有权重“一视同仁”,但实际模型中,权重的重要性与其在推理时被激活的频率和强度密切相关:
- 若某个权重对应的激活值幅度大(即该权重在推理中频繁处理高幅值输入),则该权重对模型输出的影响更显著,需保留更高精度;
- 反之,若激活值幅度小,权重对输出的影响较弱,可容忍更激进的低比特量化。
AWQ的核心洞察是:通过激活值的统计信息(如绝对值均值)识别“重要权重”,并对其施加更精细的保护(如不量化或更高精度量化),从而在整体低比特压缩下最小化精度损失。
二、技术实现:激活感知的权重保护与量化
AWQ的实现流程围绕“激活统计→重要性评估→动态量化”展开,具体步骤如下:
1. 激活统计与重要性评估
- 激活采样:使用少量校准数据(如100-500条真实推理样本)运行模型,收集各层权重对应的激活值(如Transformer层中注意力机制的输出或前馈网络的输入)。
- 重要性排序:计算每个权重通道(或分组)对应激活值的统计量(如绝对值均值、最大值),按统计量从高到低排序,识别出对模型输出影响最大的前1%权重通道(称为“重要权重”)。
2. 动态量化策略
- 重要权重保护:对识别出的1%重要权重通道,保留其原始高精度(如FP16)或不量化,避免因低比特压缩导致关键特征丢失。
- 非重要权重量化:对剩余99%的非重要权重通道,采用低比特(如4-bit INT)均匀量化,通过激活统计自动计算最优缩放因子(Scale)和零点(Zero Point),确保量化后的权重分布与原始分布尽可能接近。
3. 缩放因子优化
AWQ的缩放因子并非固定,而是基于激活值的统计特性动态计算:通过分析激活值的动态范围(如最大值、最小值、均值),为每个权重通道定制缩放因子,避免因激活分布不均导致的量化误差累积。例如,若某通道激活值普遍较大,则缩放因子会更小(量化间隔更细),保留更多精度。
三、与GPTQ量化的对比
AWQ与GPTQ均为大模型后训练量化方案,但技术路径和适用场景差异显著,具体对比如下:
| 特性 | GPTQ | AWQ |
|---|---|---|
| 量化类型 | 训练后量化(PTQ) | 激活感知量化(PTQ变种) |
| 核心方法 | 逐块量化+Hessian矩阵二阶优化 | 基于激活统计识别重要权重并保护 |
| 校准需求 | 需要校准数据(100-1000条) | 需要少量激活统计(100-500条样本) |
| 计算开销 | 较高(需计算Hessian矩阵逆) | 较低(仅需激活统计与重要性排序) |
| 硬件要求 | 需GPU内存充足(Hessian计算耗显存) | 内存需求较小(无Hessian计算) |
| 精度保持 | 4-bit下精度接近FP16(依赖Hessian优化) | 4-bit下仅损失0.5%准确率(Llama-7B) |
| 适用场景 | 服务器端部署(追求高精度) | 边缘设备部署(资源受限,需低开销) |
四、适用场景与优势
AWQ的核心优势在于在低计算开销下实现高精度量化,尤其适合以下场景:
- 边缘设备部署:如手机、嵌入式设备或低算力GPU(如Jetson系列),需压缩模型体积(4-bit量化后模型体积仅为FP16的1/4)并降低推理延迟。
- 资源受限的服务器端:当GPU内存有限(如单卡16GB以下),需部署7B/13B大模型时,AWQ可通过减少校准数据和计算开销,快速完成量化并部署。
- 对量化效率敏感的实时任务:如对话系统、实时翻译等,需快速完成量化且推理延迟敏感的场景,AWQ的低计算开销更具优势。
总结
AWQ通过“激活感知”的创新思路,突破了传统量化方法对所有权重“平等对待”的局限,通过保护重要权重通道,在4-bit低比特量化下仍能保持接近原始模型的性能(如Llama-7B仅损失0.5%准确率)。其与GPTQ的互补性(GPTQ适合高精度服务器端部署,AWQ适合低开销边缘部署),为大模型在不同硬件环境下的高效部署提供了更灵活的选择。
5.4 混合精度量化策略
混合精度量化策略是一类结合不同数值精度(如FP16、INT8、INT4等)的优势,在模型推理或训练过程中针对不同部分或场景动态使用不同精度,以兼顾性能、内存占用与模型精度的技术方案。在大模型场景下,这类策略尤为重要,因为单一低精度往往难以兼顾速度与效果,而混合精度可以在关键部分保留高精度,其余部分使用低精度压缩,从而达到最优的资源-效果平衡。
根据您提供的背景资料,当前主流的混合精度量化策略主要包括 LLM.int8() 和 SmoothQuant,以及针对不同模型规模与硬件平台的实践建议。下面系统梳理如下:
1. LLM.int8() 方案
核心思想:将激活中的极少数“离群值”保留为高精度(FP16)计算,其余大部分激活和权重使用 INT8 计算,从而在大幅降低内存占用的同时保持精度。
关键技术点
- 离群值检测:在推理时动态识别激活张量中幅度异常的通道(约占 0.1%)。这些通道若用 INT8 量化会带来巨大误差。
- 混合计算模式:
- 离群值 → 使用 FP16 计算(保证精度)
- 正常值 → 使用 INT8 计算(节省内存与加速)
- 内存优化:相比全 FP16 推理,可减少 70–75% 的内存占用。
- 精度表现:在 13B 参数以上的大模型上几乎无损,适合需要高精度的大模型部署。
优势与适用场景
- 适合 大模型(≥13B) 部署,尤其在 GPU 显存受限但又不能接受明显精度下降时。
- 对硬件要求较高(需支持 INT8 与 FP16 混合运算,如 Ampere 架构及以上 NVIDIA GPU)。
2. SmoothQuant 方案
核心创新:将量化难度从激活(X)转移到权重(W),通过数学变换让激活更容易量化,从而在全 INT8 推理中实现更低精度损失。
数学原理
平滑因子计算公式:
s=max(∣X∣)αmax(∣W∣)1−αs = \frac{\max(|X|)\alpha}{\max(|W|){1-\alpha}}s=max(∣W∣)1−αmax(∣X∣)α
- 一般取
α=0.5\alpha = 0.5α=0.5
- 做均衡。
- 通过对权重和激活同时做比例缩放,让两者的动态范围匹配,减少量化误差。
实施步骤
- 统计最大值:分别计算激活和权重的每通道最大值
max(∣X∣)\max(|X|)max(∣X∣)
- 、
max(∣W∣)\max(|W|)max(∣W∣)
- 。
- 计算平滑因子
sss
- :按公式得到每通道的缩放比例。
- 变换:
- 权重:
W′=W×sW’ = W \times sW′=W×s
- 激活:
X′=X/sX’ = X / sX′=X/s
- 量化:对
W′W’W′
- 与
X′X’X′
- 分别进行 INT8 量化。
优势与适用场景
- 可实现 全 INT8 推理,无需混合 FP16,计算效率高。
- 对大模型和小模型均适用,尤其在推理速度优先且硬件对 INT8 支持良好时效果佳。
- 在部署服务器端推理服务时可显著降低延迟与带宽压力。
3. 实践建议与选型指南
按模型规模选择
| 模型规模 | 推荐混合精度量化方案 |
|---|---|
| < 7B | GPTQ INT4 量化(侧重极致压缩) |
| 7B–13B | AWQ INT4 或 GPTQ INT8(平衡精度与资源) |
| ≥ 13B | LLM.int8() 或 SmoothQuant(保证高精度+内存优化) |
按硬件平台适配
| 硬件平台 | 推荐方案 |
|---|---|
| NVIDIA GPU | TensorRT-LLM + INT8 量化(利用 Tensor Core 加速) |
| Intel CPU | OpenVINO + INT8 量化(优化 x86 推理) |
| ARM 设备 | TFLite + INT8 量化(移动端与嵌入式友好) |
4. 混合精度量化的优势总结
- 内存与显存节省:通过低精度表示大幅压缩模型体积与运行时内存。
- 推理加速:INT8/INT4 运算在支持硬件上可获数倍速度提升。
- 精度保持:关键部分保留 FP16 或动态保护重要权重,避免低精度带来的性能崩塌。
- 灵活适配:可根据模型规模、任务需求、硬件环境选择不同混合策略,实现最优部署。
✅ 结论:
混合精度量化策略是当前大模型本地部署与高效推理的核心技术之一。LLM.int8() 通过离群值分离保护精度,SmoothQuant 通过数学变换降低量化难度,两者在不同场景下互为补充。结合模型规模与硬件平台合理选型,可在保证性能的同时最大化资源利用率,为大模型在服务器、边缘设备和端侧的高效运行提供可行路径。
第六章:微调与量化联合训练
6.1 QAT微调技术
QAT(Quantization-Aware Training,量化感知训练) 是一种在模型训练/微调阶段即引入量化操作的方案,其核心目标是让模型在训练过程中“感知”量化带来的误差,从而在推理阶段使用低精度(如INT8、INT4)时依然保持接近全精度的性能。与训练后量化(PTQ,如GPTQ、AWQ)不同,QAT在微调阶段就模拟量化误差,并通过反向传播优化权重,使模型天然适应低精度推理。
1. 核心原理
1.1 训练阶段模拟量化
- 在前向传播中插入伪量化节点(Fake Quantization Node),即在计算图中加入**量化(Quantize)→反量化(Dequantize)**操作,使模型在训练中就能感受到低精度的数值范围和舍入误差。
- 反向传播时,由于量化函数不可导,采用**直通估计器(Straight-Through Estimator, STE)**来近似梯度,使梯度可以直接穿过量化节点,从而正常更新全精度权重。
1.2 量化误差提前补偿
- 通过在训练阶段反复暴露模型于量化误差,模型参数会逐渐调整到对量化更鲁棒的状态,从而在推理阶段使用真正的整型运算时精度损失最小。
- 相比PTQ只在训练后做一次映射,QAT的精度优势通常在2–5个百分点(根据具体任务和模型大小不同)。
2. 技术流程
- 插入量化/反量化Stub 在模型输入和输出处分别加入 QuantStub (量化入口)和 DeQuantStub (反量化出口),并在需要量化的层之间插入伪量化节点。
- 配置QAT量化策略 设定量化方式(对称/非对称)、粒度(per-tensor或per-channel)、目标精度(int8、int4等),并选择后端(如 fbgemm 用于服务器推理, qnnpack 用于移动端)。
- 准备QAT模型 使用框架工具(如PyTorch的 prepare_qat )将模型转换为QAT模式,此时计算图已包含伪量化节点。
- QAT微调训练 在目标任务数据上继续训练(或微调),优化全精度权重,使模型适应量化误差。训练过程与普通微调类似,只是前向传播中多了量化模拟。
- 转换为真实量化模型 微调完成后,调用 convert 将QAT模型转为真正的低精度整型模型,用于推理部署。此时模型不再包含伪量化节点,计算完全在低位宽下进行。
3. PyTorch代码示例
import torch
import torch.nn as nn
from torch.quantization import QuantStub, DeQuantStub, prepare_qat, convert


# 1. 定义带QAT支持的模型
class QATModel(nn.Module):
    def __init__(self, base_model):
        super().__init__()
        self.base_model = base_model
        self.quant = QuantStub()   # 量化入口
        self.dequant = DeQuantStub() # 反量化出口

    def forward(self, x):
        x = self.quant(x)            # 模拟量化
        x = self.base_model(x)       # 模型前向
        x = self.dequant(x)          # 模拟反量化
        return x


# 2. 准备QAT模型
model = QATModel(base_model)
# 选择QAT配置(fbgemm适用于服务器端int8推理)
model.qconfig = torch.quantization.get_default_qat_qconfig('fbgemm')
model_prepared = prepare_qat(model.train())  # 插入伪量化节点


# 3. QAT微调训练
for epoch in range(num_epochs):
    model_prepared.train()
    for batch_data, batch_labels in train_loader:
        optimizer.zero_grad()
        outputs = model_prepared(batch_data)
        loss = criterion(outputs, batch_labels)
        loss.backward()
        optimizer.step()


# 4. 转换为真实量化模型(推理阶段使用)
model_prepared.eval()
model_quantized = convert(model_prepared)  # 替换为int8运算
Python
4. 优势与适用场景
| 优势 | 说明 |
|---|---|
| 精度更高 | 相比PTQ,QAT能显著降低低精度推理的精度损失(2–5%),尤其在超低比特(INT4)下优势明显。 |
| 鲁棒性强 | 模型在训练阶段已适应量化误差,对分布偏移更稳健。 |
| 端到端优化 | 可与PEFT(如LoRA)结合,在微调与量化两阶段同时优化,适合大模型低资源部署。 |
适用场景
- 需要在INT8或更低精度下保持接近全精度性能的推理任务(如金融、医疗等高可靠性场景)。
- 模型部署在资源受限设备(边缘设备、移动端)且对延迟/内存敏感。
- 已有可用的全精度预训练/微调模型,希望在部署前进一步提升量化后精度。
5. 与PTQ的对比
| 特性 | QAT | PTQ(GPTQ、AWQ等) |
|---|---|---|
| 训练阶段 | 包含量化模拟,需额外微调 | 仅在训练后量化,无需额外训练 |
| 精度 | 高(接近全精度) | 中-高(依赖校准数据与算法) |
| 计算开销 | 高(需完整微调流程) | 低(一次校准即可) |
| 适用场景 | 精度优先、可承担训练成本 | 快速部署、资源有限 |
✅ 总结
QAT微调技术通过在训练阶段引入量化误差模拟,使模型提前适应低精度推理,从而在部署时获得更高的精度和更强的鲁棒性。它特别适合对推理精度要求苛刻且具备微调能力的场景,常与PEFT、混合精度训练等技术结合,用于大模型的本地化高效部署。
6.2 QLoRA微调实战
1️⃣ QLoRA 简介与核心原理
QLoRA(Quantized LoRA)是 LoRA(Low-Rank Adaptation)与 4-bit 量化结合的微调方法,由华盛顿大学等提出,核心思想是:
- 基础模型:用 4-bit NormalFloat (NF4) 量化加载,大幅降低显存占用(相比 FP16/FP32)。
- 适配器:在冻结的 4-bit 模型上叠加 16-bit LoRA 参数,只训练少量增量参数(通常占总参数的 0.1%-1%)。
- 优化器:使用 分页优化器(Paged Optimizer) 防止显存碎片。
- 双量化(Double Quantization):对量化常数再做一次量化,进一步压缩内存。
这样做的结果是:
- 在单张 24GB 显存 GPU(如 RTX 4090、A6000)上可微调 70B 参数模型。
- 保持接近全精度 LoRA 微调的性能。
2️⃣ 技术架构拆解
| 组件 | 作用 | 配置细节 |
|---|---|---|
| 4-bit 基础模型 | 降低模型本体显存 | load_in_4bit=True , bnb_4bit_quant_type=“nf4” , bnb_4bit_compute_dtype=bfloat16 |
| LoRA 适配器 | 训练增量参数 | r=16 , lora_alpha=32 , target_modules=[“q_proj”,“v_proj”,“k_proj”,“o_proj”] |
| 分页优化器 | 防止显存碎片 | optim=“paged_adamw_8bit” |
| 双量化 | 再压缩量化常数 | bnb_4bit_use_double_quant=True |
3️⃣ 完整训练流程(实战代码)
以下代码基于 Hugging Face Transformers + PEFT + BitsAndBytes + TRL(SFTTrainer),已在 Llama-2-7B 上验证可行。
import torch
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
TrainingArguments
)
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer
import bitsandbytes as bnb


# 1️⃣ 加载 4-bit 基础模型
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    load_in_4bit=True,
    bnb_4bit_compute_dtype=torch.bfloat16,      # 计算时使用 bf16 加速
    bnb_4bit_use_double_quant=True,             # 双量化进一步压缩
    bnb_4bit_quant_type="nf4",                  # NF4 格式比 INT4 更适配正态分布权重
    device_map="auto"                           # 自动分配 GPU/CPU
)


# 2️⃣ 配置 LoRA 参数
lora_config = LoraConfig(
    r=16,                          # 低秩矩阵的秩
    lora_alpha=32,                 # 缩放因子
    target_modules=["q_proj", "v_proj", "k_proj", "o_proj"],  # 针对 Transformer 注意力投影层
    lora_dropout=0.05,             # Dropout 防止过拟合
    bias="none",                   # 不训练偏置
    task_type="CAUSAL_LM"          # 因果语言建模任务
)


# 3️⃣ 包装为 PEFT 模型(只训练 LoRA 参数)
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()  # 应输出类似:trainable params: 16M || all params: 7B


# 4️⃣ 训练参数配置
training_args = TrainingArguments(
    output_dir="./qlora_results",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,   # 等效 batch_size=16
    warmup_steps=100,
    max_steps=1000,
    learning_rate=2e-4,
    fp16=True,                       # 混合精度训练
    logging_steps=10,
    optim="paged_adamw_8bit",        # 分页 AdamW 8-bit 优化器
    save_strategy="steps",
    save_steps=200,
    report_to="none"
)


# 5️⃣ 准备数据集(示例略,需自行构造 instruction-input-output 格式)
# train_dataset = ...


# 6️⃣ 创建 SFTTrainer 并开始训练
trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    peft_config=lora_config,
    packing=True  # 拼接短样本提升 GPU 利用率
)


trainer.train()


# 7️⃣ 保存 LoRA 权重(可合并到基础模型或直接推理使用)
model.save_pretrained("./qlora_llama2_7b")
4️⃣ 内存与性能对比
| 配置方案 | 显存占用 | 可训练参数 | 训练速度 | 备注 |
|---|---|---|---|---|
| 全参微调 (FP16) | ~80GB | 70亿 | 1× | 需多卡或高显存 |
| LoRA 微调 (FP16) | ~24GB | 1600万 | 1.5× | 需 FP16 基础模型 |
| QLoRA 微调 | ~8GB | 1600万 | 1.2× | 单卡 24GB 可跑 7B,40GB 可跑 13B,80GB 可跑 70B |
5️⃣ 实战注意事项与优化技巧
- 校准数据与量化稳定性
- 4-bit 加载时 BitsAndBytes 会自动校准,但建议用与目标任务相近的数据做 warm-up 推理,确保激活分布稳定。
- LoRA Target Modules 选择
- 对 LLaMA 结构常用 [“q_proj”,“v_proj”,“k_proj”,“o_proj”] ,也可加 “gate_proj”,“up_proj”,“down_proj” 覆盖 MLP 层,提高效果但增加训练参数。
- Batch Size 与 Gradient Accumulation
- 显存受限时减小 per_device_train_batch_size ,加大 gradient_accumulation_steps 保持有效 batch size。
- 学习率与优化器
- QLoRA 建议 LR 在 1e-4 ~ 2e-4 范围,使用 paged_adamw_8bit 可避免显存碎片。
- 推理部署
- 保存的 LoRA 权重可用 PeftModel.from_pretrained 动态加载,也可合并到基础模型后导出 GGUF 供 llama.cpp 推理。
- 双量化与 NF4
- bnb_4bit_use_double_quant=True 在多数场景能再省 0.5~1GB 显存。
- NF4 相比 INT4 对正态分布权重更友好,精度更高。
6️⃣ 适用场景
- 单卡微调超大模型(13B/30B/70B)
- 边缘/实验室资源受限但需要自定义模型能力
- 需要快速迭代多个任务(LoRA 权重切换方便)
- 高价值场景需保持微调性能(如医疗、法律、金融问答)
✅ 总结
QLoRA 微调实战的核心是 4-bit 量化基础模型 + 16-bit LoRA 微调 + 分页优化器,通过这种组合,可以在消费级或单卡专业 GPU 上完成原本需要多卡/高显存的模型微调任务,并保持接近全精度 LoRA 的效果。只要按上述流程配置环境与代码,即可快速落地,并根据任务需求调整 LoRA rank、target modules 和学习率等超参来优化效果。
6.3 蒸馏-量化协同训练
核心思想:
将知识蒸馏与**量化感知训练(QAT)结合,通过“教师模型→学生模型的知识迁移”与“学生模型在训练中感知量化误差”两条主线并行,让学生在低精度(如INT8/INT4)**下同时继承教师模型的强大能力并保持高精度。该方法尤其适合在资源受限设备上部署高性能小模型。
1️⃣ 技术原理
知识蒸馏(Knowledge Distillation)
- 教师模型:通常为高精度的大模型(如 Llama-70B、GPT-3.5),提供软标签(soft targets)。
- 学生模型:结构更小、适合部署(如 Llama-7B 或定制小模型),通过学习教师的输出分布来获得接近教师的能力。
- 损失函数:
Ltotal=α⋅LCE(student_logits,labels)+β⋅LKL(student_soft,teacher_soft)L_{total} = \alpha \cdot L_{CE}(student_logits, labels) + \beta \cdot L_{KL}(student_soft, teacher_soft)Ltotal=α⋅LCE(student_logits,labels)+β⋅LKL(student_soft,teacher_soft)
LCEL_{CE}LCE
- :标准交叉熵损失(硬标签)
LKLL_{KL}LKL
- :KL散度损失(软标签)
α,β\alpha,\betaα,β
- :权重系数(常取 0.3 / 0.7 或 0.5 / 0.5)
- **温度参数 **
TTT
- :软化概率分布,一般取 2–5,使教师输出更平滑、富含类别间相似性信息。
量化感知训练(QAT)
- 在训练/微调阶段插入伪量化节点(Fake Quantization),模拟推理时的低精度运算误差。
- 通过反向传播的**直通估计器(STE)**让梯度穿透不可导的量化函数,更新全精度权重,使学生模型在量化后依然保持性能。
协同机制
- 阶段融合:蒸馏损失引导学生学习教师的知识表示,QAT让学生适应低精度推理,两者在同一个训练流程中共同作用。
- 误差补偿:蒸馏减少“能力差距”,QAT减少“精度损失”,协同降低部署后的性能下降。
2️⃣ 典型训练流程(三阶段策略)
| 阶段 | 目标 | 方法 | 说明 |
|---|---|---|---|
| ① 全精度蒸馏 | 学生模型学习教师知识 | Teacher(FP32)→ Student(FP32) 使用 KL + CE 损失 | 先让小模型在 FP32 下获得接近大模型的表示能力 |
| ② 量化感知训练 | 学生适应低精度运算 | 在模型中插入伪量化节点 保持蒸馏损失 | 学生模型在训练中感知 INT8/INT4 的舍入与截断误差 |
| ③ 微调校准 | 恢复量化后精度 | 用少量校准数据微调量化参数(scale、zero point) | 针对目标硬件分布优化,进一步减少推理误差 |
3️⃣ 代码框架示例
import torch
import torch.nn.functional as F
from torch.quantization import QuantStub, DeQuantStub, prepare_qat, convert


class QuantAwareDistillation:
    def __init__(self, teacher_model, student_model, T=3.0, alpha=0.3, beta=0.7):
        self.teacher = teacher_model.eval()  # 教师模型不训练
        self.student = student_model.train()
        self.T = T
        self.alpha = alpha
        self.beta = beta


        # QAT 量化桩
        self.quant = QuantStub()
        self.dequant = DeQuantStub()


    def forward(self, x):
        x = self.quant(x)
        x = self.student(x)
        x = self.dequant(x)
        return x


    def compute_loss(self, inputs, labels):
        # 教师输出(无梯度)
        with torch.no_grad():
            teacher_logits = self.teacher(inputs)


        # 学生输出(含伪量化)
        student_logits = self.student(inputs)


        # 蒸馏损失(KL散度)
        soft_loss = F.kl_div(
            F.log_softmax(student_logits / self.T, dim=-1),
            F.softmax(teacher_logits / self.T, dim=-1),
            reduction='batchmean'
        ) * (self.T * self.T)


        # 硬标签损失(交叉熵)
        hard_loss = F.cross_entropy(student_logits, labels)


        # 总损失
        total_loss = self.alpha * hard_loss + self.beta * soft_loss
        return total_loss


# 使用流程:
# 1. 初始化教师模型(FP32)和学生模型(可带 LoRA / 全参数)
# 2. 包装为 QuantAwareDistillation
# 3. 三阶段训练:全精度蒸馏 → QAT → 微调校准
# 4. 转换为真实 INT8/INT4 推理模型
Python
4️⃣ 优势与适用场景
| 优势 | 说明 |
|---|---|
| 性能接近大模型 | 蒸馏让学生继承教师能力,量化后仍保持较高精度 |
| 部署成本低 | 学生模型体积小、推理速度快,适合边缘/移动端 |
| 精度鲁棒性高 | QAT提前适应量化误差,减少部署掉点 |
| 灵活组合 | 可与 LoRA、PEFT、混合精度训练结合,进一步优化资源利用 |
适用场景:
- 将云端超大规模模型能力迁移到本地/边缘设备
- 对推理延迟、内存占用敏感的业务(如实时翻译、车载系统、智能客服)
- 高可靠性领域(医疗、金融)需要低精度部署但不接受性能大幅下降
5️⃣ 与单独技术的对比
| 方法 | 精度 | 资源需求 | 部署友好性 | 适合场景 |
|---|---|---|---|---|
| 单独蒸馏 | 中-高 | 低 | 高 | 需要小模型但不在乎推理精度损失 |
| 单独QAT | 高 | 中 | 高 | 已有可用模型,需压缩到低位宽 |
| 蒸馏-量化协同 | 高 | 低-中 | 很高 | 既要小模型又要高精度推理 |
✅ 总结
蒸馏-量化协同训练通过知识迁移 + 量化误差提前补偿的双路径优化,让小模型在低位宽部署下依然能逼近大模型的性能,是目前大模型能力落地到资源受限环境的最有效方案之一。三阶段训练策略(全精度蒸馏 → QAT → 微调校准)可系统化实现这一目标,配合 LoRA/PEFT 等参数高效微调技术,能在单卡甚至边缘设备上完成高性能模型的部署。
第七章:模型部署架构与环境规划
7.1 硬件需求计算
1️⃣ 显存估算公式
大模型运行时显存占用主要来自 4 个部分:
总显存=模型参数显存+激活显存+优化器状态显存+梯度显存\text{总显存} = \text{模型参数显存} + \text{激活显存} + \text{优化器状态显存} + \text{梯度显存}总显存=模型参数显存+激活显存+优化器状态显存+梯度显存
其中:
- 模型参数显存
=参数量×精度字节数= \text{参数量} \times \text{精度字节数}=参数量×精度字节数
- 例:7B 参数模型,FP16(2字节) →
7×109×2=14 GB7\times10^9 \times 2 = 14\ \text{GB}7×109×2=14 GB
- 激活显存(推理/训练时每层前向激活)
≈序列长度×隐藏维度×层数×2×精度字节数\approx \text{序列长度} \times \text{隐藏维度} \times \text{层数} \times 2 \times \text{精度字节数}≈序列长度×隐藏维度×层数×2×精度字节数
- (系数 2 是因为激活要存前向+反向的中间结果,推理时可减少)
- 优化器状态显存(如 Adam)
=参数量×12= \text{参数量} \times 12=参数量×12
- (Adam 存一阶矩、二阶矩、参数共 3 份,FP32 即
3×4=123\times4=123×4=12
- 字节/参数)
- 梯度显存
=参数量×精度字节数= \text{参数量} \times \text{精度字节数}=参数量×精度字节数
注:推理时只需「模型参数显存 + 激活显存」;训练时加上优化器状态和梯度显存,会多出很多。
2️⃣ 不同规模模型显存需求(推理场景为主)
| 模型规模 | 参数量 | FP16显存 | INT8显存 | INT4显存 | 推荐硬件 |
|---|---|---|---|---|---|
| 轻量级 | 7B | 14 GB | 7 GB | 3.5 GB | RTX 3090 / RTX 4090 |
| 中等 | 13B | 26 GB | 13 GB | 6.5 GB | RTX A6000 (48GB) |
| 大型 | 70B | 140 GB | 70 GB | 35 GB | 2×A100 80GB / H100 |
| 超大型 | 180B | 360 GB | 180 GB | 90 GB | 4×A100/H100 |
提示:
- 上表显存为推理时模型参数显存的近似值,不含 KV 缓存和批处理激活。
- 若用 QLoRA / GPTQ 等量化方案,基础模型显存可按对应压缩比计算(如 INT4 约为 FP16 的 1/4)。
- 若开启 梯度检查点 或 LoRA 微调,需额外加 LoRA 参数显存(通常 MB~GB 级)。
3️⃣ 内存带宽要求
- 推理瓶颈:主要受内存带宽限制吞吐量,而不是算力。
- 吞吐量公式(粗略):
吞吐量 (tokens/s)≈内存带宽模型大小(字节)\text{吞吐量} \ (\text{tokens/s}) \approx \frac{\text{内存带宽}}{\text{模型大小(字节)}}吞吐量 (tokens/s)≈模型大小(字节)内存带宽
- 例:A100 PCIe 版内存带宽约 2 TB/s,模型大小 14 GB(FP16 7B)→ 理论峰值吞吐约 143 tokens/s(单 batch 推理)。
- 优化策略:
- KV 缓存复用:避免重复计算历史 token 的 Key/Value。
- 连续内存访问:优化权重加载布局,减少显存碎片。
- 批处理合并:合理增大 batch size 提高带宽利用率(受显存限制)。
- 量化:降低模型字节数,提高带宽利用率(INT4 推理速度约为 FP16 的 2–4 倍)。
4️⃣ 实战速查表(推理部署)
| 目标模型 | 量化方案 | 显存需求(约) | 单卡可部署硬件示例 |
|---|---|---|---|
| 7B | FP16 | 14 GB | RTX 4090 (24GB) |
| 7B | INT8 | 7 GB | RTX 3060 (12GB) |
| 7B | INT4 (GPTQ/AWQ) | 3.5 GB | RTX 3060 / Jetson Orin |
| 13B | FP16 | 26 GB | RTX A6000 (48GB) |
| 13B | INT4 | 6.5 GB | RTX 4090 |
| 70B | INT4 | 35 GB | 2×RTX A6000 或 1×H100 |
| 180B | INT4 | 90 GB | 4×A100 80GB |
5️⃣ 计算示例
例:在单张 RTX 4090 (24GB) 部署 13B 模型,用 INT4 量化
- 模型参数显存 ≈
13×109×0.5 字节=6.5 GB13\times10^9 \times 0.5\ \text{字节} = 6.5\ \text{GB}13×109×0.5 字节=6.5 GB
- 激活显存(序列 2048、hidden 5120、layer 40,INT4 计 0.5字节):
2048×5120×40×0.5≈0.2 GB2048 \times 5120 \times 40 \times 0.5 \approx 0.2\ \text{GB}2048×5120×40×0.5≈0.2 GB
- (推理时很小)
- 总显存 ≈ 6.7 GB → 可部署,且剩余显存可用于 KV 缓存和批处理。
✅ 总结
硬件需求计算的关键是:
- 按参数量 × 精度字节数估算模型本体显存;
- 推理场景加激活显存,训练场景再加优化器状态和梯度显存;
- 量化可显著降低显存(INT8减半,INT4再减半);
- 内存带宽决定推理吞吐量,KV 缓存和连续访存是优化重点;
- 结合你的硬件(显卡显存/带宽)反推可部署的最大模型规模与量化方案。?
7.2 单卡部署方案
一、Ollama一键部署(最简单)
Ollama是本地大模型运行工具,支持macOS/Windows/Linux,提供一键安装、模型管理与API服务,适合快速体验或轻量级部署。
1. 核心优势
- 零代码:一条命令安装,一条命令运行模型;
- 跨平台:支持主流操作系统;
- 模型丰富:内置Ollama模型库(如Llama3、Qwen、DeepSeek等);
- API兼容:默认暴露 http://localhost:11434 接口,可对接Chatbox、Page Assist等前端。
2. 部署步骤
(1)安装Ollama
# Linux/macOS(一键脚本)
curl -fsSL https://ollama.com/install.sh | sh


# Windows:下载安装包( https://ollama.com/download/windows ),双击运行
Bash
(2)拉取并运行模型
Ollama模型库地址: https://ollama.com/library
示例:运行Llama3.2-1B(轻量模型,适合低显存)、Qwen1.5-7B-Chat(中文优化)、DeepSeek-R1(推理模型):
# 拉取模型(首次运行自动下载)
ollama pull llama3.2:1b       # 1B参数,FP16约2GB,INT4约0.5GB
ollama pull qwen1.5-7b-chat   # 7B参数,FP16约14GB,INT4约3.5GB
ollama pull deepseek-r1       # 7B参数,需联网下载


# 运行模型(进入交互式对话)
ollama run llama3.2:1b
ollama run qwen1.5-7b-chat
Bash
(3)常用命令
ollama list          # 查看已安装的模型
ollama ps            # 查看运行中的模型进程
ollama stop <model>  # 停止指定模型(如ollama stop qwen1.5-7b-chat)
ollama rm <model>    # 删除模型(释放磁盘空间)
ollama serve         # 后台启动Ollama服务(默认已自动启动)
Bash
(4)对接前端界面
Ollama默认提供API,可搭配Chatbox(图形化聊天)、Page Assist(浏览器插件,支持知识库)使用:
- Chatbox配置:设置API地址为 http://localhost:11434 ,选择对应模型即可聊天;
- Page Assist:安装Chrome插件后,配置Ollama API,支持上传文档构建本地知识库。
3. 硬件适配建议
| 模型规模 | Ollama推荐配置 | 示例硬件 |
|---|---|---|
| 1B-7B | 16GB内存 + 8GB显存(RTX3060) | RTX3060(12GB)、RTX4060Ti(16GB) |
| 7B-13B | 32GB内存 + 16GB显存(RTX4060Ti) | RTX4070 Super(16GB)、RTX A6000(48GB) |
| 13B+ | 64GB内存 + 24GB+显存 | RTX A100(40GB)、H100(80GB) |
二、Transformers + Gradio方案(灵活可控)
若需自定义推理逻辑(如修改生成参数、添加业务逻辑)或搭建Web界面,可使用Hugging Face Transformers加载模型,结合Gradio快速构建交互界面。
1. 核心优势
- 灵活:可自定义模型加载(量化、LoRA、设备分配)、生成参数(max_new_tokens、temperature);
- 可视化:Gradio快速生成Web聊天界面,支持多轮对话、历史记录;
- 扩展性强:可对接数据库、知识库或业务系统(如OA、CRM)。
2. 部署步骤
(1)环境准备
安装依赖库(以Python为例):
pip install torch transformers gradio accelerate bitsandbytes
Bash
- torch :PyTorch框架(需匹配CUDA版本,如 torch==2.0.1+cu117 );
- transformers :Hugging Face模型加载库;
- gradio :Web界面构建工具;
- accelerate :自动设备分配(GPU/CPU);
- bitsandbytes :量化支持(如4-bit/8-bit加载)。
(2)代码实现(以Qwen1.5-7B-Chat为例)
以下代码实现4-bit量化加载(降低显存占用)+ Gradio Web界面:
import torch
import gradio as gr
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
BitsAndBytesConfig
)


# ------------------- 1. 配置量化参数(4-bit) -------------------
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,                  # 4-bit量化
    bnb_4bit_quant_type="nf4",          # NF4格式(适配正态分布权重)
    bnb_4bit_compute_dtype=torch.bfloat16,  # 计算时用bfloat16加速
    bnb_4bit_use_double_quant=True     # 双量化(进一步压缩常数)
)


# ------------------- 2. 加载模型与分词器 -------------------
model_name = "Qwen/Qwen1.5-7B-Chat"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    quantization_config=bnb_config,     # 应用量化配置
    device_map="auto",                  # 自动分配GPU/CPU(优先GPU)
    trust_remote_code=True,
    low_cpu_mem_usage=True              # 低内存加载(避免CPU爆内存)
)


# ------------------- 3. 定义聊天函数 -------------------
def chat(message, history):
    # 拼接历史对话(Gradio传递的history是多轮对话列表)
    conversation = ""
    for human, assistant in history:
        conversation += f"Human: {human}\nAssistant: {assistant}\n"
    conversation += f"Human: {message}\nAssistant:"

    #  tokenize输入
    inputs = tokenizer(conversation, return_tensors="pt").to(model.device)

    # 生成响应(自定义参数)
    outputs = model.generate(
        **inputs,
        max_new_tokens=512,       # 最大生成长度
        temperature=0.7,          # 随机性(0~1,越小越确定)
        top_p=0.9,                #  nucleus采样(保留前90%概率的token)
        do_sample=True,           # 开启采样(否则贪心解码)
        pad_token_id=tokenizer.pad_token_id
    )

    # 解码响应(跳过特殊token)
    response = tokenizer.decode(outputs[0], skip_special_tokens=True)
    # 提取Assistant的回复(去掉前面的对话历史)
    response = response.split("Assistant:")[-1].strip()
    return response


# ------------------- 4. 启动Gradio界面 -------------------
gr.ChatInterface(
    fn=chat,
    title="Qwen1.5-7B-Chat 单卡部署",
    description="基于Transformers + Gradio的单卡推理界面",
    examples=["你好,介绍一下大模型量化", "写一段Python代码实现冒泡排序"]
).launch(share=True)  # share=True生成公网链接(可选)
(3)运行与访问
执行代码后,终端会输出Web界面地址(如 http://localhost:7860 ),打开浏览器即可聊天。
3. 关键优化技巧
- 量化加载:使用 bitsandbytes 的4-bit量化,可将7B模型显存占用从14GB降至3.5GB(适配RTX3060等12GB显存卡);
- 设备分配: device_map=“auto” 自动将模型层分配到GPU/CPU,避免显存溢出;
- 生成参数调优: temperature (随机性)、 top_p (多样性)、 max_new_tokens (长度)可根据任务调整(如代码生成用低temperature,创意写作用高temperature);
- 批处理:若需提升吞吐量,可修改 chat 函数支持batch输入(需调整tokenize与generate逻辑)。
三、单卡部署注意事项
- 显存限制:
- 推理时显存≈模型参数显存+激活显存(KV缓存);
- 7B模型FP16需14GB显存,INT4仅需3.5GB(优先选量化模型);
- 若显存不足,可减小 max_new_tokens 或关闭 do_sample 。
- 量化选择:
- 低显存卡(≤12GB):选4-bit量化(如GPTQ、AWQ)或1B-7B小模型;
- 高显存卡(≥24GB):可选FP16/INT8,追求更高精度。
- 模型兼容性:
- 部分模型(如Qwen、DeepSeek)需设置 trust_remote_code=True (允许加载自定义模型代码);
- 确保PyTorch与CUDA版本匹配(如CUDA 11.7对应PyTorch 2.0+)。
- 性能监控:
- 使用 nvidia-smi 查看GPU显存/利用率;
- 若吞吐量低,可增大 batch_size (需平衡显存)或优化KV缓存(如复用历史Key/Value)。
总结
- 快速体验:选Ollama,一条命令跑模型,适合新手或非技术人员;
- 自定义需求:选Transformers + Gradio,灵活控制模型加载与界面逻辑,适合开发者;
- 硬件适配:根据模型规模选量化方案(4-bit/INT8/FP16),确保显存足够。
通过以上方案,可在单卡上高效部署大模型,满足本地推理、知识库问答、创意生成等场景需求。
7.3 多卡并行策略
多卡并行策略是大模型训练与推理中突破单卡显存/算力限制的核心技术,通过将计算任务拆分到多个GPU协同完成,实现更大模型、更长序列或更高吞吐量的处理。根据拆分维度的不同,主要分为模型并行、流水线并行、数据并行三类,实际中常结合使用形成混合并行策略。以下是详细解析:
一、模型并行(Tensor Parallelism)
核心原理
将模型单层内的参数张量按维度拆分到多个GPU,每个GPU仅存储和计算部分参数,通过通信聚合中间结果完成前向/反向传播。例如,将Transformer层的注意力矩阵(如Q/K/V投影矩阵)按列拆分到不同GPU,计算时各GPU处理局部张量,再通过All-Reduce等操作合并结果。
实现方式
- Megatron-LM:NVIDIA提出的经典模型并行框架,支持Transformer层的张量拆分(如将多头注意力的头拆分到不同GPU),通过高效的通信原语(如NCCL)实现张量聚合。
- DeepSpeed Inference:支持张量并行推理,通过 tensor_parallel_degree 参数指定并行度(如2/4/8卡),自动拆分模型层并优化通信。
适用场景
单卡无法容纳的超大规模模型(如70B/180B参数模型),或需要处理超长序列(如32k/128k tokens)的场景。
通信开销
每层计算需触发All-Reduce操作(聚合各GPU的中间结果),通信量与模型层大小和并行度正相关。例如,7B模型的注意力层拆分到2卡时,每层需传输约 (d_model×d_model)/2 的浮点数据(d_model为隐藏层维度)。
二、流水线并行(Pipeline Parallelism)
核心原理
将模型按层分段(如将Transformer的前10层放GPU0,中间10层放GPU1,后10层放GPU2),不同GPU负责不同阶段的计算。通过**微批次(Micro-Batch)**将大批次数据拆分为更小的子批次,依次流经各阶段,形成流水线作业。
关键问题与优化
- 气泡问题(Pipeline Bubble):流水线启动时,前序阶段已完成计算但后续阶段未就绪,导致GPU空闲。通常占训练时间的10%-30%。
- 优化方法:
- 1F1B调度(One Forward One Backward):每个GPU交替执行前向和反向传播,减少空闲时间。
- 交错调度(Interleaved Scheduling):将一个批次拆分为更多微批次(如8个),流水线更密集,气泡占比降至5%以下。
实现方式
- GPipe:Google提出的流水线并行框架,通过微批次和1F1B调度优化气泡。
- DeepSpeed Pipeline Parallelism:支持动态调整微批次大小和调度策略,兼容ZeRO优化。
适用场景
模型层数极深(如1000+层)或单卡无法容纳完整模型层的场景(如GPT-3 175B的96层Transformer)。
三、数据并行(Data Parallelism)
核心原理
每个GPU存储完整的模型副本,将训练数据按批次拆分到不同GPU,各自独立计算前向/反向传播,再通过**梯度同步(All-Reduce)**聚合梯度并更新模型参数。
实现方式
- PyTorch DDP(Distributed Data Parallel):通过 torch.distributed 实现梯度All-Reduce,支持多卡同步训练。
- Horovod:Uber开源的分布式训练框架,支持TensorFlow/PyTorch,通过MPI或NCCL实现高效梯度同步。
适用场景
模型可单卡容纳(如7B/13B),但需提升训练吞吐量(增大有效批次大小)的场景。例如,8卡数据并行可将批次大小从8提升至64(8卡×8 batch)。
通信开销
每次反向传播需同步所有参数的梯度(如7B模型FP16梯度约14GB),通信时间与GPU间带宽成反比(如A100 NVLink带宽600GB/s,同步14GB梯度约23ms)。
四、混合并行策略
实际中,单一并行策略无法满足超大规模模型(如180B参数)的需求,需结合模型并行、流水线并行和数据并行,形成混合并行。例如:
- 训练70B模型:使用2路模型并行(拆分单层张量到2卡)+ 4路流水线并行(按层分4段)+ 8路数据并行(8卡处理不同数据),总并行度为 2×4×8=64卡 。
- 推理优化:使用模型并行(拆分模型层到多卡)+ 数据并行(多卡处理不同请求),提升吞吐量。
典型框架与配置
以DeepSpeed为例,通过配置文件定义混合并行策略(如ZeRO-3优化+模型并行+流水线并行):
ds_config = {
    "train_batch_size": 1024,          # 总批次大小
    "train_micro_batch_size_per_gpu": 8,  # 单卡微批次大小
    "pipeline": {
        "stages": 4,                   # 流水线阶段数(4卡)
        "activation_checkpoint_interval": 1  # 每1层做激活检查点
    },
    "tensor_parallel": {
        "tp_size": 2                   # 模型并行度(2卡)
    },
    "zero_optimization": {
        "stage": 3,                    # ZeRO第三阶段(参数/梯度/优化器状态分片)
        "offload_param": {"device": "cpu"}  # 参数卸载到CPU(节省GPU显存)
    }
}
Python
五、策略选择与注意事项
| 策略 | 优势 | 挑战 | 适用场景 |
|---|---|---|---|
| 模型并行 | 突破单卡张量容量限制 | 通信开销大,需高带宽互联(如NVLink) | 超大模型(≥70B)、长序列处理 |
| 流水线并行 | 突破单卡层数限制 | 气泡问题,需优化调度策略 | 超深模型(≥100层)、模型层无法拆分 |
| 数据并行 | 简单易实现,提升训练吞吐量 | 单卡需容纳完整模型,显存压力大 | 中小模型(≤13B)、高吞吐量训练 |
| 混合并行 | 灵活组合,支持任意规模模型 | 配置复杂,需调优并行度和通信 | 超大规模模型(≥70B)训练/推理 |
注意事项:
- 通信优化:使用高速互联(如NVLink、InfiniBand)降低通信延迟;启用通信计算重叠(如DeepSpeed的 overlap_comm )。
- 显存管理:结合激活检查点(Gradient Checkpointing)减少激活显存占用;使用ZeRO优化分片参数/梯度/优化器状态。
- 负载均衡:确保各GPU计算量均衡(如模型并行时拆分均匀的张量,流水线并行时各阶段层数相近)。
总结
多卡并行策略通过拆分模型、数据或计算阶段,突破单卡资源限制,是大模型训练与推理的必备技术。实际应用中需根据模型规模、硬件资源(显存/带宽)和任务需求(训练/推理),选择单一或混合并行策略,并通过框架(如DeepSpeed、Megatron-LM)优化配置,实现效率与成本的平衡。
7.4 GPU检测与优化
1️⃣ GPU检测脚本与信息收集
基础环境检测
上文中脚本已经覆盖了 PyTorch 与 CUDA 的基本信息,这里稍作增强,加入 NVML(NVIDIA Management Library) 监控实时显存与利用率:
import torch
import pynvml
import subprocess


def check_gpu_environment():
    """全面检测GPU环境(含实时利用率)"""
    print(f"PyTorch版本: {torch.__version__}")
    print(f"CUDA可用: {torch.cuda.is_available()}")


    if torch.cuda.is_available():
        print(f"CUDA版本: {torch.version.cuda}")
        print(f"cuDNN版本: {torch.backends.cudnn.version()}")
        print(f"GPU数量: {torch.cuda.device_count()}")


        pynvml.nvmlInit()
        for i in range(torch.cuda.device_count()):
            handle = pynvml.nvmlDeviceGetHandleByIndex(i)
            name = torch.cuda.get_device_name(i)
            props = torch.cuda.get_device_properties(i)
            mem_info = pynvml.nvmlDeviceGetMemoryInfo(handle)
            util = pynvml.nvmlDeviceGetUtilizationRates(handle)


            print(f"\nGPU {i}: {name}")
            print(f"  显存总量: {mem_info.total / 1e9:.2f} GB")
            print(f"  显存已用: {mem_info.used / 1e9:.2f} GB")
            print(f"  显存可用: {mem_info.free / 1e9:.2f} GB")
            print(f"  计算能力: {props.major}.{props.minor}")
            print(f"  SM数量: {props.multi_processor_count}")
            print(f"  当前GPU利用率: {util.gpu}%")
            print(f"  当前显存利用率: {util.memory}%")


        pynvml.nvmlShutdown()
    else:
        print("未检测到可用GPU,请检查驱动和CUDA安装。")


if __name__ == "__main__":
    check_gpu_environment()
💡 用途:
- 查看显卡型号、显存容量、计算能力
- 实时监控显存占用与 GPU 利用率,判断是否出现瓶颈(如显存不足、算力闲置)
2️⃣ 常见性能瓶颈检测
| 瓶颈类型 | 检测方式 | 典型表现 |
|---|---|---|
| 显存不足 | nvidia-smi / pynvml 显存占用 ≥ 90% | OOM(Out Of Memory)报错,训练/推理中断 |
| 算力闲置 | GPU利用率 < 50% | 数据传输慢、CPU预处理拖慢、批次过小 |
| PCIe/NVLink带宽限制 | 多卡训练时通信耗时占比高 | nvtop / nsys 显示 All-Reduce 时间长 |
| Kernel效率低 | nsys / nvprof 看到单个kernel耗时久 | 未使用FlashAttention、未融合算子 |
3️⃣ GPU优化技巧(实战)
内核融合与高效算子
- FlashAttention:替代标准Attention,减少显存读写,提速 2–4 倍
pip install flash-attn
Bash
使用时在模型加载或Trainer配置里开启(如HuggingFace attn_implementation=“flash_attention_2” )。
- Fused LayerNorm / Fused MLP:部分框架(如 Megatron-LM、DeepSpeed-Inference)会自动融合,提高效率。
显存优化
- 梯度检查点(Gradient Checkpointing):用时间换空间,减少激活显存
model.gradient_checkpointing_enable()
Python
- 激活重计算:推理阶段可关闭不必要的中间保存。
- ZeRO优化(DeepSpeed):分片参数/梯度/优化器状态,显著降低显存占用(ZeRO-3 + CPU Offload 可单卡跑更大模型)。
连续内存与碎片减少
- 张量创建时尽量 contiguous() ,避免 stride 导致的低效访存。
- 批量推理时预先分配固定大小的 buffer,减少动态分配。
异步数据传输与计算重叠
- 使用 .to(device, non_blocking=True) 异步拷贝数据到 GPU。
- DeepSpeed / Apex 支持计算与通信重叠,提高多卡效率。
图优化与推理加速
- TorchScript:将模型序列化为静态图,减少 Python 解释开销。
- ONNX Runtime / TensorRT:针对固定输入尺寸做图优化与 kernel 融合,大幅提升推理吞吐。
- FP16 / BF16 混合精度:利用 Tensor Core 加速(Ampere 架构及以上)。
from torch.cuda.amp import autocast, GradScaler
4️⃣ 性能分析工具
| 工具 | 功能 | 使用场景 |
|---|---|---|
| nvidia-smi | 实时显存/利用率监控 | 快速查看GPU状态 |
| nvtop | 类 htop 的GPU监控 | 观察多卡利用率变化 |
| Nsight Systems ( nsys ) | 全栈性能分析(CPU-GPU时间线) | 找出kernel耗时、通信瓶颈 |
| Nsight Compute ( ncu ) | Kernel级别分析 | 优化单个CUDA kernel |
| PyTorch Profiler | 捕获模型各层耗时 | 定位慢算子 |
| DeepSpeed Profiling | 多卡训练通信分析 | 优化混合并行效率 |
示例(PyTorch Profiler):
with torch.profiler.profile(
    activities=[torch.profiler.ProfilerActivity.CUDA, torch.profiler.ProfilerActivity.CPU],
    record_shapes=True,
    on_trace_ready=torch.profiler.tensorboard_trace_handler('./log')
) as prof:
    trainer.train()  # 或 model inference
print(prof.key_averages().table(sort_by="cuda_time_total"))
5️⃣ 优化流程建议
- 检测硬件上限:用 check_gpu_environment 摸清显存/算力。
- 监控运行时状态: nvidia-smi / nvtop 看利用率与显存曲线。
- 定位瓶颈:
- 显存不足 → 梯度检查点 / 量化 / ZeRO / 减小 batch
- 算力闲置 → 增大 batch / 数据加载优化 / 使用 FlashAttention
- 通信慢 → 高速互联(NVLink/InfiniBand)/ 通信计算重叠
- 应用优化技术:按表格选择融合算子、混合精度、图优化。
- 性能剖析:用 nsys / ncu /PyTorch Profiler 验证改进效果。
- 迭代:循环 2–5 步,直至达到目标吞吐/延迟。
✅ 总结
GPU检测与优化是大模型高效训练/推理的前提。
- 检测:用脚本+实时监控工具摸清硬件能力与运行状态。
- 优化:围绕显存、算力、通信三大瓶颈,结合内核融合、混合精度、量化、并行策略与图优化。
- 工具链: nvidia-smi / nvtop → nsys / ncu → PyTorch Profiler → DeepSpeed/Megatron 框架调优。
这样即可在单卡或多卡环境下,最大化 GPU 利用率,稳定高效运行大模型微调与推理任务。
第八章:推理服务与运维监控
8.1 推理框架选型对比
主流推理框架的选型对比如下,涵盖核心优势、支持模型、适用场景及性能表现:
一、主流推理框架特性对比表
| 框架 | 核心优势 | 支持模型 | 适用场景 | 性能表现 |
|---|---|---|---|---|
| vLLM | 基于PagedAttention技术,高效管理KV缓存,显著提升吞吐量;支持动态批处理、连续批处理优化。 | HuggingFace主流模型(如Llama、Qwen等) | 高并发生产环境(如大规模API服务) | 吞吐量最优(同类框架领先) |
| TensorRT-LLM | NVIDIA官方优化,深度整合Tensor Core,支持INT4/INT8量化;针对NVIDIA GPU极致优化,低延迟推理。 | NVIDIA优化模型(如Llama、GPT系列) | 实时推理(如对话系统、低延迟需求场景) | 极低延迟(毫秒级响应) |
| llama.cpp | 轻量级设计,支持CPU/GPU混合计算;兼容GGUF格式模型(量化友好),资源占用低。 | GGUF格式模型(如Llama、Mistral等) | 边缘设备(如手机、嵌入式设备)、低资源环境 | 资源效率高(CPU/小GPU可运行) |
| TGI | 支持持续批处理(Continuous Batching)和流式输出(Streaming);优化文本生成任务的响应速度。 | 文本生成模型(如Llama、Falcon等) | 聊天应用(如在线客服、AI助手) | 响应速度快(流式输出流畅) |
| ONNX Runtime | 跨平台支持(Windows/Linux/macOS);兼容多硬件(CPU、GPU、TPU);支持ONNX格式模型转换,部署灵活。 | ONNX格式模型(需转换自PyTorch/TensorFlow) | 多环境部署(如云、边、端混合场景) | 兼容性好(跨平台稳定) |
二、关键框架详解与实战
1. vLLM:高并发生产环境的首选
- 核心技术:PagedAttention(分页管理KV缓存,避免内存碎片)、动态批处理(合并多请求提升GPU利用率)。
- 部署实战(文本示例): 安装: pip install vllm 启动API服务:
python -m vllm.entrypoints.api_server \
    --model meta-llama/Llama-3-8B-Instruct \
    --tensor-parallel-size 2 \  # 2卡张量并行
    --gpu-memory-utilization 0.9 \  # 显存利用率90%
    --max-num-seqs 256 \  # 最大并发序列数
    --served-model-name llama-3-8b
Bash
客户端调用(OpenAI兼容接口):
import openai
client = openai.OpenAI(base_url=" http://localhost:8000/v1 ", api_key="token-abc123")
response = client.chat.completions.create(model="llama-3-8b", messages=[{"role": "user", "content": "你好"}])
Python
2. TensorRT-LLM:实时推理的极致优化
- 核心优势:NVIDIA针对自家GPU(如A100、H100)的深度优化,支持INT4/INT8量化,利用Tensor Core加速矩阵运算,延迟可低至毫秒级。
- 适用场景:对延迟敏感的场景(如实时翻译、自动驾驶对话系统)。
3. llama.cpp:边缘设备的轻量之选
- 核心优势:纯C++实现,无依赖,支持CPU/GPU混合计算;GGUF格式模型(量化后体积小,如7B模型INT4仅3.5GB),适合内存/显存有限的设备。
- 适用场景:手机、树莓派、Jetson等边缘设备,或需要本地离线推理的场景。
4. TGI:聊天应用的流式输出专家
- 核心优势:持续批处理(动态合并新请求到当前批次,减少等待时间)、流式输出(逐token返回结果,提升交互体验)。
- 适用场景:在线聊天机器人、AI助手等需要实时交互的应用。
5. ONNX Runtime:跨平台部署的通用方案
- 核心优势:支持将PyTorch/TensorFlow模型转换为ONNX格式,兼容CPU、GPU、TPU等多硬件,适合需要跨平台(如Windows+Linux)或混合硬件环境的部署。
- 适用场景:企业级多环境部署(如云服务器+本地PC+边缘设备)。
三、选型建议
- 高并发生产环境:选vLLM(吞吐最优,适合API服务)。
- 实时低延迟需求:选TensorRT-LLM(NVIDIA GPU优化,延迟最低)。
- 边缘设备/低资源场景:选llama.cpp(轻量、CPU/GPU混合支持)。
- 聊天/流式输出应用:选TGI(持续批处理+流式输出优化)。
- 跨平台/多硬件部署:选ONNX Runtime(兼容性强,部署灵活)。
8.2 高性能推理机制
大模型推理的高性能机制主要围绕内存管理优化、批处理策略、计算加速和量化压缩四大方向,通过技术创新显著提升吞吐量、降低延迟并减少资源占用。以下是核心机制的详细解析:
一、PagedAttention技术:高效管理KV缓存
核心背景
Transformer模型推理时,注意力机制需缓存历史token的Key(K)和Value(V)向量(即KV缓存),以支持长序列生成。传统KV缓存管理采用连续内存分配,易导致内存碎片(如不同长度的请求释放后留下无法复用的“空洞”),显存利用率低(仅30%-40%),限制并发请求数。
技术原理
PagedAttention借鉴操作系统“虚拟内存分页”思想,将KV缓存划分为固定大小的块(如16KB/块),通过**块表(Block Table)**管理物理块与逻辑缓存的映射关系,实现动态、高效的KV缓存分配与回收。
- 分页管理:将KV缓存按固定块大小(如每个块存储16个token的K/V向量)划分,避免连续内存分配的限制。
- 按需分配:请求到达时,仅分配所需数量的块;请求结束或生成完成时,释放对应块,供其他请求复用。
- 块表映射:通过块表记录每个逻辑缓存位置对应的物理块地址,推理时通过块表快速查找K/V向量,无需连续内存。
优势
- 内存效率提升60%-70%:消除内存碎片,显存利用率从30%-40%提升至90%以上。
- 支持高并发:动态处理请求的动态到达与离开,允许更多请求同时驻留显存,显著提升吞吐量(如vLLM中并发请求数可达传统方法的2-3倍)。
- 长序列友好:支持超长序列(如32k/128k tokens)推理,避免因KV缓存膨胀导致的显存溢出。
应用框架
vLLM是PagedAttention的典型实现,其通过该技术使Llama-7B模型在A100 GPU上的吞吐量达到传统框架(如Hugging Face Transformers)的2-4倍。
二、连续批处理(Continuous Batching)优化
核心背景
传统批处理(Static Batching)需等待固定批次的请求全部到达后统一处理,导致新请求需等待批次填满,延迟高且GPU利用率低(尤其在小批次场景下)。
技术原理
连续批处理(又称动态批处理)允许新请求动态加入当前正在处理的批次,无需等待批次填满。具体实现包括:
- 动态合并:推理引擎维护一个“活跃批次”,新请求到达后立即加入,与当前批次的请求共同处理。
- 逐token生成:在生成每个token时检查是否有新请求加入,若有则扩展批次,避免等待整个序列生成完毕。
- 优先级调度:根据请求优先级(如付费用户)或延迟要求,动态调整批次中的请求顺序。
优势
- 降低延迟:新请求无需等待批次填满,首token响应时间(TTFT)缩短30%-50%。
- 提升GPU利用率:GPU始终处理接近最大容量的批次,避免空闲等待,吞吐量提升1.5-2倍。
- 适配流式输出:与流式生成(逐token返回)天然兼容,提升交互体验(如聊天应用中实时显示生成内容)。
应用框架
vLLM、TGI(Text Generation Inference)均支持连续批处理。例如,TGI通过该技术使Llama-13B模型的吞吐量较传统批处理提升2倍以上。
三、KV缓存量化
核心背景
KV缓存占推理显存的30%-50%(如7B模型生成1024token时,KV缓存约占用4-6GB FP16显存),量化可大幅压缩其内存占用,支持更长序列或更高并发。
技术原理
将KV缓存从高精度(如FP16)转换为低精度(如INT8/INT4),通过缩放因子(Scale)和零点(Zero Point)映射浮点值与整数值,平衡精度损失与压缩率。主要方法包括:
- INT8量化:将KV缓存的每个元素从FP16(2字节)压缩为INT8(1字节),内存占用减半。
- 分组量化(Group-wise Quantization):将KV缓存按组(如每组64个元素)独立量化,每组共享缩放因子,减少量化误差(精度损失<1%)。
- 动态量化:根据KV缓存的数值范围(如当前序列的K/V最大值)动态调整缩放因子,避免固定缩放导致的精度骤降。
优势
- 内存节省50%-75%:INT8量化使KV缓存显存占用减半,INT4量化可进一步压缩至1/4。
- 支持更长序列:相同显存下,INT8量化可使最大序列长度从2048扩展至4096(+100%)。
- 精度损失可控:通过分组量化或动态量化,Llama-7B模型在INT8 KV缓存下的生成质量(如困惑度)仅下降0.5%-1%。
实现示例
vLLM支持KV缓存INT8量化,通过配置 --kv-cache-dtype int8 启用,在A100 GPU上可使7B模型的并发请求数提升1倍。
四、其他辅助优化机制
1. 算子融合(Operator Fusion)
将多个连续的小算子(如LayerNorm+Linear、Softmax+MatMul)合并为一个大算子,减少GPU内核启动次数和内存读写开销。例如,FlashAttention通过融合Attention计算中的Q/K/V投影、Softmax和输出投影,使Attention计算速度提升2-4倍。
2. 混合精度推理(Mixed Precision Inference)
使用FP16/BF16进行计算(利用GPU Tensor Core加速),同时对关键层(如输出层)保留FP32精度,平衡速度与精度。例如,TensorRT-LLM通过混合精度使Llama-70B模型的推理延迟降低40%。
3. 计算与通信重叠
在多卡并行推理中,通过异步通信技术(如NCCL的 ncclCommInitRank )将数据通信(如All-Reduce)与计算(如前向传播)重叠,隐藏通信延迟。DeepSpeed-Inference通过该优化使多卡推理效率提升30%。
总结
高性能推理机制通过PagedAttention优化内存、连续批处理提升吞吐、KV缓存量化压缩显存,结合算子融合、混合精度等技术,显著提升了大模型推理的效率与资源利用率。实际应用中,需根据场景需求(如延迟优先/吞吐优先、硬件资源)选择组合策略(如vLLM+PagedAttention+连续批处理+INT8 KV量化),以实现最优性能。
8.3 监控体系构建
监控体系是保障大模型推理服务稳定性、性能与质量的核心支撑,需覆盖性能指标、资源指标、质量指标三大维度,并通过数据采集→存储→可视化→告警全流程工具链实现闭环管理。以下结合大模型推理的特点,详细说明监控体系的构建方法:
一、关键监控指标设计
1. 性能指标(直接影响用户体验)
| 指标 | 定义与计算方式 | 目标阈值(参考) | 说明 |
|---|---|---|---|
| QPS(每秒查询数) | 单位时间内成功处理的推理请求数(QPS = 总请求数 / 时间) | >100(良好),>500(优秀) | 反映服务吞吐能力,高并发场景下需重点关注(如电商大促、直播互动)。 |
| P99延迟 | 99%请求的响应时间(即99%的请求在X秒内完成,X为P99值) | <500ms(良好),<100ms(优秀) | 衡量尾延迟,避免少数慢请求拖垮整体体验(如对话系统中用户等待回复的耐心阈值)。 |
| 吞吐量(Tokens/秒) | 单位时间内生成的Token数量(吞吐量 = 总生成Token数 / 时间) | 依模型规模而定(如7B模型INT4量化后目标>1000 Tokens/秒) | 直接反映模型计算效率,与硬件算力、批处理策略强相关。 |
| 首Token延迟(TTFT) | 从接收请求到生成第一个Token的时间(TTFT = 首Token生成时间 - 请求接收时间) | <200ms(良好),<50ms(优秀) | 对聊天/实时交互场景至关重要(用户期望“即时响应”)。 |
2. 资源指标(保障服务可持续性)
| 指标 | 定义与计算方式 | 目标阈值(参考) | 说明 |
|---|---|---|---|
| GPU利用率 | GPU计算单元的使用率(GPU Utilization = 计算时间 / 总时间) | 70%-90%(避免过热或闲置) | 过低(<50%)可能批处理策略不合理或请求量不足;过高(>95%)可能导致排队延迟增加。 |
| 显存使用率 | GPU显存占用比例(显存使用率 = 已用显存 / 总显存) | <80%(预留缓冲防OOM) | 显存不足会触发OOM(Out Of Memory)错误,需结合量化(如INT4)、KV缓存优化(如PagedAttention)降低占用。 |
| CPU/内存使用率 | 服务器CPU核心使用率、系统内存占用比例 | CPU<80%,内存<85% | 数据预处理、模型加载、日志写入等操作可能占用CPU/内存,需避免成为瓶颈(如CPU过载导致请求排队)。 |
| 网络带宽利用率 | 服务器网络接口的收发带宽占比(带宽利用率 = 实际流量 / 总带宽) | <70%(避免丢包) | 高并发场景下,网络带宽不足会导致请求/响应传输延迟(如API服务与外部存储或数据库的通信)。 |
3. 质量指标(保障输出可靠性)
| 指标 | 定义与计算方式 | 目标阈值(参考) | 说明 |
|---|---|---|---|
| 错误率 | 失败请求占总请求的比例(错误率 = 失败请求数 / 总请求数) | <1% | 错误包括模型崩溃、超时、输出格式错误等,需区分“可重试错误”(如临时OOM)和“不可重试错误”(如模型加载失败)。 |
| 超时率 | 请求处理时间超过阈值的占比(超时率 = 超时请求数 / 总请求数) | <0.5% | 超时阈值根据业务需求设定(如对话场景设为5秒),超时可能由资源不足或模型计算慢导致。 |
| 输出质量 | 生成内容的准确性、相关性、合规性(通过人工抽检或自动评估指标如BLEU、ROUGE、困惑度) | 人工抽检合格率>95% | 需定期抽样检查输出是否符合业务要求(如客服场景避免错误回答、法律场景避免误导性内容)。 |
二、监控工具链搭建(Prometheus + Grafana 方案)
1. 数据采集层
(1)性能指标采集
- 自定义指标导出:通过 prometheus_client 库在服务代码中埋点,记录QPS、延迟、吞吐量等。 示例代码(见背景资料):
from prometheus_client import Counter, Histogram, Gauge


REQUEST_COUNTER = Counter('llm_requests_total', 'Total requests')
REQUEST_LATENCY = Histogram('llm_request_latency_seconds', 'Request latency')
TOKEN_THROUGHPUT = Gauge('llm_token_throughput', 'Tokens generated per second')


@REQUEST_LATENCY.time()  # 自动记录函数执行时间
def inference_handler(prompt):
    REQUEST_COUNTER.inc()  # 计数+1
    start_time = time.time()
    result = model.generate(prompt)  # 模型推理
    tokens = len(result.split())  # 假设按空格分词
    duration = time.time() - start_time
    TOKEN_THROUGHPUT.set(tokens / duration)  # 更新吞吐量
    return result
Python
- 框架内置指标:部分推理框架(如vLLM、TGI)已内置Prometheus指标端点(如 /metrics ),可直接抓取(如vLLM暴露 vllm_requests_total 、 vllm_request_latency_seconds 等指标)。
(2)资源指标采集
- GPU指标:通过 DCGM Exporter (NVIDIA Datacenter GPU Manager)采集GPU利用率、显存使用率、温度等,暴露端口 9835 。 安装命令: docker run -d --gpus all -p 9835:9835 nvidia/dcgm-exporter
- CPU/内存/网络指标:通过 Node Exporter 采集服务器基础资源,暴露端口 9100 。 安装命令: docker run -d -p 9100:9100 prom/node-exporter
(3)质量指标采集
- 错误率/超时率:通过日志解析或自定义埋点记录失败请求(如HTTP状态码非200、推理抛异常),转换为Prometheus指标。 示例:
ERROR_COUNTER = Counter('llm_errors_total', 'Total errors', ['error_type'])


try:
    result = inference_handler(prompt)
except Exception as e:
    ERROR_COUNTER.labels(error_type=type(e).__name__).inc()  # 按错误类型分类
    raise
- 输出质量:定期人工抽检或通过自动评估模型(如基于BERT的相似度模型)计算BLEU/ROUGE分数,手动录入监控系统(如Grafana注释或外部数据库)。
2. 数据存储与可视化层
- Prometheus:时序数据库,存储采集的指标数据(配置 prometheus.yml 定义抓取任务,见背景资料)。 关键配置:
scrape_configs:
  - job_name: 'llm_inference'
    static_configs:
      - targets: ['localhost:8000']  # 推理服务地址(暴露/metrics)
  - job_name: 'gpu_monitor'
    static_configs:
      - targets: ['localhost:9835']  # DCGM Exporter地址
  - job_name: 'node_monitor'
    static_configs:
      - targets: ['localhost:9100']  # Node Exporter地址
YAML
- Grafana:可视化工具,连接Prometheus数据源,构建仪表盘展示指标趋势。 推荐仪表盘面板:
- 实时QPS/P99延迟趋势图(折线图);
- GPU/显存使用率热力图(按卡展示);
- 错误率/超时率告警面板(红绿灯标识);
- 吞吐量对比图(不同模型/量化方案的效率对比)。
3. 告警层
- Alertmanager:Prometheus的告警管理组件,配置告警规则并发送通知(邮件、Slack、钉钉等)。 关键配置(见背景资料):
groups:
  - name: llm_alerts
    rules:
      - alert: HighP99Latency
        expr: histogram_quantile(0.99, rate(llm_request_latency_seconds_bucket[5m])) > 1
        for: 5m  # 持续5分钟超阈值触发
        labels: {severity: warning}
        annotations: {summary: "P99延迟超1秒", description: "当前P99延迟: {{ $value }}秒"}
      - alert: HighGPUMemoryUsage
        expr: gpu_memory_usage_bytes / gpu_memory_total_bytes > 0.9
        for: 2m
        labels: {severity: critical}
        annotations: {summary: "GPU显存使用率超90%", description: "GPU {{ $labels.instance }} 显存使用率: {{ $value | humanizePercentage }}"}
YAML
三、监控体系落地要点
- 指标分层与优先级:核心指标(如P99延迟、GPU利用率)需实时监控并设置高优先级告警;次要指标(如CPU使用率)可降低采集频率(如1分钟/次)。
- 动态阈值调整:根据业务周期(如白天高峰、夜间低谷)自动调整告警阈值(如使用Prometheus的 recording_rules 预计算动态基线)。
- 根因分析支持:监控数据需保留足够历史(如30天),结合日志(ELK栈)和追踪(Jaeger)定位问题根因(如某时间段延迟飙升是因某批请求序列过长导致KV缓存爆炸)。
- 自动化运维联动:告警触发后自动执行修复操作(如扩容实例、重启服务、切换备用模型),例如通过Kubernetes的HPA(Horizontal Pod Autoscaler)根据QPS自动扩缩容。
总结
大模型推理服务的监控体系需围绕性能、资源、质量三大维度设计指标,通过Prometheus+Grafana+Alertmanager构建“采集-存储-可视化-告警”闭环,并结合业务场景动态调整策略。其核心价值在于:提前发现瓶颈(如显存不足)、快速定位故障(如GPU过载)、保障输出质量(如错误率超标),最终实现大模型推理服务的高可用、高效率与高可靠性。
8.4 自动化运维实战
一、健康检查端点(Health Check Endpoint)
作用
为推理服务提供实时状态监测,便于负载均衡器、Kubernetes 探针、监控系统判断实例是否可用,并在出现异常时自动摘除或重启容器。
实现示例(FastAPI + PyTorch + psutil)
from fastapi import FastAPI, Response
import psutil
import torch
from datetime import datetime


app = FastAPI()


@app.get("/health")
async def health_check():
    """综合健康检查"""
    status = {
        "gpu_available": torch.cuda.is_available(),
        "gpu_memory_used": round(torch.cuda.memory_allocated() / 1e9, 2) if torch.cuda.is_available() else 0,
        "cpu_percent": psutil.cpu_percent(),
        "memory_percent": psutil.virtual_memory().percent,
        "disk_percent": psutil.disk_usage('/').percent,
        "timestamp": datetime.now().isoformat()
    }

    # 判断健康状态
    healthy = all([
        status["cpu_percent"] < 90,
        status["memory_percent"] < 90,
        status["disk_percent"] < 90
    ])

    return {
        "status": "healthy" if healthy else "unhealthy",
        "details": status
    }
Python
关键点
- GPU可用性: torch.cuda.is_available() 检测 GPU 驱动和 CUDA 是否正常。
- 显存占用: torch.cuda.memory_allocated() 获取当前已分配的显存,用于判断显存是否接近上限。
- CPU / 内存 / 磁盘:通过 psutil 获取系统资源使用率,防止过载。
- 健康判定逻辑:可根据业务需求调整阈值(如 GPU 显存使用率 < 85%)。
- 集成 Kubernetes:将此 endpoint 配置为 livenessProbe 和 readinessProbe ,实现自动重启和流量摘除。
二、滚动更新策略(Rolling Update Strategy)
在推理服务升级或模型热替换时,为保证业务不中断,可采用多种部署策略:
| 策略 | 原理 | 优点 | 适用场景 |
|---|---|---|---|
| 蓝绿部署 | 保持两套完整环境(Blue=旧版,Green=新版),验证通过后一次性切流量 | 切换快速、回滚简单 | 对可用性要求极高的场景,如金融、客服 |
| 金丝雀发布 | 先让小部分流量(如5%)进入新版,监控指标正常后逐步扩大比例 | 风险可控、可灰度验证 | 新模型上线、功能迭代测试 |
| A/B测试 | 同时运行两个版本,按用户或请求特征分流,收集效果数据对比 | 数据驱动决策 | 模型效果评估、算法优化 |
| 回滚机制 | 监控关键指标(P99延迟、错误率、显存使用),异常时自动切回旧版本 | 快速止损 | 自动化运维、无人值守场景 |
实施建议
- 流量控制:结合网关(如 Nginx、Istio、Kong)或推理框架的路由功能实现按比例分发。
- 监控联动:健康检查与 Prometheus + Alertmanager 联动,异常时触发自动回滚。
- 版本管理:模型文件和推理服务版本号绑定,支持快速切换和回退。
- 渐进式发布:例如金丝雀发布可分 5% → 20% → 50% → 100% 阶段推进,每阶段观察 5–10 分钟。
- 自动化脚本:使用 CI/CD 工具(如 ArgoCD、Jenkins、GitHub Actions)结合 Kubernetes 实现全自动滚动更新。
三、自动化运维实战流程(示例)
- CI阶段
- 模型量化/微调完成 → 打包镜像(含 /health 接口)
- 推送镜像到仓库(Docker Registry)
- CD阶段
- 使用 Kubernetes Deployment 部署新版本 Pod
- 配置 readinessProbe 指向 /health ,确保只有健康实例接收流量
- 采用金丝雀策略:先部署 1-2 个 Pod,观察指标(QPS、P99延迟、错误率)
- 指标正常 → 逐步扩大副本数,替换旧版本
- 若指标异常 → 自动回滚到上一版本镜像
- 运行时
- Prometheus 定时抓取 /metrics 和 /health 数据
- Grafana 可视化趋势,Alertmanager 配置告警(如 GPU 显存 > 90%、P99延迟 > 1s)
- 告警触发后,运维平台或自动化脚本执行回滚/扩容
- 日志与追踪
- 集成 ELK(Elasticsearch + Logstash + Kibana)收集推理日志
- 使用 Jaeger/OpenTelemetry 做请求链路追踪,定位慢请求根因
四、落地要点总结
- 健康检查要全面:不仅检测服务进程存活,还要覆盖 GPU/显存/CPU/内存/磁盘等资源状态。
- 滚动更新要灰度:避免一次性全量发布导致全局故障,金丝雀和蓝绿是较安全的方案。
- 监控告警要闭环:从采集 → 可视化 → 告警 → 自动修复形成完整链路。
- 回滚要快:版本切换与回滚过程需自动化,减少人工干预时间(目标 < 3 分钟)。
- 可观测性是核心:结合 metrics、logs、traces 三支柱,才能快速定位并解决线上问题。
✅ 结论
自动化运维实战的核心是通过健康检查保障实例可用性,并通过蓝绿/金丝雀等滚动更新策略实现安全发布,配合监控告警与快速回滚机制,形成从代码提交到生产运行的闭环自动化体系,确保大模型推理服务在高并发、高可用要求下稳定运行。
第九章:大模型典型应用案例
9.1 医疗智能问诊系统
医疗智能问诊系统是大模型+医疗专业知识深度融合的典型应用,核心是通过“数据-知识-模型-服务”的分层架构,实现症状分析、疾病初筛、检查建议、用药指导等核心功能,同时严格遵循医疗安全与合规要求。以下从架构设计、关键模块、实战要点、安全合规四方面展开说明:
一、系统架构设计(分层逻辑)
医疗智能问诊系统的架构需覆盖“数据输入-知识加工-模型推理-服务输出-应用落地”全流程,典型分层如下:
数据层 → 知识层 → 模型层 → 服务层 → 应用层
Plain Text
| 层级 | 核心组成与作用 |
|---|---|
| 数据层 | 电子病历(EMR)、医学文献(PubMed/CNKI)、药品数据库(CFDA批准目录)、临床指南(如《内科学》第9版) → 提供原始医疗数据支撑 |
| 知识层 | 疾病知识图谱(如“糖尿病→并发症→视网膜病变”关联)、诊疗指南库(如ADA糖尿病指南)、药物相互作用库(如“头孢+酒精→双硫仑反应”) → 将非结构化数据转化为结构化知识 |
| 模型层 | 医学微调大模型(如基于Llama-2微调的MedLLaMA)、RAG检索模块(向量数据库存储医学知识)、规则引擎(如“体温>38.5℃+咳嗽→建议查血常规”) → 实现“知识检索+模型推理”的混合决策 |
| 服务层 | 问诊对话服务(多轮交互)、诊断建议服务(疾病排序+概率)、用药推荐服务(禁忌证校验)、报告生成服务(结构化问诊小结) → 封装核心能力为可调用的API |
| 应用层 | Web问诊平台(医院官网)、移动APP(患者端)、医生工作站集成(辅助诊断) → 触达终端用户(患者/医生) |
二、关键模块实战要点
1. 数据准备:医疗数据的“质”与“安”
医疗数据的高质量是模型效果的基础,需重点解决脱敏、标准化、标注三大问题:
- 脱敏处理:去除患者姓名、身份证号、手机号等PII信息(用正则匹配+实体识别),避免隐私泄露;
- 术语标准化:统一疾病编码(ICD-10)、药品通用名(如“泰诺”→“对乙酰氨基酚”)、检查项目(如“CT平扫”→“计算机断层扫描平扫”);
- 标注质量:由主治及以上医生双盲标注(如“症状-疾病”关联),Kappa系数>0.85(表示标注一致性高);
- 数据增强:通过“同义词替换”(如“发烧”→“发热”)、“句式变换”(如“我咳嗽”→“咳嗽是我的主要症状”)、“回译增强”(中→英→中)扩充训练数据,缓解医疗数据稀缺问题。
2. RAG增强:解决大模型“幻觉”的核心方案
医疗场景对事实准确性要求极高(如药物剂量错误可能危及生命),需用RAG(检索增强生成)将模型输出“锚定”到权威医学知识:
- 向量数据库选型:选用ChromaDB(轻量)或Pinecone( scalable),存储医学知识的嵌入向量(用 text-embedding-ada-002 或医学专用模型如 BioBERT 生成);
- 检索策略:用**最大边际相关性(MMR)**替代普通相似度检索,平衡“相关性”与“多样性”(避免检索结果过于集中);
- 提示工程:构建“医学知识+患者信息”的增强提示,强制模型基于检索结果回答(示例见下文代码)。
3. 模型微调:让通用大模型“懂医学”
通用大模型(如Llama-2)缺乏医学专业能力,需通过领域微调注入医学知识:
- 微调数据:使用指令微调数据集(如 MedDialog (中英医疗对话)、 HealthCareMagic (患者提问-医生回答));
- 微调方法:采用QLoRA(4-bit量化+LoRA适配器),在单张RTX 4090上即可微调7B医学模型,显存占用从14GB降至3.5GB;
- 评估指标:除常规困惑度(Perplexity)外,需增加医学特异性指标(如“疾病分类准确率”“用药建议符合指南率”)。
三、核心功能实现示例(RAG诊断模块)
以下是医疗问诊系统中诊断建议模块的代码框架(基于FastAPI+RAG):
from fastapi import FastAPI
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings
from transformers import AutoModelForCausalLM, AutoTokenizer


app = FastAPI()


# 初始化医学RAG系统
class MedicalRAG:
    def __init__(self):
        # 1. 加载医学知识向量库(预先存入诊疗指南、药品说明书)
        self.vector_db = Chroma(
            persist_directory="./medical_knowledge",
            embedding_function=OpenAIEmbeddings(model="text-embedding-ada-002")
        )
        # 2. 加载医学微调大模型(如MedLLaMA-7B)
        self.tokenizer = AutoTokenizer.from_pretrained("medllama/MedLLaMA-7B")
        self.model = AutoModelForCausalLM.from_pretrained(
            "medllama/MedLLaMA-7B",
            device_map="auto",
            load_in_4bit=True  # 4-bit量化降低显存
        )

    def retrieve_knowledge(self, query: str) -> str:
        """检索相关医学知识"""
        docs = self.vector_db.similarity_search(query, k=5)  # 检索Top5相关知识
        return "\n".join([f"[来源:{doc.metadata['source']}] {doc.page_content}" for doc in docs])

    def generate_diagnosis(self, symptoms: str, history: str) -> str:
        """生成诊断建议"""
        # 1. 检索医学知识
        knowledge = self.retrieve_knowledge(f"症状:{symptoms};病史:{history}")
        # 2. 构建增强提示(强制模型基于知识回答)
        prompt = f"""你是资深内科医生,需基于以下医学知识和患者信息给出诊断建议:

【医学知识】
{knowledge}


【患者信息】
主诉:{symptoms}
既往史:{history}


【要求】
1. 列出可能的疾病(按可能性从高到低排序,标注概率);
2. 建议需做的检查项目(如血常规、CT);
3. 初步治疗建议(如“多喝水、休息”);
4. 就医建议(如“建议24小时内到呼吸科门诊就诊”);
5. 所有建议必须基于上述医学知识,不得编造。"""
        # 3. 模型生成响应
        inputs = self.tokenizer(prompt, return_tensors="pt").to("cuda")
        outputs = self.model.generate(**inputs, max_new_tokens=512, temperature=0.3)  # 低温度保证准确性
        return self.tokenizer.decode(outputs[0], skip_special_tokens=True)


# 实例化RAG系统
rag_system = MedicalRAG()


@app.post("/diagnose")
async def diagnose(symptoms: str, history: str = ""):
    """问诊诊断接口"""
    try:
        diagnosis = rag_system.generate_diagnosis(symptoms, history)
        return {"status": "success", "diagnosis": diagnosis}
    except Exception as e:
        return {"status": "error", "message": str(e)}
四、安全与合规:医疗场景的“生命线”
医疗AI的安全性与合规性直接决定系统能否落地,需重点落实以下措施:
- 免责声明:所有输出需明确标注“本建议仅供参考,不能替代专业医生诊断”;
- 风险分级:对高风险症状(如“胸痛+呼吸困难”“意识丧失”)自动触发紧急转人工(调用120或医院急诊接口);
- 审计日志:完整记录问诊过程(患者输入、模型输出、检索的知识来源),保存期限≥15年(符合《医疗质量管理办法》);
- 合规认证:需通过医疗软件二类认证(国家药监局NMPA认证),确保系统符合医疗设备的安全要求;
- 伦理审查:由医院伦理委员会审核模型训练数据的使用权限,避免数据滥用。
五、应用效果与挑战
- 应用效果:某三甲医院的试点数据显示,该系统可将门诊初筛效率提升40%(减少医生重复询问症状的时间),患者满意度达92%(因回答更专业、易懂);
- 现存挑战:
- 罕见病数据稀缺(模型对罕见病的诊断准确率低);
- 多模态数据处理能力不足(如无法分析医学影像(CT/MRI));
- 跨地域诊疗差异(如基层医院的诊疗条件与大医院不同,模型建议需适配)。
总结
医疗智能问诊系统的核心是**“专业知识+大模型能力+安全合规”的平衡:通过RAG解决大模型“幻觉”,通过微调注入医学能力,通过合规设计规避医疗风险。未来随着多模态模型**(如处理影像+文本)与联邦学习(跨医院数据共享而不泄露隐私)的发展,系统将更精准、更普惠。
9.2 企业知识问答平台
企业知识问答平台是大模型时代企业知识管理的核心工具,通过**“知识整合-智能检索-精准回答”闭环,解决企业内部知识分散、检索低效、新人培训成本高等痛点,实现“所问即所需”的高效知识服务。以下从架构设计、核心模块、关键技术、实战案例、优化策略**五方面系统解析。
一、系统架构设计(分层逻辑)
企业知识问答平台需覆盖“知识接入-加工-存储-检索-服务”全流程,典型分层架构如下:
接入层 → 知识层 → 模型层 → 服务层 → 应用层
Plain Text
| 层级 | 核心组成与作用 |
|---|---|
| 接入层 | 文档上传接口(支持PDF/Word/Excel/PPT)、API对接(如Confluence/Jira/CRM系统)、爬虫采集(公开行业知识) → 实现多源知识“进得来” |
| 知识层 | 文档解析器(OCR/格式转换)、文本分割器(按段落/语义切分)、向量数据库(FAISS/Chroma)、知识图谱(实体关系关联) → 实现非结构化知识“转得准” |
| 模型层 | 嵌入模型(sentence-transformers)、检索模型(BM25/向量相似度)、生成模型(LLM微调/RAG增强) → 实现知识“检得快、答得准” |
| 服务层 | 问答API(REST/gRPC)、权限管理服务、缓存服务、审计日志服务 → 封装核心能力为可调用的企业级服务 |
| 应用层 | 员工门户(Web端)、企业微信/钉钉插件、智能客服机器人、数据分析看板 → 触达终端用户(员工/管理者) |
二、核心模块实战要点
1. 知识库构建:从“杂乱文档”到“结构化知识”
知识库是平台的“大脑”,需解决多格式解析、语义分割、向量化存储三大关键问题。
(1)文档解析:打破格式壁垒
企业内部文档格式多样(PDF扫描件、Word表格、Excel报表),需针对性处理:
- PDF解析:
- 文本型PDF:用 PyPDF2 / pdfplumber 直接提取文字;
- 扫描件PDF:用 PaddleOCR / Tesseract 做OCR识别(需先去噪、校正倾斜);
- Office文档:用 python-docx (Word)、 openpyxl (Excel)、 python-pptx (PPT)提取文本与表格;
- 表格处理:Excel表格需保留行列结构(如“产品名称-规格-价格”),转为Markdown表格或JSON格式,避免语义割裂。
示例代码(PDF+OCR解析):
import pdfplumber
from paddleocr import PaddleOCR


def parse_pdf(file_path):
    text = ""
    with pdfplumber.open(file_path) as pdf:
        for page in pdf.pages:
            # 先尝试提取文本型PDF
            page_text = page.extract_text()
            if page_text.strip():
                text += page_text + "\n"
            else:
                # 扫描件:OCR识别
                ocr = PaddleOCR(use_angle_cls=True, lang="ch")
                result = ocr.ocr(file_path, cls=True)
                for line in result:
                    text += line[0] + "\n"  # 提取识别文本
    return text
(2)文本分割:平衡“语义完整性”与“检索效率”
文本分割直接影响检索效果:分块太小易丢失上下文,太大则检索精度下降。需根据文档类型动态调整:
- 通用文档(如制度文件):按“段落+标题”分割(每块200-500字),保留章节结构;
- 对话/FAQ:按“问答对”分割(如“Q:请假流程?A:…”),直接作为独立知识单元;
- 长文(如技术白皮书):用语义分割(如 TextSplitter 基于句子相似度合并,确保块内主题一致)。
示例(语义分割):
from langchain.text_splitter import SemanticChunker
from sentence_transformers import SentenceTransformer


# 加载语义模型(中文推荐paraphrase-multilingual-MiniLM-L12-v2)
embedder = SentenceTransformer("paraphrase-multilingual-MiniLM-L12-v2")
splitter = SemanticChunker(embedder, breakpoint_threshold=0.5)  # 相似度低于0.5则分割


text = "第一章 总则...第二章 组织架构...第三章 业务流程..."  # 长文输入
chunks = splitter.split_text(text)  # 输出语义连贯的文本块
(3)向量化与存储:让知识“可检索”
将文本块转为向量(嵌入)后存入向量数据库,支持高效相似度检索:
- 嵌入模型:中文场景推荐 text2vec-base-chinese (哈工大)、 m3e-base (阿里),英文推荐 all-MiniLM-L6-v2 ;
- 向量数据库:
- 轻量本地部署: FAISS (Facebook开源,适合中小规模知识库)、 Chroma (易上手,支持元数据过滤);
- 大规模分布式: Milvus (Zilliz开源,支持十亿级向量)、 Pinecone (云服务,免运维);
- 存储策略:向量库需关联原始文本、文档来源、更新时间等元数据(如“来源:HR手册2023版”“更新人:张三”),便于溯源与权限控制。
示例代码(FAISS向量库构建):
import faiss
import numpy as np
from sentence_transformers import SentenceTransformer


# 1. 加载嵌入模型
model = SentenceTransformer("text2vec-base-chinese")
# 2. 文本块转向量
chunks = ["企业知识库建设规范...", "请假流程说明...", "报销标准2023..."]
vectors = model.encode(chunks, normalize_embeddings=True)  # 归一化向量(余弦相似度等价欧氏距离)
# 3. 构建FAISS索引(FlatL2适合小规模,IVF适合大规模)
dimension = vectors.shape
index = faiss.IndexFlatL2(dimension)
index.add(np.array(vectors))
# 4. 保存索引与元数据
faiss.write_index(index, "knowledge.index")
np.save("chunks_metadata.npy", chunks)  # 存储文本块(实际需存更丰富的元数据)
Python
2. RAG增强:解决大模型“幻觉”的企业级方案
企业知识需100%准确(如制度条款、流程规范),直接用通用大模型回答易出现“幻觉”(编造不存在的规定)。RAG(检索增强生成)通过“先检索知识→再生成回答”,强制模型基于企业私有知识作答,是核心解决方案。
(1)RAG工作流程
用户提问 → 问题向量化 → 向量库检索Top-K相关知识 → 知识+问题构造Prompt → LLM生成回答 → 输出带溯源的答案
Plain Text
(2)关键优化:检索精度与生成可控性
- 检索策略:
- 混合检索:结合关键词检索(BM25)与向量检索,弥补单一检索的不足(如“请假3天”中,“3天”是关键词,向量检索可能忽略数字);
- 元数据过滤:按部门(“仅检索财务部文档”)、时间(“仅用2023年后更新的制度”)过滤知识,提升相关性;
- Prompt工程:构造“角色+知识+约束”的强引导Prompt,示例:
你是企业知识问答助手,需严格基于以下企业知识回答问题,不得编造。若知识中无相关信息,回答“暂未找到相关资料,请联系HR部门确认”。


【企业知识】
1. [来源:HR手册2023版] 请假流程:员工需提前3个工作日通过OA系统提交申请,部门负责人审批后抄送HR备案;病假需附医院证明。
2. [来源:财务制度2023版] 报销标准:差旅住宿一线城市限额500元/晚,二线城市300元/晚。


【用户问题】请假1天需要提前多久申请?
Plain Text
- 答案溯源:生成回答时强制引用知识来源(如“根据HR手册2023版规定…”),并在界面展示“知识来源卡片”,增强可信度。
3. 权限与安全:企业知识的“防火墙”
企业知识涉及商业机密(如战略规划、客户信息),需严格控制访问权限:
- 角色权限:按部门(如“财务部可见报销制度,技术部不可见”)、职级(“普通员工仅可见公开制度,管理层可见战略文档”)划分权限;
- 数据加密:传输层用HTTPS,存储层向量与文本均需AES-256加密,密钥由企业密钥管理系统(KMS)托管;
- 审计日志:记录所有操作(谁、何时、查询了什么知识、生成了什么回答),日志保存≥6个月,支持合规审计;
- 水印与脱敏:敏感回答(如薪资结构)自动添加用户ID水印,防止截图泄露;个人隐私信息(如员工手机号)在检索结果中脱敏(如“138****5678”)。
三、核心功能实现示例(FastAPI+RAG问答接口)
以下是企业知识问答平台的核心问答接口代码,集成文档解析、RAG检索、权限校验:
from fastapi import FastAPI, Depends, HTTPException
from pydantic import BaseModel
import faiss
import numpy as np
from sentence_transformers import SentenceTransformer
from typing import List, Optional


app = FastAPI()


# -------------------------- 初始化知识库与权限 --------------------------
# 加载向量库与元数据(实际应连接数据库)
index = faiss.read_index("knowledge.index")
chunks_metadata = np.load("chunks_metadata.npy", allow_pickle=True).tolist()
model = SentenceTransformer("text2vec-base-chinese")


# 权限配置(示例:部门-可见知识源映射)
PERMISSIONS = {
    "hr": ["HR手册", "考勤制度"],
    "finance": ["财务制度", "报销流程"],
    "tech": ["技术文档", "开发规范"]
}


# -------------------------- 数据模型与依赖 --------------------------
class QuestionRequest(BaseModel):
    question: str
    user_department: str  # 用户所属部门(用于权限校验)
    top_k: int = 3  # 检索Top-K知识


def check_permission(department: str, knowledge_source: str) -> bool:
    """校验用户是否有权限访问某知识源"""
    allowed_sources = PERMISSIONS.get(department, [])
    return any(source in knowledge_source for source in allowed_sources)


# -------------------------- 核心问答接口 --------------------------
@app.post("/qa")
async def enterprise_qa(request: QuestionRequest):
    # 1. 权限预校验(简化:实际需解析知识元数据中的来源)
    if request.user_department not in PERMISSIONS:
        raise HTTPException(status_code=403, detail="无权限访问知识库")

    # 2. 问题向量化
    query_vector = model.encode([request.question], normalize_embeddings=True)

    # 3. 向量检索Top-K知识(实际需结合元数据过滤)
    distances, indices = index.search(query_vector, request.top_k)
    retrieved_chunks = []
    for idx in indices[0]:
        chunk = chunks_metadata[idx]
        # 校验权限(假设chunk元数据含"source"字段)
        if "source" in chunk and check_permission(request.user_department, chunk["source"]):
            retrieved_chunks.append(chunk)

    if not retrieved_chunks:
        return {"answer": "暂未找到您有权限访问的相关资料,请联系管理员。"}

    # 4. 构造Prompt并生成回答(简化:实际调用LLM API)
    knowledge_str = "\n".join([f"[{c['source']}] {c['content']}" for c in retrieved_chunks])
    prompt = f"""你是企业知识问答助手,需基于以下知识回答,不得编造:
{knowledge_str}
用户问题:{request.question}
回答:"""

    # 调用LLM(示例:用本地模型或API)
    answer = "根据HR手册2023版规定:请假需提前3个工作日通过OA提交申请,部门负责人审批后抄送HR备案。(来源:HR手册2023版)"

    return {
        "answer": answer,
        "sources": [c["source"] for c in retrieved_chunks],  # 返回知识来源
        "retrieved_chunks": retrieved_chunks  # 调试用,实际生产环境隐藏
    }
四、实战案例:某制造企业知识问答平台落地
1. 需求背景
某制造企业有5000+员工,知识分散在Confluence(技术文档)、SharePoint(制度文件)、本地硬盘(老员工经验),新人培训周期长达3个月,跨部门咨询重复率达40%。
2. 落地效果
- 知识整合:接入2000+文档(PDF/Word/Excel),构建含50万+向量的知识库,覆盖制度、技术、流程3大类;
- 效率提升:员工知识检索时间从平均15分钟/次降至30秒/次,跨部门咨询量减少60%;
- 新人培训:新人通过问答平台自主学习,培训周期缩短至1个月,考核通过率从65%提升至90%;
- 权限管控:实现“部门-文档-人员”三级权限控制,敏感知识(如战略规划)零泄露。
五、优化策略:性能、体验、成本平衡
1. 性能优化
- 缓存高频问题:用Redis缓存Top 100高频问题的回答(缓存24小时),命中率达70%,降低LLM调用成本;
- 异步检索:复杂问题(如跨文档综合分析)异步处理,先返回“正在检索中”,完成后推送结果(WebSocket);
- 冷热分离:近3个月更新的知识常驻内存(FAISS RAM),历史冷知识存磁盘,检索速度提升3倍。
2. 体验优化
- 多轮对话:支持上下文记忆(如“上次问的请假流程,病假需要什么证明?”自动关联历史问题);
- 多模态问答:集成OCR识别图片中的文字(如截图中的制度条款)、语音转文字(支持语音提问);
- 个性化推荐:根据用户角色(如“新员工”)主动推送高频问题(如“入职体检流程”)。
3. 成本控制
- 模型轻量化:用7B参数模型(如Qwen-7B)替代13B+模型,推理成本降低50%;
- 向量库选型:中小规模用Chroma(开源免费),大规模用FAISS(本地部署无云服务费用);
- 按需扩容:用Kubernetes部署问答服务,QPS突增时自动扩容Pod,闲时缩容至最小实例数。
总结
企业知识问答平台的核心价值是**“让企业知识活起来”:通过多源整合打破知识孤岛,通过RAG确保回答准确,通过权限控制保障安全,最终成为员工的“智能知识伙伴”。落地时需聚焦业务痛点**(如检索低效、新人培训难),小步快跑迭代(先覆盖核心知识域,再扩展全场景),并结合企业现有技术栈(如现有文档管理系统)降低集成成本。未来随着多模态模型(图文问答)、自主Agent(自动整理知识)的发展,平台将从“被动问答”升级为“主动知识服务”,成为企业数字化转型的核心基础设施。
9.3 智能客服系统升级
智能客服系统升级:从“被动应答”到“主动服务”的大模型重构
一、传统智能客服的核心痛点
传统智能客服(基于规则引擎或小模型)在应对复杂业务场景时存在四大瓶颈,直接制约用户体验与企业效率:
| 痛点 | 具体表现 | 业务影响 |
|---|---|---|
| 响应速度慢 | 依赖关键词匹配+人工兜底,平均等待时间>30秒,高峰期排队超5分钟 | 用户流失率提升20%+,投诉率增加15% |
| 知识更新滞后 | 新产品/政策需手动更新规则库,同步延迟3-7天,导致“答非所问”(如旧活动规则被误用) | 误导用户决策,品牌信任度下降 |
| 多轮对话能力弱 | 仅支持单轮问答,无法理解上下文(如用户说“刚才说的那个优惠”,客服无法关联历史对话) | 复杂问题解决率仅65%,需转人工比例高达40% |
| 个性化不足 | 无用户画像能力,对所有用户回复模板化内容(如向新客/老客推送相同促销信息) | 营销转化率降低30%,用户粘性不足 |
二、大模型驱动的智能客服升级方案
基于大模型的语义理解、知识推理、多轮对话、个性化生成能力,可从“底层模型-知识增强-对话管理-系统集成”四层重构客服系统,实现“快响应、准解答、懂用户、自进化”。
(一)核心架构:大模型+知识增强+用户画像的三位一体
升级后的智能客服系统架构如下,核心是通过大模型串联“知识检索-意图理解-个性化生成-持续优化”全流程:
用户请求 → 接入层(多渠道统一接入) → 意图识别层(大模型语义理解) → 知识增强层(RAG+知识图谱) → 对话管理层(多轮上下文+业务逻辑) → 个性化生成层(用户画像驱动) → 响应输出 → 持续优化(反馈闭环)
Plain Text
(二)关键技术模块实战解析
1. 意图识别与动态路由:从“关键词匹配”到“语义理解”
传统客服依赖预设关键词(如“退款”“物流”),无法处理模糊表达(如“我买的东西还没到,想问问咋办”)。大模型通过语义向量匹配实现精准意图识别:
- 技术方案:
- 用 text2vec-base-chinese 将用户问题转为向量,与预定义的意图向量(如“物流查询”“退款申请”“产品故障”)计算余弦相似度,识别意图(准确率从传统的70%提升至92%);
- 结合少样本学习(Few-shot Learning),仅需5-10条标注数据即可新增意图(如“会员积分兑换”无需重新训练模型)。
- 代码示例(意图识别):
from sentence_transformers import SentenceTransformer, util


class IntentClassifier:
    def __init__(self):
        self.model = SentenceTransformer("text2vec-base-chinese")
        # 预定义意图向量(示例)
        self.intent_examples = {
            "物流查询": ["我的快递到哪了", "订单物流信息", "发货了吗"],
            "退款申请": ["我要退款", "退货怎么操作", "订单取消"],
            "产品故障": ["设备无法开机", "功能用不了", "质量问题"]
        }
        # 意图向量库
        self.intent_embeddings = {
            intent: self.model.encode(examples, normalize_embeddings=True)
            for intent, examples in self.intent_examples.items()
        }


    def classify(self, query):
        query_embedding = self.model.encode(query, normalize_embeddings=True)
        scores = {}
        for intent, embeds in self.intent_embeddings.items():
            # 计算与意图示例的最大相似度
            similarity = max(util.cos_sim(query_embedding, embed)[0] for embed in embeds)
            scores[intent] = similarity
        return max(scores, key=scores.get)  # 返回最高得分意图


classifier = IntentClassifier()
print(classifier.classify("我昨天买的衣服还没收到,能查下物流吗"))  # 输出:物流查询
Python
2. 知识增强:RAG+知识图谱解决“幻觉”与“知识滞后”
企业知识(如产品参数、售后政策)动态更新频繁,大模型直接生成易出现“幻觉”(编造不存在的规则)。通过RAG(检索增强生成)+知识图谱可实现“知识实时更新+答案精准溯源”:
- RAG流程: 用户问题 → 向量化检索企业知识库(FAISS/Chroma)→ Top-K相关知识片段 → 构造“知识+问题”Prompt → 大模型生成回答(强制基于检索结果)。
- 知识图谱补充: 对复杂业务关系(如“订单-物流-售后”关联),用知识图谱存储实体关系(如“订单A→物流单B→配送员C”),支持多跳查询(如用户问“我的订单为什么延迟?”,可关联物流单的“天气延误”节点)。
- 知识更新机制: 对接企业CRM/ERP系统,当产品信息更新时(如“某型号手机保修期延长至2年”),自动触发知识库向量重新生成,确保“分钟级同步”。
3. 多轮对话与上下文管理:从“单轮问答”到“场景化交互”
大模型通过会话历史压缩+关键信息提取,支持长上下文多轮对话,理解用户指代(如“刚才说的那个优惠”):
- 上下文管理策略:
- 滑动窗口:保留最近5轮对话(避免上下文过长导致模型遗忘);
- 关键信息提取:用大模型抽取对话中的实体(如订单号、产品型号)和状态(如“已进入退款流程”),存储为结构化上下文(如 {“order_id”: “12345”, “status”: “refund_pending”} );
- 指代消解:通过Prompt引导模型关联历史信息(示例Prompt:“用户历史对话中提到订单12345,当前问题:这个订单的退款到账了吗?”)。
4. 个性化服务:用户画像驱动的“千人千面”回复
基于用户历史行为(购买记录、咨询偏好、投诉记录)构建画像,大模型生成个性化回答:
- 用户画像维度:
- 基础属性:年龄、地域、会员等级;
- 行为数据:近3个月购买品类(如“母婴用品”“数码产品”)、咨询高频问题(如“物流时效”“售后政策”);
- 情感倾向:历史对话情绪(如“愤怒”“满意”),用于调整回复语气(如对愤怒用户优先安抚)。
- 个性化生成示例:
- 新客咨询产品:侧重“产品亮点+新人优惠”;
- 老客咨询售后:直接关联历史订单(“您去年购买的XX产品,本次可享免费延保”);
- 高价值用户:优先转人工客服(若问题复杂)。
5. 系统集成与多渠道适配
支持Web、APP、微信/钉钉、电话语音等多渠道接入,统一对话管理能力:
- 语音渠道适配:集成ASR(语音转文字,如Whisper)和TTS(文字转语音,如Azure TTS),支持“语音提问-语音回答”;
- 工单系统联动:复杂问题自动生成工单(含对话历史、用户信息),分配给对应业务部门,并跟踪处理进度反馈给用户;
- 人工无缝接管:当用户要求转人工或模型置信度低(如意图识别得分<0.6)时,自动转接人工客服,并同步对话上下文。
6. 持续优化:反馈闭环驱动能力提升
通过“用户反馈-模型迭代-知识更新”闭环,实现客服系统自进化:
- 反馈收集:用户对回答标记“有用/无用”,或人工客服修正模型错误回答;
- 模型微调:每月用反馈数据微调大模型(QLoRA 4-bit量化,单卡RTX 4090可完成7B模型微调),重点优化高频错误场景(如“退款流程”回答不准确);
- 知识库清洗:自动识别过时知识(如“已下架产品的售后政策”),触发人工审核删除。
三、关键性能指标提升(实战数据)
某电商平台落地大模型智能客服后,核心指标显著改善:
| 指标 | 传统客服(规则引擎) | 大模型客服(升级后) | 提升幅度 |
|---|---|---|---|
| 首次响应时间 | 45秒 | 3秒 | 93%↓ |
| 问题解决率 | 65% | 85% | 31%↑ |
| 用户满意度(CSAT) | 3.8/5 | 4.5/5 | 18%↑ |
| 人工转接率 | 40% | 12% | 70%↓ |
| 人力成本占比 | 100%(基准) | 40% | 60%↓ |
| 知识更新周期 | 7天 | 10分钟 | 99%↓ |
四、落地挑战与应对策略
| 挑战 | 应对策略 |
|---|---|
| 算力成本 | 用QLoRA 4-bit量化模型(7B模型显存占用从14GB降至3.5GB),单卡RTX 4090可部署;推理时启用FP16混合精度,吞吐量提升2倍。 |
| 数据安全与隐私 | 用户对话数据脱敏(如手机号替换为“138****5678”),向量数据库加密存储(AES-256),符合GDPR/《个人信息保护法》。 |
| 复杂业务规则适配 | 结合规则引擎(如“退款需满足7天无理由”),在Prompt中强制模型校验规则(“若用户订单已超过7天,回答‘不支持无理由退款,可联系人工客服协商’”)。 |
| 方言/口语化理解 | 微调数据中加入方言样本(如粤语“唔该查下快递”),或用Whisper ASR的多语言支持识别方言语音。 |
五、总结与展望
大模型驱动的智能客服升级,本质是通过语义理解突破规则限制、知识增强解决“幻觉”、个性化提升用户体验,实现从“成本中心”到“价值中心”的转变。未来可进一步结合多模态大模型(图文/视频客服)、自主Agent(自动发起主动服务,如“您的订单即将超时,是否需要催单?”),打造“预判需求-主动服务-闭环解决”的下一代智能客服体系,成为企业与用户之间的“超级连接器”。
9.4 代码智能助手案例
代码智能助手案例聚焦于利用大模型技术赋能开发者日常编码工作,通过“代码理解-智能生成-质量验证-知识沉淀”的全流程能力,解决“代码编写效率低、调试困难、文档缺失、规范不统一”等痛点,成为开发者的“AI结对编程伙伴”。以下从应用场景、技术架构、核心功能、实战案例、优化策略五方面展开解析。
一、核心应用场景
代码智能助手的价值贯穿软件开发全生命周期,典型场景包括:
| 场景 | 痛点 | 助手能力 |
|---|---|---|
| 代码补全 | 重复编写模板代码(如函数定义、循环结构),效率低 | 基于上下文预测后续代码(如输入 def calculate_ ,自动补全参数与逻辑) |
| 代码解释 | 阅读陌生代码(如 legacy 系统、开源项目)时理解成本高 | 解析代码逻辑,生成自然语言解释(功能、算法、复杂度) |
| 代码调试 | 定位bug(如空指针、逻辑错误)需反复打印日志,耗时久 | 分析错误堆栈,定位根因并建议修复方案(如“第5行数组越界,建议增加长度校验”) |
| 单元测试生成 | 编写测试用例繁琐,覆盖率不足(尤其是边界条件) | 根据代码逻辑自动生成测试用例(含正常/异常场景) |
| 文档生成 | 手写API文档耗时,易遗漏关键信息(如参数约束、返回值说明) | 从代码注释/结构中提取信息,生成标准化文档(如Markdown/OpenAPI) |
| 代码优化 | 代码冗余、性能瓶颈(如嵌套循环O(n²))难以发现 | 识别低效写法,建议优化方案(如“用字典替代列表查找,复杂度从O(n)降至O(1)”) |
二、技术架构设计
代码智能助手的技术架构需兼顾“代码理解深度”与“生成质量”,典型分层如下:
代码输入层 → 代码解析层 → 知识增强层 → 模型生成层 → 质量验证层 → 输出层
Plain Text
1. 代码输入层
支持多语言(Python/Java/JS/C++等)、多格式(代码片段、文件、项目目录)输入,兼容IDE插件(VS Code/JetBrains)、CLI工具、Web界面等交互方式。
2. 代码解析层
将非结构化代码转为结构化表示,为模型提供语义理解基础:
- 语法解析:用编译器前端工具(如Python的 ast 模块、Java的 JavaParser )生成抽象语法树(AST),提取函数、变量、控制流等结构;
- 语义分析:识别代码中的实体(如类名、函数名)、关系(如调用依赖、继承)和逻辑(如条件分支、循环);
- 多语言适配:针对不同语言设计解析器(如JavaScript用 @babel/parser ,C++用 clang AST ),统一输出标准化中间表示(IR)。
3. 知识增强层
解决大模型“代码知识滞后”与“企业私有规范缺失”问题:
- 代码知识库:存储开源代码库(如GitHub Top 10k项目)、API文档(如Python官方文档)、最佳实践(如《Effective Java》),通过向量数据库(FAISS/Chroma)实现语义检索;
- 企业代码规范:整合内部编码规范(如命名规则、注释要求)、历史代码风格(如团队惯用设计模式),通过RAG(检索增强生成)注入生成过程;
- 上下文管理:维护对话历史(如用户连续追问“这个函数如何优化”)和项目上下文(如当前文件的依赖库版本),确保生成代码与项目环境兼容。
4. 模型生成层
核心是大模型的“代码理解与生成”能力,分为两类:
- 通用代码模型:如CodeLlama(Meta)、StarCoder(BigCode)、CodeGeeX(智谱),支持多语言代码生成与解释;
- 领域微调模型:基于企业私有代码库微调通用模型(如用QLoRA 4-bit量化在单卡RTX 4090上微调7B模型),适配特定业务场景(如金融风控代码、医疗设备驱动代码)。
5. 质量验证层
确保生成代码的正确性、安全性、规范性:
- 语法检查:调用编译器(如 py_compile 、javac)验证语法正确性;
- 逻辑验证:运行单元测试或符号执行(如 pytest 、 JUnit ),检查是否满足功能需求;
- 安全扫描:集成静态分析工具(如SonarQube、CodeQL)检测漏洞(如SQL注入、XSS);
- 规范检查:用 flake8 (Python)、 ESLint (JS)验证是否符合PEP8、Airbnb等编码规范。
6. 输出层
支持多形式输出:代码补全(IDE内联提示)、解释文本(侧边栏注释)、修复建议(diff格式)、文档(Markdown/HTML),并与IDE深度集成(如一键替换选中代码、自动导入缺失依赖)。
三、核心功能实现示例
1. 代码补全(以Python为例)
基于上下文预测后续代码,核心是“代码向量化+大模型生成”:
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
import ast


class CodeCompleter:
    def __init__(self, model_name="codellama/CodeLlama-7b-hf"):
        self.tokenizer = AutoTokenizer.from_pretrained(model_name)
        self.model = AutoModelForCausalLM.from_pretrained(
            model_name,
            device_map="auto",
            load_in_4bit=True  # 4-bit量化降低显存占用
        )

    def complete_code(self, code_prefix, max_length=200):
        """根据前缀补全代码"""
        # 解析前缀代码,提取上下文(如函数名、参数类型)
        try:
            tree = ast.parse(code_prefix)
            context = self._extract_context(tree)  # 提取函数名、参数等信息
        except SyntaxError:
            context = {}

        # 构造Prompt(包含上下文提示)
        prompt = f"""You are an expert Python developer. Complete the following code snippet logically:\n\n{code_prefix}\n# Your completion here:\n"""

        # 模型生成补全代码
        inputs = self.tokenizer(prompt, return_tensors="pt").to("cuda")
        outputs = self.model.generate(
            **inputs,
            max_length=len(inputs.input_ids[0](@ref) + max_length,
            temperature=0.2,  # 低温度确保生成确定性代码
            pad_token_id=self.tokenizer.eos_token_id
        )

        # 提取补全部分(去除输入前缀)
        completion = self.tokenizer.decode(outputs[0], skip_special_tokens=True)
        return completion[len(code_prefix):].strip()


# 使用示例
completer = CodeCompleter()
prefix = "def calculate_fibonacci(n: int) -> int:\n    \"\"\"Calculate the nth Fibonacci number.\"\"\"\n    if n <= 0:\n        return 0\n    elif n == 1:\n        return 1\n    else:\n        # Your completion here:\n"
print(completer.complete_code(prefix))
# 输出示例:"return calculate_fibonacci(n-1) + calculate_fibonacci(n-2)"
2. 代码解释与调试
解析代码逻辑并生成自然语言解释,或定位bug根因:
class CodeExplainer:
    def __init__(self, model_name="meta-llama/Llama-3-8b-code"):
        self.tokenizer = AutoTokenizer.from_pretrained(model_name)
        self.model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")

    def explain_code(self, code_snippet, lang="python"):
        """解释代码功能与逻辑"""
        prompt = f"""As a senior {lang} developer, explain the following code in detail, including:\n1. Main functionality\n2. Key algorithms/logic\n3. Time complexity\n4. Potential optimizations\n\n```{lang}\n{code_snippet}\n```"""

        inputs = self.tokenizer(prompt, return_tensors="pt").to("cuda")
        outputs = self.model.generate(**inputs, max_new_tokens=500)
        return self.tokenizer.decode(outputs[0], skip_special_tokens=True)

    def debug_code(self, code_snippet, error_msg):
        """分析错误原因并建议修复"""
        prompt = f"""The following {lang} code produced an error: {error_msg}\nAnalyze the root cause and suggest a fix:\n\n```{lang}\n{code_snippet}\n```"""

        inputs = self.tokenizer(prompt, return_tensors="pt").to("cuda")
        outputs = self.model.generate(**inputs, max_new_tokens=300)
        return self.tokenizer.decode(outputs[0], skip_special_tokens=True)
3. 单元测试生成
根据代码逻辑自动生成测试用例(含正常/异常场景):
class TestGenerator:
    def __init__(self, model_name="bigcode/starcoderbase"):
        self.tokenizer = AutoTokenizer.from_pretrained(model_name)
        self.model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")

    def generate_tests(self, code_snippet, lang="python"):
        """生成单元测试用例"""
        prompt = f"""Generate comprehensive unit tests for the following {lang} function, covering normal cases, edge cases, and exception handling. Use pytest framework.\n\nFunction code:\n```{lang}\n{code_snippet}\n```\n\nTest code:\n"""

        inputs = self.tokenizer(prompt, return_tensors="pt").to("cuda")
        outputs = self.model.generate(**inputs, max_new_tokens=400)
        return self.tokenizer.decode(outputs[0], skip_special_tokens=True)
四、实战案例:某互联网公司代码智能助手落地
1. 需求背景
某互联网公司有1000+开发者,面临三大痛点:
- 新人熟悉项目代码平均需2周,老员工重复编写模板代码占比30%;
- 代码缺陷率(线上bug)达5%,调试耗时占开发周期的25%;
- 单元测试覆盖率仅40%,文档缺失导致跨团队协作效率低。
2. 落地方案
- 模型选型:基于CodeLlama-7b微调(QLoRA 4-bit量化,单卡RTX 4090训练),融入公司内部代码规范(如“所有API必须加类型注解”)和历史代码风格;
- 功能集成:开发VS Code插件,支持代码补全、解释、测试生成、文档生成四大核心功能;
- 质量验证:集成SonarQube(安全扫描)、pytest(逻辑验证)、flake8(规范检查),生成代码需通过所有检查方可采纳。
3. 落地效果
- 效率提升:代码编写效率提升40%(模板代码自动补全),新人熟悉项目时间缩短至3天;
- 质量改善:代码缺陷率降至1.2%,单元测试覆盖率提升至75%,调试耗时减少60%;
- 协作优化:API文档自动生成率100%,跨团队协作沟通成本降低50%。
五、优化策略:性能、安全与体验平衡
1. 性能优化
- 模型轻量化:用4-bit/8-bit量化(如QLoRA、GPTQ)降低显存占用(7B模型从14GB→3.5GB),支持消费级GPU部署;
- 缓存高频场景:用Redis缓存高频补全模式(如“for循环遍历列表”),命中率达60%,降低模型调用延迟;
- 增量解析:仅解析用户修改的代码文件,避免全项目重复解析(如IDE插件监听文件变更事件)。
2. 安全与合规
- 代码隐私保护:用户输入代码仅在本地处理(如IDE插件离线模式),不上传至第三方服务器;
- 漏洞拦截:集成CodeQL检测生成代码中的高危漏洞(如硬编码密钥、SQL注入),拦截率100%;
- 版权合规:避免使用未授权开源代码训练模型(如StarCoder训练数据来自 permissive license 项目)。
3. 体验优化
- 多轮对话:支持上下文记忆(如用户追问“这个函数的时间复杂度能优化吗?”,自动关联历史代码);
- 个性化配置:允许用户自定义补全风格(如“优先使用列表推导式”“禁用某些第三方库”);
- 错误反馈闭环:用户标记“生成代码有误”后,自动收集反馈数据,每周微调模型优化薄弱场景。
总结
代码智能助手的本质是**“大模型+代码领域知识”的深度融合**,通过代码解析、知识增强、质量验证三大核心能力,将开发者从重复劳动中解放,聚焦高价值创新。未来随着多模态大模型(如图文代码生成)、自主Agent(自动修复bug并提交PR)的发展,代码智能助手将从“辅助工具”升级为“开发伙伴”,推动软件开发进入“人机协同”新时代。
总结与展望
大模型技术正在从实验室走向产业应用,本地化部署、高效微调、智能量化成为企业落地的关键技术路径。本指南系统性地梳理了从基础设施搭建到应用场景落地的完整技术栈,为不同规模的组织提供了可操作的实施方案。
未来发展趋势包括:
- 多模态融合:文本、图像、语音的统一理解与生成
- 边缘智能:轻量化模型在终端设备的广泛部署
- 自主进化:模型在运行中持续学习和优化
- 可信AI:可解释性、公平性、安全性的全面提升
随着技术的不断成熟和生态的完善,大模型将成为企业数字化转型的核心引擎,推动各行各业向智能化深度演进。
更多推荐

 12
 0
- 0


 已为社区贡献12条内容

所有评论(0)