
机器学习(7)
·
决策树的核心思想和原理
- 内部节点:特征属性 叶子节点:决策结果
- 监督学习算法,分类,回归均可
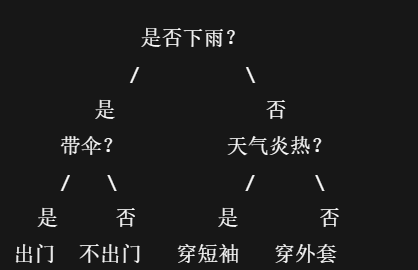
决策树在每一个节点上是怎么被构建出来的?
特征选择、节点分裂(使用二叉树还是多叉树)、阈值确定
决策树的本质:梯度下降的路径
信息熵
熵:分布的混乱程度或分布程度
信息熵:
联合熵:两个随机变量放在一起,有多不确定?
条件熵:在已知一个变量后,另一个变量还剩多少不确定性?
关系:
信息增益:一个特征能给分类系统带来多少信息
相对熵 = 交叉熵-信息熵
决策树分类
数据准备
from sklearn import datasets

iris = datasets.load_iris()
x = iris.data[:,1:3]
y = iris.target

plt.scatter(x[:,0],x[:,1],c=y)
plt.show()
决策树分类
from sklearn.tree import DecisionTreeClassifier
clf = DecisionTreeClassifier(max_depth=2,criterion='entropy')
clf.fit(x,y)
def decision_boundary_plot(X,y,clf):
    # 确定画图范围:向外扩 1 个单位,避免边界贴边
    axis_x1_min, axis_x1_max = X[:, 0].min() - 1, X[:, 0].max() + 1
    axis_x2_min, axis_x2_max = X[:, 1].min() - 1, X[:, 1].max() + 1
    # 构造二维网格点(关键)
    x1, x2 = np.meshgrid(
        np.arange(axis_x1_min, axis_x1_max, 0.01),
        np.arange(axis_x2_min, axis_x2_max, 0.01),
    )
    # 对每个网格点做预测,得到 整片平面的分类结果
    z = clf.predict(np.c_[x1.ravel(), x2.ravel()])
    # 预测结果变回网格形状,每个网格点都有一个类别
    z = z.reshape(x1.shape)

    from matplotlib.colors import ListedColormap
    # 自定义颜色
    custom_cmap = ListedColormap(['#F5B9EF','#BBFFBB','#F9F9CB'])
    # 画决策区域 / 决策边界,不同颜色交界处 = 决策边界
    plt.contourf(x1,x2,z,cmap=custom_cmap)
    plt.scatter(X[:,0],X[:,1],c=y)

decision_boundary_plot(x,y,clf)
from sklearn.tree import plot_tree
plot_tree(clf)
最优化分条件
from collections import Counter
Counter(y)

def calc_entropy(y):
    counter = Counter(y)
    sum_ent = 0
    for i in counter:
        p=counter[i]/len(y)
        sum_ent +=-(p*np.log2(p))
    return sum_ent

calc_entropy(y)
def split_dataset(x,y,dim,value):
    index_left = (x[:,dim]<=value)
    index_right = (x[:,dim]>value)
    return x[index_left],y[index_left],x[index_right],y[index_right]

def find_best_split(x,y):
    best_dim = -1
    best_value = -1
    best_entropy = np.inf
    best_entropy_left,best_entropy_right = -1,-1
    for dim in range(x.shape[1]):
        sorted_index = np.argsort(x[:,dim])
        for i in range(x.shape[0]-1):
            value_left,value_right = x[sorted_index[i],dim],x[sorted_index[i+1],dim]
            if value_left!=value_right:
                value = (value_left+value_right)/2
                x_left,y_left,x_right,y_right = split_dataset(x,y,dim,value)
                entropy_left,entropy_right = calc_entropy(y_left),calc_entropy(y_right)
                entropy = (len(x_left)*entropy_left +len(x_right)*entropy_right)/x.shape[0]
                if entropy < best_entropy:
                    best_dim = dim
                    best_value = value
                    best_entropy = entropy
                    best_entropy_left,best_entropy_right = entropy_left,entropy_right
    return best_dim,best_value,best_entropy,best_entropy_left,best_entropy_right

find_best_split(x,y)
x_left,y_left,x_right,y_right = split_dataset(x,y,1,2.45)
find_best_split(x_right,y_right)
基尼系数
基尼系数 = 从节点里随机抽两个样本,它们类别不一样的概率
基尼系数和信息熵:
- 基尼系数运算稍快
- 物理意义稍有不同
- 模型效果上差异不大
| 对比点 | 熵(Entropy) | 基尼系数(Gini) |
|---|---|---|
| 数学形式 | 有对数 | 无对数 |
| 计算复杂度 | 较高 | 较低 |
| 曲线形状 | 更“陡” | 更“平” |
| 对纯节点敏感性 | 高 | 稍低 |
| 常见算法 | ID3 / C4.5 |
CART |
## 修改决策树分类中的代码
## 将entropy改为gini
from sklearn.tree import DecisionTreeClassifier
clf = DecisionTreeClassifier(max_depth=2,criterion='gini')
clf.fit(x,y)

def calc_gini(y):
    counter = Counter(y)
    sum_gini = 1
    for i in counter:
        p=counter[i]/len(y)
        sum_gini -= (p**2)
    return sum_gini

def find_best_split(x,y):
    best_dim = -1
    best_value = -1
    best_gini = np.inf
    best_gini_left,best_gini_right = -1,-1
    for dim in range(x.shape[1]):
        sorted_index = np.argsort(x[:,dim])
        for i in range(x.shape[0]-1):
            value_left,value_right = x[sorted_index[i],dim],x[sorted_index[i+1],dim]
            if value_left!=value_right:
                value = (value_left+value_right)/2
                x_left,y_left,x_right,y_right = split_dataset(x,y,dim,value)
                gini_left,gini_right = calc_gini(y_left),calc_gini(y_right)
                gini = (len(x_left)*gini_left +len(x_right)*gini_right)/x.shape[0]
                if gini < best_gini:
                    best_dim = dim
                    best_value = value
                    best_gini = gini
                    best_gini_left,best_gini_right = gini_left,gini_right
    return best_dim,best_value,best_gini,best_gini_left,best_gini_right
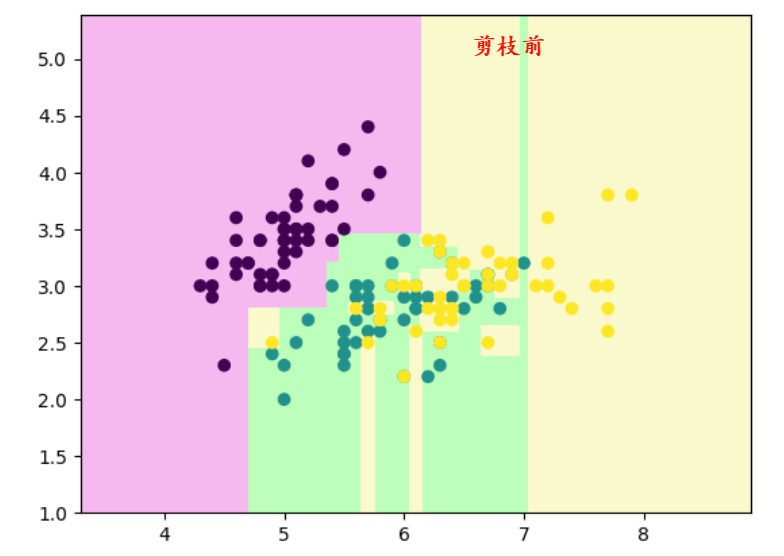
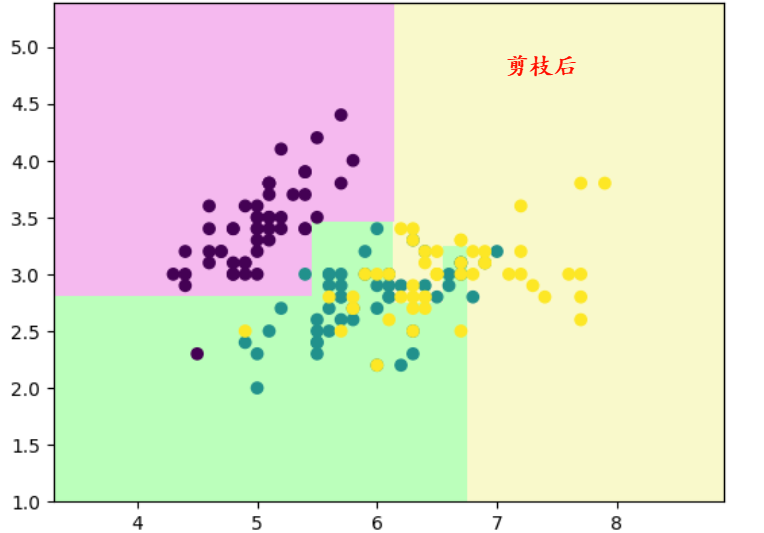
决策树剪枝
为什么要进行剪枝:
- 复杂度过高
- 预测复杂度:
- 训练复杂度:
- 预测复杂度:
- 容易过拟合
- 非参数学习
- 如何进行剪枝
目标:
- 降低复杂度
- 解决过拟合
手段:
- 限制深度(结点层数)
- 限制广度(叶子结点个数)
数据准备
from sklearn import datasets

iris = datasets.load_iris()
x = iris.data[:,0:2]
y = iris.target

plt.scatter(x[:,0],x[:,1],c=y)
plt.show()
代码实现
# max_depth:最大深度
# min_samples_split:最小样本划分,样本数低于这个节点就不再划分(看节点的samples值)
# min_samples_leaf:最小的节点样本数(最小的叶子节点数不能低于5个),如果低于5个就合并
# max_leaf_nodes:最大叶子节点
# min_weight_fraction_leaf:叶子节点所需的最小的加权分数,叶子节点的样本最小权重
clf = DecisionTreeClassifier(min_weight_fraction_leaf=0.03)
clf.fit(x,y)
# 调用决策树分类中的decision_boundary_plot方法
decision_boundary_plot(x,y,clf)
plot_tree(clf)
决策树回归
- 相似的输入必会产生相似的输出
- 取节点平均值
数据准备
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
import pandas as pd

boston = (pd.read_csv("./BostonHousing.csv")).to_numpy()
x = boston[:,:-1]
y = boston[:,-1]
x_train,x_test,y_train,y_test = train_test_split(x,y,random_state=233)
决策树回归
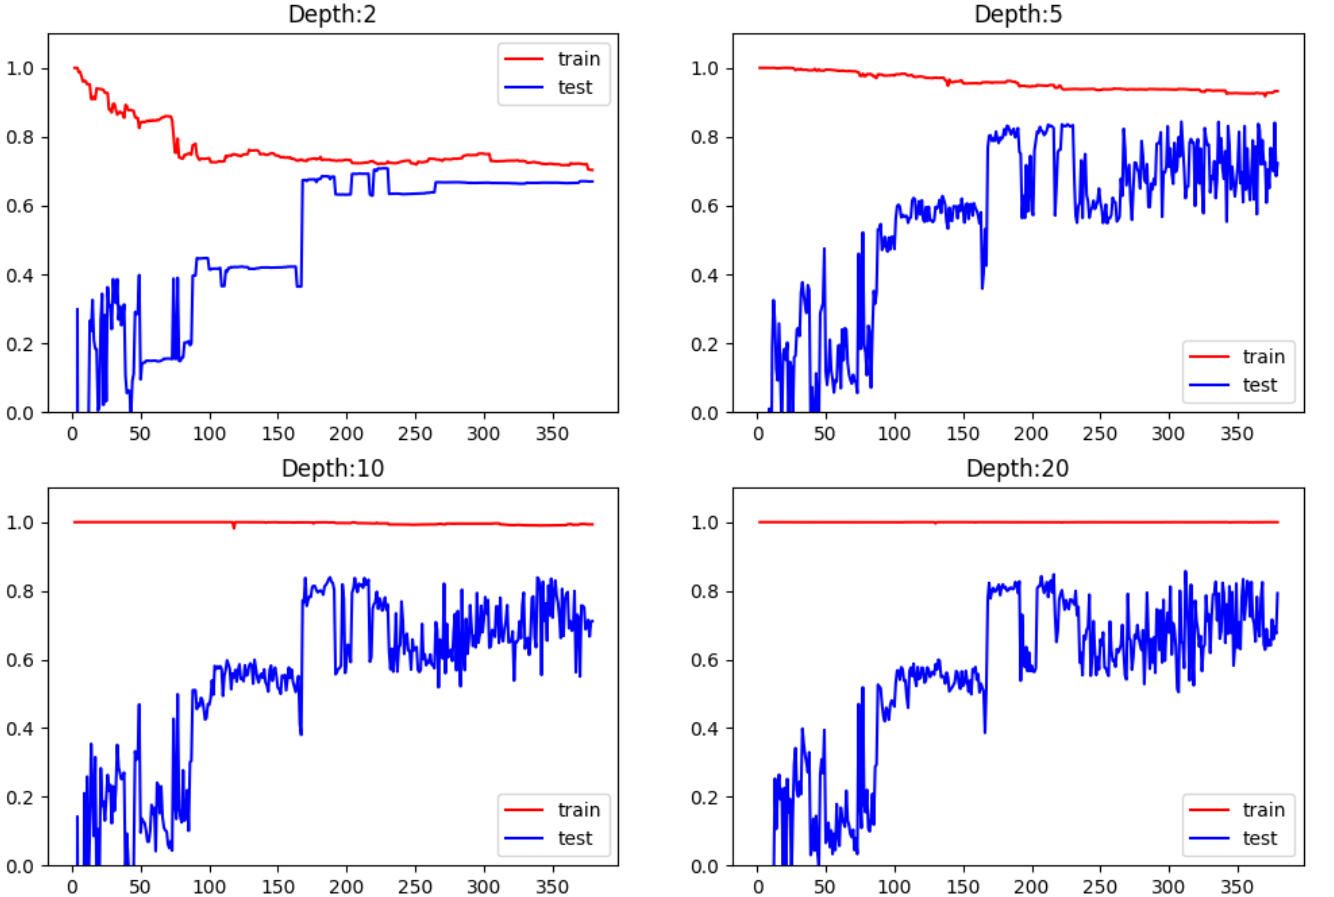
# 绘制学习曲线
from sklearn.metrics import r2_score

plt.rcParams["figure.figsize"]=(12,8)
max_depth = [2,5,10,20]

for i,depth in enumerate(max_depth):

    reg = DecisionTreeRegressor(max_depth=depth)
    train_error,test_error=[],[]
    for k in range(len(x_train)):
        reg.fit(x_train[:k+1],y_train[:k+1])
        y_train_pred = reg.predict(x_train[:k+1])
        train_error.append(r2_score(y_train[:k+1],y_train_pred))

        y_test_pred = reg.predict(x_test)
        test_error.append(r2_score(y_test,y_test_pred))

    plt.subplot(2,2,i+1)
    plt.ylim(0,1.1)
    plt.title("Depth:{0}".format(depth))
    plt.plot([k+1 for k in range(len(x_train))],train_error,color='red',label='train')
    plt.plot([k+1 for k in range(len(x_train))],test_error,color='blue',label='test')
    plt.legend()

plt.show()

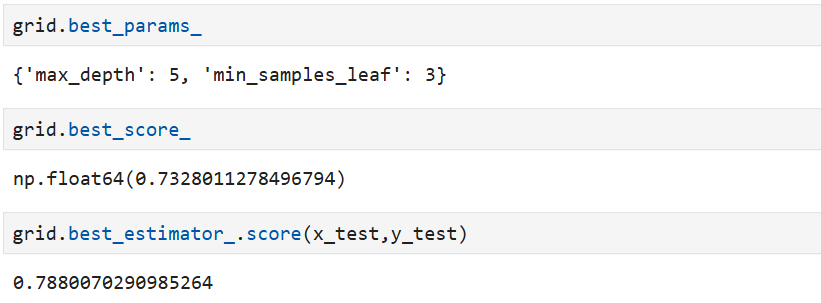
# 网格搜索
from sklearn.model_selection import GridSearchCV

params = {
    'max_depth':[n for n in range(2,15)],
    'min_samples_leaf':[sn for sn in range(3,20)]
}

grid = GridSearchCV(
    estimator=DecisionTreeRegressor(),
    param_grid=params,
    n_jobs=-1
)
grid.fit(x_train,y_train)
决策树的优缺点和适用条件
优点:
- 符合人类直观思维
- 可解释性强
- 能够处理数值型数据和分类型数据
- 能够处理多输入问题
缺点:
- 容易产生过拟合
- 决策边界只能是水平或竖直方向
- 不稳定,数据的微小变化可能生成完全不同的树
更多推荐

 17
 0
- 0


 已为社区贡献20条内容

所有评论(0)