
深度学习之PyTorch(下)损失函数、参数更新方法、附经典案例在PyTorch中的应用
·
一、损失函数
1、分类任务损失函数
1.1、二分类任务损失函数
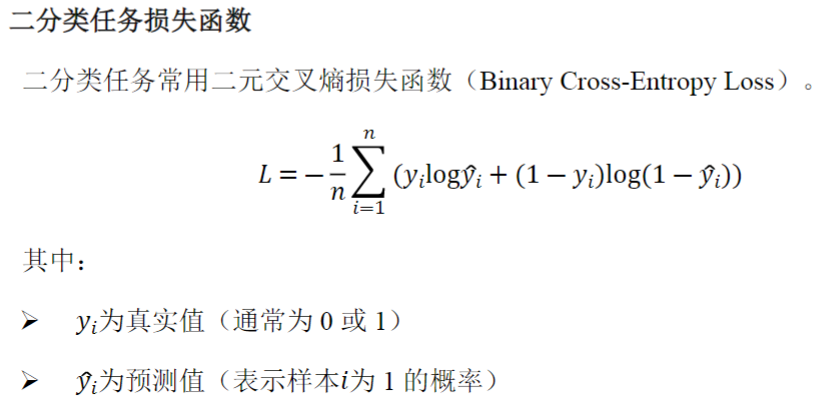
import torch
import torch.nn as nn

input = torch.randn(3,2)
print(input)
target = torch.tensor([
    [1,0],
    [0,1],
    [0.3,0.7],
])
y_pred = torch.sigmoid(input)
loss = nn.BCELoss()
loss_value = loss(y_pred, target)
print(loss_value)

tensor([[-1.0834,  0.6818],
        [-1.8503, -1.1181],
        [ 0.2840,  1.8961]])
tensor(0.9136)
1.2、多分类任务损失函数
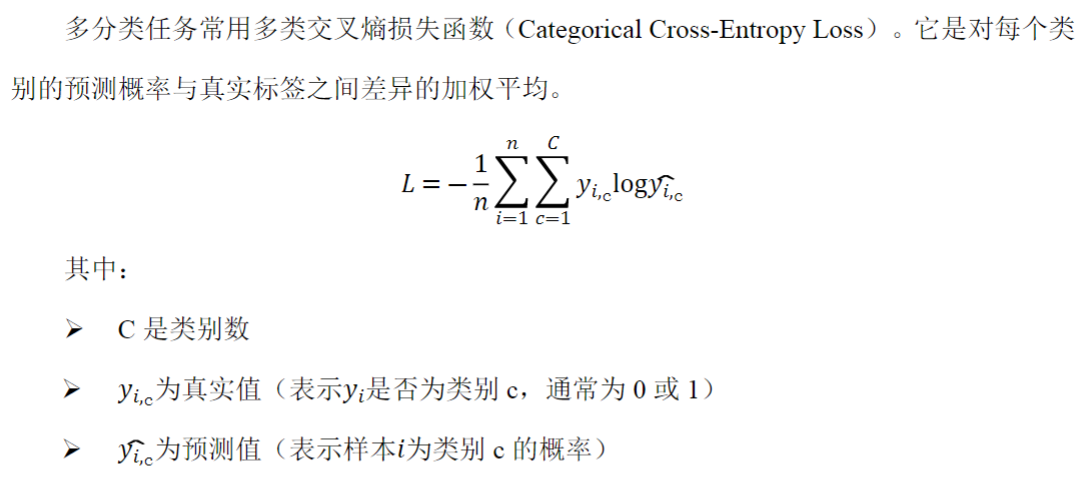
调用 torch.nn.CrossEntropyLoss 相当于调用了 torch.nn.LogSoftmax 之后再调用
torch.nn.NLLLoss。即使用 CrossEntropyLoss 时上一层的输出不需要 Softmax 激活函数,因为该
损失函数内会自动处理。
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import torch.nn as nn

input = torch.randn(6,8)
print(input)
target = torch.randint(0,8,(6,))
print(target)
loss = nn.CrossEntropyLoss()
loss_value = loss(input, target)
print(loss_value)

tensor([[-1.2928e+00, -1.5292e+00,  2.2292e-01,  5.7030e-01, -5.6122e-01,
         -6.6292e-01, -2.7012e-01, -7.0373e-01],
        [-3.3748e-02, -6.2801e-01, -2.3060e-01, -3.4853e-04, -3.2203e-01,
         -3.4081e-01,  2.0129e+00,  9.5193e-01],
        [ 8.7324e-01,  7.9247e-01,  1.8452e+00, -9.3519e-01,  5.0346e-01,
         -8.0731e-01, -1.0711e+00,  5.9961e-02],
        [ 1.2703e+00, -9.1585e-01,  7.1065e-01, -5.2294e-01, -4.6369e-01,
          6.8445e-01,  2.3985e-01, -2.2850e+00],
        [ 6.1638e-01,  4.7640e-01, -2.8723e-01,  7.1540e-01, -9.0803e-01,
         -1.7809e+00, -6.7771e-02, -3.6200e-01],
        [-3.6680e-01,  1.6236e-01, -2.4741e-01, -5.2993e-01, -3.0050e-02,
         -8.3966e-01, -1.0472e-01,  1.5665e-03]])
tensor([7, 7, 4, 2, 4, 7])
tensor(2.1625)
2、回归任务损失函数MAEL1,MSEL2,SmoothL1平滑L1
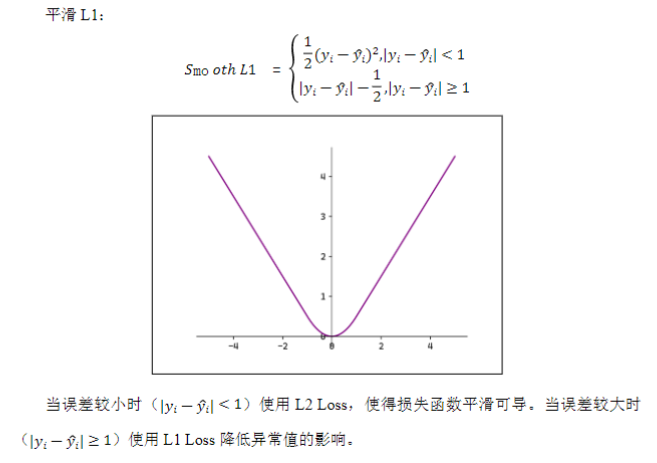
import torch
from torch.nn import MSELoss,L1Loss,SmoothL1Loss

input = torch.randn(3,5)
target = torch.randn(3,5)
print(input)
print(target)
mae_loss = L1Loss()
mae = mae_loss(input,target)
print(mae)
mse_loss = MSELoss()
mse = mse_loss(input,target)
print(mse)
sml1 = SmoothL1Loss()
sml1_loss = sml1(input,target)
print(sml1_loss)

tensor([[-0.9700,  0.1623,  1.1262, -1.2611, -1.0052],
        [-0.0985, -2.0033,  0.9617, -0.5301, -0.5155],
        [-0.0496, -1.9691,  1.3506, -1.6605, -1.0312]])
tensor([[-0.3123,  1.2515,  0.0369,  1.6495, -0.3261],
        [ 0.6243,  0.7736,  0.6756,  0.9600, -0.2522],
        [ 0.0111,  1.5231,  1.0979,  0.3515,  1.4080]])
tensor(1.3481)
tensor(2.9736)
tensor(0.9411)
3、损失函数综合练习
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
from torch import nn, optim

class Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.linear1 = nn.Linear(5,3)
        self.linear1.weight.data = torch.tensor([
            [0.1,0.2,0.3],
            [0.4,0.5,0.6],
            [0.7,0.8,0.9],
            [1.0,1.1,1.2],
            [1.3,1.4,1.5],
        ]).T
        self.linear1.bias.data = torch.tensor([1.0,2.0,3.0])

    def forward(self, x):
        y = self.linear1(x)
        return y

x = torch.tensor([[1,2,3,4,5],[6,7,8,9,10]],dtype=torch.float)
target = torch.tensor([[0,0,0],[0,0,0]],dtype=torch.float)

model = Model()
y_pred = model(x)
print(y_pred)
loss = nn.MSELoss()
loss_value = loss(y_pred, target)
print(loss_value)
loss_value.backward()
print(model.linear1.weight.grad)
print(model.linear1.bias.grad)
optimizer = optim.SGD(model.parameters(),lr = 0.01)
optimizer.step()
optimizer.zero_grad()
for name, param in model.named_parameters():
    print(name,param)

tensor([[14.5000, 17.0000, 19.5000],
        [32.0000, 37.0000, 42.0000]], grad_fn=<AddmmBackward0>)
tensor(839.4167, grad_fn=<MseLossBackward0>)
tensor([[ 68.8333,  84.3333,  99.8333, 115.3333, 130.8333],
        [ 79.6667,  97.6667, 115.6667, 133.6667, 151.6667],
        [ 90.5000, 111.0000, 131.5000, 152.0000, 172.5000]])
tensor([15.5000, 18.0000, 20.5000])
linear1.weight Parameter containing:
tensor([[-0.5883, -0.4433, -0.2983, -0.1533, -0.0083],
        [-0.5967, -0.4767, -0.3567, -0.2367, -0.1167],
        [-0.6050, -0.5100, -0.4150, -0.3200, -0.2250]], requires_grad=True)
linear1.bias Parameter containing:
tensor([0.8450, 1.8200, 2.7950], requires_grad=True)
二、参数更新方法
1、Momentum
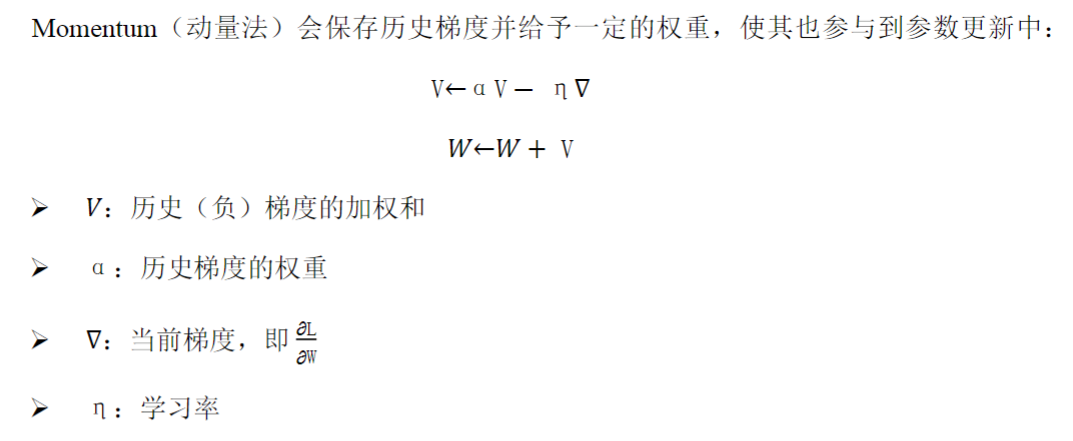
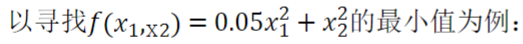
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD  # 随机梯度下降法(动量法)

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

# 梯度下降法函数,将数据和优化器、迭代次数传入
def gradient_descent(X,optimizer,num_iter):
    x1_list = []
    x2_list = []
    for i in range(num_iter):
        x1_list.append(X[0].detach().numpy().copy())
        x2_list.append(X[1].detach().numpy().copy())
        y = f(X)
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
    return x1_list,x2_list

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.01
num_iter = 500

X_clone = X.clone().detach().requires_grad_(True)
optimizer = SGD([X_clone],lr = lr)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'red')

X_clone = X.clone().detach().requires_grad_(True)
optimizer = SGD([X_clone],lr = lr,momentum = 0.9)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'blue')

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
plt.contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
plt.legend('SGD','Momentum')
plt.show()
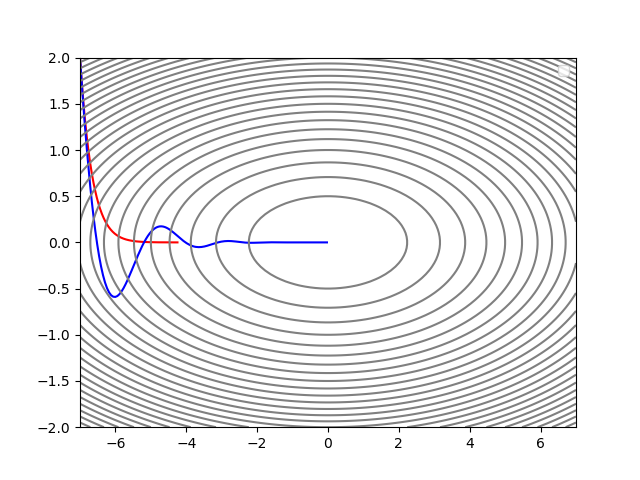
2、学习率衰减
2.1、等间隔衰减StepLR
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD
from torch.optim.lr_scheduler import StepLR # 等间隔衰减

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.9
num_iter = 500

optimizer = SGD([X],lr = lr)
lr_scheduler = StepLR(optimizer,step_size=20,gamma=0.7)

x1_list = []
x2_list = []
lr_list = []
for i in range(num_iter):
    x1_list.append(X[0].detach().numpy().copy())
    x2_list.append(X[1].detach().numpy().copy())
    lr_list.append(optimizer.param_groups[0]['lr'])
    y = f(X)
    y.backward()
    optimizer.step()
    optimizer.zero_grad()
    lr_scheduler.step()

plt.rcParams['font.sans-serif'] = ['Kaiti']
plt.rcParams['axes.unicode_minus'] = False

fig,ax = plt.subplots(1,2,figsize = (12,4))

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
ax[0].contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
ax[0].set_title('梯度下降过程')
ax[0].plot(x1_list,x2_list,color = 'red')

ax[1].plot(lr_list,color = 'k')
ax[1].set_title('学习率衰减')
plt.show()
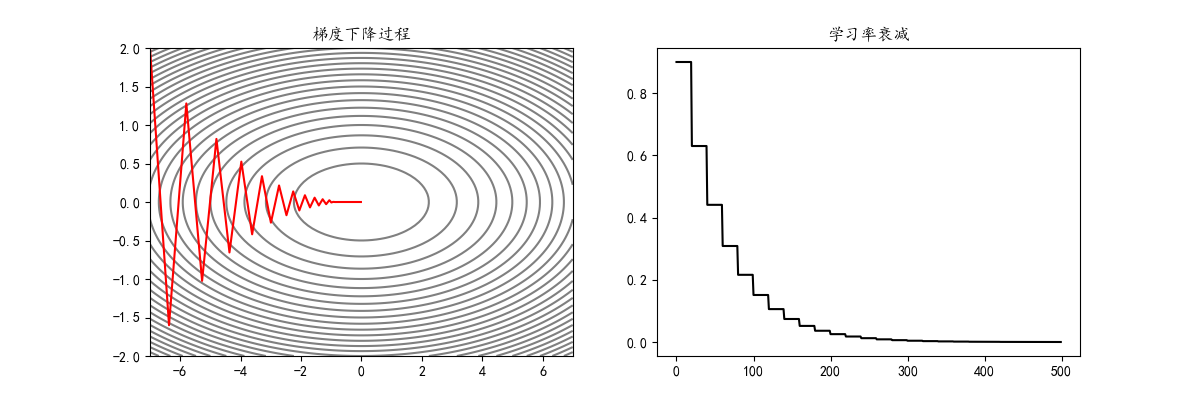
2.2、指定间隔和指数衰减MultiStepLR、ExponentialLR
等间隔衰减
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD
from torch.optim.lr_scheduler import MultiStepLR # 指定间隔衰减

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.9
num_iter = 500

optimizer = SGD([X],lr = lr)
lr_scheduler = MultiStepLR(optimizer,milestones = [ 10,50,200 ],gamma=0.7)

x1_list = []
x2_list = []
lr_list = []
for i in range(num_iter):
    x1_list.append(X[0].detach().numpy().copy())
    x2_list.append(X[1].detach().numpy().copy())
    lr_list.append(optimizer.param_groups[0]['lr'])
    y = f(X)
    y.backward()
    optimizer.step()
    optimizer.zero_grad()
    lr_scheduler.step()

plt.rcParams['font.sans-serif'] = ['Kaiti']
plt.rcParams['axes.unicode_minus'] = False

fig,ax = plt.subplots(1,2,figsize = (12,4))

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
ax[0].contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
ax[0].set_title('梯度下降过程')
ax[0].plot(x1_list,x2_list,color = 'red')

ax[1].plot(lr_list,color = 'k')
ax[1].set_title('学习率衰减')
plt.show()
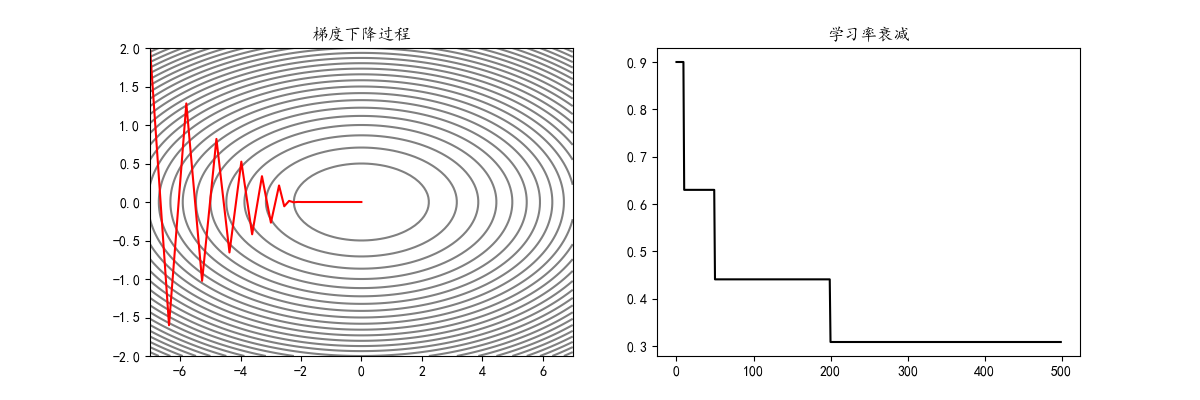
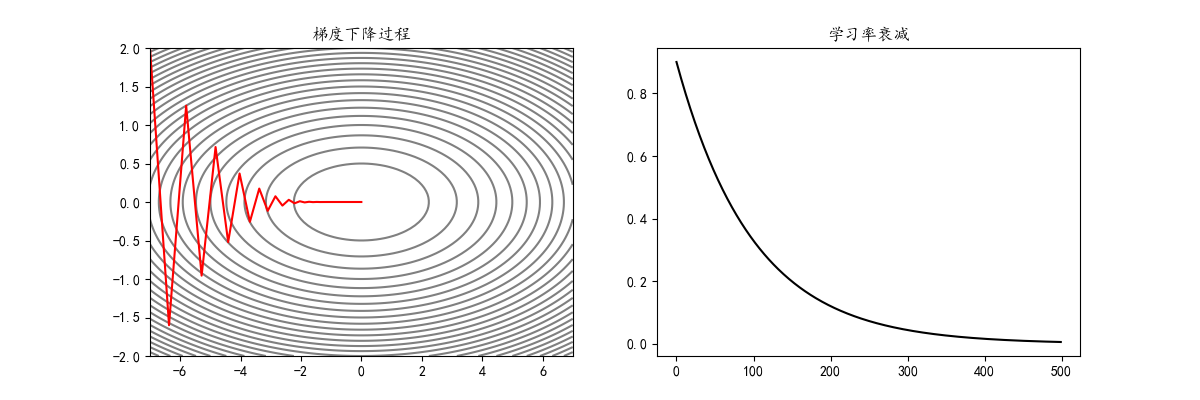
指数衰减
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD
from torch.optim.lr_scheduler import ExponentialLR # 指数衰减

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.9
num_iter = 500

optimizer = SGD([X],lr = lr)
lr_scheduler = ExponentialLR(optimizer,gamma=0.99)

x1_list = []
x2_list = []
lr_list = []
for i in range(num_iter):
    x1_list.append(X[0].detach().numpy().copy())
    x2_list.append(X[1].detach().numpy().copy())
    lr_list.append(optimizer.param_groups[0]['lr'])
    y = f(X)
    y.backward()
    optimizer.step()
    optimizer.zero_grad()
    lr_scheduler.step()

plt.rcParams['font.sans-serif'] = ['Kaiti']
plt.rcParams['axes.unicode_minus'] = False

fig,ax = plt.subplots(1,2,figsize = (12,4))

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
ax[0].contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
ax[0].set_title('梯度下降过程')
ax[0].plot(x1_list,x2_list,color = 'red')

ax[1].plot(lr_list,color = 'k')
ax[1].set_title('学习率衰减')
plt.show()
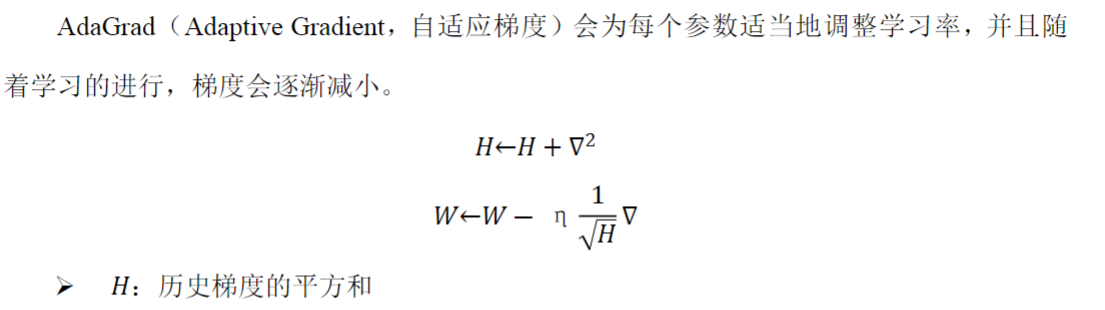
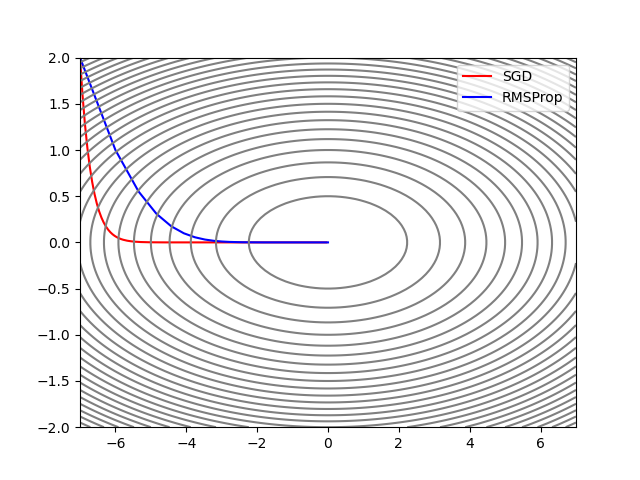
2.3、AdaGrad和RMSProp
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD,Adagrad

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

# 梯度下降法函数,将数据和优化器、迭代次数传入
def gradient_descent(X,optimizer,num_iter):
    x1_list = []
    x2_list = []
    for i in range(num_iter):
        x1_list.append(X[0].detach().numpy().copy())
        x2_list.append(X[1].detach().numpy().copy())
        y = f(X)
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
    return x1_list,x2_list

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.9
num_iter = 500

X_clone = X.clone().detach().requires_grad_(True)
optimizer = SGD([X_clone],lr = lr)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
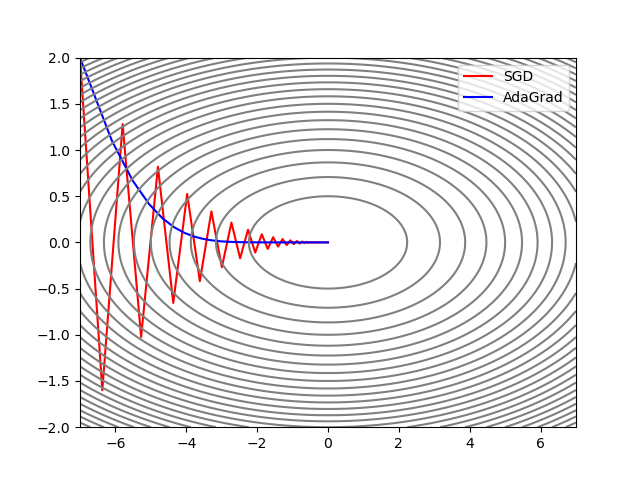
plt.plot(x1_list,x2_list,color = 'red')

X_clone = X.clone().detach().requires_grad_(True)
optimizer = Adagrad([X_clone],lr = lr)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'blue')

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
plt.contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
plt.legend(['SGD','AdaGrad'])
plt.show()
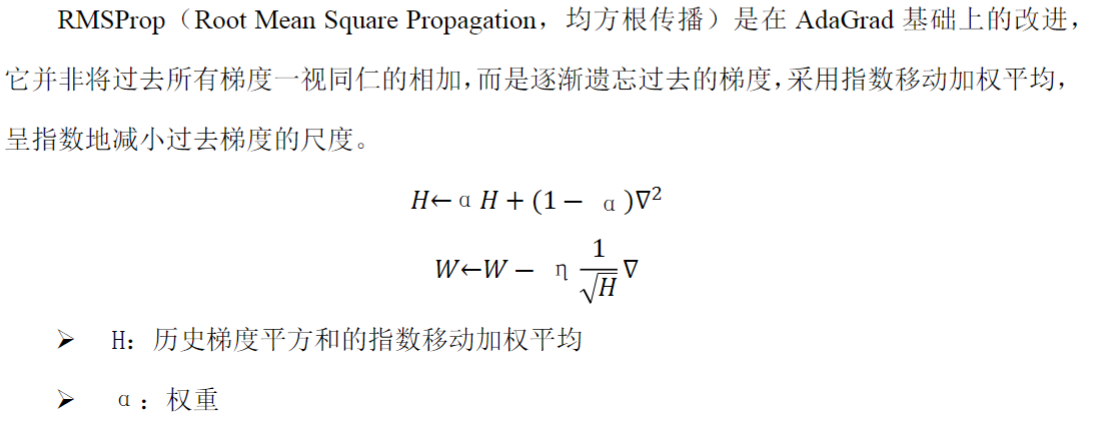
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD,RMSprop

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

# 梯度下降法函数,将数据和优化器、迭代次数传入
def gradient_descent(X,optimizer,num_iter):
    x1_list = []
    x2_list = []
    for i in range(num_iter):
        x1_list.append(X[0].detach().numpy().copy())
        x2_list.append(X[1].detach().numpy().copy())
        y = f(X)
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
    return x1_list,x2_list

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.1
num_iter = 500

X_clone = X.clone().detach().requires_grad_(True)
optimizer = SGD([X_clone],lr = lr)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'red')

X_clone = X.clone().detach().requires_grad_(True)
optimizer = RMSprop([X_clone],lr = lr,alpha = 0.99)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'blue')

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
plt.contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
plt.legend(['SGD','RMSProp'])
plt.show()
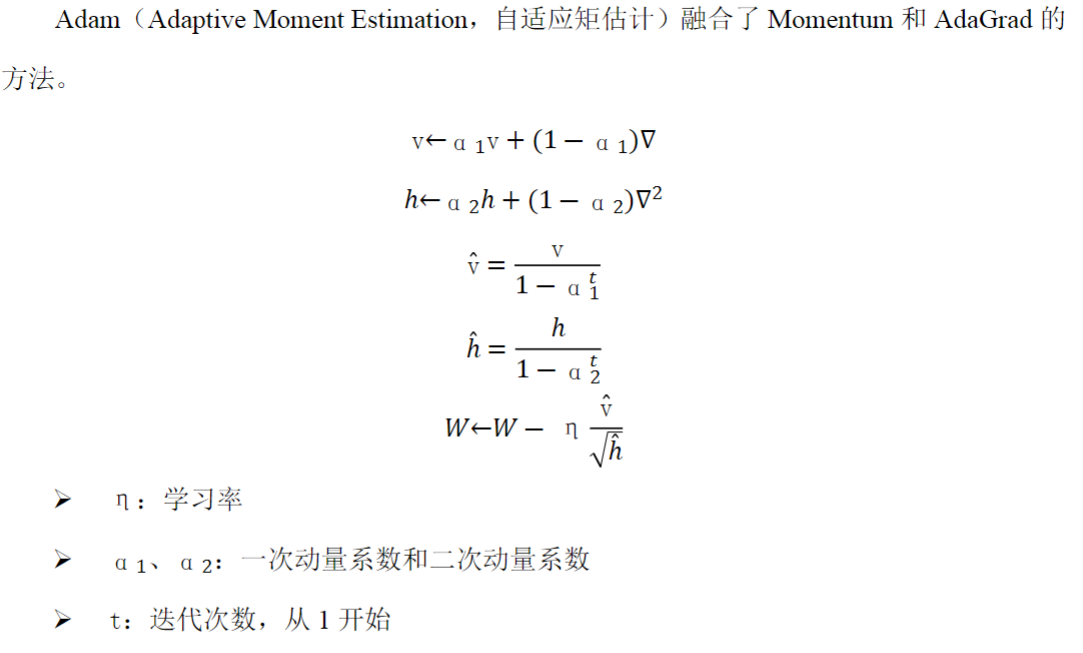
2.4、Adam和AdamW
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch.optim import SGD,Adam

def f(X):
    return 0.05 * X[0] ** 2 + X[1] ** 2

# 梯度下降法函数,将数据和优化器、迭代次数传入
def gradient_descent(X,optimizer,num_iter):
    x1_list = []
    x2_list = []
    for i in range(num_iter):
        x1_list.append(X[0].detach().numpy().copy())
        x2_list.append(X[1].detach().numpy().copy())
        y = f(X)
        y.backward()
        optimizer.step()
        optimizer.zero_grad()
    return x1_list,x2_list

X = torch.tensor([-7.0,2.0],requires_grad=True)

lr = 0.1
num_iter = 500

X_clone = X.clone().detach().requires_grad_(True)
optimizer = SGD([X_clone],lr = lr)
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'red')

X_clone = X.clone().detach().requires_grad_(True)
optimizer = Adam([X_clone],lr = lr,betas = (0.9,0.999))
x1_list,x2_list = gradient_descent(X_clone,optimizer,num_iter)
plt.plot(x1_list,x2_list,color = 'blue')

x1_grid,x2_grid = np.meshgrid(np.linspace(-7,7,100),np.linspace(-2,2,100))
y_grid = 0.05 * x1_grid ** 2 + x2_grid ** 2
plt.contour(x1_grid,x2_grid,y_grid,colors='gray',levels = 30)
plt.legend(['SGD','Adam'])
plt.show()
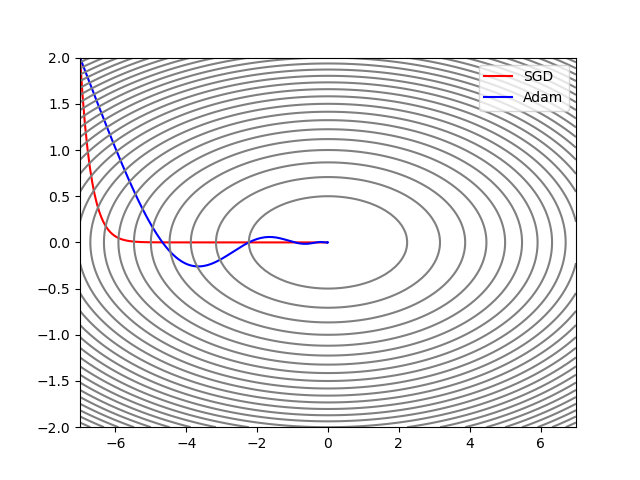
AdamW现在应用更广泛
三、房价预测案例
对特征进行处理,数值型特征使用均值填充缺失值,再标准化;类别型特征使用字符串“NaN”填充
缺失值,再独特编码。之后构造数据集。
import os
os.environ["KMP_DUPLICATE_LIB_OK"] = "TRUE"
import torch
from torch import nn,optim
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler,OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from torch.utils.data import TensorDataset, DataLoader

def create_dataset():
    data = pd.read_csv('data/house_prices.csv')
    data.drop(["Id"],axis=1,inplace=True)
    X = data.drop("SalePrice",axis=1)
    y = data["SalePrice"]
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    print(x_train.shape,y_train.shape)

    numerical_features = X.select_dtypes(exclude = 'object').columns
    categorical_features = X.select_dtypes(include = 'object').columns

    numerical_transformer = Pipeline(steps = [
        ('fillna', SimpleImputer(strategy='mean')),# 缺失值填充,均值填充
        ('std', StandardScaler()) # 标准化
    ])
    categorical_transformer = Pipeline(steps = [
        ('fillna',SimpleImputer(strategy = 'constant',fill_value='NaN')),
        ('onehot', OneHotEncoder(handle_unknown='ignore'))
    ])
    columnTransformer = ColumnTransformer(transformers = [
        ('num', numerical_transformer, numerical_features),
        ('cat', categorical_transformer, categorical_features),
    ])

    x_train = columnTransformer.fit_transform(x_train)
    x_test = columnTransformer.transform(x_test)
    # 将稀疏矩阵的压缩表示转换成稠密矩阵形式
    x_train =x_train.toarray()
    x_test = x_test.toarray()
    print(x_train.shape,x_test.shape)
    train_dataset = TensorDataset(torch.Tensor(x_train),torch.Tensor(y_train.values))
    test_dataset = TensorDataset(torch.Tensor(x_test),torch.Tensor(y_test.values))
    return train_dataset,test_dataset,x_train.shape[1]

train_dataset,test_dataset,feature_num = create_dataset()
print(feature_num)

model = nn.Sequential(
    nn.Linear(feature_num,128),
    nn.BatchNorm1d(128),
    nn.ReLU(),
    nn.Dropout(0.2),
    nn.Linear(128,1)
)

def init_weights(layer):
    if isinstance(layer,nn.Linear):
        nn.init.kaiming_normal_(layer.weight)
model.apply(init_weights)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model.to(device)

lr = 0.1
batch_size = 64
epoch_num = 200

train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=batch_size)

optimizer = optim.Adam(model.parameters(), lr=lr)

def log_rmse(pred,target):
    pred = torch.clamp(pred,1,float("inf"))
    mse = nn.MSELoss()
    mse_loss_value = mse(torch.log(pred),torch.log(target))
    return torch.sqrt(mse_loss_value)

train_loss_list = []
test_loss_list = []
for epoch in range(epoch_num):
    model.train() # 开启训练模式是因为BN层和Dropout都是在训练的时候生效,测试不生效

    train_loss_total = 0

    for X, y in train_loader:
        X,y = X.to(device),y.to(device)
        y_pred = model(X)
        loss_value = log_rmse(y_pred.squeeze(),y)
        loss_value.backward()
        optimizer.step()
        optimizer.zero_grad()

        train_loss_total += loss_value.item() * X.shape[0]
    this_train_loss = train_loss_total / len(train_dataset)
    train_loss_list.append(this_train_loss)

    model.eval()
    test_loss_total = 0

    with torch.no_grad():
        for X, y in test_loader:
            X,y = X.to(device),y.to(device)
            y_pred = model(X)
            loss_value = log_rmse(y_pred.squeeze(),y)

            test_loss_total += loss_value.item() * X.shape[0]

    this_test_loss = test_loss_total / len(test_dataset)
    test_loss_list.append(this_test_loss)

    print(f'epoch:{epoch + 1}\t train loss:{this_train_loss:.6}\t test loss:{this_test_loss:.6f}')

plt.plot(train_loss_list,label='train loss',color = 'blue',linewidth = 3)
plt.plot(test_loss_list,label='test loss',color = 'red',linestyle='--',linewidth = 2)
plt.legend(loc='best')
plt.show()

更多推荐


 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)