
机器学习支持向量机(SVM)
·
1. 支持向量机相关概念
支持向量机(SVM)是一种经典二分类模型,核心目标是 寻找 “最大间隔超平面”实现类别划分,
- 最大间隔超平面:能将不同类别样本分开,且与两类样本的最小距离(间隔)最大的超平面;
- 支持向量:距离超平面最近的样本点(决定了间隔大小,是模型训练的核心样本);
- 软间隔与参数 C:当样本不完全线性可分时,允许部分样本越界(“软间隔”),参数
C控制 “间隔最大化” 与 “分类错误最小化” 的权衡:C越大,对分类错误的惩罚越重,模型更倾向于正确分类所有样本; - 核函数:将低维非线性可分样本映射到高维特征空间,使其线性可分(本题数据集为线性可分,使用线性核)。
2. 实验过程和内容
2.1 实验目的
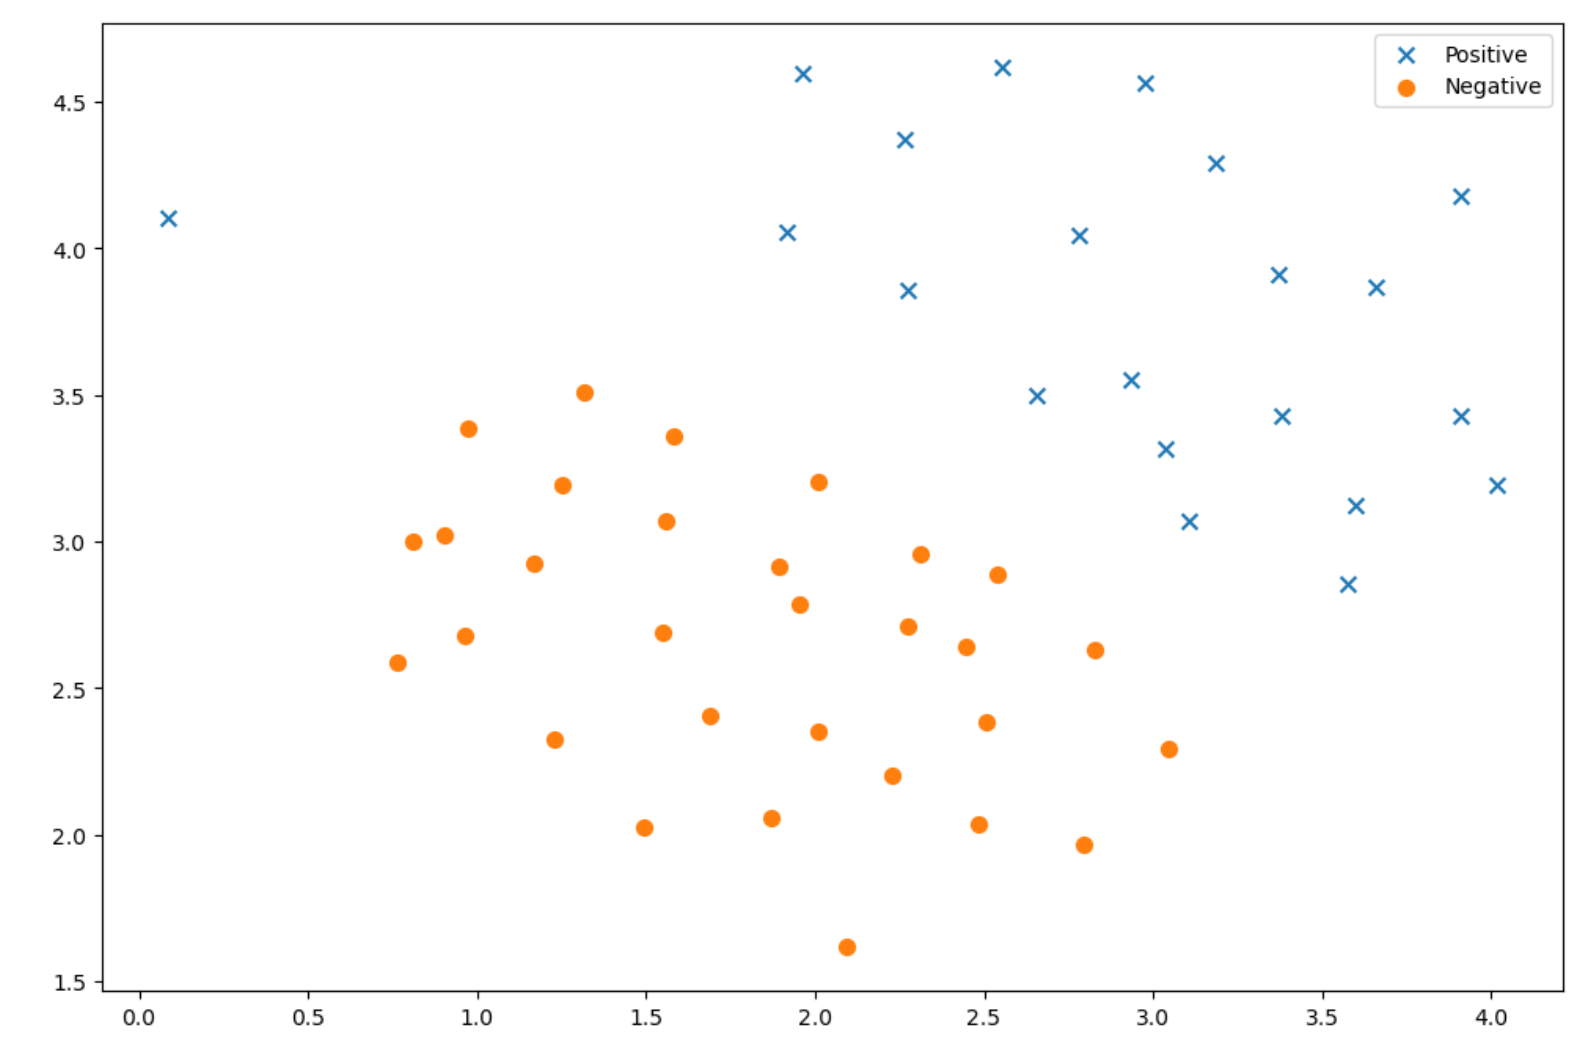
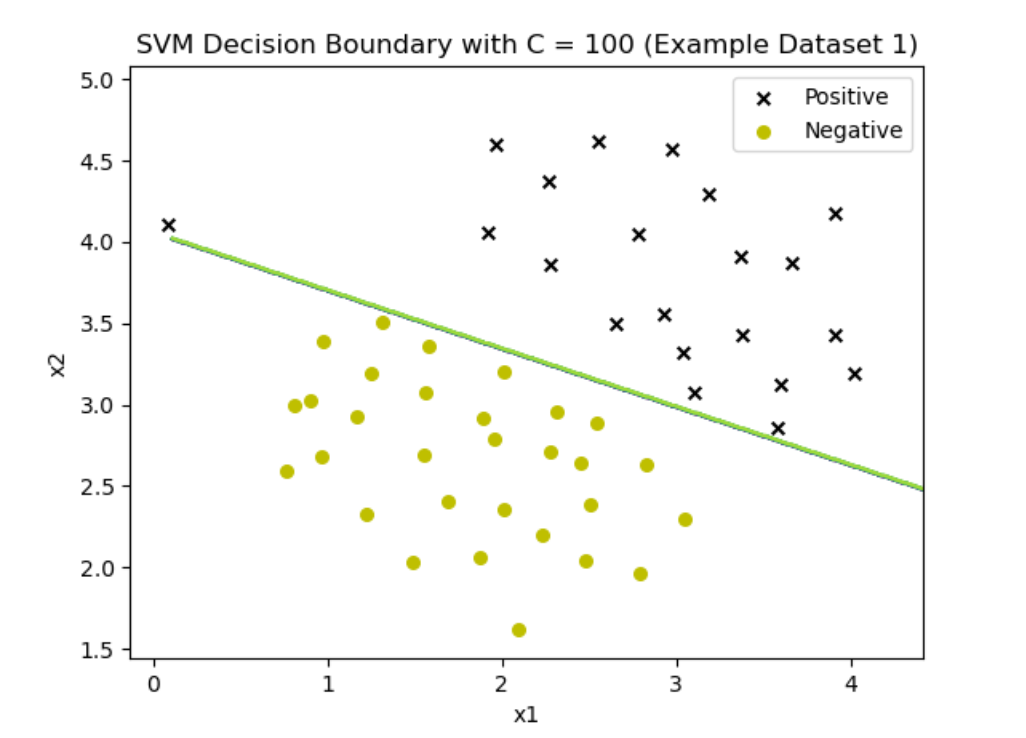
基于 “Example Dataset 1”(二维特征 + 二分类标签),使用线性 SVM实现分类,观察C=100时的决策边界,验证 SVM 的分类效果。
2.2 数据集说明
数据集包含 2 个特征(x1、x2),标签分为两类:
- 正类(Positive):用 “×” 表示,分布在特征空间的右上方区域;
- 负类(Negative):用 “・” 表示,分布在特征空间的左下方区域;样本整体呈线性可分分布。
2.3 实验步骤
- 构造 / 加载模拟数据集;
- 初始化线性 SVM 模型;
- 用数据集训练 SVM 模型;
- 绘制样本点与 SVM 决策边界;
- 分析决策边界与分类效果。
3. 代码分段实现
3.1 导入依赖库
import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import SVC  # 支持向量机分类器
from sklearn.datasets import make_blobs  # 生成模拟分类数据
3.2 构造模拟数据集(匹配题目分布)
# 生成正类(Positive)和负类(Negative)样本
# 负类:左下方,正类:右上方
X_neg, y_neg = make_blobs(n_samples=25, centers=[[1.5, 2.5]], cluster_std=0.6, random_state=42)
X_pos, y_pos = make_blobs(n_samples=20, centers=[[3.0, 4.0]], cluster_std=0.5, random_state=42)

# 合并为完整数据集:特征X + 标签y(负类→0,正类→1)
X = np.vstack([X_neg, X_pos])
y = np.hstack([np.zeros(len(X_neg)), np.ones(len(X_pos))])
3.3 初始化并训练 SVM 模型(C=100,线性核)
# 初始化线性SVM,设置C=100(对分类错误惩罚较重)
svm_model = SVC(kernel='linear', C=100, random_state=42)
# 训练模型
svm_model.fit(X, y)
3.4 绘制样本点与决策边界
# 1. 绘制样本点
plt.figure(figsize=(8, 6))
plt.scatter(X_neg[:, 0], X_neg[:, 1], c='gold', label='Negative', marker='o', s=50)
plt.scatter(X_pos[:, 0], X_pos[:, 1], c='black', label='Positive', marker='x', s=50)

# 2. 绘制决策边界(超平面)
# 生成网格点用于绘制决策边界
x1_min, x1_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
x2_min, x2_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.linspace(x1_min, x1_max, 200), np.linspace(x2_min, x2_max, 200))

# 预测网格点类别
Z = svm_model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# 绘制决策边界与区域
plt.contourf(xx, yy, Z, alpha=0.1, cmap=plt.cm.coolwarm)
# 绘制决策超平面(线性边界)
w = svm_model.coef_[0]
b = svm_model.intercept_[0]
x1_plot = np.linspace(x1_min, x1_max, 200)
x2_plot = (-w[0] * x1_plot - b) / w[1]
plt.plot(x1_plot, x2_plot, 'g-', linewidth=2, label='Decision Boundary')

# 3. 图表设置
plt.title('SVM Decision Boundary with C = 100 (Example Dataset 1)')
plt.xlabel('x1')
plt.ylabel('x2')
plt.legend()
plt.grid(alpha=0.3)
plt.show()
4. 实验总结
4.1 实验结果
当C=100时,SVM 模型学习到的线性决策边界能清晰分离 “Positive” 与 “Negative” 样本,且由于C值较大,模型对分类错误的惩罚较重,最终实现了所有样本的正确分类。
4.2 实验分析
- C 参数的影响:
C=100属于较大值,此时模型更优先保证 “分类正确”,因此决策边界更贴近部分样本(支持向量),间隔相对较小;若减小C,模型会更注重 “间隔最大化”,允许少量样本越界。 - SVM 的优势:仅依赖 “支持向量” 训练模型,计算效率高,泛化能力强;线性核在样本线性可分时效果简洁高效。
- 局限性:当样本量极大时,SVM 的训练效率会降低;非线性场景需依赖核函数选择。
更多推荐

 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)