
注意力机制--大模型输入的上下文【上】
长序列建模中的问题
让我们考虑一个场景,我们需要开发一个语言翻译模型。由于源语言和目标语言的语法结构不同,只是逐个单词进行翻译是不准确的,如下图所示。翻译过程是需要理解上下文并进行语法对齐。
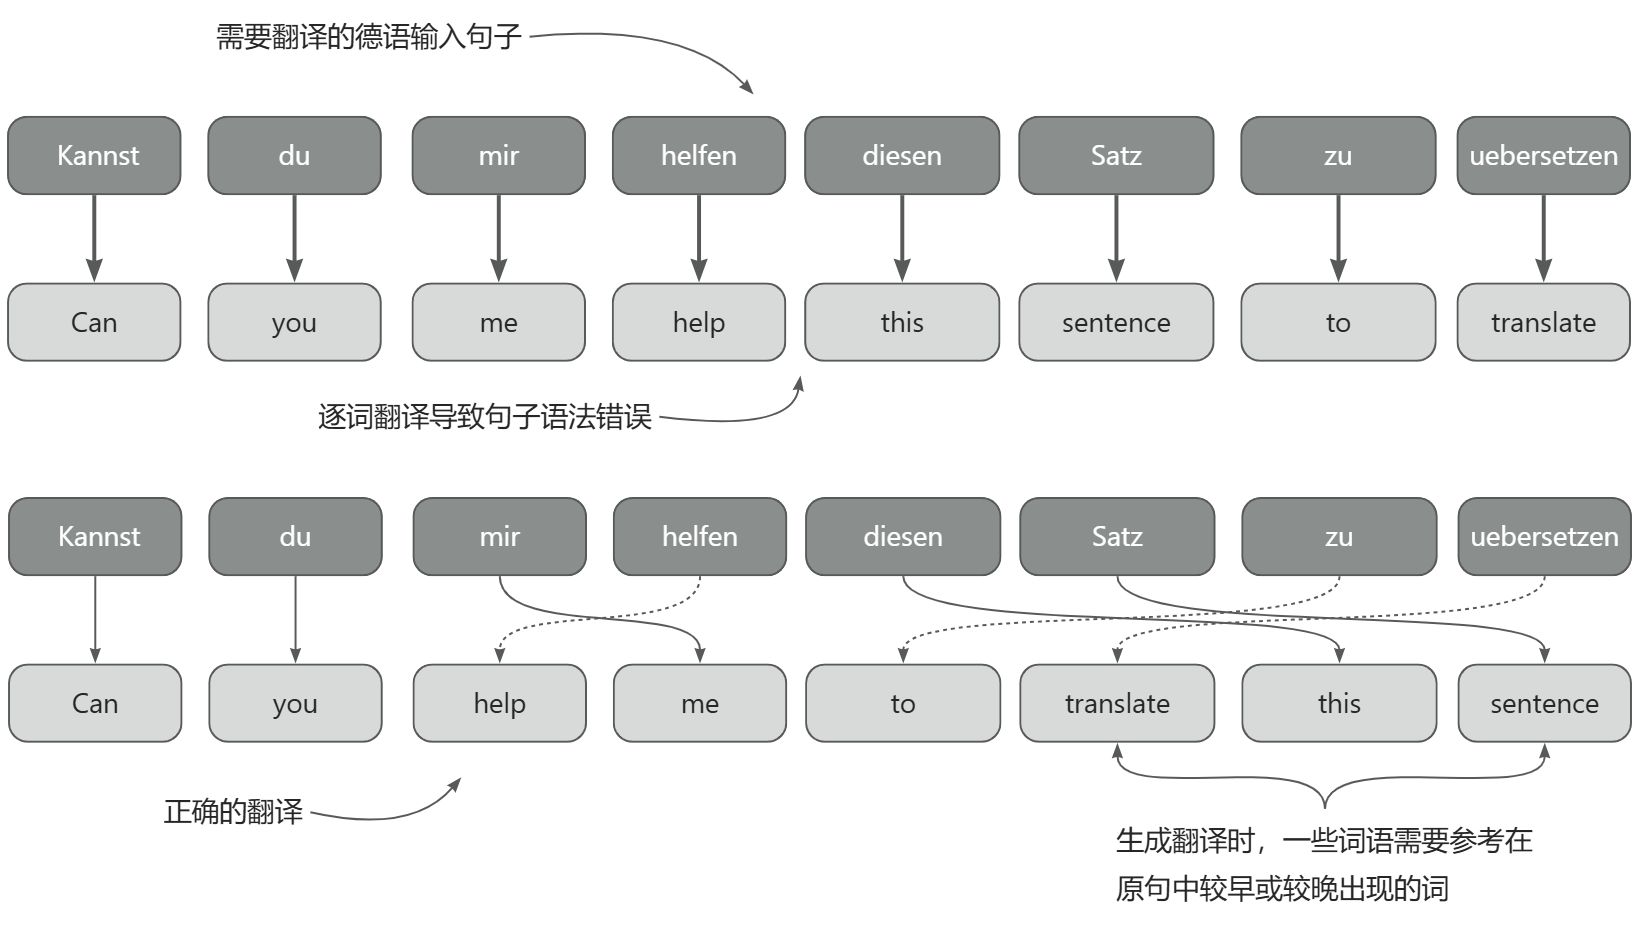
在 Transformer 出现之前,循环神经网络(recurrent neural network,RNN)是语言翻译中最流行的编码器-解码器架构。
在RNN 中,输入文本被传递给编码器以逐步处理。编码器在每一步都会更新其隐藏状态(隐藏层的内部值,一个中间神经网络层),其试图在最终的隐藏状态中捕捉输入句子的全部含义,如下图所示。然后,解码器使用这个最终的隐藏状态开始逐字生成翻译后的句子。解码器同样在每一步更新其隐藏状态,该状态包含为下一单词预测所需的上下文信息。
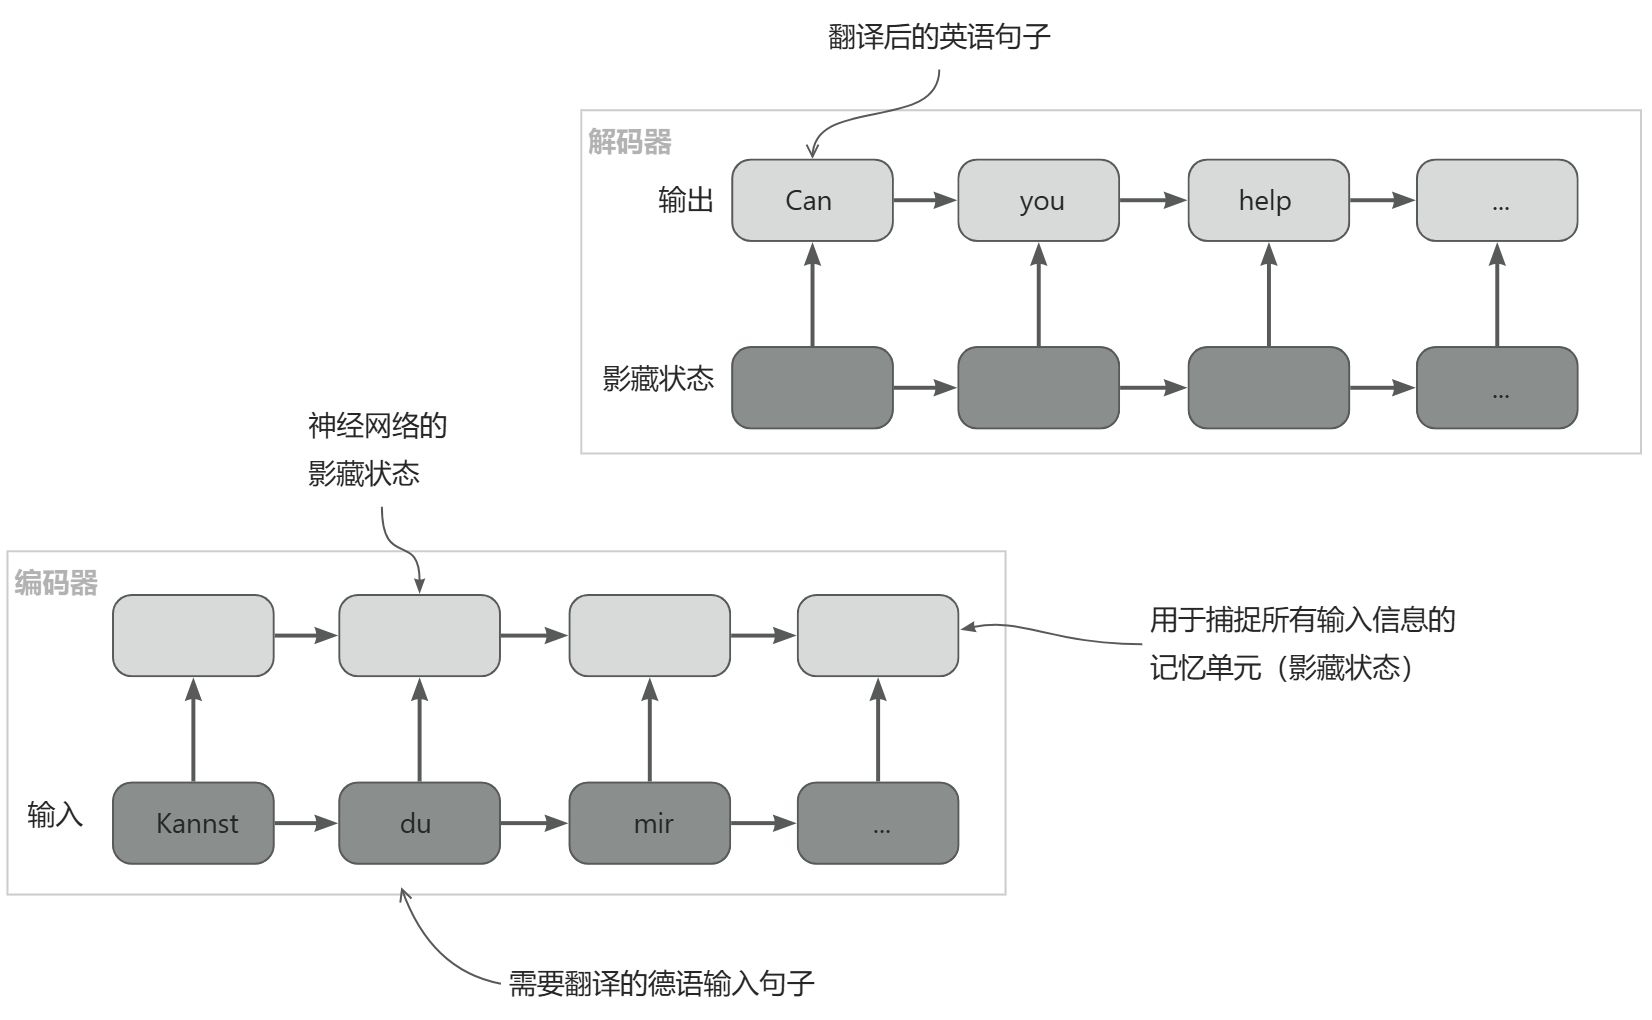
我们可以将这个隐藏状态视为一种嵌入向量。
编码器-解码器RNN的主要限制是,在解码阶段,RNN无法访问编码器中的早期隐藏状态。因此,它只能依赖当前的隐藏状态,这个状态包含了所有相关信息。这可能导致上下文丢失,特别是在复杂句子中,依赖关系可能跨越较长的距离。
使用注意力机制捕捉数据依赖关系
尽管 RNN 在翻译短句时表现良好,但在处理较长文本时效果不佳,因为它无法访问输入中靠前的单词。因此,研究人员在 2014 年为 RNN 开发了** Bahdanau 注意力机制**,该机制使得解码器在每个步骤中可以选择性地访问输入序列的不同部分。
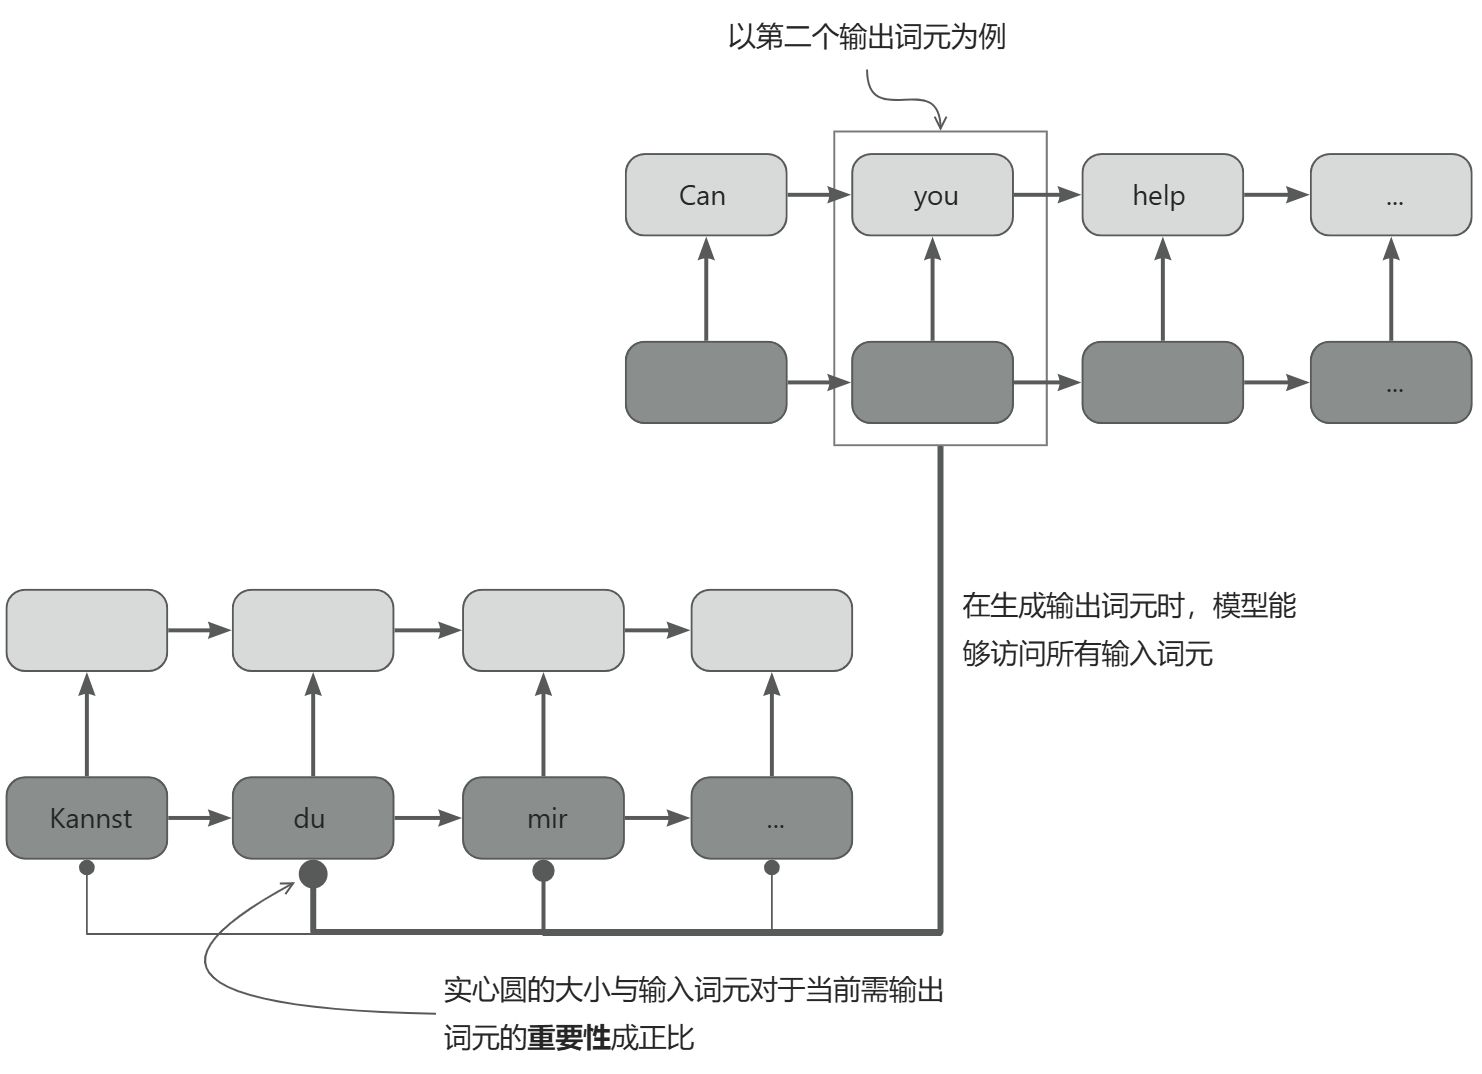
通过注意力机制,解码器可以有选择地访问所有输入词元,这意味着对于生成一个特定的输出词元,某些输人词元比其他输入词元更重要。而这种重要性由注意力权重决定。
在2017年,研究人员提出了 Transformer 架构,包括受 Bahdanau 注意力机制启发的自注意力机制。自注意力机制在计算序列表示时,通过允许输入序列中的每个位置与同一序列中的其他所有位置进行交互并权衡其重要性,来计算出更高效的输入表示。
通过自注意力机制关注输入的不同部分
在自注意力机制中,“自”指的是该机制通过关联当前输入序列中的不同位置来计算注意力权重的能力。它可以评估并学习输入本身各个部分之间的关系和依赖,比如句子中的单词或图像中的图像块。
简单自注意力机制
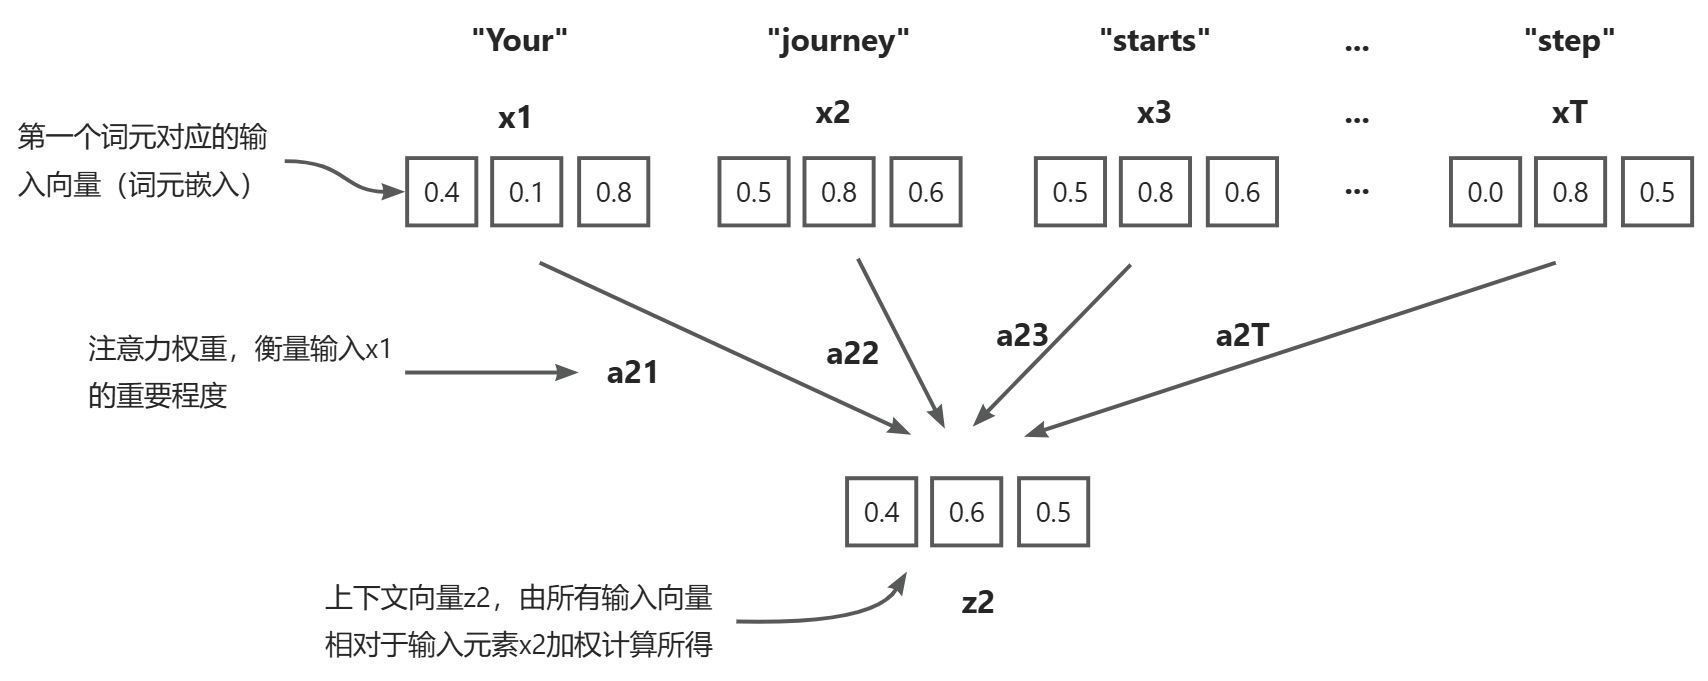
自注意力机制的目标是为输入序列中的每个元素计算上下文向量。上下文向量(context vector)可以被理解为包含序列中所有元素信息的嵌入向量。该向量结合了其他所有输入元素的信息。
上下文向量的目的是通过结合序列中其他所有元素的信息,为输入序列中的每个元素创建上下文信息(包括语义、语序、依赖关系等)。因为语言模型需要理解句子中单词之间的关系和相关性。
在下图中,我们计算输入词元x2的上下文向量z2 。计算z2时,各个输入元素的重要性或贡献度由注意力权重 a21到 a2T 决定。这些注意力权重是针对输入元素 x2及其他所有输入元素计算的。
注意力分数
后面我们通过将第二个输入元素x2作为查询,来演示上下文向量z2的计算过程。实现自注意力机制的第一步是计算注意力分数。可以通过点积计算查询词元与其他所有输入元素之间的注意力分数。
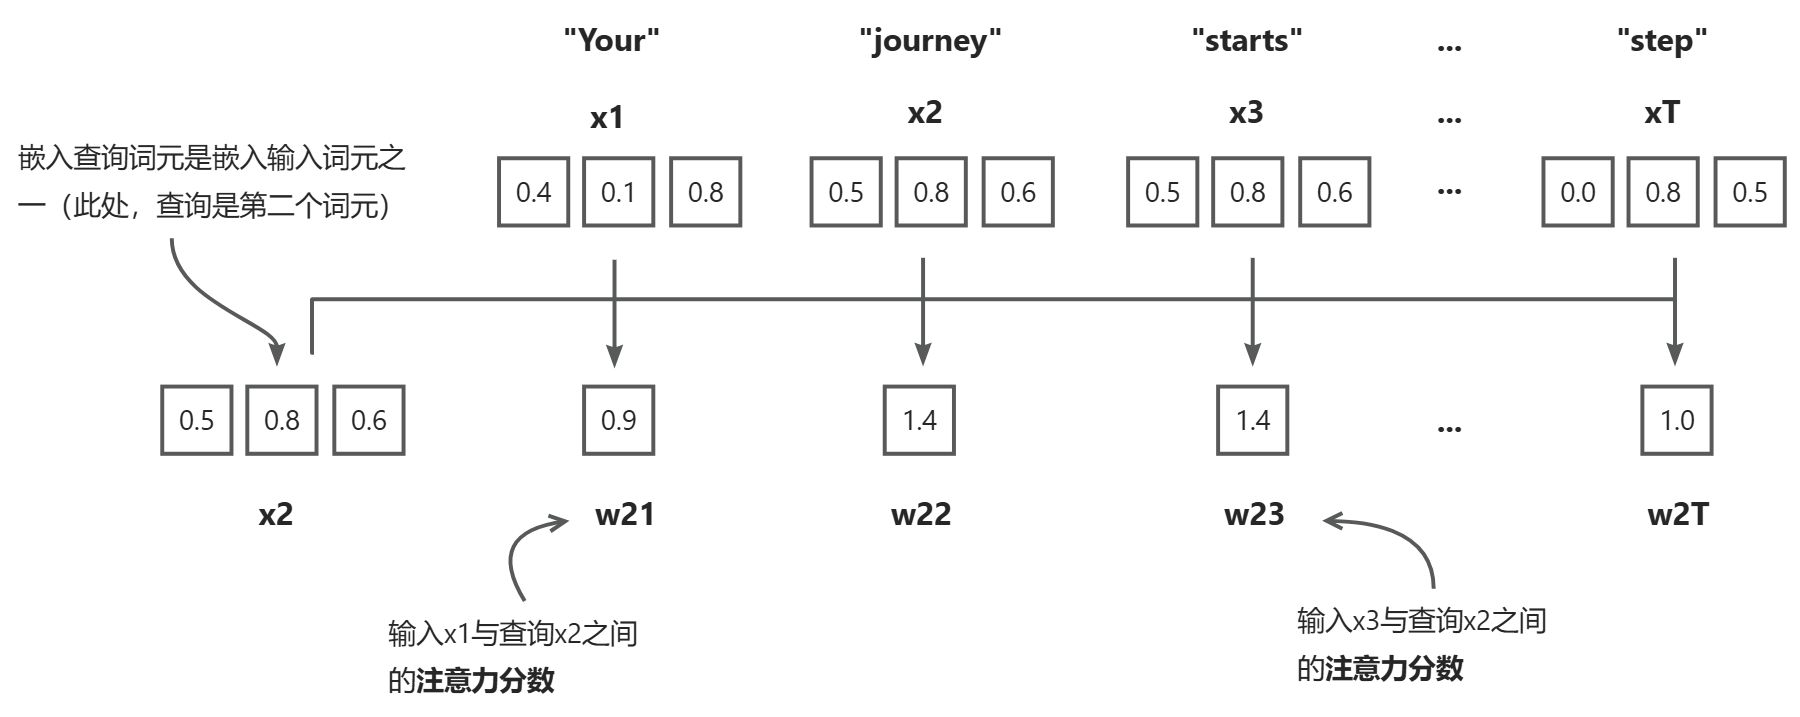
上图展示了第一个中间步骤,即通过点积计算查询x2与其他所有输人元素之间的注意力分数w(注意,为了减少视觉混乱,数值被截断为小数点后一位数字)
点积本质上是将两个向量逐个元素相乘然后对乘积求和。点积不仅被视为一种将两个向量转化为标量值的数学工具,而且也是度量相似度的一种方式,因为它可以量化两个向量之间的对齐程度:点积越大,向量之间的对齐程度或相似度就越高。在自注意机制中,点积决定了序列中每个元素对其他元素的关注程度:点积越大,两个元素之间的相似度和注意力分数就越高。
注意力权重
第二步,对上一步的注意力分数进行归一化处理。归一化的目的是获得总和为 1 的注意力权重。这种归一化能维持大语言模型的训练稳定性。
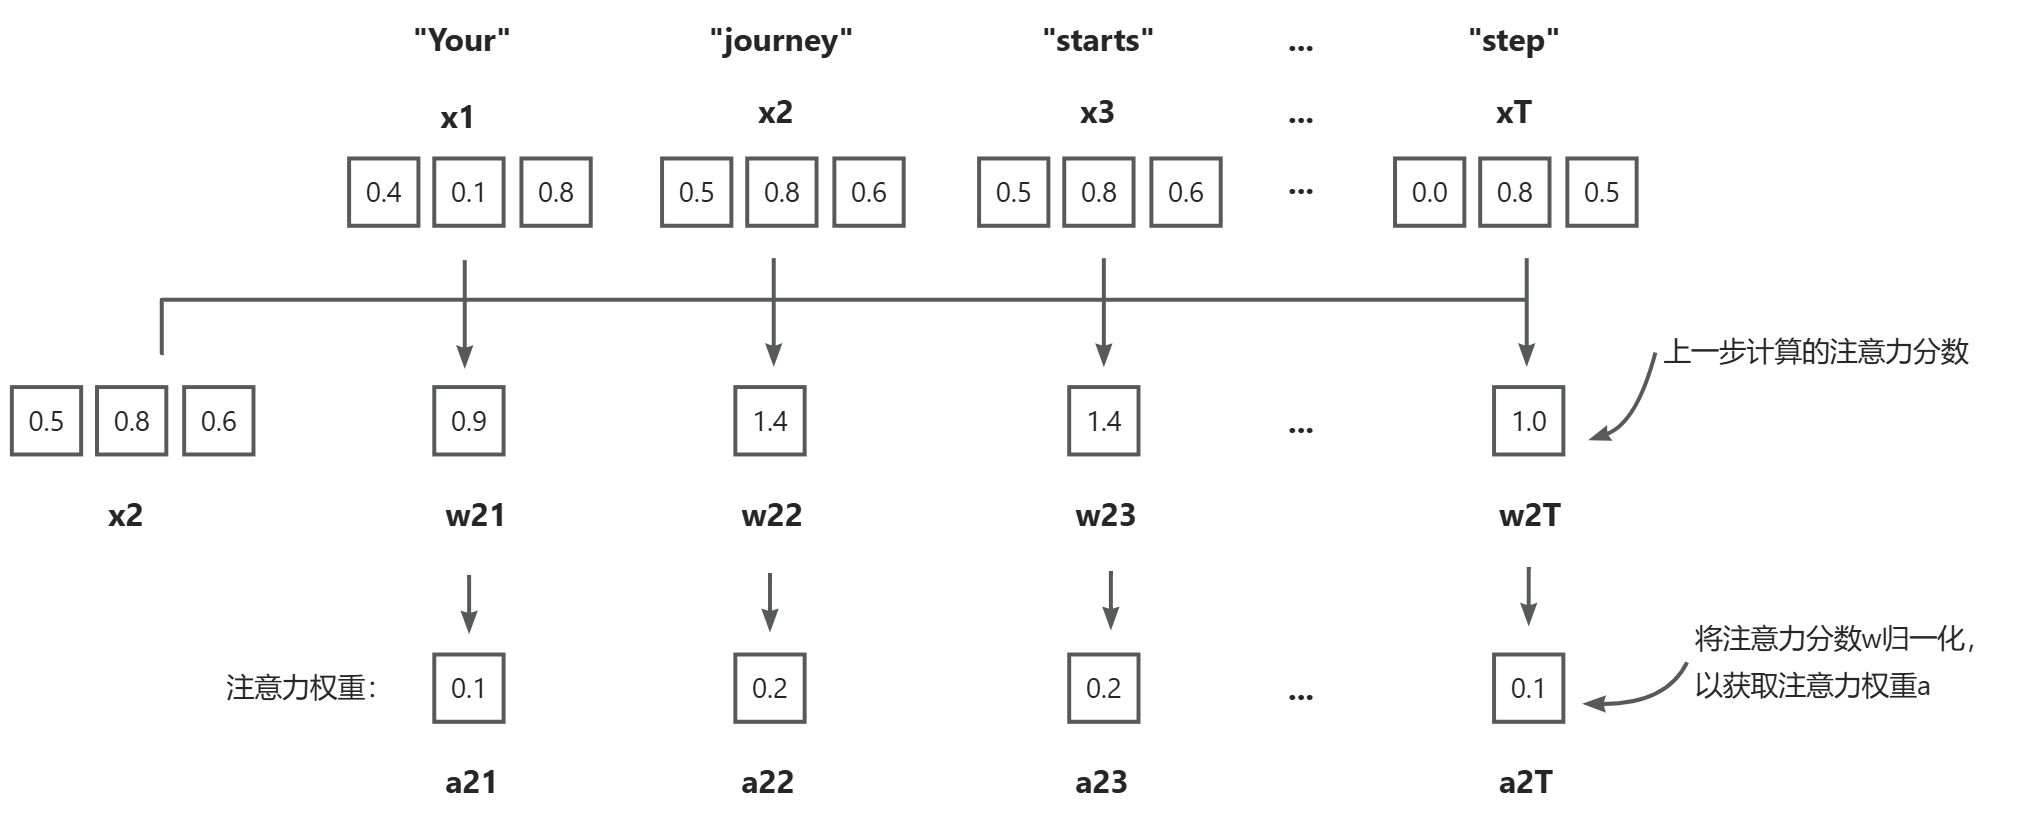
在计算完与输人查询x2相关的注意力分数w21到w2T之后,下一步是通过对这些注意力分数进行归一化,来获得注意力权重a21到a2T。
在实际应用中,使用 softmax 函数进行归一化。该方法能更好地处理极值,并在训练期间提供更有利的梯度特性。
上下文向量
最后一步,将嵌入的输入词元与相应的注意力权重相乘,再将得到的向量求和来计算上下文向量。因
此,上下文向量是所有输入向量的加权总和,通过将每个输入向量与其对应的注意力权重相乘而获得。
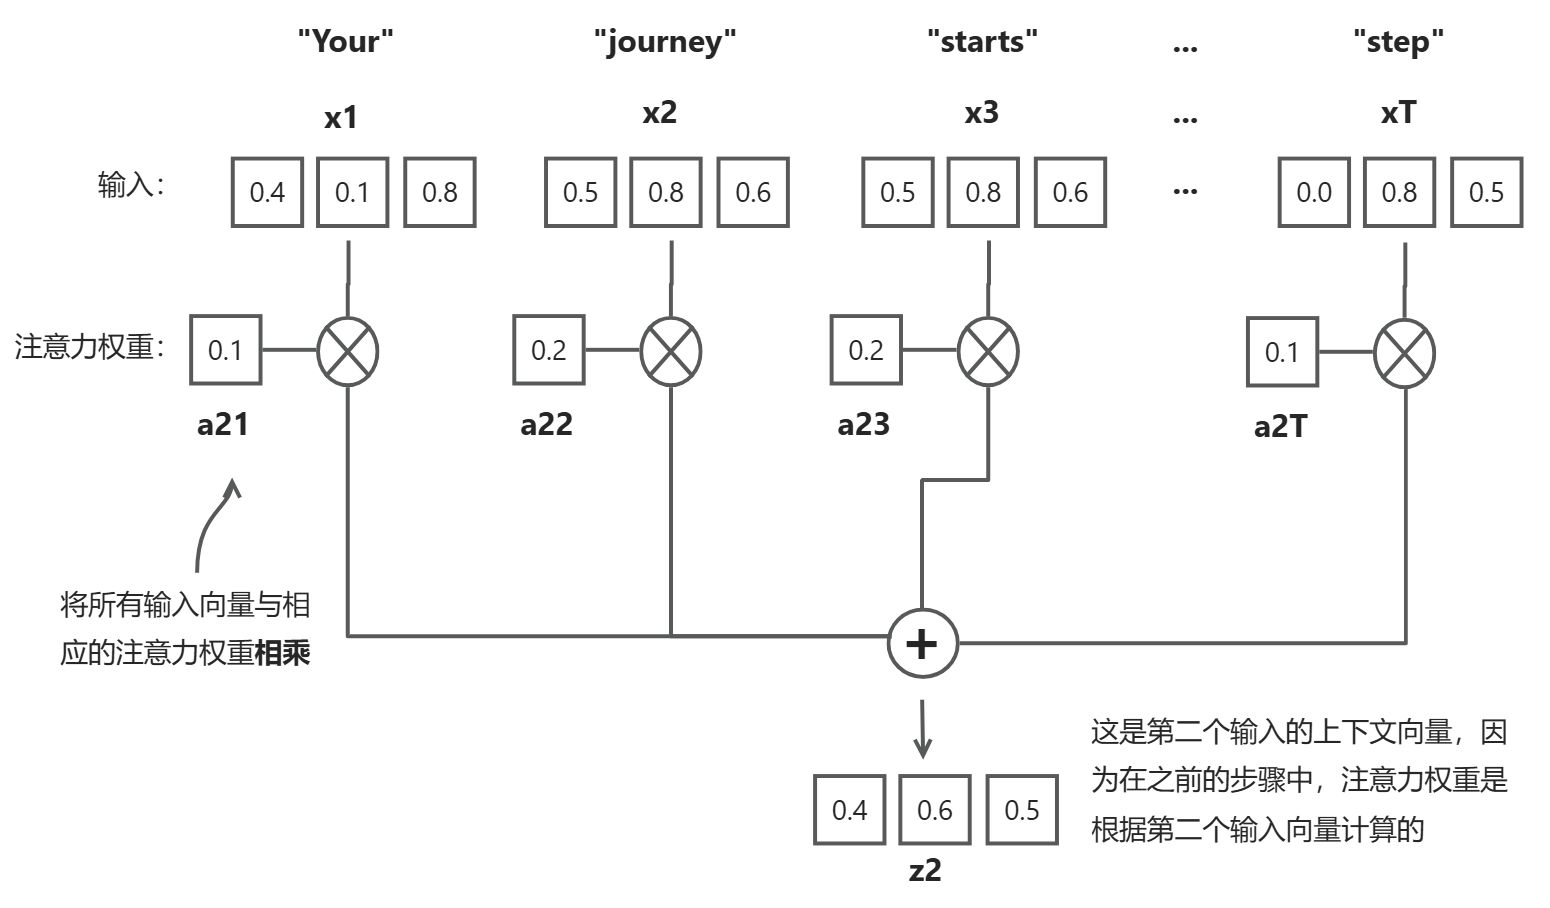
在计算并归一化注意力分数以获取查询x2的注意力权重之后,最后一步是计算上下文向量z2。该上下文向量z2是所有输人向量x1到xT按注意力权重加权的总和。
计算所有输入词元的注意力权重
接下来,我们遵循计算上下文向量的 3 个步骤,使用for循环,计算所有上下文向量,得到所有输入词元的注意力分数。而不仅仅是第二个上下文向量 。
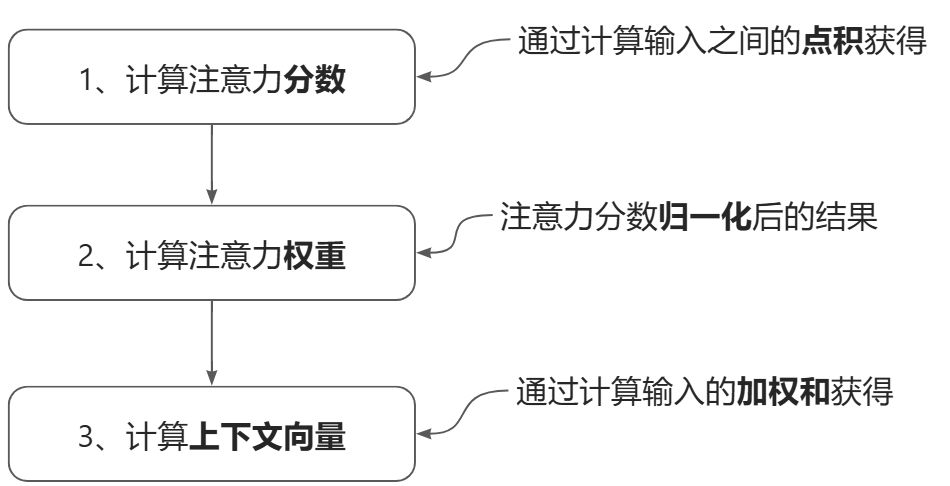
计算得到的注意力分数如下下图中张量所示:
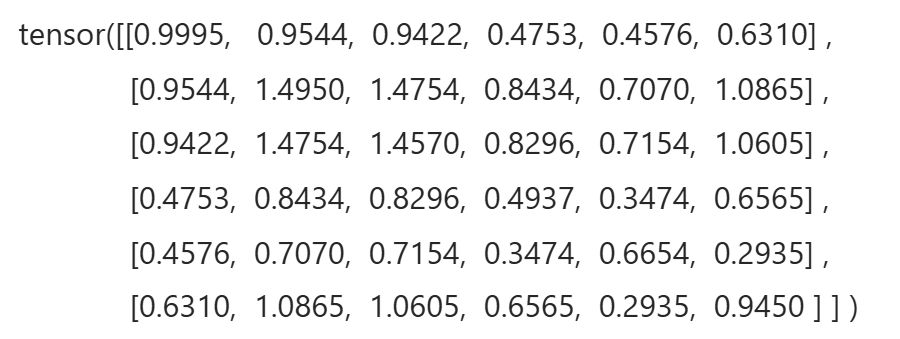
上面张量中的每个元素表示每对输入之间的注意力分数。
因为for 循环通常较慢,我们可以使用矩阵乘法来得到相同的结果。
至此,我们实现了一个简单的自注意力机制。这个机制允许模型在处理序列数据时能够更好地捕捉长期依赖关系以及不同位置信息间的关联性。通过这种方式,即使面对非常长的文本序列,也能有效地提取出有用特征,进而支持更复杂的下游任务,比如机器翻译、情感分析等。
带可训练权重的自注意力机制
在简单自注意力机制的基础上,我们引入在模型训练期间可训练的权重矩阵。可训练的权重帮助大语言模型学习如何构建上下文向量,使它们能用于预测下一个词元。带可训练权重的自注意力机制,也被称为缩放点积注意力(scaled dot-product attention)。
逐步计算注意力权重
通过引入 3 个可训练的权重矩阵 Wq、Wk 和 Wv,一步一步地实现可训练权重的自注意力。这3个矩阵用于将嵌入的输入词元 x (i)分别映射为查询向量、键向量和值向量。
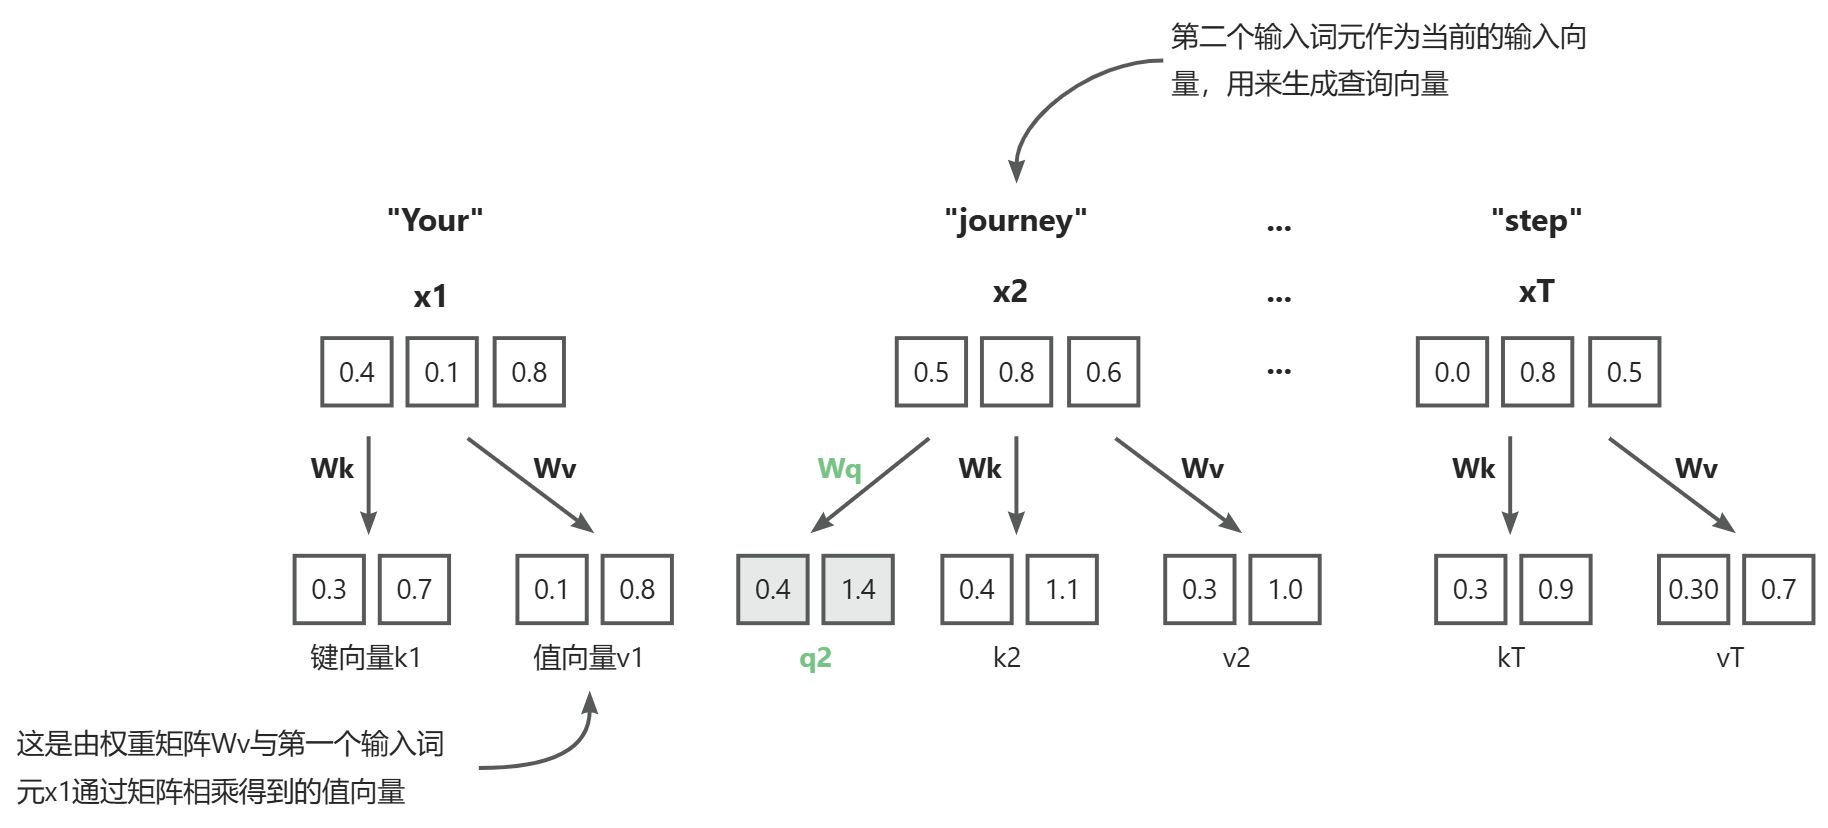
在实现具有可训练权重矩阵的自注意机制的第一步中,我们计算了输人元素x的查询向量q、键向量k和值向量v。与之前类似,我们将第二个输人元素x2指定为查询输人。查询向量q2是通过第二个输入元素x2与权重矩阵Wq之间的矩阵乘法得到的。同样,我们通过包含权重矩阵Wk和Wv的矩阵乘法得到键向量和值向量。
计算一个上下文向量,仍然需要所有输入元素的键向量和值向量,因为它们参与计算相对于查询的注意力权重。
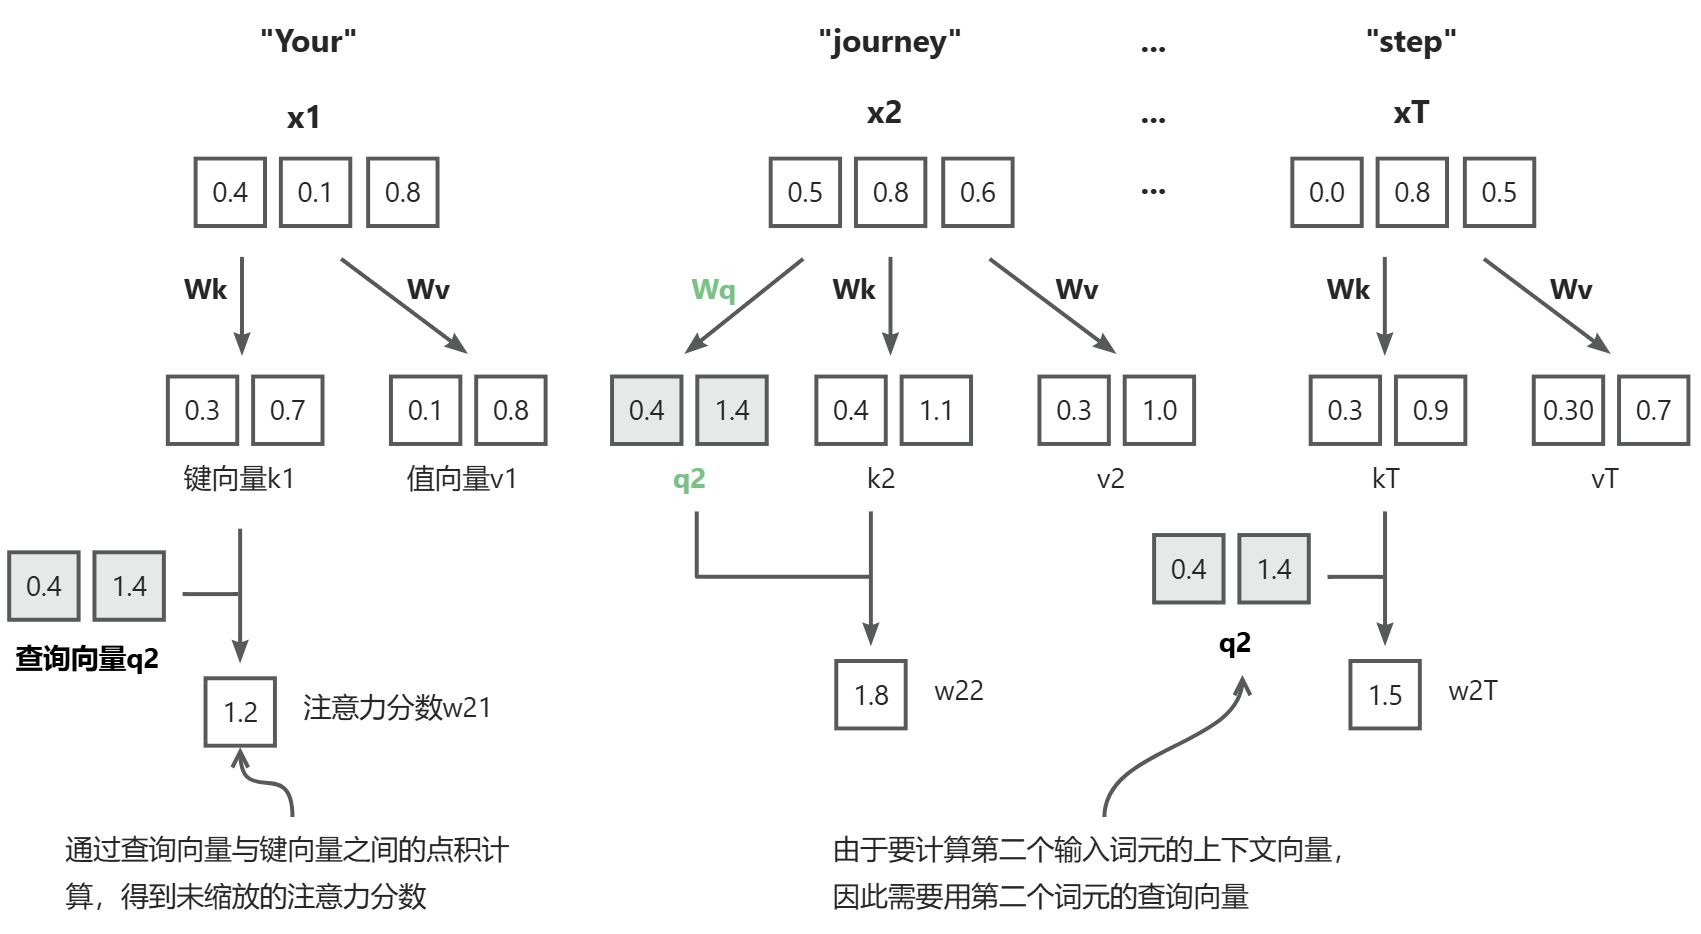
注意力分数的计算是一种点积计算。与简单自注意力中计算注意力分数直接计算输入元素之间的点积的方式不同,在这里,我们使用通过各自权重矩阵变换后的查询向量和键向量进行计算。
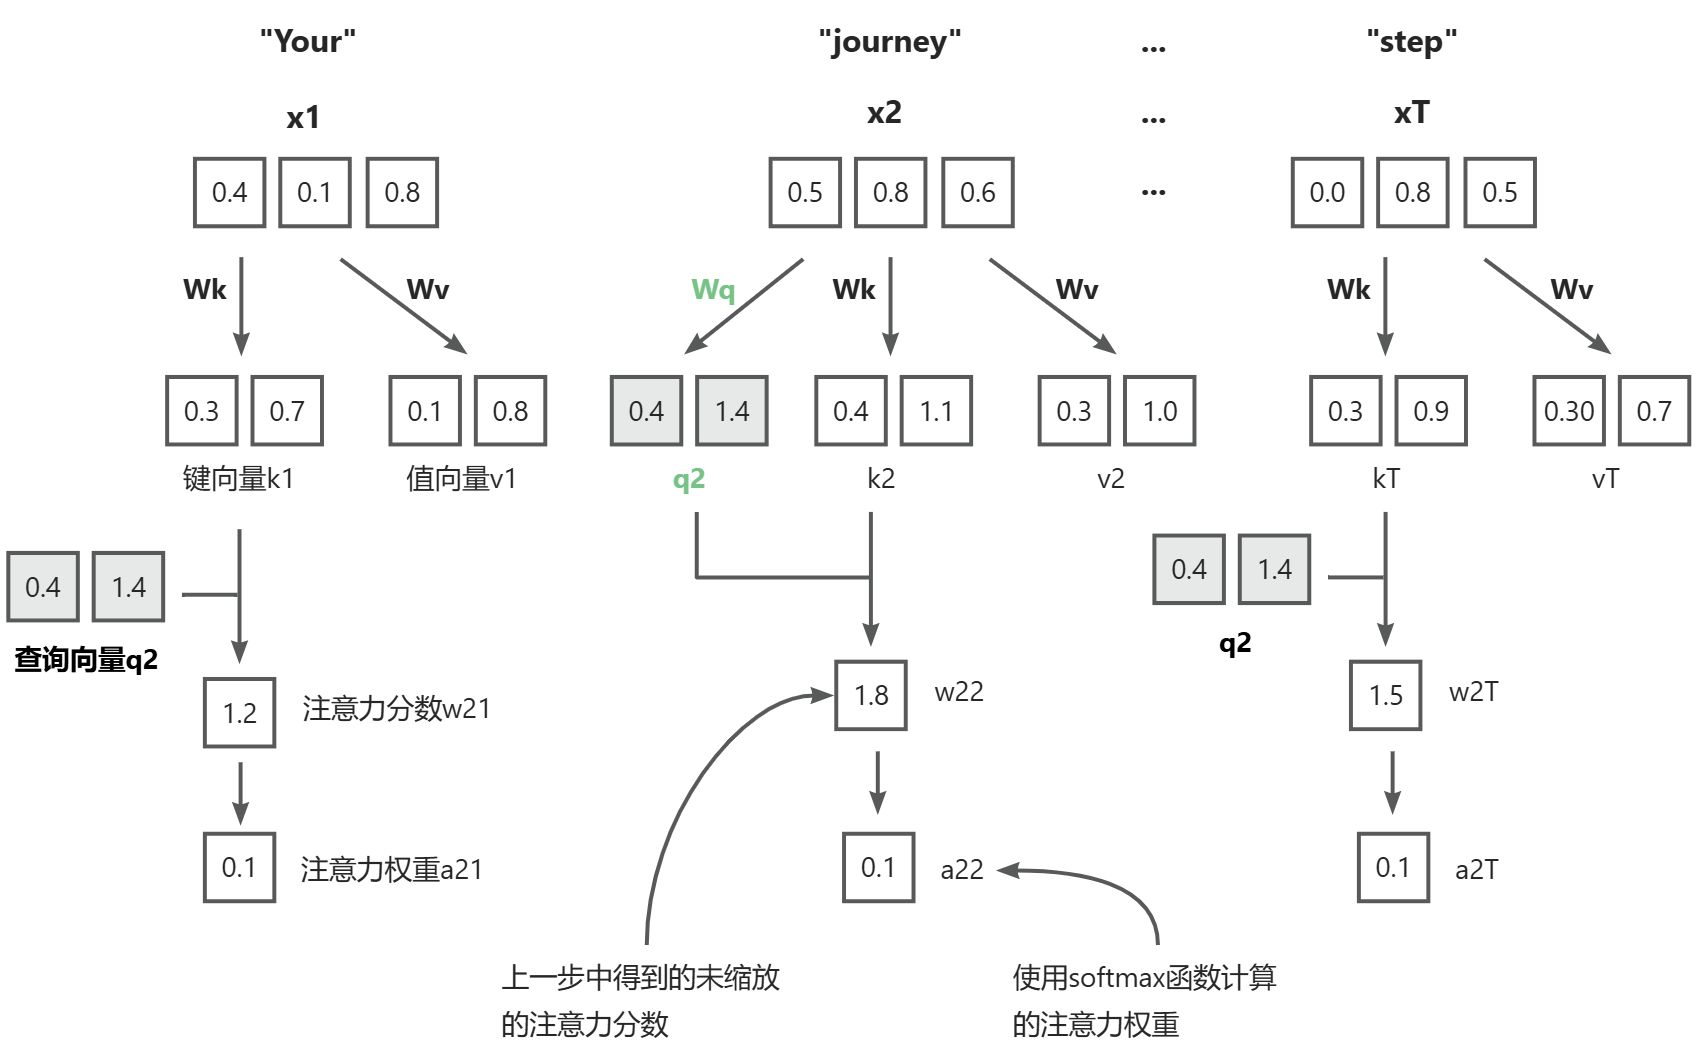
第二步,我们要将注意力分数转换为注意力权重,如下图所示。我们通过缩放注意力分数并应用 softmax 函数来计算注意力权重。不过,此时是通过将注意力分数除以键向量的嵌入维度的平方根来进行缩放(取平方根在数学上等同于以 0.5 为指数进行幂运算)。对嵌入维度进行归一化是为了避免梯度过小,从而提升训练性能。
最后一步,计算上下文向量,通过对值向量进行加权求和来计算上下文向量。在这里,注意力权重作为加权因子,用于权衡每个值向量的重要性。与简单注意力机制中计算上下文向量的方式类似,现在通过对值向量进行加权求和来计算上下文向量。
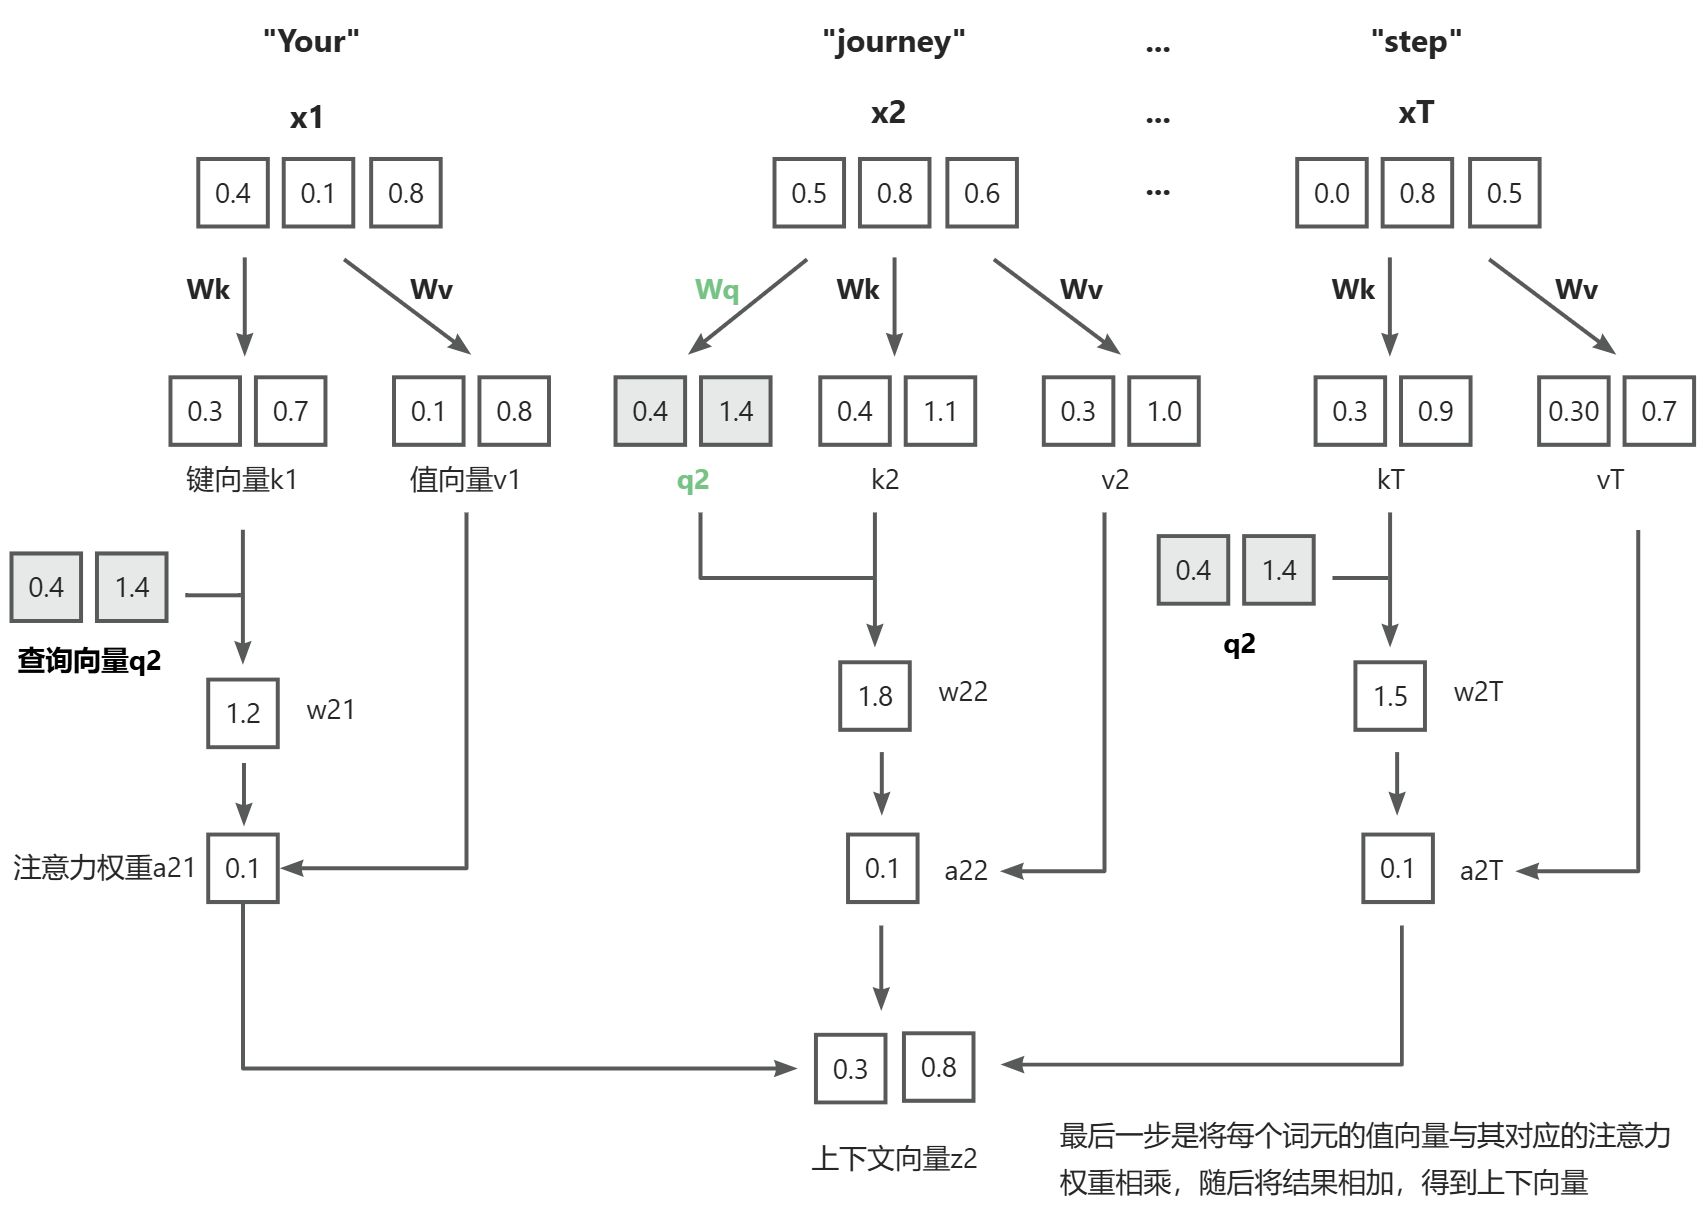
所生成的向量内容如下所示
tensor([0.3061, 0.8210])
在前向传播过程中,我们通过使用 forward 方法将查询向量和键向量相乘来计算注意力分数,然后使用 softmax 对这些分数进行归一化。最后,使用归一化的注意力权重对值向量进行加权和来创建上下文向量。
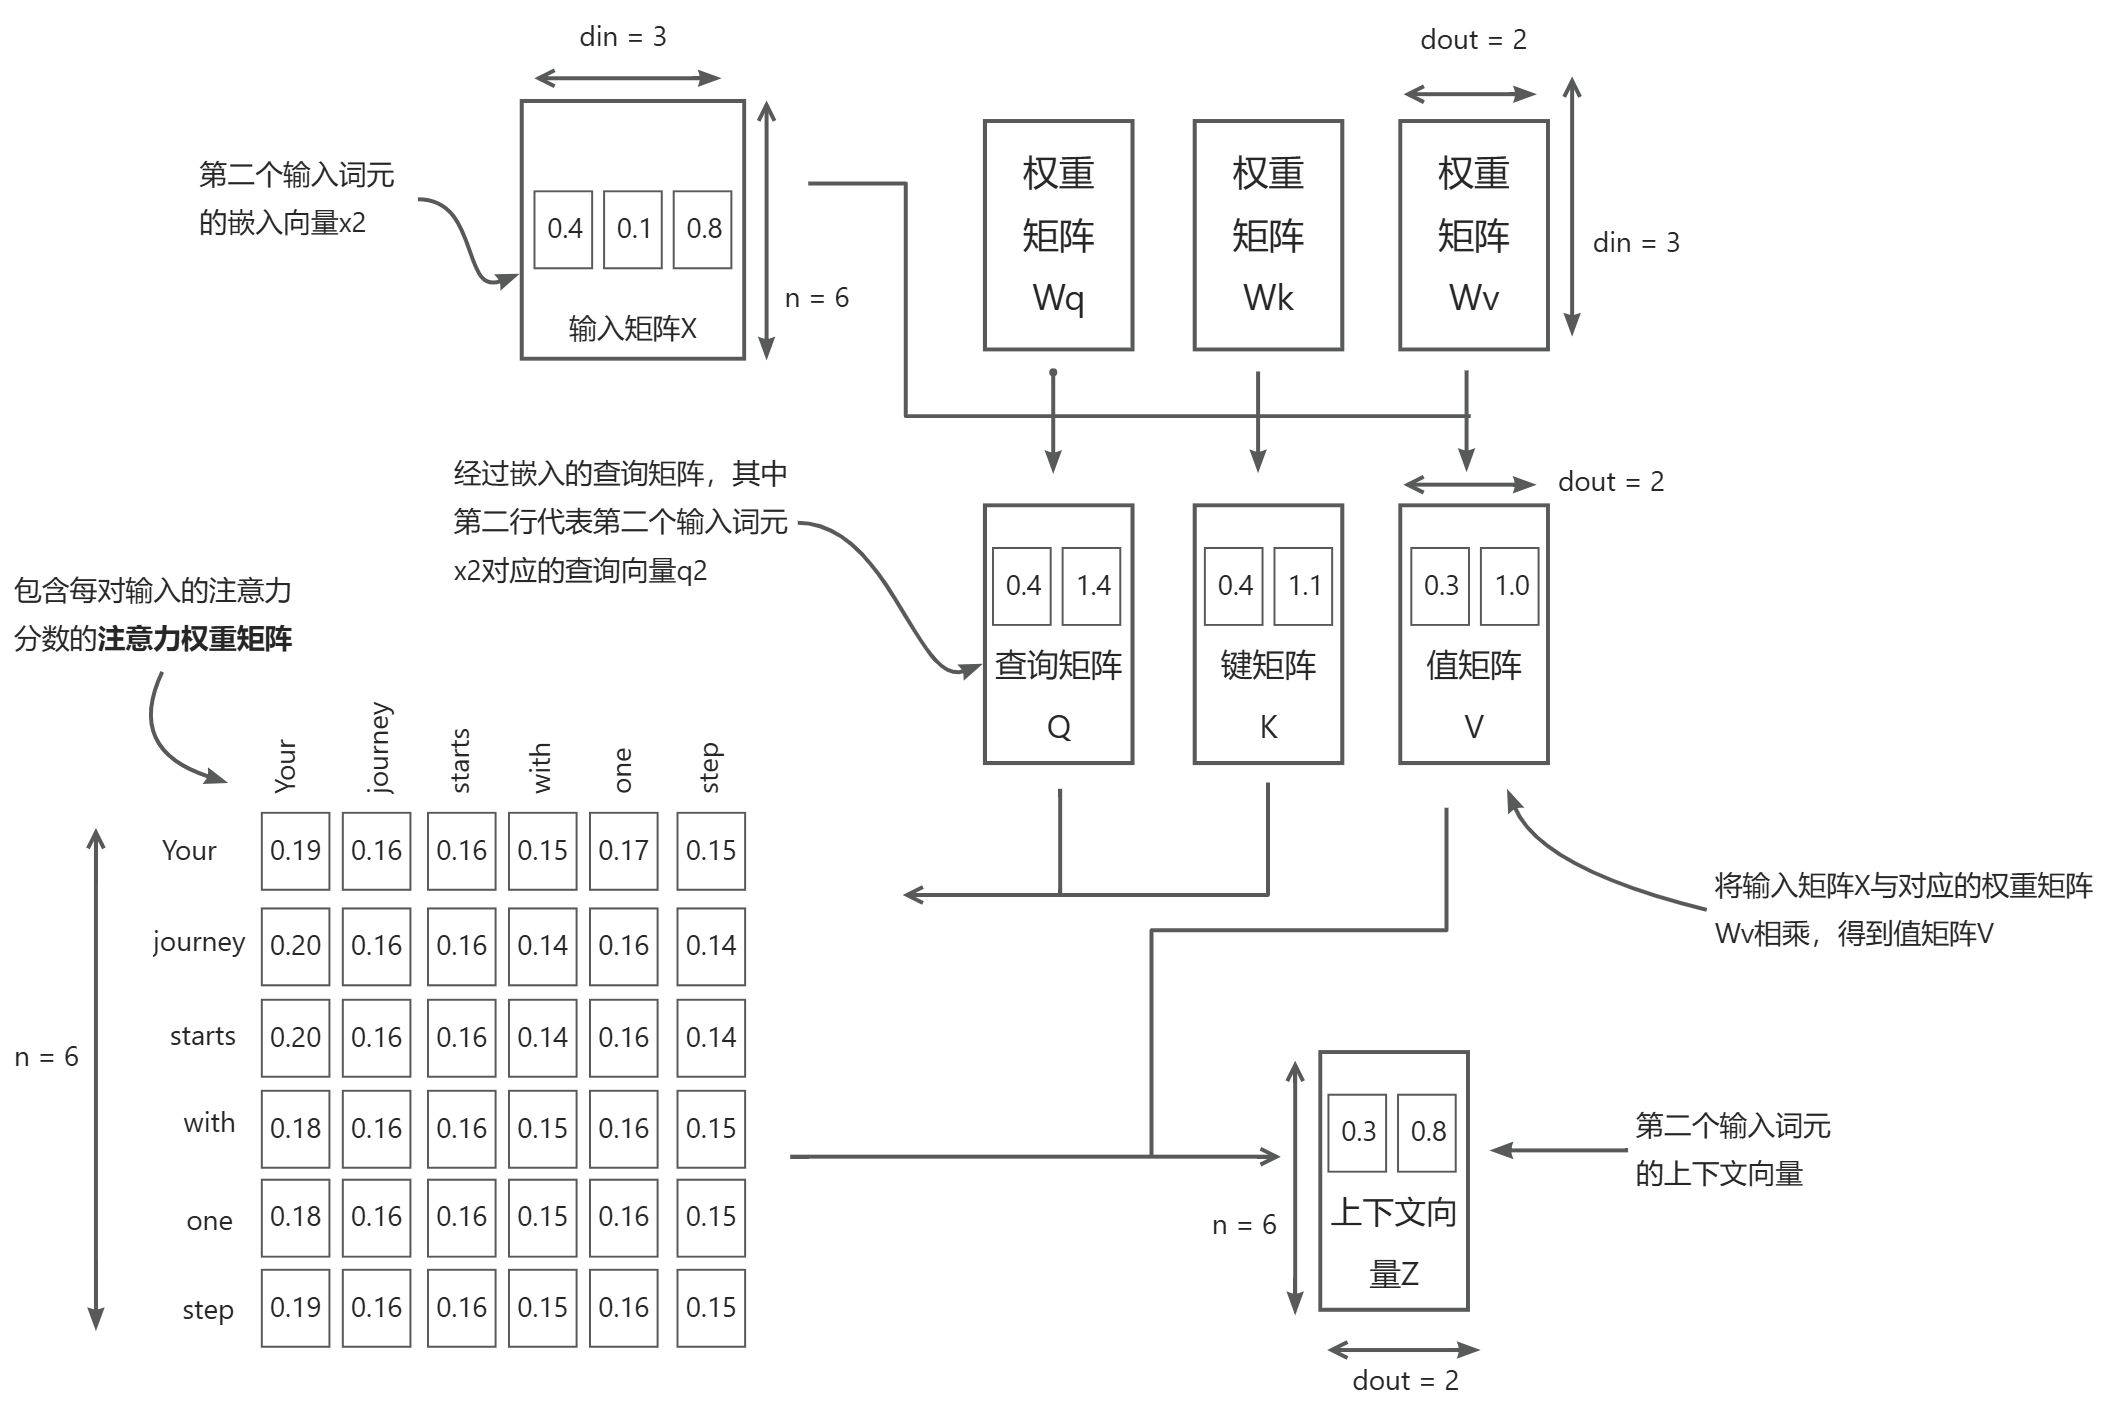
在自注意力机制中,我们用 3 个权重矩阵 Wq、Wk 和 Wv 来变换输入矩阵 X 中的输入向量。首先根据所得查询矩阵(Q)和键矩阵(K)计算注意力权重矩阵。然后,使用注意力权重矩阵和值矩阵(V)计算上下文向量(Z)。
为了视觉清晰,我们关注具有 n个词元的单个输入文本,而不是一批多个输入。因此,在这种情况下,三维输入张量被简化为二维矩阵。这种方法允许更直观地可视化和理解所涉及的过程。为了与后面的图保持一致,注意力矩阵中的值不代表真正的注意力权重(该图中的数值被截断为小数点后两位,以减少视觉混乱。每行中的值加起来应为 1.0 或 100%。)
自注意力机制包含可训练的权重矩阵Wq、Wk和Wv。这些矩阵将输入数据转换为查询向量、键向量和值向量。这些矩阵在注意力机制中至关重要。随着模型在训练中接触更多数据,模型会调整这些可训练的权重。
参考
《从零构建大模型》
更多推荐


 44
 0
- 0


 已为社区贡献7条内容

所有评论(0)