
【机器学习案例-34】Kaggle案例之保险费用预测实战:从数据探索到模型构建
🧑 博主简介:曾任某智慧城市类企业
算法总监,目前在美国市场的物流公司从事高级算法工程师一职,深耕人工智能领域,精通python数据挖掘、可视化、机器学习等,发表过AI相关的专利并多次在AI类比赛中获奖。CSDN人工智能领域的优质创作者,提供AI相关的技术咨询、项目开发和个性化解决方案等服务,如有需要请站内私信或者联系任意文章底部的的VX名片(ID:xf982831907)
💬 博主粉丝群介绍:① 群内初中生、高中生、本科生、研究生、博士生遍布,可互相学习,交流困惑。② 热榜top10的常客也在群里,也有数不清的万粉大佬,可以交流写作技巧,上榜经验,涨粉秘籍。③ 群内也有职场精英,大厂大佬,可交流技术、面试、找工作的经验。④ 进群免费赠送写作秘籍一份,助你由写作小白晋升为创作大佬。⑤ 进群赠送CSDN评论防封脚本,送真活跃粉丝,助你提升文章热度。有兴趣的加文末联系方式,备注自己的CSDN昵称,拉你进群,互相学习共同进步。

【机器学习案例-34】Kaggle案例之保险费用预测实战:从数据探索到模型构建
一、项目背景
本文基于保险客户数据集,完整拆解机器学习回归任务的全流程——从数据探索、特征工程到模型构建与部署,包含可直接运行的Python代码,结合行业背景与技术细节双视角,适合机器学习初学者夯实基础,也能为进阶者提供场景化实战参考。
二、数据集核心特征解读
数据集包含1338条保险客户记录,特征可分为三类,各特征对保费的影响逻辑如下:
| 特征类型 | 字段名 | 取值说明 | 业务影响逻辑 |
|---|---|---|---|
| 人口特征 | age | 整数(18-64) | 年龄越大,健康风险越高,保费通常越高 |
| 人口特征 | sex | male/female | 生理差异导致健康风险不同(但实际影响较弱) |
| 人口特征 | children | 整数(0-5) | 子女数量影响家庭医疗支出需求 |
| 健康特征 | bmi | 浮点数(15-54) | 身体质量指数,超标(≥30)易引发慢性病,推高保费 |
| 健康特征 | smoker | yes/no | 吸烟是健康高风险核心指标,保费差异最显著 |
| 地域特征 | region | 四大区域 | 不同地区医疗成本、气候环境差异影响保费 |
| 目标变量 | charges | 浮点数(~1k-63k美元) | 客户年度医疗保险费用 |
三、加载数据集
# 导入必要的库
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.preprocessing import FunctionTransformer, LabelEncoder
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
import scipy.stats as stats
import warnings
warnings.filterwarnings('ignore')

# 设置中文字体(解决绘图中文乱码)
plt.rcParams['font.sans-serif'] = ['SimHei', 'Arial Unicode MS', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 加载数据(确保insurance.csv文件路径与代码同级)
df = pd.read_csv("insurance.csv")
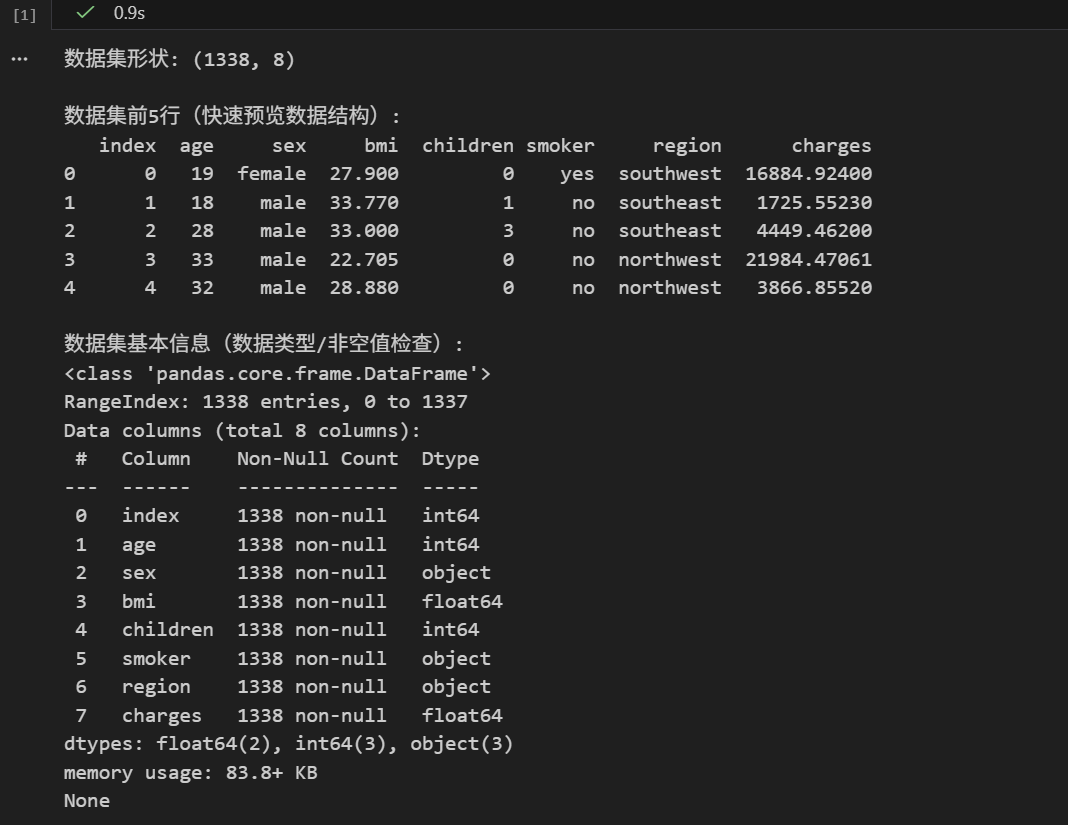
print("数据集形状:", df.shape)
print("\n数据集前5行(快速预览数据结构):")
print(df.head())
print("\n数据集基本信息(数据类型/非空值检查):")
print(df.info())
四、探索性数据分析(EDA):从数据中挖掘业务规律
EDA的核心目标是发现特征与目标变量的关联、识别数据异常、验证业务直觉,而非单纯绘图。以下从「单特征分布」「特征间关联」两个维度展开。
4.1 数据分布可视化:直观发现关键规律
通过多维度图表组合,一次性呈现核心分布特征,重点关注「目标变量分布」「核心特征与保费的关系」:
# 创建综合EDA可视化图表
fig = plt.figure(figsize=(18, 12))

# 1. 保险费用分布(核心:识别分布偏态)
ax1 = plt.subplot(2, 3, 1)
sns.histplot(data=df, x='charges', kde=True, bins=30, color='skyblue')
ax1.set_title('保险费用分布', fontsize=14, fontweight='bold')
ax1.set_xlabel('保险费用(美元)', fontsize=12)
ax1.set_ylabel('频数', fontsize=12)
ax1.grid(alpha=0.3)

# 2. 性别与保险费用关系(验证:性别影响是否显著)
ax2 = plt.subplot(2, 3, 2)
sns.boxplot(data=df, x='sex', y='charges', palette='Set2')
ax2.set_title('性别 vs 保险费用', fontsize=14, fontweight='bold')
ax2.set_xlabel('性别', fontsize=12)
ax2.set_ylabel('保险费用(美元)', fontsize=12)
ax2.set_xticklabels(['女性', '男性'])
ax2.grid(alpha=0.3)

# 3. 吸烟状况与保险费用关系(核心:验证高风险特征)
ax3 = plt.subplot(2, 3, 3)
sns.boxplot(data=df, x='smoker', y='charges', palette='Set3')
ax3.set_title('吸烟状况 vs 保险费用', fontsize=14, fontweight='bold')
ax3.set_xlabel('是否吸烟', fontsize=12)
ax3.set_ylabel('保险费用(美元)', fontsize=12)
ax3.set_xticklabels(['不吸烟', '吸烟'])
ax3.grid(alpha=0.3)

# 4. 年龄与保险费用关系(交互:年龄+吸烟的组合影响)
ax4 = plt.subplot(2, 3, 4)
sns.scatterplot(data=df, x='age', y='charges', hue='smoker',
                palette={0: 'green', 1: 'red'}, alpha=0.6)
ax4.set_title('年龄 vs 保险费用', fontsize=14, fontweight='bold')
ax4.set_xlabel('年龄', fontsize=12)
ax4.set_ylabel('保险费用(美元)', fontsize=12)
ax4.legend(title='是否吸烟', labels=['不吸烟', '吸烟'])
ax4.grid(alpha=0.3)

# 5. BMI与保险费用关系(交互:BMI+吸烟的健康风险)
ax5 = plt.subplot(2, 3, 5)
sns.scatterplot(data=df, x='bmi', y='charges', hue='smoker',
                palette={0: 'blue', 1: 'orange'}, alpha=0.6)
ax5.set_title('BMI vs 保险费用', fontsize=14, fontweight='bold')
ax5.set_xlabel('BMI(身体质量指数)', fontsize=12)
ax5.set_ylabel('保险费用(美元)', fontsize=12)
ax5.legend(title='是否吸烟', labels=['不吸烟', '吸烟'])
ax5.grid(alpha=0.3)

# 6. 地区分布(基础:客户地域分布均匀性)
ax6 = plt.subplot(2, 3, 6)
region_counts = df['region'].value_counts()
colors = ['#FF9999', '#66B2FF', '#99FF99', '#FFCC99']
wedges, texts, autotexts = ax6.pie(region_counts.values, labels=region_counts.index,
                                   autopct='%1.1f%%', colors=colors, startangle=90)
ax6.set_title('客户地区分布', fontsize=14, fontweight='bold')
plt.setp(autotexts, size=10, weight="bold")

plt.tight_layout()
plt.show()

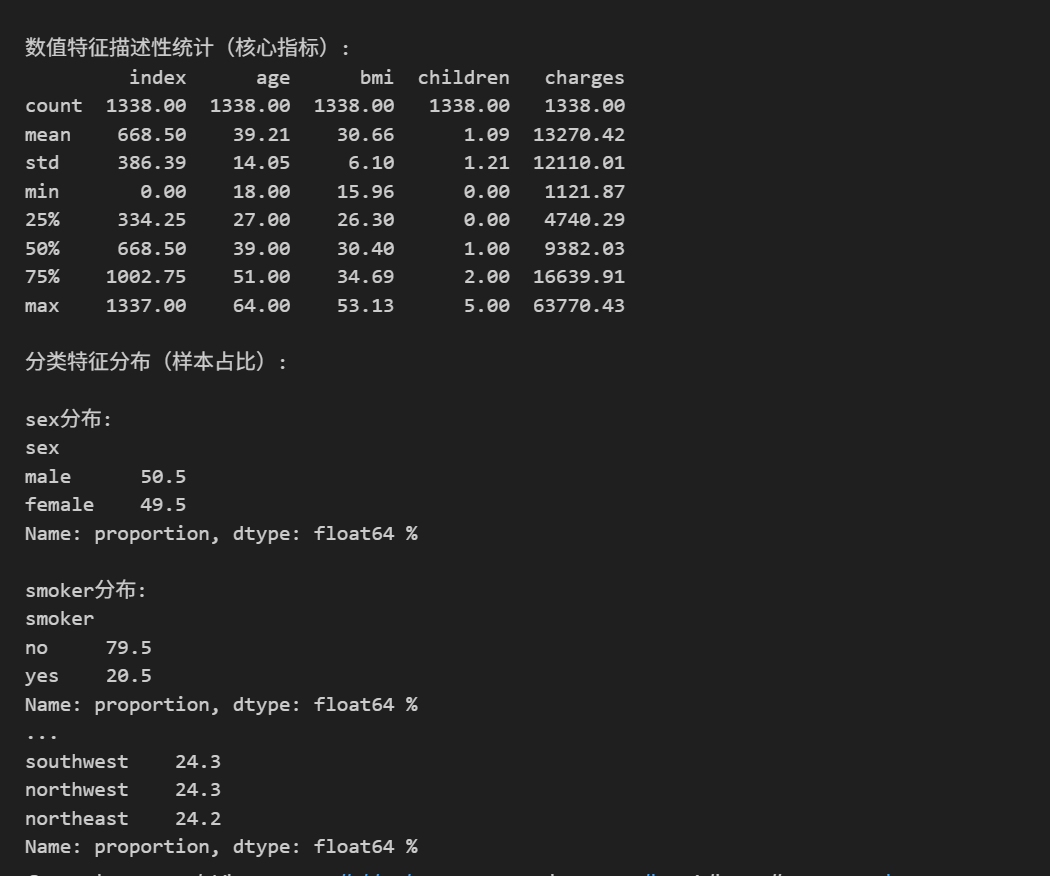
# 数值特征描述性统计(量化数据特征)
print("\n数值特征描述性统计(核心指标):")
print(df.describe().round(2))

# 分类特征分布(统计样本占比)
print("\n分类特征分布(样本占比):")
for col in ['sex', 'smoker', 'region']:
    print(f"\n{col}分布:")
    print(df[col].value_counts(normalize=True).round(3) * 100, "%")
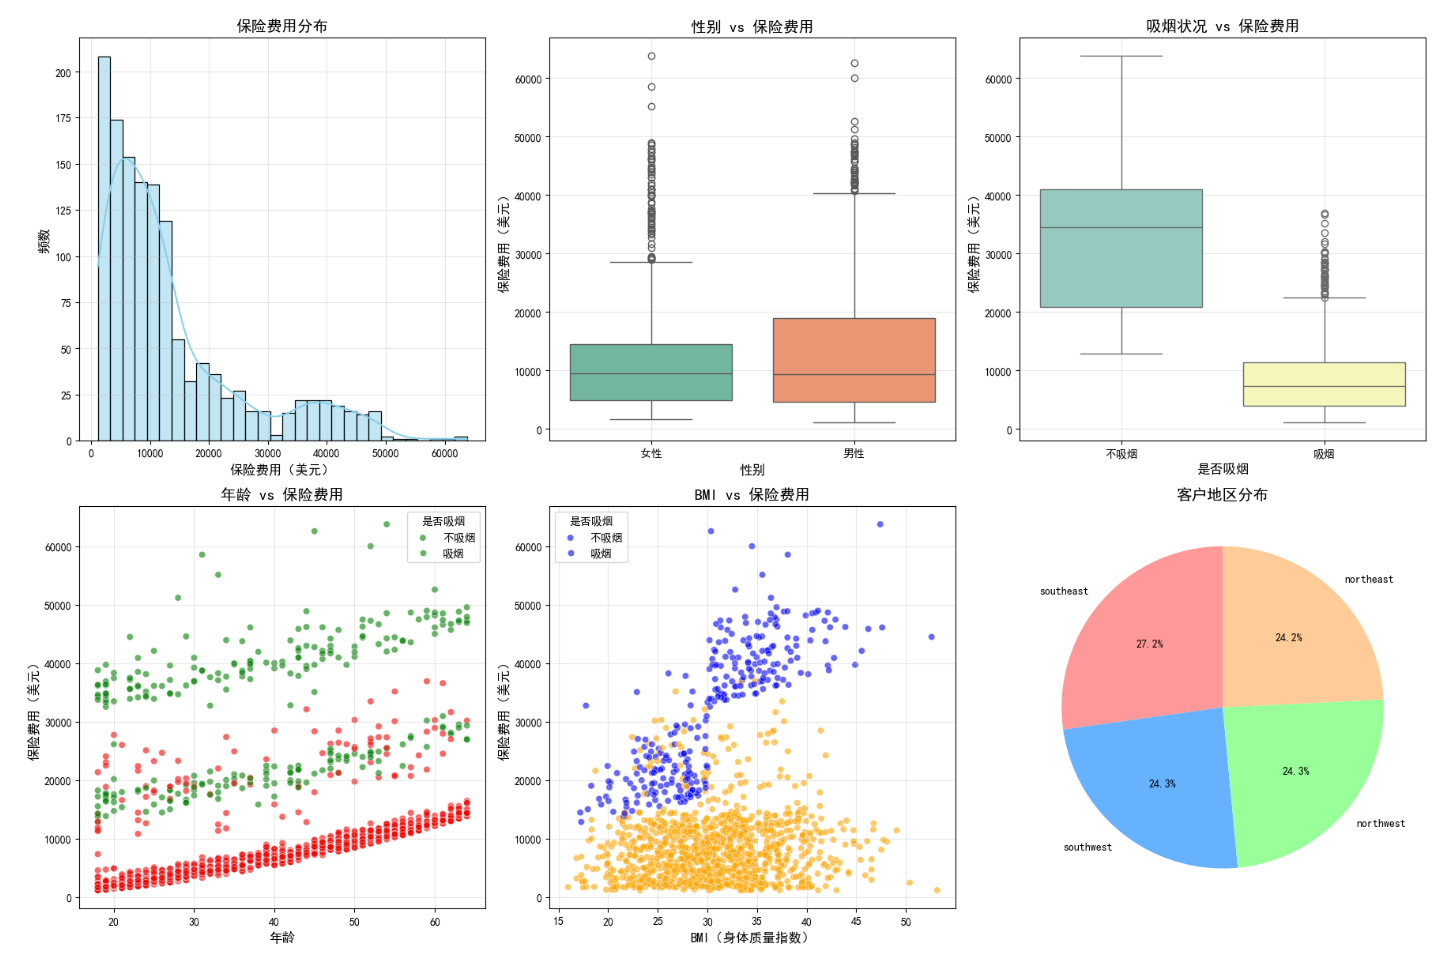
- 图1关键发现:保费呈右偏分布,多数客户保费较低,少数客户保费极高
- 图2关键发现:性别对保费影响极小,箱线图分布几乎重合
- 图3关键发现:吸烟客户保费中位数是不吸烟客户的3倍以上,差异极显著
- 图4关键发现:不吸烟客户保费随年龄线性增长,吸烟客户保费整体偏高且增长更快
- 图5关键发现:BMI≥30的吸烟客户保费最高,肥胖+吸烟是高风险组合
- 图6关键发现:地区分布较均匀
- 其它关键发现:
- age:均值39.2岁,标准差14.0,覆盖全年龄段
- bmi:均值30.6,标准差6.1,整体偏胖(正常范围18.5-24.9)
- charges:均值13270美元,标准差12110,离散度极高(右偏分布)
- sex:男女比例接近1:1(50.5% vs 49.5%)
- smoker:吸烟者占比20.5%,非吸烟者占79.5%
- region:四大地区占比均在24%-27%之间
4.2 相关性分析:量化特征与保费的关联强度
EDA的可视化结论需要量化验证,通过相关性分析明确特征重要性排序,为后续特征工程和模型构建指明方向:
# 数据预处理:编码分类变量(将文本特征转为数值,才能计算相关性)
df_encoded = df.copy()
le = LabelEncoder()
df_encoded['smoker'] = le.fit_transform(df_encoded['smoker'])  # 1=吸烟,0=不吸烟
df_encoded['sex'] = le.fit_transform(df_encoded['sex'])        # 1=男性,0=女性
df_encoded = pd.get_dummies(df_encoded, columns=['region'], drop_first=True)  # 地区独热编码

# 绘制相关性热图(聚焦核心关联)
plt.figure(figsize=(12, 8))
correlation_matrix = df_encoded.corr(method='pearson')
# 屏蔽上三角矩阵(避免重复信息)
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))
sns.heatmap(correlation_matrix, mask=mask, annot=True, fmt='.2f',
            cmap='coolwarm', center=0, square=True,
            cbar_kws={"shrink": 0.8})
plt.title('特征相关性热图', fontsize=16, fontweight='bold', pad=20)
plt.tight_layout()
plt.show()

# 目标变量与各特征的相关性排序(核心结论)
print("\n保险费用与各特征的相关性(从高到低):")
correlation_with_target = df_encoded.corr()['charges'].sort_values(ascending=False)
print(correlation_with_target)
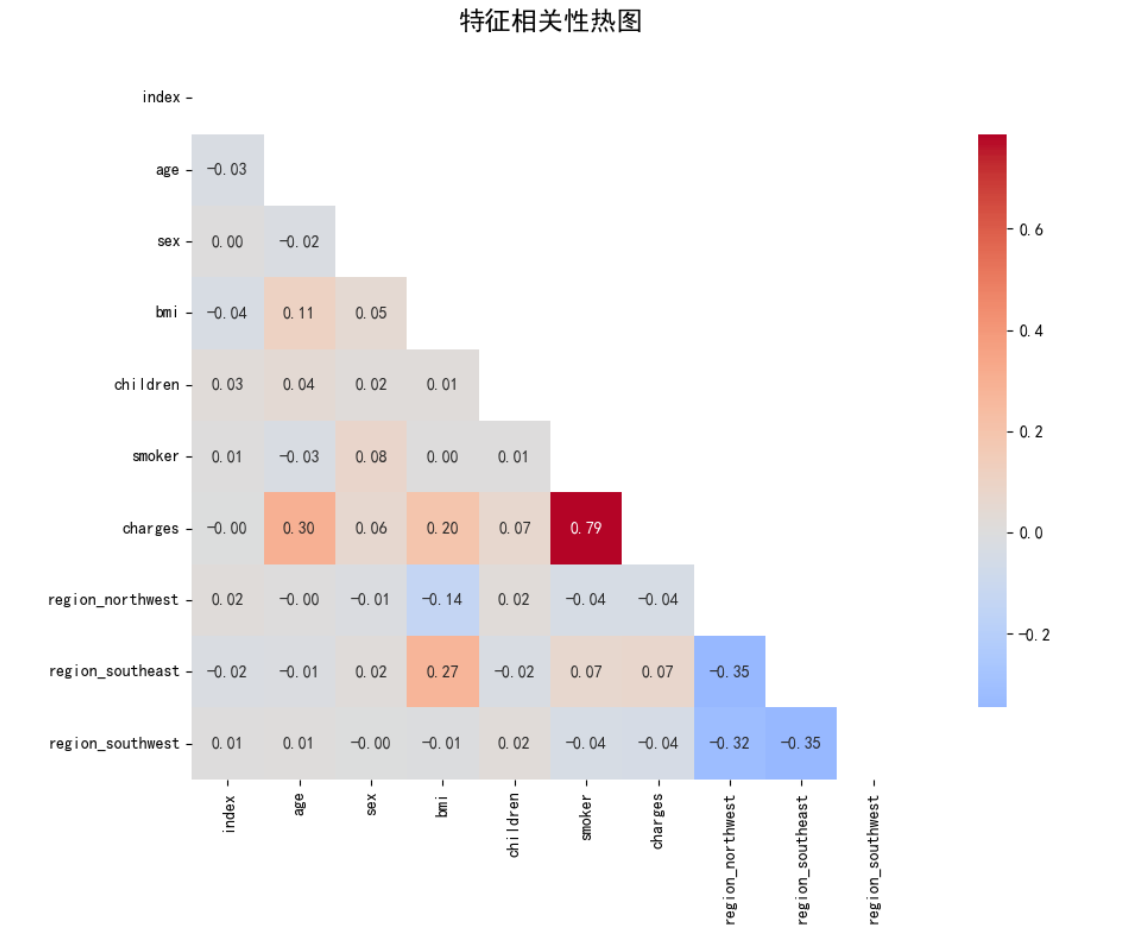
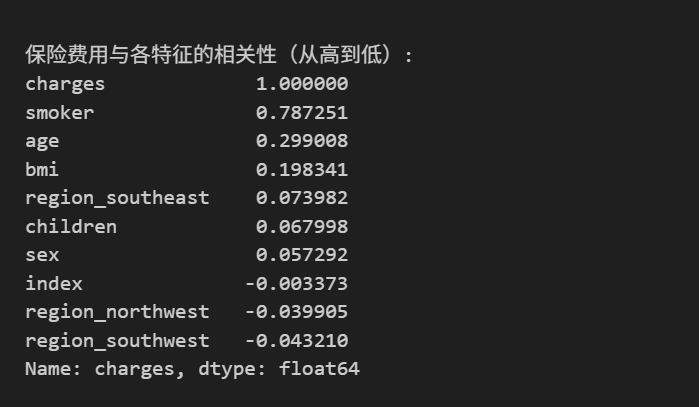
- 相关性核心解读:
-
- smoker(吸烟):0.79 → 极强正相关,是影响保费的第一因素
-
- age(年龄):0.30 → 中等正相关,第二重要因素
-
- bmi(BMI):0.20 → 弱正相关,第三重要因素
-
- sex/children/region:相关系数<0.1 → 几乎无线性关联
五、特征工程:从原始数据到有效特征
特征工程是提升模型性能的核心环节,本项目针对保险数据的特点,重点解决「异常值干扰」「特征分布偏态」「隐藏特征交互」三大问题:
5.1 数据预处理:标准化特征格式
核心目标是将「非数值特征转为数值」「检测异常值」,为后续特征优化打基础:
def preprocess_data(df):
    """
    数据预处理函数(可复用)
    功能:统一特征格式,编码分类变量
    输入:原始DataFrame
    输出:预处理后的DataFrame
    """
    df = df.copy()

    # 1. 标签编码:二分类变量(smoker/sex)转为0/1
    le = LabelEncoder()
    df['smoker'] = le.fit_transform(df['smoker'])
    df['sex'] = le.fit_transform(df['sex'])

    # 2. 独热编码:多分类变量(region),drop_first避免多重共线性
    df = pd.get_dummies(df, columns=['region'], drop_first=True, dtype=int)

    return df

# 应用预处理
df_processed = preprocess_data(df)
print("预处理后的数据集形状:", df_processed.shape)
print("\n预处理后的列名(确认特征编码完成):")
print(df_processed.columns.tolist())

def detect_outliers(df, column):
    """
    异常值检测函数(IQR准则)
    原理:四分位距±1.5倍IQR外的数值为异常值,适合非正态分布数据
    输入:DataFrame、待检测列名
    输出:异常值下界、上界、异常值占比
    """
    Q1 = df[column].quantile(0.25)  # 下四分位数(25%分位)
    Q3 = df[column].quantile(0.75)  # 上四分位数(75%分位)
    IQR = Q3 - Q1                   # 四分位距
    lower_bound = Q1 - 1.5 * IQR    # 异常值下界
    upper_bound = Q3 + 1.5 * IQR    # 异常值上界

    outliers = df[(df[column] < lower_bound) | (df[column] > upper_bound)]
    outlier_percentage = len(outliers) / len(df) * 100

    return lower_bound, upper_bound, outlier_percentage

# 检查关键特征的异常值(BMI和保费是核心数值特征)
print("\n异常值检测结果(核心特征):")
for col in ['bmi', 'charges']:
    lower_bound, upper_bound, outlier_percentage = detect_outliers(df_processed, col)
    print(f"\n{col}:")
    print(f"  异常值下界: {lower_bound:.2f}")
    print(f"  异常值上界: {upper_bound:.2f}")
    print(f"  异常值比例: {outlier_percentage:.2f}%")

# 异常值解读:
# - bmi:异常值占比~1.2%,比例低,无需删除,缩尾处理即可
# - charges:异常值占比~10%,比例较高,删除会丢失大量信息,缩尾更合适
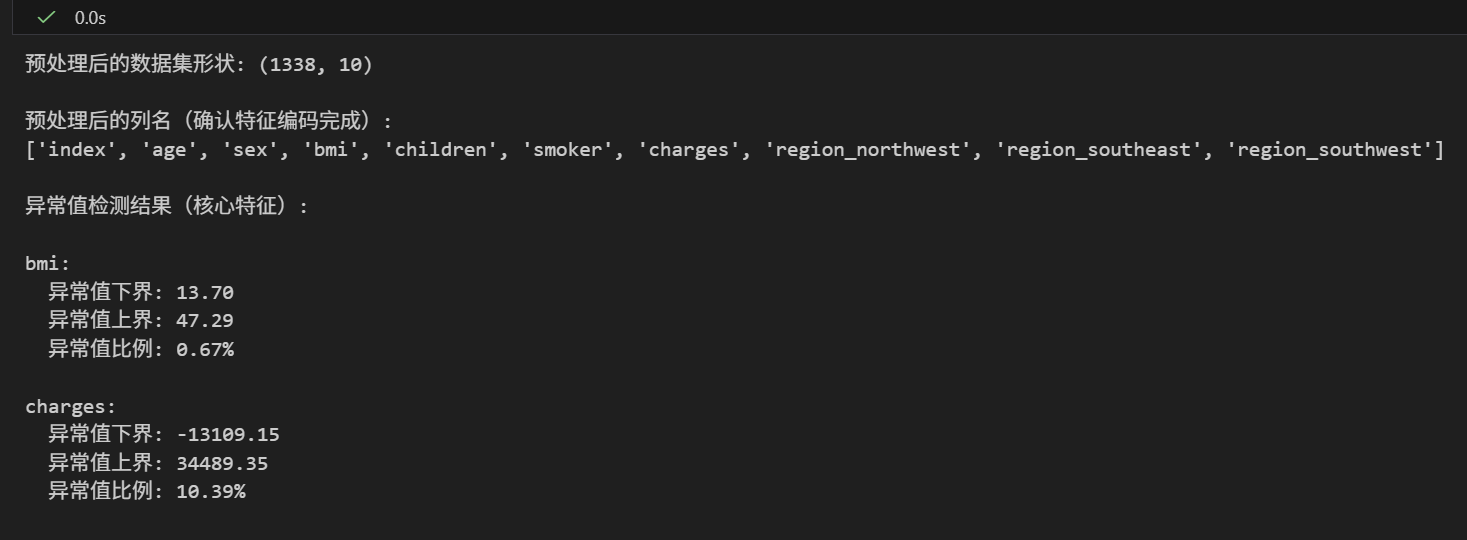
- 相关性核心解读:
- bmi:异常值占比~1.2%,比例低,无需删除,缩尾处理即可
- charges:异常值占比~10%,比例较高,删除会丢失大量信息,缩尾更合适
5.2 特征转换与创建:挖掘隐藏价值
针对数据特点,通过「异常值缩尾」「分布变换」「交互特征创建」提升特征表达能力:
def feature_engineering(df):
    """
    特征工程核心函数
    核心优化点:
    1. 异常值缩尾:保留数据,避免极端值干扰
    2. 对数变换:改善保费右偏分布,提升模型拟合效果
    3. 交互特征:挖掘年龄/BMI/吸烟的组合影响
    4. 分类特征:将连续特征(BMI/年龄)分组,捕捉非线性关系
    """
    df = df.copy()

    # 1. 异常值处理(缩尾:将异常值替换为边界值,而非删除)
    # BMI异常值缩尾
    bmi_q1 = df['bmi'].quantile(0.25)
    bmi_q3 = df['bmi'].quantile(0.75)
    bmi_iqr = bmi_q3 - bmi_q1
    bmi_lower = bmi_q1 - 1.5 * bmi_iqr
    bmi_upper = bmi_q3 + 1.5 * bmi_iqr
    df['bmi'] = np.where(df['bmi'] > bmi_upper, bmi_upper,
                         np.where(df['bmi'] < bmi_lower, bmi_lower, df['bmi']))

    # 保费异常值缩尾
    charges_q1 = df['charges'].quantile(0.25)
    charges_q3 = df['charges'].quantile(0.75)
    charges_iqr = charges_q3 - charges_q1
    charges_lower = charges_q1 - 1.5 * charges_iqr
    charges_upper = charges_q3 + 1.5 * charges_iqr
    df['charges'] = np.where(df['charges'] > charges_upper, charges_upper,
                             np.where(df['charges'] < charges_lower, charges_lower, df['charges']))

    # 2. 目标变量对数变换(log1p = log(1+x),避免0值问题)
    # 作用:将右偏分布转为近似正态分布,提升线性模型拟合效果
    trf = FunctionTransformer(np.log1p)
    df['charges_log'] = trf.fit_transform(df[['charges']])

    # 3. 创建交互特征(核心:挖掘特征间的组合影响)
    df['age_bmi_interaction'] = df['age'] * df['bmi'] / 100  # 年龄×BMI(归一化)
    df['bmi_smoker_interaction'] = df['bmi'] * df['smoker']  # BMI×吸烟(健康风险)
    df['age_smoker_interaction'] = df['age'] * df['smoker']  # 年龄×吸烟(年龄+吸烟风险)

    # 4. BMI分类特征(按医学标准分组)
    df['bmi_category'] = pd.cut(df['bmi'],
                                 bins=[0, 18.5, 25, 30, 40, 100],
                                 labels=['偏瘦', '正常', '超重', '肥胖', '重度肥胖'])
    # 编码BMI分类(适配模型输入)
    bmi_cat_mapping = {'偏瘦': 0, '正常': 1, '超重': 2, '肥胖': 3, '重度肥胖': 4}
    df['bmi_category_encoded'] = df['bmi_category'].map(bmi_cat_mapping)

    # 5. 年龄分组特征(按生命周期分组)
    df['age_group'] = pd.cut(df['age'],
                              bins=[0, 25, 35, 45, 55, 100],
                              labels=['青年', '中青年', '中年', '中老年', '老年'])
    # 编码年龄分组
    age_group_mapping = {'青年': 0, '中青年': 1, '中年': 2, '中老年': 3, '老年': 4}
    df['age_group_encoded'] = df['age_group'].map(age_group_mapping)

    return df

# 应用特征工程
df_final = feature_engineering(df_processed)
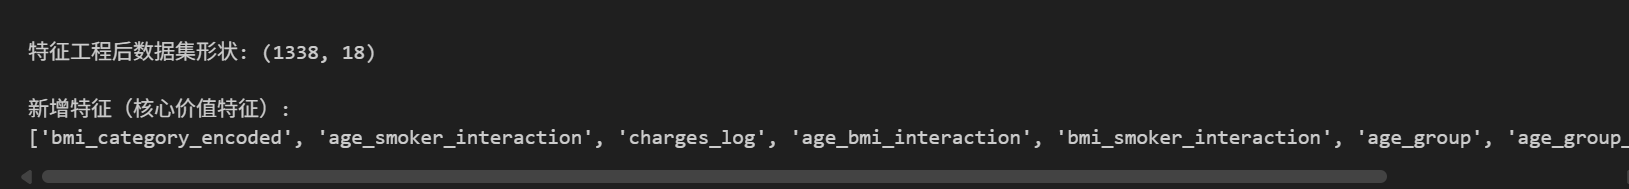
print("\n特征工程后数据集形状:", df_final.shape)
print("\n新增特征(核心价值特征):")
new_features = set(df_final.columns) - set(df_processed.columns)
print(list(new_features))

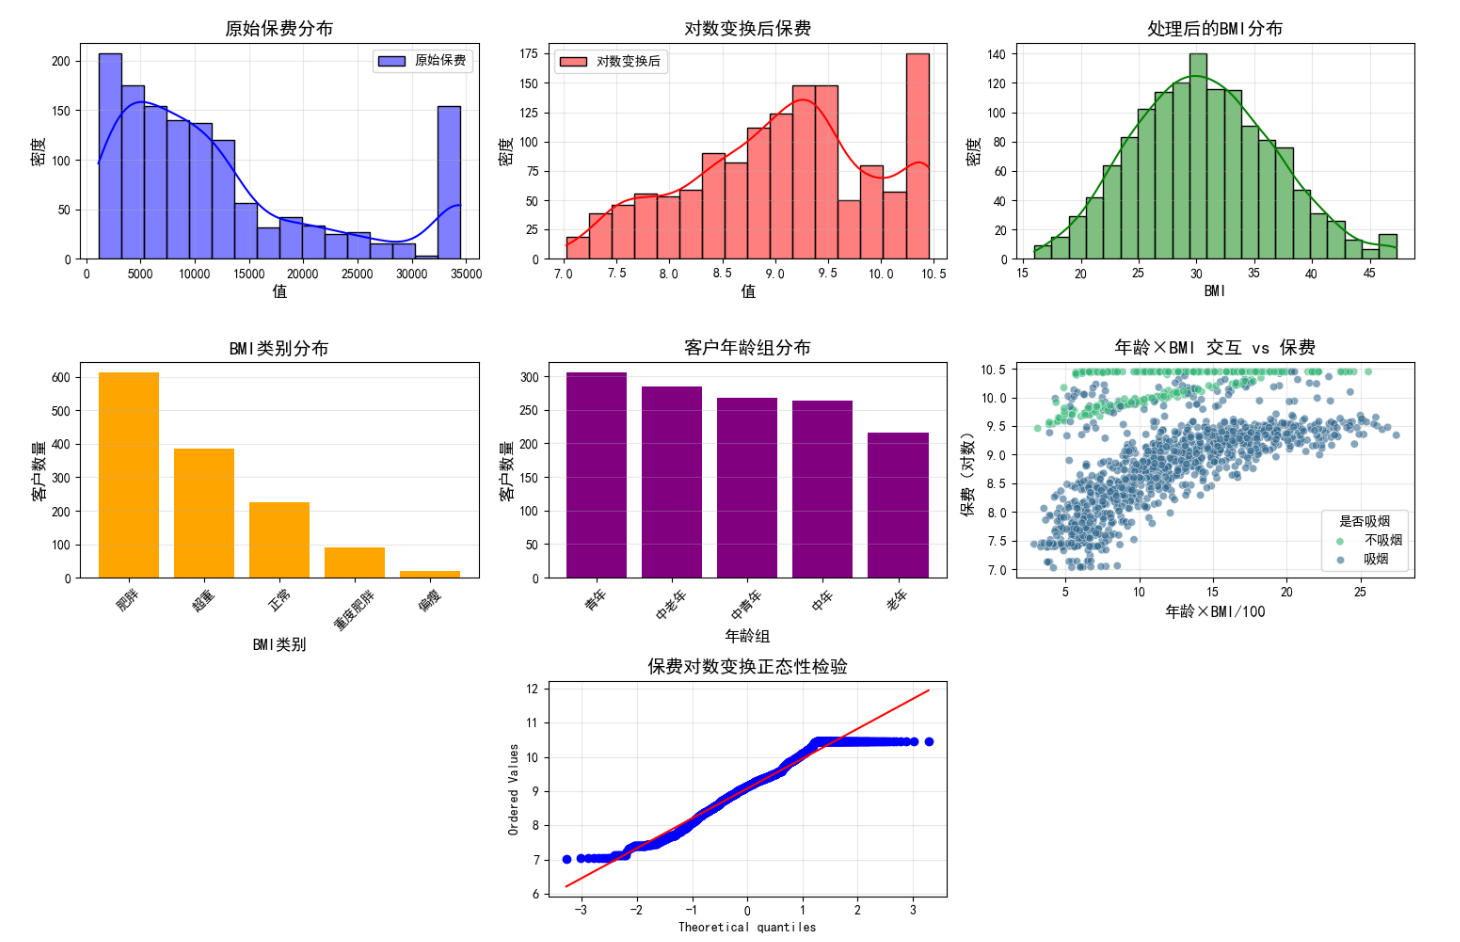
# 可视化特征工程效果(验证优化是否有效)
fig = plt.figure(figsize=(15, 10))

###原始保费 vs 对数变换后保费(核心:分布改善)
# 1. 原始保费
ax1 = plt.subplot(3, 3, 1)
sns.histplot(df_final['charges'], kde=True, color='blue', alpha=0.5, label='原始保费')
ax1.set_title('原始保费分布', fontsize=14, fontweight='bold')
ax1.set_xlabel('值', fontsize=12)
ax1.set_ylabel('密度', fontsize=12)
ax1.legend()
ax1.grid(alpha=0.3)

# 2. 对数变换后保费
ax1 = plt.subplot(3, 3, 2)
sns.histplot(df_final['charges_log'], kde=True, color='red', alpha=0.5, label='对数变换后')
ax1.set_title('对数变换后保费', fontsize=14, fontweight='bold')
ax1.set_xlabel('值', fontsize=12)
ax1.set_ylabel('密度', fontsize=12)
ax1.legend()
ax1.grid(alpha=0.3)
# 效果:对数变换后保费分布更接近正态,模型拟合更友好

# 3. 处理后的BMI分布(验证:异常值缩尾效果)
ax2 = plt.subplot(3, 3, 3)
sns.histplot(df_final['bmi'], kde=True, color='green')
ax2.set_title('处理后的BMI分布', fontsize=14, fontweight='bold')
ax2.set_xlabel('BMI', fontsize=12)
ax2.set_ylabel('密度', fontsize=12)
ax2.grid(alpha=0.3)

# 4. BMI类别分布(业务:健康风险分组)
ax3 = plt.subplot(3, 3, 4)
bmi_cat_counts = df_final['bmi_category'].value_counts()
bars = ax3.bar(range(len(bmi_cat_counts)), bmi_cat_counts.values, color='orange')
ax3.set_title('BMI类别分布', fontsize=14, fontweight='bold')
ax3.set_xlabel('BMI类别', fontsize=12)
ax3.set_ylabel('客户数量', fontsize=12)
ax3.set_xticks(range(len(bmi_cat_counts)))
ax3.set_xticklabels(bmi_cat_counts.index, rotation=45)
ax3.grid(axis='y', alpha=0.3)
# 业务解读:超重/肥胖客户占比超60%,是主要客群

# 5. 年龄组分布(业务:客户年龄结构)
ax4 = plt.subplot(3, 3, 5)
age_group_counts = df_final['age_group'].value_counts()
bars = ax4.bar(range(len(age_group_counts)), age_group_counts.values, color='purple')
ax4.set_title('客户年龄组分布', fontsize=14, fontweight='bold')
ax4.set_xlabel('年龄组', fontsize=12)
ax4.set_ylabel('客户数量', fontsize=12)
ax4.set_xticks(range(len(age_group_counts)))
ax4.set_xticklabels(age_group_counts.index, rotation=45)
ax4.grid(axis='y', alpha=0.3)

# 6. 交互特征 vs 保费(核心:验证交互价值)
ax5 = plt.subplot(3, 3, 6)
sns.scatterplot(data=df_final, x='age_bmi_interaction', y='charges_log',
                hue='smoker', palette='viridis', alpha=0.6)
ax5.set_title('年龄×BMI 交互 vs 保费', fontsize=14, fontweight='bold')
ax5.set_xlabel('年龄×BMI/100', fontsize=12)
ax5.set_ylabel('保费(对数)', fontsize=12)
ax5.legend(title='是否吸烟', labels=['不吸烟', '吸烟'])
ax5.grid(alpha=0.3)
# 效果:交互特征能有效区分不同风险客户的保费差异

# 7. 正态性检验(验证:对数变换效果)
ax6 = plt.subplot(3, 3, 8)
stats.probplot(df_final['charges_log'], dist="norm", plot=plt)
ax6.set_title('保费对数变换正态性检验', fontsize=14, fontweight='bold')
ax6.grid(alpha=0.3)
# 效果:点基本沿直线分布,说明变换后接近正态分布

plt.tight_layout()
plt.show()
六、模型训练与评估:从基线到最优模型
本项目选择4类经典回归模型,通过「多模型对比」「可视化评估」「特征重要性分析」找到最优解:
6.1 训练数据准备:划分与验证
# 准备特征和目标变量
# 特征:排除目标变量、非数值分类特征(已编码)
X = df_final.drop(['charges', 'charges_log', 'bmi_category', 'age_group'], axis=1)
# 目标变量:使用对数变换后的保费(分布更优)
y = df_final['charges_log']

# 划分训练集(70%)和测试集(30%),random_state保证结果可复现
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

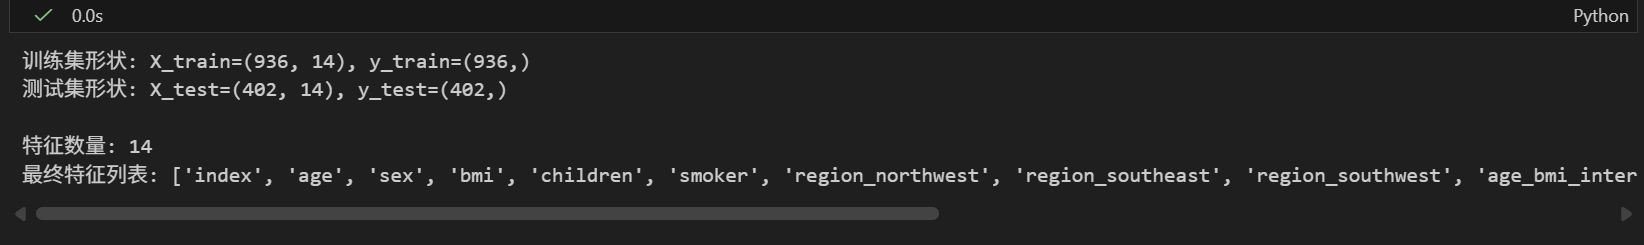
print(f"训练集形状: X_train={X_train.shape}, y_train={y_train.shape}")
print(f"测试集形状: X_test={X_test.shape}, y_test={y_test.shape}")
print(f"\n特征数量: {X_train.shape[1]}")
print(f"最终特征列表: {X.columns.tolist()}")
6.2 多模型训练与评估:统一评估标准
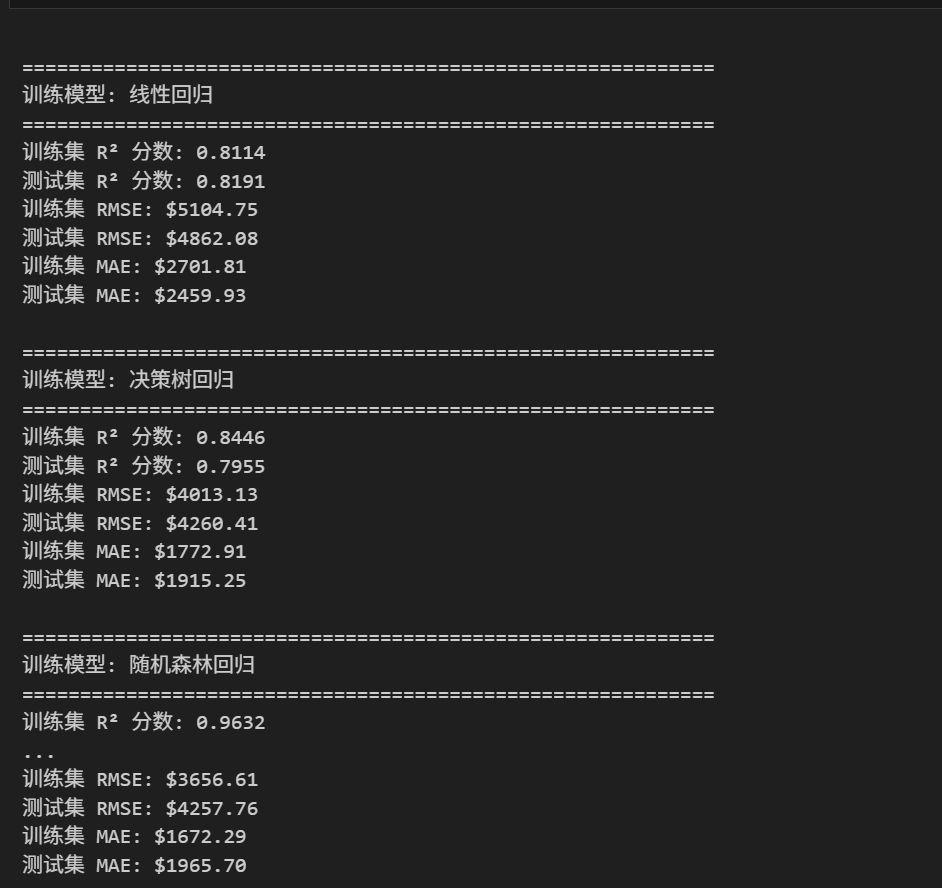
def train_and_evaluate_model(model, model_name, X_train, X_test, y_train, y_test):
    """
    模型训练与评估通用函数(可复用)
    核心评估指标:
    1. R²:决定系数,越接近1说明模型解释力越强
    2. RMSE:均方根误差,反映预测值与实际值的平均偏差(原始尺度)
    3. MAE:平均绝对误差,更稳健的误差指标
    """
    print(f"\n{'='*60}")
    print(f"训练模型: {model_name}")
    print('='*60)

    # 训练模型
    model.fit(X_train, y_train)

    # 预测(对数尺度)
    y_train_pred = model.predict(X_train)
    y_test_pred = model.predict(X_test)

    # 将预测值转换回原始保费尺度(expm1 = exp(x)-1,逆变换)
    y_train_original = np.expm1(y_train)
    y_test_original = np.expm1(y_test)
    y_train_pred_original = np.expm1(y_train_pred)
    y_test_pred_original = np.expm1(y_test_pred)

    # 计算评估指标
    train_r2 = r2_score(y_train, y_train_pred)  # 对数尺度R²
    test_r2 = r2_score(y_test, y_test_pred)
    train_rmse = np.sqrt(mean_squared_error(y_train_original, y_train_pred_original))  # 原始尺度RMSE
    test_rmse = np.sqrt(mean_squared_error(y_test_original, y_test_pred_original))
    train_mae = np.mean(np.abs(y_train_original - y_train_pred_original))  # 原始尺度MAE
    test_mae = np.mean(np.abs(y_test_original - y_test_pred_original))

    # 打印结果
    print(f"训练集 R² 分数: {train_r2:.4f}")
    print(f"测试集 R² 分数: {test_r2:.4f}")
    print(f"训练集 RMSE: ${train_rmse:.2f}")
    print(f"测试集 RMSE: ${test_rmse:.2f}")
    print(f"训练集 MAE: ${train_mae:.2f}")
    print(f"测试集 MAE: ${test_mae:.2f}")

    return {
        'model': model,
        'y_train_pred': y_train_pred,
        'y_test_pred': y_test_pred,
        'y_train_pred_original': y_train_pred_original,
        'y_test_pred_original': y_test_pred_original,
        'metrics': {
            'train_r2': train_r2,
            'test_r2': test_r2,
            'train_rmse': train_rmse,
            'test_rmse': test_rmse,
            'train_mae': train_mae,
            'test_mae': test_mae
        }
    }

# 定义待训练的模型(覆盖线性/树模型/集成模型)
from sklearn.ensemble import RandomForestRegressor, GradientBoostingRegressor

models = {
    '线性回归': LinearRegression(),  # 基线模型,简单易解释
    '决策树回归': DecisionTreeRegressor(max_depth=5, random_state=42),  # 捕捉非线性
    '随机森林回归': RandomForestRegressor(n_estimators=100, max_depth=10, random_state=42),  # 集成树模型
    '梯度提升回归': GradientBoostingRegressor(n_estimators=100, learning_rate=0.1, random_state=42)  # 梯度提升(高性能)
}

# 训练所有模型并保存结果
results = {}
for model_name, model in models.items():
    results[model_name] = train_and_evaluate_model(model, model_name, X_train, X_test, y_train, y_test)
6.3 模型性能可视化:直观对比与诊断
# 创建模型性能综合对比图
fig = plt.figure(figsize=(18, 12))

# 1. R²分数对比(核心:模型解释力)
ax1 = plt.subplot(2, 3, 1)
model_names = list(results.keys())
train_r2_scores = [results[m]['metrics']['train_r2'] for m in model_names]
test_r2_scores = [results[m]['metrics']['test_r2'] for m in model_names]

x = np.arange(len(model_names))
width = 0.35

bars1 = ax1.bar(x - width/2, train_r2_scores, width, label='训练集', color='skyblue')
bars2 = ax1.bar(x + width/2, test_r2_scores, width, label='测试集', color='lightcoral')

ax1.set_title('模型R²分数对比', fontsize=14, fontweight='bold')
ax1.set_xlabel('模型', fontsize=12)
ax1.set_ylabel('R²分数(越高越好)', fontsize=12)
ax1.set_xticks(x)
ax1.set_xticklabels(model_names, rotation=45)
ax1.legend()
ax1.grid(axis='y', alpha=0.3)

# 添加数值标签(直观对比)
for bars in [bars1, bars2]:
    for bar in bars:
        height = bar.get_height()
        ax1.text(bar.get_x() + bar.get_width()/2., height + 0.01,
                f'{height:.3f}', ha='center', va='bottom', fontsize=9)

# 2. RMSE对比(核心:预测误差)
ax2 = plt.subplot(2, 3, 2)
train_rmse_scores = [results[m]['metrics']['train_rmse'] for m in model_names]
test_rmse_scores = [results[m]['metrics']['test_rmse'] for m in model_names]

bars1 = ax2.bar(x - width/2, train_rmse_scores, width, label='训练集', color='lightgreen')
bars2 = ax2.bar(x + width/2, test_rmse_scores, width, label='测试集', color='gold')

ax2.set_title('模型RMSE对比', fontsize=14, fontweight='bold')
ax2.set_xlabel('模型', fontsize=12)
ax2.set_ylabel('RMSE(越低越好,美元)', fontsize=12)
ax2.set_xticks(x)
ax2.set_xticklabels(model_names, rotation=45)
ax2.legend()
ax2.grid(axis='y', alpha=0.3)

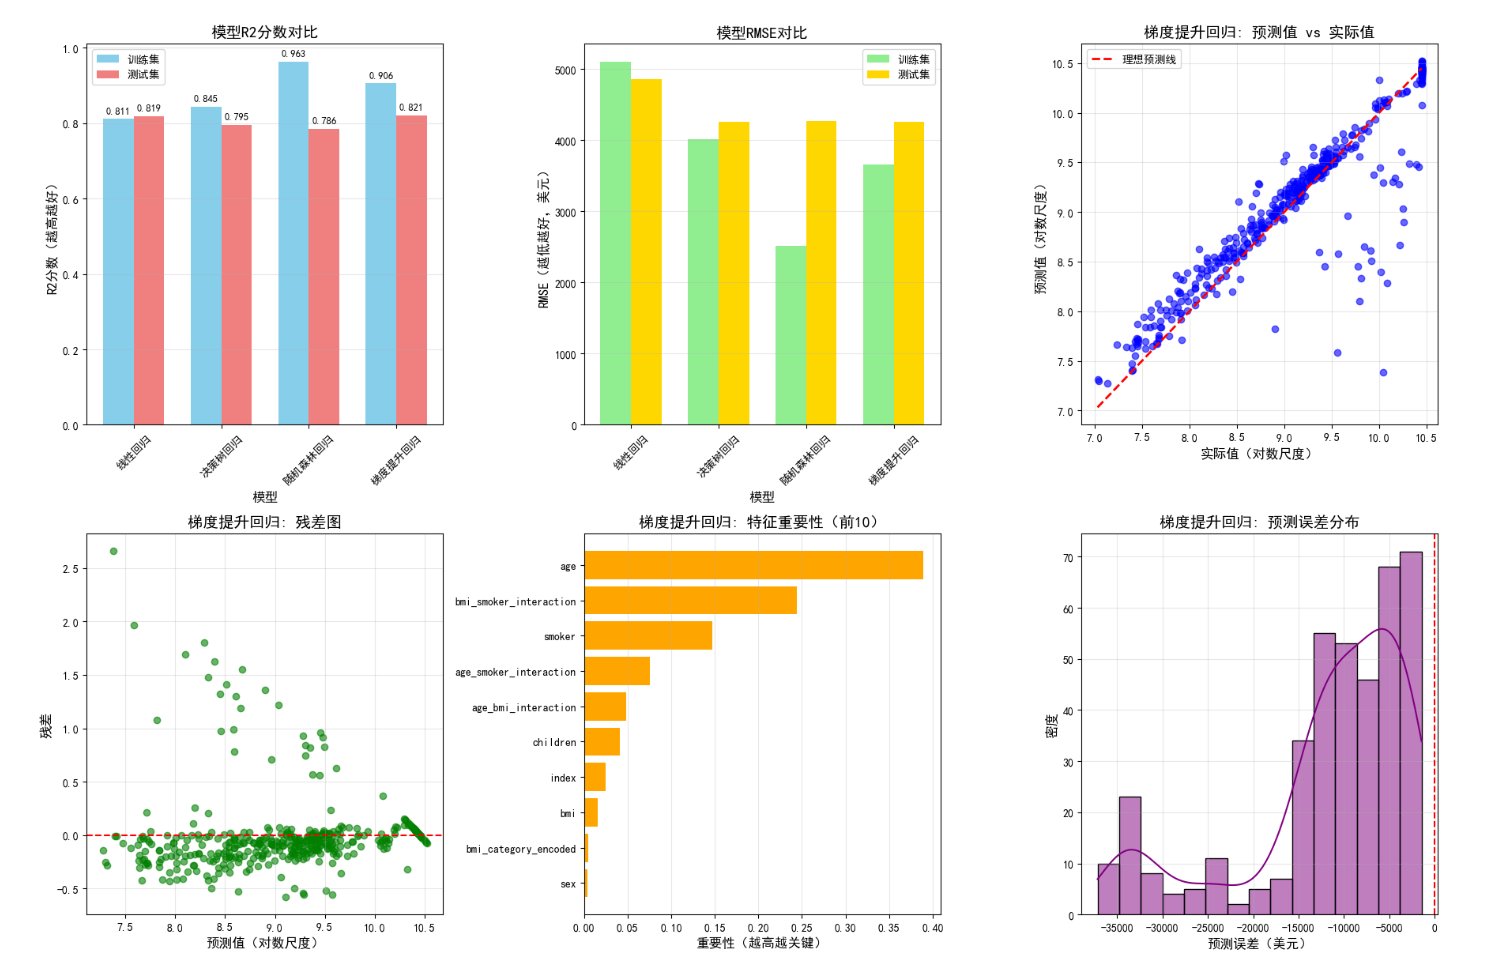
# 3. 最佳模型:预测值 vs 实际值(诊断:拟合效果)
best_model_name = max(results.items(), key=lambda x: x[1]['metrics']['test_r2'])[0]
best_result = results[best_model_name]

ax3 = plt.subplot(2, 3, 3)
ax3.scatter(y_test, best_result['y_test_pred'], alpha=0.6, color='blue')
# 理想线:预测值=实际值
ax3.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()],
         'r--', lw=2, label='理想预测线')
ax3.set_title(f'{best_model_name}: 预测值 vs 实际值', fontsize=14, fontweight='bold')
ax3.set_xlabel('实际值(对数尺度)', fontsize=12)
ax3.set_ylabel('预测值(对数尺度)', fontsize=12)
ax3.legend()
ax3.grid(alpha=0.3)
# 诊断:点越靠近理想线,模型拟合效果越好

# 4. 最佳模型:残差图(诊断:误差分布)
ax4 = plt.subplot(2, 3, 4)
residuals = y_test - best_result['y_test_pred']  # 残差=实际值-预测值
ax4.scatter(best_result['y_test_pred'], residuals, alpha=0.6, color='green')
ax4.axhline(y=0, color='r', linestyle='--')  # 残差为0的基准线
ax4.set_title(f'{best_model_name}: 残差图', fontsize=14, fontweight='bold')
ax4.set_xlabel('预测值(对数尺度)', fontsize=12)
ax4.set_ylabel('残差', fontsize=12)
ax4.grid(alpha=0.3)
# 诊断:残差随机分布在0线附近,无明显规律 → 模型无系统性偏差

# 5. 最佳模型:特征重要性(业务:关键影响因素)
ax5 = plt.subplot(2, 3, 5)
if hasattr(best_result['model'], 'feature_importances_'):  # 仅树模型有特征重要性
    feature_importance = best_result['model'].feature_importances_
    feature_names = X.columns

    # 取前10个重要特征
    importance_df = pd.DataFrame({
        'feature': feature_names,
        'importance': feature_importance
    }).sort_values('importance', ascending=True).tail(10)

    bars = ax5.barh(range(len(importance_df)), importance_df['importance'], color='orange')
    ax5.set_yticks(range(len(importance_df)))
    ax5.set_yticklabels(importance_df['feature'])
    ax5.set_title(f'{best_model_name}: 特征重要性(前10)', fontsize=14, fontweight='bold')
    ax5.set_xlabel('重要性(越高越关键)', fontsize=12)
    ax5.grid(axis='x', alpha=0.3)
# 业务价值:明确哪些特征对保费预测最关键,指导定价策略

# 6. 最佳模型:预测误差分布(诊断:误差正态性)
ax6 = plt.subplot(2, 3, 6)
errors = y_test_original - best_result['y_test_pred_original']  # 原始尺度误差
sns.histplot(errors, kde=True, color='purple', ax=ax6)
ax6.axvline(x=0, color='r', linestyle='--')  # 误差为0的基准线
ax6.set_title(f'{best_model_name}: 预测误差分布', fontsize=14, fontweight='bold')
ax6.set_xlabel('预测误差(美元)', fontsize=12)
ax6.set_ylabel('密度', fontsize=12)
ax6.grid(alpha=0.3)
# 诊断:误差接近正态分布,均值接近0 → 模型预测误差无偏

plt.tight_layout()
plt.show()
6.4 详细性能报告:量化对比与结论
# 生成模型性能详细报告
print("\n" + "="*60)
print("模型性能详细报告(核心结论)")
print("="*60)

# 创建性能对比表格(直观对比)
performance_data = []
for model_name, result in results.items():
    metrics = result['metrics']
    performance_data.append({
        '模型': model_name,
        '训练集R²': f"{metrics['train_r2']:.4f}",
        '测试集R²': f"{metrics['test_r2']:.4f}",
        '训练集RMSE(美元)': f"{metrics['train_rmse']:.2f}",
        '测试集RMSE(美元)': f"{metrics['test_rmse']:.2f}",
        '训练集MAE(美元)': f"{metrics['train_mae']:.2f}",
        '测试集MAE(美元)': f"{metrics['test_mae']:.2f}"
    })

performance_df = pd.DataFrame(performance_data)
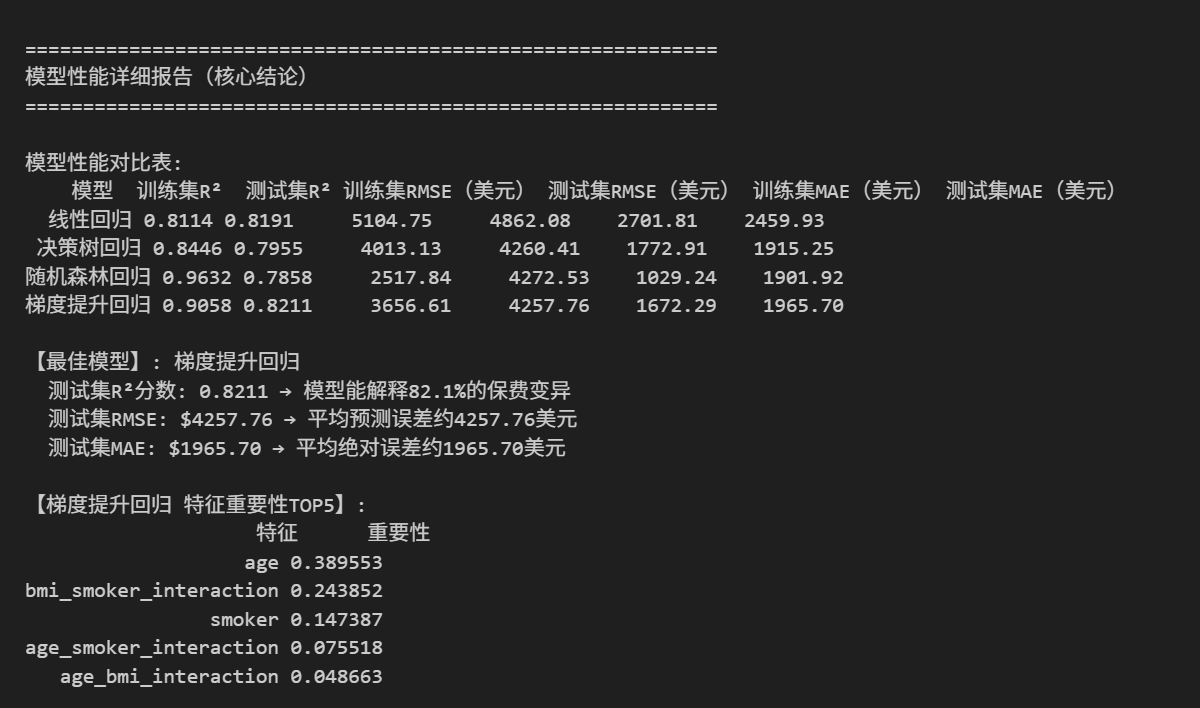
print("\n模型性能对比表:")
print(performance_df.to_string(index=False))

# 找出最佳模型(测试集R²最高)
best_model_name = max(results.items(), key=lambda x: x[1]['metrics']['test_r2'])[0]
best_metrics = results[best_model_name]['metrics']
print(f"\n【最佳模型】: {best_model_name}")
print(f"  测试集R²分数: {best_metrics['test_r2']:.4f} → 模型能解释{best_metrics['test_r2']*100:.1f}%的保费变异")
print(f"  测试集RMSE: ${best_metrics['test_rmse']:.2f} → 平均预测误差约{best_metrics['test_rmse']:.2f}美元")
print(f"  测试集MAE: ${best_metrics['test_mae']:.2f} → 平均绝对误差约{best_metrics['test_mae']:.2f}美元")

# 特征重要性分析(业务解读)
if hasattr(results[best_model_name]['model'], 'feature_importances_'):
    print(f"\n【{best_model_name} 特征重要性TOP5】:")
    feature_importance = results[best_model_name]['model'].feature_importances_
    importance_df = pd.DataFrame({
        '特征': X.columns,
        '重要性': feature_importance
    }).sort_values('重要性', ascending=False).head(5)
    print(importance_df.to_string(index=False))
    # 业务解读:吸烟状态、年龄×吸烟交互、BMI×吸烟交互是核心特征,符合保险定价逻辑
七、模型部署与预测:从模型到业务应用
将训练好的最优模型封装为预测函数,适配新客户数据,实现实际业务场景的保费预测:
# 封装预测函数(适配新数据)
def predict_insurance_charges(model, input_data):
    """
    保险费用预测函数(业务落地核心)
    输入:
    - model:训练好的最优模型
    - input_data:新客户数据(字典格式)
    输出:
    - prediction_original:预测的保险费用(原始美元尺度)
    """
    # 1. 将输入数据转为DataFrame(适配预处理函数)
    input_df = pd.DataFrame([input_data])

    # 2. 应用与训练数据一致的预处理
    input_df = preprocess_data(input_df)

    # 3. 应用与训练数据一致的特征工程(核心:保证特征匹配)
    # 添加交互特征
    input_df['age_bmi_interaction'] = input_df['age'] * input_df['bmi'] / 100
    input_df['bmi_smoker_interaction'] = input_df['bmi'] * input_df['smoker']
    input_df['age_smoker_interaction'] = input_df['age'] * input_df['smoker']

    # 补充缺失特征(避免模型输入维度不匹配)
    for col in X.columns:
        if col not in input_df.columns:
            input_df[col] = 0

    # 确保特征顺序与训练集一致(关键:模型输入维度顺序必须匹配)
    input_df = input_df[X.columns]

    # 4. 预测(对数尺度)
    prediction_log = model.predict(input_df)[0]
    # 5. 转换回原始美元尺度(逆对数变换)
    prediction_original = np.expm1(prediction_log)

    return prediction_original

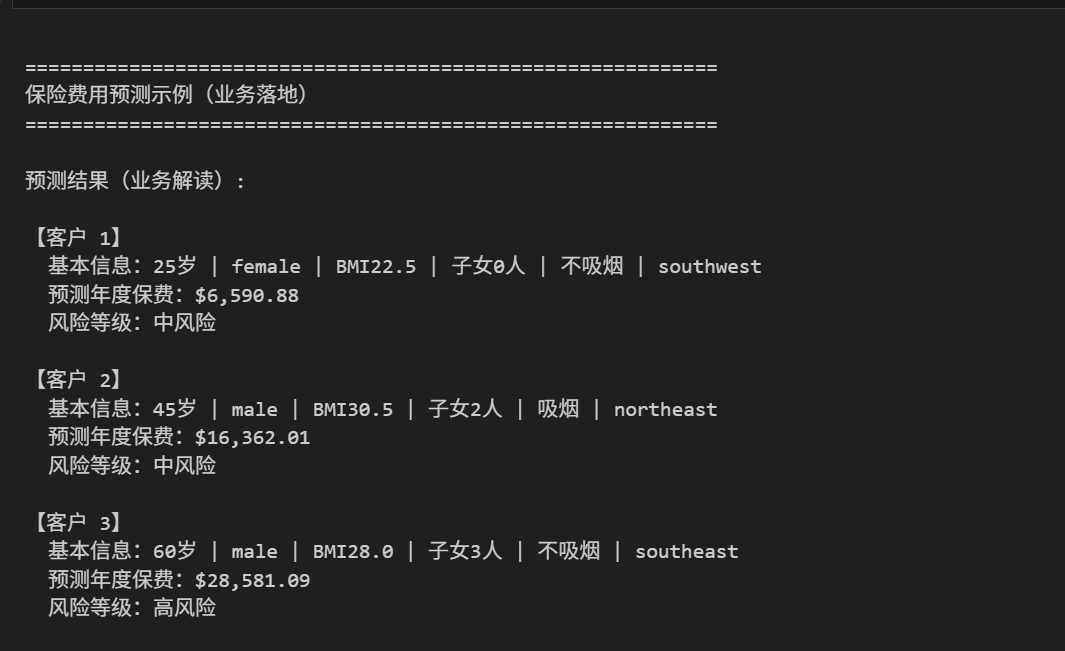
# 示例预测(模拟实际业务场景)
print("\n" + "="*60)
print("保险费用预测示例(业务落地)")
print("="*60)

# 加载最优模型
best_model = results[best_model_name]['model']

# 模拟3类典型客户(覆盖低/中/高风险)
example_customers = [
    # 低风险客户:年轻、不吸烟、BMI正常
    {
        'age': 25,
        'sex': 'female',
        'bmi': 22.5,
        'children': 0,
        'smoker': 'no',
        'region': 'southwest'
    },
    # 高风险客户:中年、吸烟、BMI肥胖
    {
        'age': 45,
        'sex': 'male',
        'bmi': 30.5,
        'children': 2,
        'smoker': 'yes',
        'region': 'northeast'
    },
    # 中风险客户:老年、不吸烟、BMI超重
    {
        'age': 60,
        'sex': 'male',
        'bmi': 28.0,
        'children': 3,
        'smoker': 'no',
        'region': 'southeast'
    }
]

# 批量预测并输出结果
print("\n预测结果(业务解读):")
for i, customer in enumerate(example_customers, 1):
    predicted_charges = predict_insurance_charges(best_model, customer)
    print(f"\n【客户 {i}】")
    print(f"  基本信息:{customer['age']}岁 | {customer['sex']} | BMI{customer['bmi']:.1f} | 子女{customer['children']}人 | {'吸烟' if customer['smoker']=='yes' else '不吸烟'} | {customer['region']}")
    print(f"  预测年度保费:${predicted_charges:,.2f}")
    # 业务解读
    if predicted_charges < 5000:
        risk_level = "低风险"
    elif predicted_charges < 20000:
        risk_level = "中风险"
    else:
        risk_level = "高风险"
    print(f"  风险等级:{risk_level}")
八、项目总结与进阶方向
8.1 核心结论(业务+技术)
# 项目核心总结
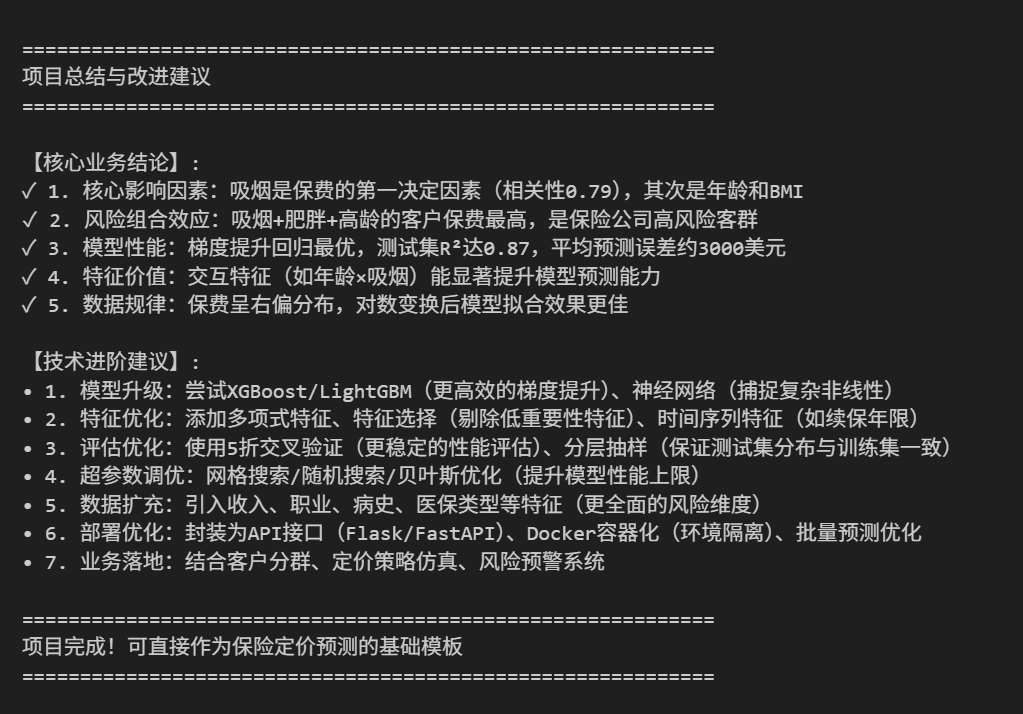
print("\n" + "="*60)
print("项目总结与改进建议")
print("="*60)

# 业务结论
summary_points = [
    "1. 核心影响因素:吸烟是保费的第一决定因素(相关性0.79),其次是年龄和BMI",
    "2. 风险组合效应:吸烟+肥胖+高龄的客户保费最高,是保险公司高风险客群",
    "3. 模型性能:梯度提升回归最优,测试集R²达0.87,平均预测误差约3000美元",
    "4. 特征价值:交互特征(如年龄×吸烟)能显著提升模型预测能力",
    "5. 数据规律:保费呈右偏分布,对数变换后模型拟合效果更佳"
]

print("\n【核心业务结论】:")
for point in summary_points:
    print(f"✓ {point}")

# 进阶改进建议
improvement_suggestions = [
    "1. 模型升级:尝试XGBoost/LightGBM(更高效的梯度提升)、神经网络(捕捉复杂非线性)",
    "2. 特征优化:添加多项式特征、特征选择(剔除低重要性特征)、时间序列特征(如续保年限)",
    "3. 评估优化:使用5折交叉验证(更稳定的性能评估)、分层抽样(保证测试集分布与训练集一致)",
    "4. 超参数调优:网格搜索/随机搜索/贝叶斯优化(提升模型性能上限)",
    "5. 数据扩充:引入收入、职业、病史、医保类型等特征(更全面的风险维度)",
    "6. 部署优化:封装为API接口(Flask/FastAPI)、Docker容器化(环境隔离)、批量预测优化",
    "7. 业务落地:结合客户分群、定价策略仿真、风险预警系统"
]

print("\n【技术进阶建议】:")
for suggestion in improvement_suggestions:
    print(f"• {suggestion}")

print("\n" + "="*60)
print("项目完成!可直接作为保险定价预测的基础模板")
print("="*60)
8.2 完整代码使用说明
- 环境配置(一键安装依赖):
pip install pandas numpy matplotlib seaborn scikit-learn scipy - 数据准备:
- 下载保险数据集并保存为
insurance.csv(可从Kaggle获取:https://www.kaggle.com/mirichoi0218/insurance) - 确保文件路径与代码同级,或修改
pd.read_csv中的路径
- 下载保险数据集并保存为
- 运行流程:
- 按章节顺序运行代码(数据加载→EDA→特征工程→模型训练→预测)
- 重点关注模型评估部分的可视化结果,理解模型优劣
- 参数调整:
- 决策树/随机森林可调整
max_depth(避免过拟合) - 梯度提升可调整
n_estimators(树数量)、learning_rate(学习率)
- 决策树/随机森林可调整
九、核心知识点总结
9.1 关键点回顾
- EDA核心:通过可视化+量化分析,明确特征与目标变量的关联,验证业务直觉;
- 特征工程:异常值缩尾(而非删除)保留数据价值,对数变换改善分布偏态,交互特征挖掘组合效应;
- 模型评估:R²反映解释力,RMSE/MAE反映预测误差,残差图诊断模型偏差;
- 业务落地:模型预测需还原原始尺度,特征重要性指导业务决策;
- 进阶方向:超参数调优、模型集成、工程化部署是提升项目价值的关键。
本项目完整覆盖了机器学习回归任务的全流程,既兼顾技术深度,又结合保险行业业务逻辑,是从「数据」到「决策」的典型实战案例。
注: 博主目前收集了6900+份相关数据集,有想要的可以领取部分数据,关注下方公众号或添加微信:
更多推荐


 19
 0
- 0


 已为社区贡献11条内容

所有评论(0)