
【人工智能引论期末复习】第4章 机器学习2-有监督学习
 一、回归分析(重点)
二、决策树(重点)
1. 基本概念
-
树结构:非叶子节点(属性判断)、叶子节点(分类结果)
-
构建目标:通过属性划分,使子集尽可能“纯”
2. 划分指标
-
信息熵:度量信息不确定性
-
信息增益(ID3算法):划分前后熵的减少值
-
信息增益率(C4.5算法):解决信息增益偏向多值属性问题
-
基尼系数(CART算法):计算更简单,用于分类与回归树
3. 构建过程
-
选择最佳划分属性 → 划分数据集 → 递归构建子树
三、线性判别分析(LDA)
-
一种有监督的降维方法
-
目标:投影后类内方差最小,类间方差最大
-
可用于分类,也可用于降维
四、集成学习与AdaBoost
1. 基本概念
-
集成学习:结合多个弱学习器构建强学习器
-
Boosting:串行生成,关注错误样本(如AdaBoost)
-
Bagging:并行生成,减少方差(如随机森林)
2. AdaBoost(自适应提升)
-
核心思想:提高错分样本权重,降低正确样本权重
-
弱分类器组合:加权投票,误差小的权重高
-
适用问题:二分类、多分类
五、支持向量机(SVM)
1. 基本概念
-
目标:寻找最大间隔超平面
-
支持向量:距离超平面最近的样本点
-
硬间隔 vs 软间隔:是否允许分类错误
2. 核函数
-
用于处理线性不可分数据
-
将数据映射到高维空间,使其线性可分
-
常见核函数:线性核、多项式核、RBF核
3. VC维与结构风险最小化
-
VC维:模型复杂度度量
-
结构风险 = 经验风险 + 正则化项 + VC置信度
-
用于控制模型复杂度,防止过拟合
六、生成模型 vs 判别模型
七、高频考点总结
| 考点 | 出题形式 | 复习重点 |
|---|---|---|
| 逻辑回归与Sigmoid | 填空、选择 | 函数形式、作用、与线性回归区别 |
| 决策树划分指标 | 选择、计算 | 信息增益、增益率、基尼系数计算与比较 |
| AdaBoost机制 | 填空、简答 | 权重更新机制、弱分类器组合方式 |
| SVM与核函数 | 选择、简答 | 最大间隔思想、核函数作用、软间隔 |
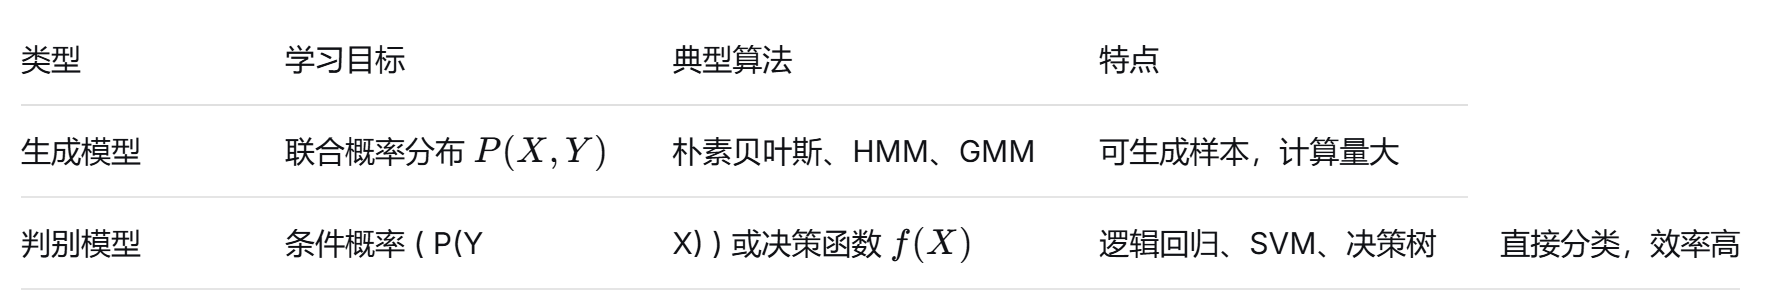
| 生成 vs 判别模型 | 填空、选择 | 区别、典型算法、适用场景 |
| LDA降维思想 | 填空、简答 | 类内方差最小、类间方差最大 |
八、可能出题方向
填空题示例:
-
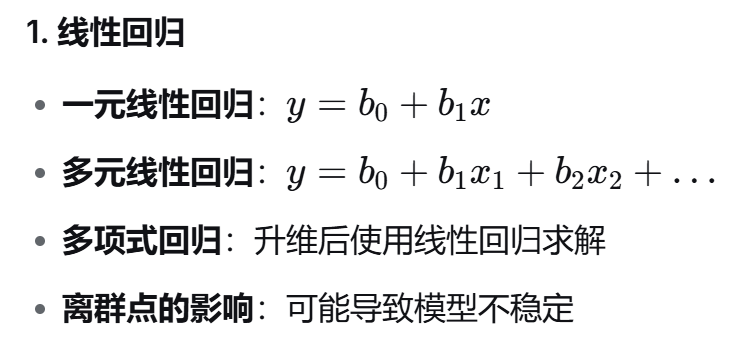
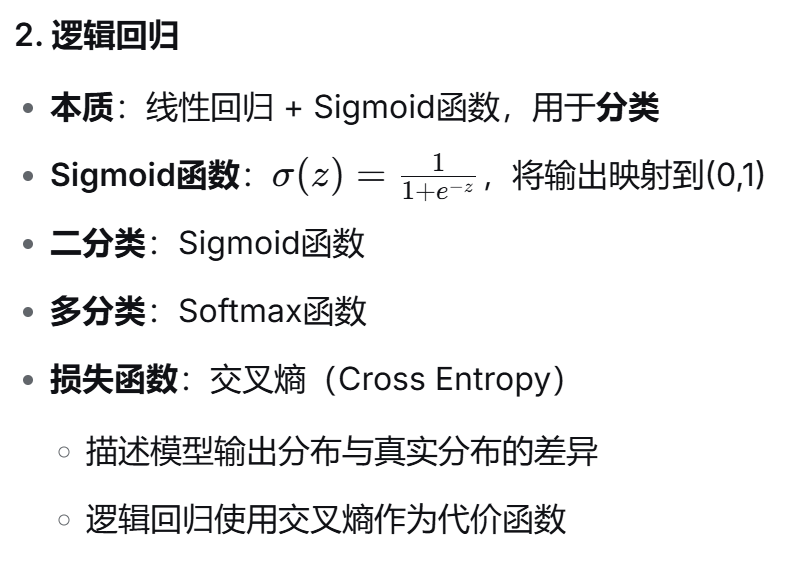
逻辑回归使用________函数将输出映射到(0,1)区间。
-
决策树中用于度量信息不确定性的指标是________。
-
SVM中用于处理线性不可分问题的技术是________。
选择题示例:
-
以下哪个是判别模型?
-
在AdaBoost中,错分样本的权重会________。
-
下列哪个指标不是决策树划分使用的?
简答题示例:
-
简述逻辑回归与线性回归的区别。
-
解释SVM中“最大间隔”的含义。
-
说明生成模型与判别模型的区别,并各举一例。
🔢 典型计算题(附解答)
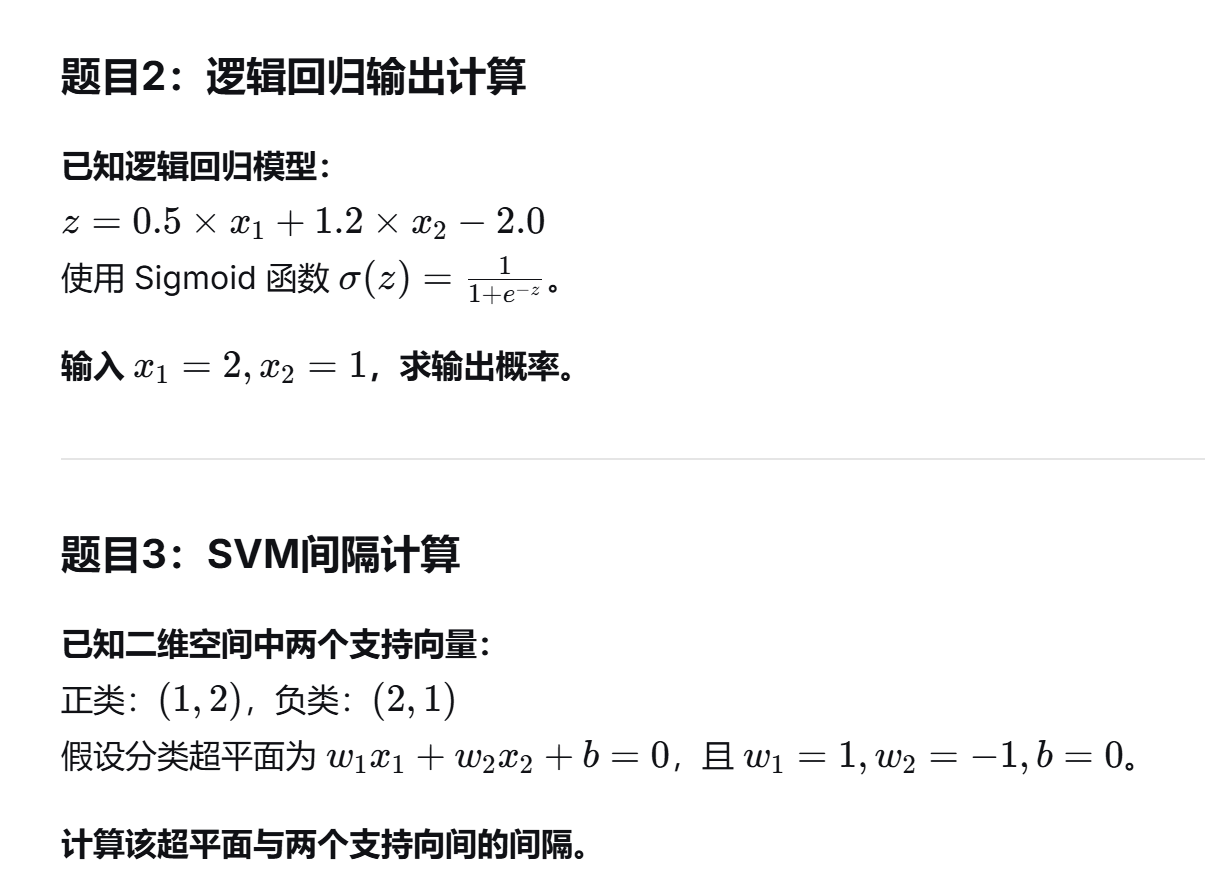
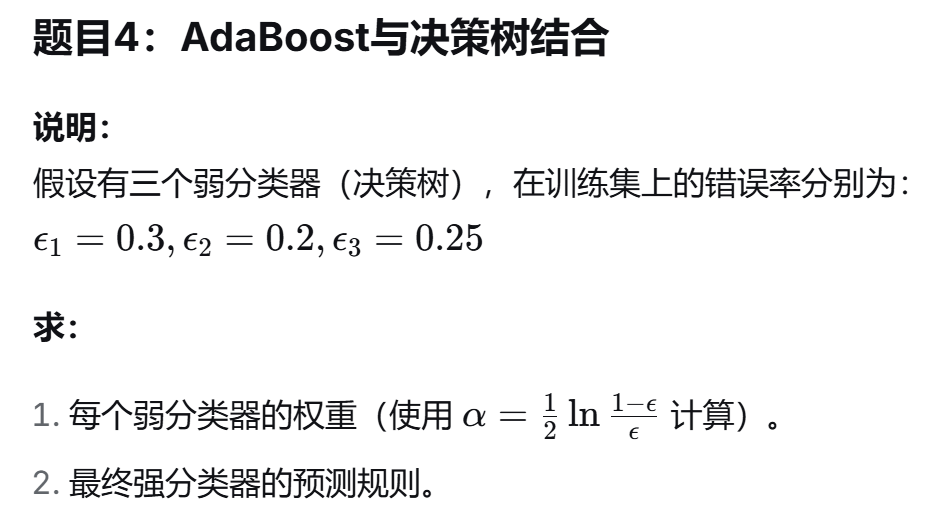
题目1:信息增益计算(决策树)
已知数据集 D:
| 天气 | 温度 | 湿度 | 风力 | 是否打球 |
|---|---|---|---|---|
| 晴 | 高 | 高 | 弱 | 否 |
| 晴 | 高 | 高 | 强 | 否 |
| 阴 | 高 | 高 | 弱 | 是 |
| 雨 | 中 | 高 | 弱 | 是 |
| 雨 | 低 | 中 | 弱 | 是 |
| 雨 | 低 | 中 | 强 | 否 |
| 阴 | 低 | 中 | 强 | 是 |
| 晴 | 中 | 高 | 弱 | 否 |
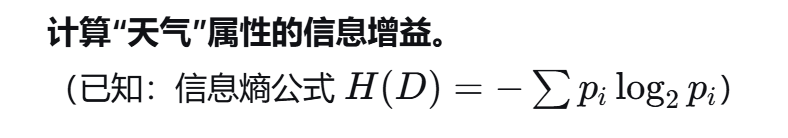
📄 模拟试题(第4章专项)
一、填空题(每空1分,共10分)
-
逻辑回归使用________函数将输出映射到(0,1)区间。
-
决策树中用于度量信息不确定性的指标是________。
-
在AdaBoost中,错分样本的权重会________。
-
SVM中用于处理线性不可分问题的技术是________。
-
生成模型学习的是________概率分布。
-
线性判别分析的目标是使投影后________方差最小,________方差最大。
-
多项式回归是通过________的方式实现非线性拟合。
-
交叉熵用于衡量________与________之间的差异。
二、选择题(每题2分,共10分)
-
以下哪个是判别模型?
-
A. 朴素贝叶斯
-
B. 隐马尔可夫模型
-
C. 逻辑回归
-
D. 高斯混合模型
-
-
决策树划分时,CART算法使用哪个指标?
-
A. 信息增益
-
B. 信息增益率
-
C. 基尼系数
-
D. 交叉熵
-
-
在SVM中,支持向量是指:
-
A. 所有训练样本
-
B. 被错误分类的样本
-
C. 距离超平面最近的样本
-
D. 随机选择的样本
-
-
AdaBoost属于哪种集成学习策略?
-
A. Bagging
-
B. Boosting
-
C. Stacking
-
D. Blending
-
-
逻辑回归的损失函数是:
-
A. 均方误差
-
B. 交叉熵
-
C. 绝对值误差
-
D. 铰链损失
-
三、简答题(每题5分,共10分)
-
简述逻辑回归与线性回归的区别。
-
解释SVM中“最大间隔”的含义及其优势。
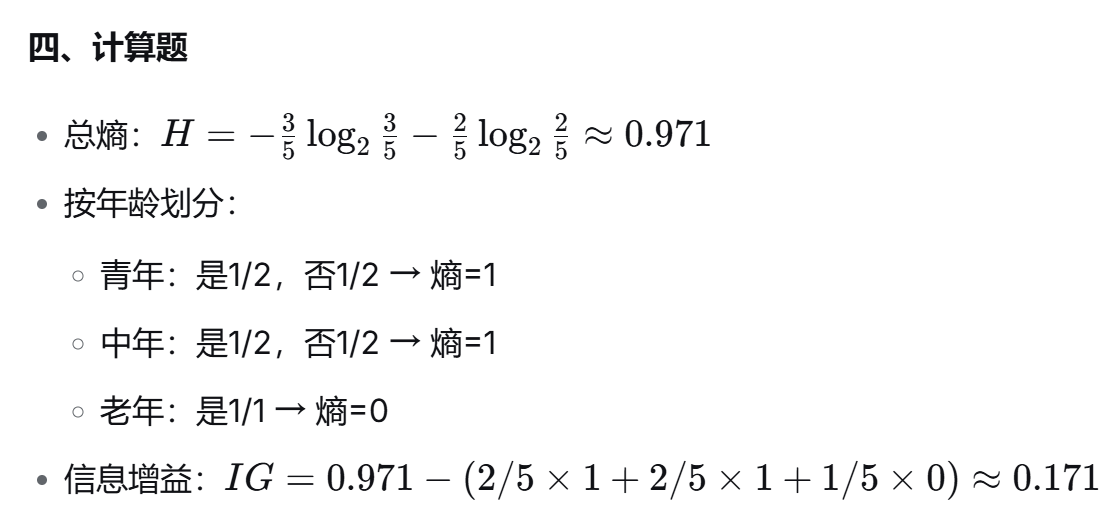
四、计算题(10分)
已知数据集如下:
| 年龄 | 收入 | 是否购买 |
|---|---|---|
| 青年 | 低 | 否 |
| 青年 | 高 | 是 |
| 中年 | 低 | 否 |
| 中年 | 高 | 是 |
| 老年 | 中 | 是 |
请计算“年龄”属性的信息增益。
(已知:购买“是”占比 3/5,“否”占比 2/5)
✅ 参考答案

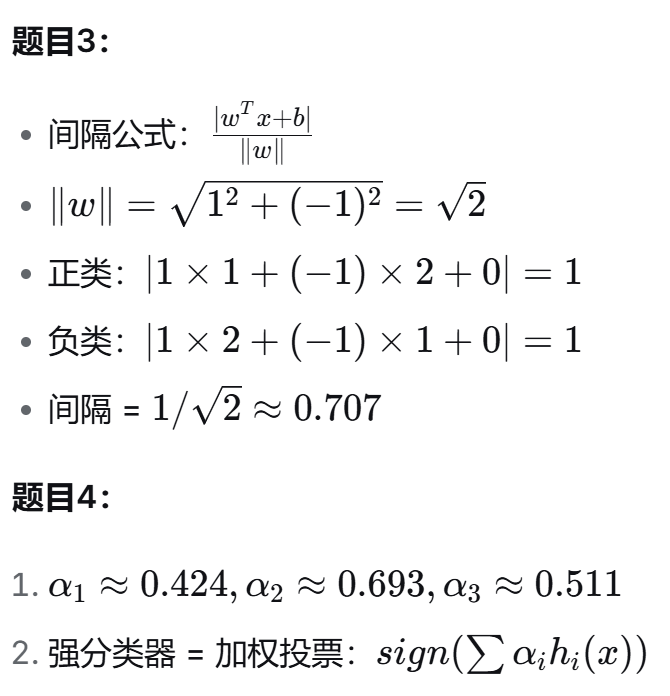
模拟试题答案
一、填空题
-
Sigmoid
-
信息熵
-
增加
-
核函数
-
联合
-
类内、类间
-
升维
-
模型输出分布、真实分布
二、选择题
-
C
-
C
-
C
-
B
-
B
三、简答题
-
逻辑回归输出概率用于分类,使用Sigmoid映射;线性回归输出连续值用于回归。
-
最大间隔是使两类样本到超平面的最小距离最大,提高泛化能力,减少过拟合。
更多推荐

 13
 0
- 0


 已为社区贡献13条内容

所有评论(0)