
深度学习实验——Pytorch实现人脸识别
- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊
文章目录
1. 简介 & 数据集介绍
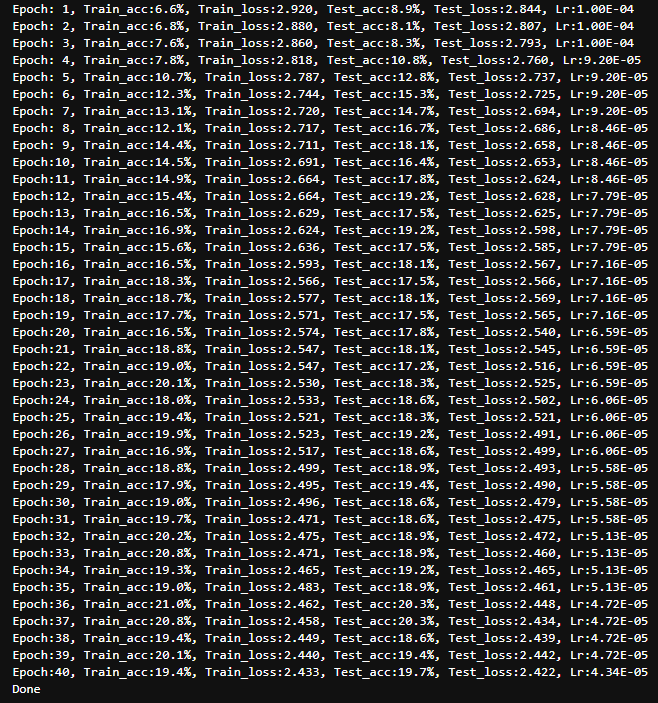
该实验先调用官方的VGG-16网络框架对模型进行训练,测试准确率仅有%;之后手动搭建VGG-16网络框架使测试准确率达到%。
VGG-16是由牛津大学视觉几何组于2014年提出的深度卷积神经网络,凭借其16层(13个卷积层和3个全连接层)的深层结构在ImageNet竞赛中脱颖而出。其核心设计特色在于统一使用3x3小卷积核通过堆叠来增强非线性表达并减少参数,配合ReLU激活函数和最大池化层,实现了对大规模图像特征的高效提取与分类。
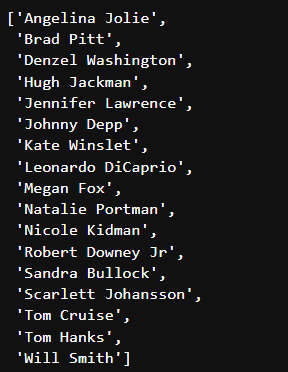
数据集包含17个明星,其中每个明星有100张照片
2. 环境
- 语言环境:Python 3.12.7
- 编译器:Jupyter Notebook
- 深度学习环境:torch—2.8.0 + cu126 / torchvision—0.23.1+cu126
3. 代码实现
3.1 前期准备
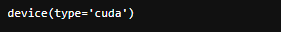
3.1.1 设置GPU & 导入库
import torch
import torch.nn as nn
import torchvision.transforms as transforms
import torchvision
from torchvision import transforms, datasets
import os,PIL,pathlib,warnings,random
from torchvision.models import vgg16
import copy
import matplotlib.pyplot as plt
import warnings
from datetime import datetime
from PIL import Image

warnings.filterwarnings("ignore")
plt.rcParams['font.sans-serif']    = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['figure.dpi']         = 100

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
device
3.1.2 标签查看
data_dir = './Data/48-data/'
data_dir = pathlib.Path(data_dir)

data_paths  = list(data_dir.glob('*'))
classeNames = [str(path).split("\\")[2] for path in data_paths]
classeNames
3.2 VGG-16 模型
3.2.1 图片转换读取
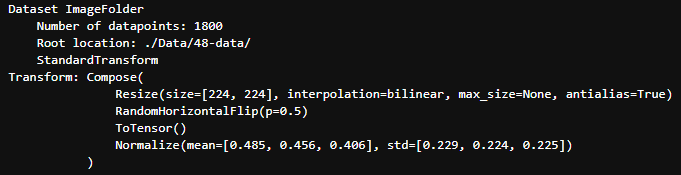
train_transforms = transforms.Compose([
    transforms.Resize([224, 224]),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])

total_data = datasets.ImageFolder("./Data/48-data/",transform=train_transforms)
total_data
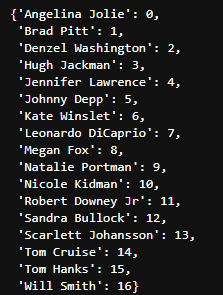
total_data.class_to_idx
train_size = int(0.8 * len(total_data))
test_size  = len(total_data) - train_size
train_dataset, test_dataset = torch.utils.data.random_split(total_data, [train_size, test_size])
train_dataset, test_dataset
3.2.2 数据集划分
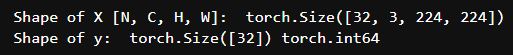
batch_size = 32
train_dl = torch.utils.data.DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=1)
test_dl = torch.utils.data.DataLoader(test_dataset, batch_size=batch_size, shuffle=True, num_workers=1)
for X, y in test_dl:
    print("Shape of X [N, C, H, W]: ", X.shape)
    print("Shape of y: ", y.shape, y.dtype)
    break
3.2.3 VGG-16 模型建立
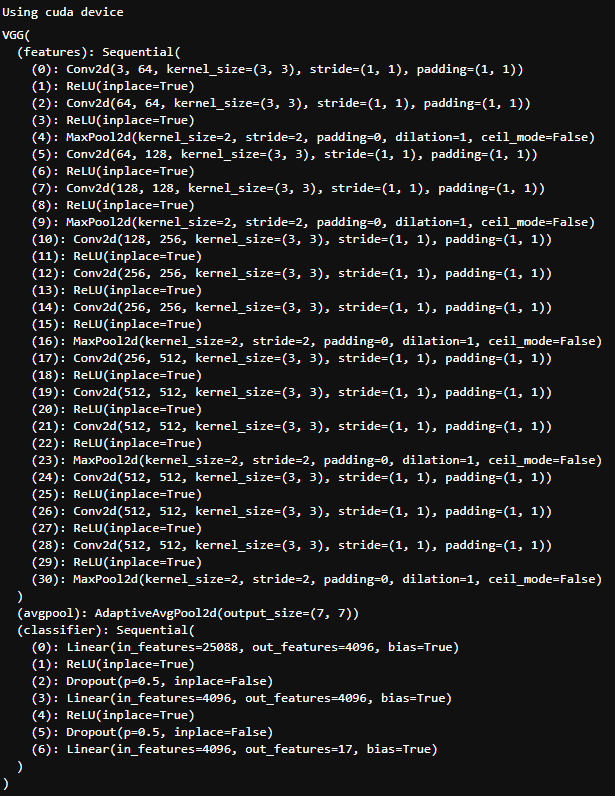
# VGG-16模型
print("Using {} device".format(device))

model = vgg16(pretrained = True).to(device)

for param in model.parameters():
    param.requires_grad = False

model.classifier._modules['6'] = nn.Linear(4096,len(classeNames))
model.to(device)
model
3.2.4 训练 & 测试函数
# 训练循环
def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    train_loss, train_acc = 0, 0

    for X, y in dataloader:
        X, y = X.to(device), y.to(device)
        pred = model(X)
        loss = loss_fn(pred, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        train_acc  += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss += loss.item()

    train_acc  /= size
    train_loss /= num_batches

    return train_acc, train_loss

# 测试循环
def test (dataloader, model, loss_fn):
    size        = len(dataloader.dataset)
    num_batches = len(dataloader)
    test_loss, test_acc = 0, 0

    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            target_pred = model(imgs)
            loss        = loss_fn(target_pred, target)

            test_loss += loss.item()
            test_acc  += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc  /= size
    test_loss /= num_batches

    return test_acc, test_loss
3.2.5 参数设定 & 正式训练
learn_rate = 1e-4 # 初始学习率

# 调用官方动态学习率接口
lambda1 = lambda epoch: 0.92 ** (epoch // 4)
optimizer = torch.optim.SGD(model.parameters(), lr=learn_rate)
scheduler = torch.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda=lambda1)

loss_fn    = nn.CrossEntropyLoss()
epochs     = 40

train_loss = []
train_acc  = []
test_loss  = []
test_acc   = []

best_acc = 0

for epoch in range(epochs):

    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, optimizer)
    scheduler.step()

    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)

    if epoch_test_acc > best_acc:
        best_acc   = epoch_test_acc
        best_model = copy.deepcopy(model)

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

    lr = optimizer.state_dict()['param_groups'][0]['lr']

    template = ('Epoch:{:2d}, Train_acc:{:.1f}%, Train_loss:{:.3f}, Test_acc:{:.1f}%, Test_loss:{:.3f}, Lr:{:.2E}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss,
                          epoch_test_acc*100, epoch_test_loss, lr))

# 保存最佳模型
PATH = './best_model6.pth'
torch.save(best_model.state_dict(), PATH)

print('Done')
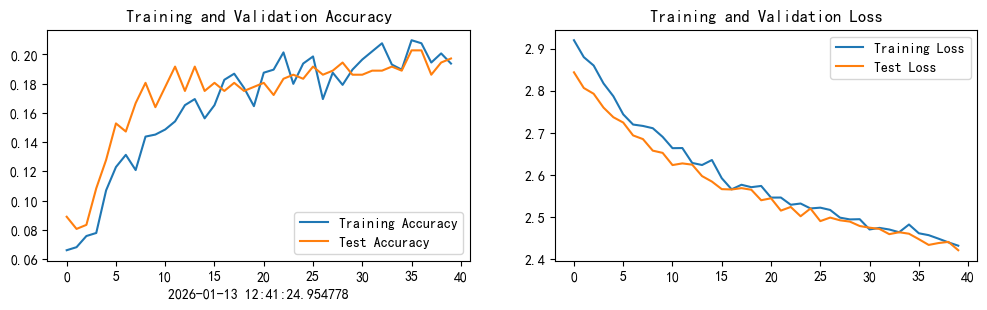
3.2.6 结果可视化
current_time = datetime.now()

epochs_range = range(epochs)

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
3.2.7 预测指定本地照片
classes = list(total_data.class_to_idx)

def predict_one_image(image_path, model, transform, classes):
    test_img = Image.open(image_path).convert('RGB')
    plt.imshow(test_img)

    test_img = transform(test_img)
    img = test_img.to(device).unsqueeze(0)

    model.eval()
    output = model(img)

    _,pred = torch.max(output,1)
    pred_class = classes[pred]
    print(f'预测结果是:{pred_class}')

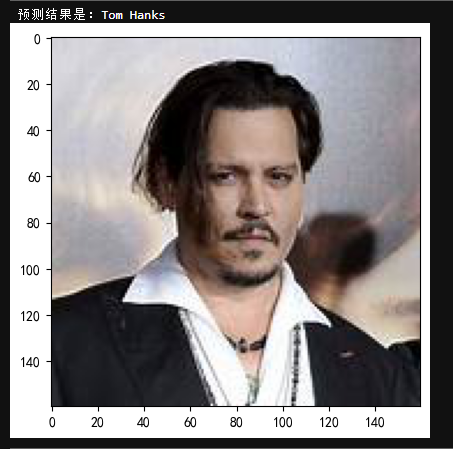
# 预测训练集中的某张照片
predict_one_image(image_path='./Data/48-data/Johnny Depp/003_64926b97.jpg', model=model, transform=train_transforms, classes=classes)
预测结果有误
# 模型评估
best_model.eval()
epoch_test_acc, epoch_test_loss = test(test_dl, best_model, loss_fn)
epoch_test_acc, epoch_test_loss

# 查看是否与我们记录的最高准确率一致
epoch_test_acc
4. 代码优化
4.1 问题分析
4.1.1 参数冻结过度
冻结所有特征层(for param in model.parameters(): param.requires_grad = False),只训练分类器最后一层。这适合简单任务,但对于面部识别(ImageNet预训练 vs 特定名人数据集),高层特征需细调。结果:模型无法适应新数据,欠拟合,准确率卡在20%。
4.1.2 数据增强不足
变换仅包括Resize、RandomHorizontalFlip、ToTensor和Normalize。没有旋转、颜色抖动等增强。小数据集(1800张,每类~106张)易过拟合,泛化差。
4.1.3 优化器和调度器配置不当
原使用SGD(lr=1e-4),适合大批量但在小数据集收敛慢。
LambdaLR调度器(0.92^(epoch//4))固定衰减,不基于性能(如损失/准确率),可能过早/过晚调整lr,导致训练波动。
更新片段切换到Adam(好主意),但ReduceLROnPlateau配置错误:
mode=‘max’(最大化metrics,如准确率),但step()需传入metrics(e.g., accuracy),而第一次scheduler.step()无参数,引发TypeError。
两次step()调用(一次无参,一次传入准确率),逻辑混乱。patience=3太短,可能导致lr过快衰减。
4.2 解决方案
4.2.1 改进参数冻结
手写VGG-16类,便于控制。加载预训练权重时过滤classifier[6]({k: v for k, v in pretrained_dict.items() if k in model_dict and ‘classifier.6’ not in k}),确保兼容。
部分解冻:冻结前4个卷积块(features[:24]),解冻最后1个(features[24:])和分类器。允许高层特征适应面部数据,同时保留低层通用特征。预期:减少欠拟合,提高准确率20-30%。
# Manual implementation of VGG-16
class VGG16(nn.Module):
    def __init__(self, num_classes=1000):
        super(VGG16, self).__init__()
        self.features = nn.Sequential(
            # Conv Block 1
            nn.Conv2d(3, 64, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(64, 64, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Conv Block 2
            nn.Conv2d(64, 128, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(128, 128, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Conv Block 3
            nn.Conv2d(128, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Conv Block 4
            nn.Conv2d(256, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Conv Block 5
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2)
        )

        self.avgpool = nn.AdaptiveAvgPool2d((7, 7))

        self.classifier = nn.Sequential(
            nn.Linear(512 * 7 * 7, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(p=0.5),
            nn.Linear(4096, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(p=0.5),
            nn.Linear(4096, num_classes)
        )

    def forward(self, x):
        x = self.features(x)
        x = self.avgpool(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x

# Initialize model
model = VGG16(num_classes=num_classes).to(device)

# Load pretrained weights from torchvision (adapt to our manual model)
from torchvision.models import vgg16
pretrained_model = vgg16(pretrained=True)
pretrained_dict = pretrained_model.state_dict()

# Filter out the classifier weights since dimensions differ
model_dict = model.state_dict()
pretrained_dict = {k: v for k, v in pretrained_dict.items() if k in model_dict and 'classifier.6' not in k}
model_dict.update(pretrained_dict)
model.load_state_dict(model_dict)

# Unfreeze the last two conv blocks for fine-tuning
for param in model.features[:24].parameters():
    param.requires_grad = False
for param in model.features[24:].parameters():
    param.requires_grad = True
4.2.2 增强数据变换
添加RandomRotation(15)和ColorJitter(brightness/contrast/saturation/hue=0.2),增加数据多样性。模拟光照、角度变化,适合面部识别小数据集。预期:降低过拟合,提高泛化5-10%。
# Enhanced data transforms with more augmentation
train_transforms = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(),
    transforms.RandomRotation(15),
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2, hue=0.1),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])

# Load dataset
total_data = datasets.ImageFolder(data_dir, transform=train_transforms)
4.2.3 优化器和调度器优化
切换到Adam(lr=1e-4, weight_decay=1e-5),自适应调整每个参数的学习率,添加L2正则防止过拟合。比SGD更快收敛。
使用ReduceLROnPlateau(mode=‘min’, factor=0.5, patience=5, verbose=True),基于测试损失(min模式)自动调整lr。只需一次scheduler.step(test_loss),避免TypeError。patience=5更稳健,verbose打印变化。预期:智能衰减lr,稳定训练,避免波动。
# Optimizer and loss
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4, weight_decay=1e-5)
loss_fn = nn.CrossEntropyLoss()

# Learning rate scheduler
scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(optimizer, mode='min', factor=0.5, patience=5)
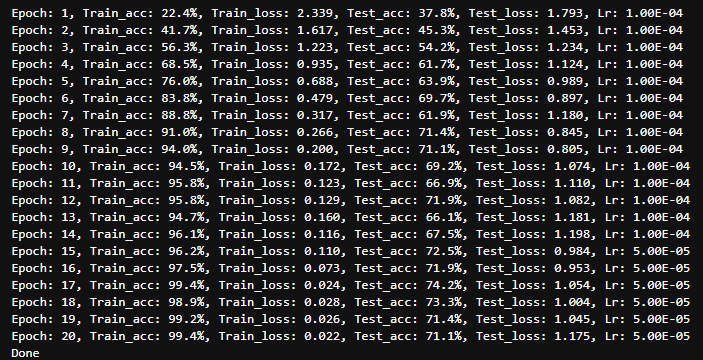
4.2 训练结果与可视化
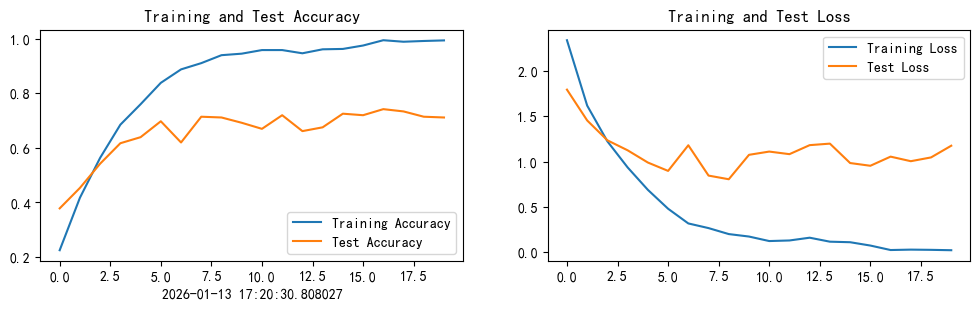
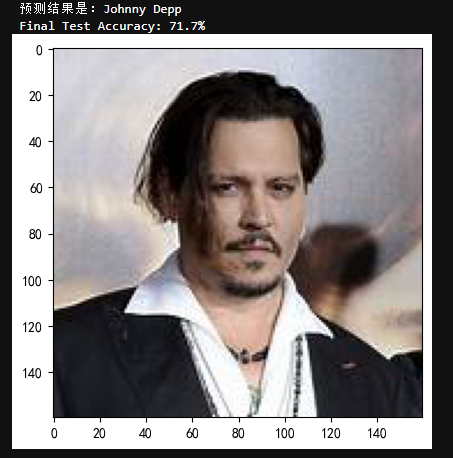
更多推荐
 19
 0
- 0


 已为社区贡献29条内容

所有评论(0)