
hadoop增加spark的service,及其shell命令
增加一个spark的service:
spark:
image: apache/spark:3.4.1-python3
container_name: spark
restart: always
environment:
- SPARK_MASTER=yarn
- HADOOP_CONF_DIR=/opt/hadoop/etc/hadoop
- YARN_CONF_DIR=/opt/hadoop/etc/hadoop
volumes:
- ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml
- ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml
- ./config/yarn-site.xml:/opt/hadoop/etc/hadoop/yarn-site.xml
- ./spark-apps:/opt/spark-apps
depends_on:
- namenode
- datanode
- resourcemanager
networks:
- default
command: ["bash", "-c", "sleep infinity"]
接着docker compose up -d,这样自动会拉取这个spark的镜像并构建这个容器。
进入spark这个容器:docker exec -it spark bash
接着会出现几个问题,需要设置一下:
第一个就是找不到spark-shell:
apache/spark:3.4.1-python3 镜像里,Spark 不在 PATH 中,spark-shell 不会直接可用。
可以输入export PATH=/opt/spark/bin:$PATH临时配置一下,就当前会话有效,一旦你退出当前会话,就不行了,当然也可以将他写入文件当中,让他永久生效,这个就自己去找。
第二个就是HDFS 权限问题,需要注册一个hdfs的用户:
可以再开一个cmd或者powershell进入namenode容器,创建一个spark的用户。

接着在spark这个容器中跑spark-shell --master yarn,就可以启动了,会出现如下:
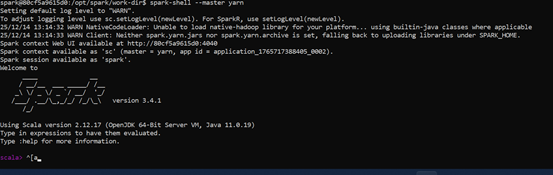
接着就可以做实验了。
在scala这执行一个简单的认证,sc.parallelize(Seq(1,2,3,4)).map(_ * 100).collect()
结果应该是100,200,300,400
更多推荐

 3
 0
- 0


 已为社区贡献6条内容

所有评论(0)