
给电气工程师讲机器学习(一)
作为一名电气工程师 免不了要跟各种设备仪表打交道:温度采集模块、压力表、位移计.....(图是在淘宝随便找的)

图1:常见设备仪表
对这些设备仪表进行数据采集往往有两种形式:一种是通讯(比如Modbus、自由口等等),只需要了解报文协议,解析报文后就能直接获取到具体数值;

图2:常见通讯协议
另一种是模拟量,获取的模拟量是"原始采集值",需要做下换算才能得到真实数值。比如,我的压力传感器量程是0-100KN,如果连接的PLC模拟量输入模块分辨率是15位,那么整个量程就被细分为了2的15次方,也就是0-32768;
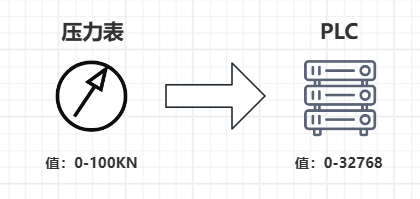
图3:压力表的模拟量输出
在理想情况下,它们是线性关系:y=kx,我们可以很轻易的根据读取到的模拟量数值计算压力值,比如模拟量10000,那么:
实际压力值=10000/32768*100KN=30.51KN
但是,实际的电路大部分上都存在零点偏移,比如0KN时,模拟量采集值却显示在1300左右跳动;加满压时,模拟量采集值还没到32768。这时简单的比例关系就不够了,需要增加一个偏置y=kx+b,这时有两个变量,分别是k和b,我们在程序里面对应增加一段标定程序,通过在不同的压力值下记录当时的模拟量,然后解二元一次方程,得到k,b值;

图4:压力值与模拟量的线性关系
当然,实际情况下,为了避免采集到异常波动值我们还会先对模拟量做下滤波,比如限制大小范围(幅值滤波),然后取5次扫描周期的均值(平滑滤波)等等,常用的滤波算法我会在评论区放个古早论坛的滤波帖链接,这里就不多赘述滤波了;但考虑到标定过程中的也会有噪声影响(实际测量值围绕真实值上下波动),仅使用两点标定(如X1,X2)的参数可能因为一次性的随机误差影响最终测量精度。

图5:通过获取不同阶段压力值进行标定取点
为优化标定的精度,一方面可以通过选取接近测量范围下限的压力值作为第一标定点(如X1),接近测量范围上限的压力值作为第二标定点(如X4),拉长跨度,提升标定直线的斜率计算精度,从而降低系统在全量程范围内的线性误差。选取的两点过于接近(如X1,X2),误差(斜率即角度)只会随着跨度增加被放大;另外还可以通过重复多次标定取均值的方式来拟合实际参数,减小误差;
以上,就是我们常规的方法来获取y=kx+b中的k,b参数;
那这又跟机器学习有什么关系呢?一起看看怎么用完整的机器学习方式实现根据模拟量预测压力值。以下是机器学习进行模型训练的大致流程:

图6:机器学习的模型训练大致流程
在机器学习中,我们往往把采集的实际x,y值称为数据集,图中的预设模型其实就是函数关系f以及有哪些待确认的参数,这里我们已知x,y是线性关系,待确认参数k,b,所以f(x)=kx+b;看到这里,是不是觉得和前面的标定没啥区别?确实是的,只是在面对多组x,y值来训练机器学习模型时,我们会先预设k,b为某个值,比如5,1,然后我们会把数据集中的x值代入到方程中,获取对应的y值。求得的y值和数据集中的y值(也称为标签)是存在差异的,我们会汇总差异并将减小这个差异值作为我们接下来更新k,b参数的目标。
现在问题来了,怎么更新k,b呢?继续瞎设么?当然不是,这里我们引入个“损失函数”的概念,既然k,b是为了减小差异值而更新,那我们把差异值设个函数。常见有两种损失函数,一种均方误差(MSE,Mean Squared Error),预测与真实值之差的平方和;另外一种平均绝对误差(MAE, Mean Absolute Error),计算预测值与真实值之差的绝对值的平均值,以下是二者对比:

表1:两种常见损失函数(from 通义千问)
通过对k,b求偏导,我们可以获取损失函数在当前参数取值下的梯度(坡度最陡的上升方向)信息,我们要获得最小的差异值,所以我们应该往梯度反方向走,走多少呢?这里引入一个新的参数“学习率”,k,b的更新步长=方向X学习率,这就是k,b更新的规则。每次更新后重新计算损失,再比对差异值是否在接受范围,或更新的轮次是否已经达到设定,任意一个满足的情况下,我们停止训练,取最后更新的k,b作为我们模型训练出的参数。当然,达到损失值最小的更新策略,其实有很多种方式,以上我们介绍的只是其中一种优化算法:梯度下降优化算法。

图7:梯度下降优化算法 (图源Analytics Vidhya)
以上,训练完成了, f(x)=k模型x+b模型 , 恭喜大家,已经掌握了机器学习里面的线性回归算法....就这?没错,就这!机器学习是让机器学习数据,实现预测或决策,这和我们做标定得到函数或者直接把多组采集数据放在excel中拟合一条直线获得线性方程并没有什么不同。只不过这个简单场景下,Excel直接求解其实会更快,哈哈。
我只是想通过这个例子让大家能对机器学习中的数据集,模型训练流程,模型(就是f),损失函数,最小化损失函数,梯度,梯度方向,学习步率,轮次….建立了解,机器学习的模型是怎么训练的?以后的算法也都是同样的套路。只不过数据集不一样,数据集中的数据关系不一样,所以模型的选择,损失函数的选择,优化算法的选择会有差异而已。关于python代码实现,相关库基本都有了,使用时只需要调用即可。就跟我们封装的功能块一样,需要的话,调用,引脚配置下就完事;
因为写这篇文章,我预设的受众是有电气工程师经验的人,所以不确定有些内容放在这里是否合适,尤其是前面部分是不是写得太没必要了。总之写了就希望尽可能起到作用。所以,如果大家有啥建议尽管提。

更多推荐

 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)