
【机器学习】万字长文带你一文搞懂各种常见卷积(3D卷积/分组卷积/1×1 卷积/深度卷积/深度可分离卷积/稀疏卷积/空洞卷积/转置卷积/亚像素卷积/可变形卷积/金字塔卷积等)
【机器学习】万字长文带你一文搞懂各种常见卷积(3D卷积/分组卷积/1×1 卷积/深度卷积/深度可分离卷积/稀疏卷积/空洞卷积/转置卷积/亚像素卷积/可变形卷积/金字塔卷积等)
文章目录
- 【机器学习】万字长文带你一文搞懂各种常见卷积(3D卷积/分组卷积/1×1 卷积/深度卷积/深度可分离卷积/稀疏卷积/空洞卷积/转置卷积/亚像素卷积/可变形卷积/金字塔卷积等)
- 一、什么是卷积(Convolution)
- 二、普通卷积(Standard Convolution)
- 三、步长卷积(Strided Convolution)
- 四、填充卷积(Padding Convolution)
- 五、1×1 卷积(Pointwise Convolution)
- 六、分组卷积(Group Convolution)
- 七、深度卷积(Depthwise Convolution)
- 八、深度可分离卷积(Depthwise Separable Convolution)
- 九、稀疏卷积(Sparse Convolution)
- 十、空洞卷积(Dilated / Atrous Convolution)
- 十一、转置卷积(Transposed Convolution)
- 十二、亚像素卷积(Sub-pixel Convolution)
- 十三、可变形卷积(Deformable Convolution)
- 十四、金字塔卷积(Pyramidal Convolution)
- 结语
一、什么是卷积(Convolution)
- 注:本文侧重的是图像处理领域的离散卷积,常见于21世纪10年代的一些深度学习的网络中,常用于目标检测等领域,对于信号领域的连续卷积在本文中不展开。
- 涉及到 “数字图像处理” 等课程中的基础知识,以及初步的机器学习知识。
在深度学习中,卷积(Convolution)是一种通过局部连接 + 权值共享来提取特征的运算方式,广泛应用于图像、语音、文本等领域,尤其是计算机视觉。
直观理解:
- 卷积核(Kernel / Filter)是一个小窗口
- 在输入特征图上滑动
- 通过加权求和生成新的特征图
公式表示为:
Y ( i , j ) = ∑ m ∑ n X ( i + m , j + n ) ⋅ K ( m , n ) Y(i,j) = \sum_{m}\sum_{n} X(i+m, j+n)\cdot K(m,n) Y(i,j)=m∑n∑X(i+m,j+n)⋅K(m,n)
在 CNN 中,特征图通常是四维张量:
( N , C , H , W ) (N,\ C,\ H,\ W) (N, C, H, W)
- N N N:batch size
- C C C:通道数
- H , W H, W H,W:空间尺寸
对于图像处理领域的离散卷积,可以认为是一个 窗口/模板/算子/卷积核 在图像上滑动,滑动到某个地方的时候,将图像上的像素与 窗口/模板/算子/卷积核 上的值进行一次逐元素点乘,作为卷积的计算结果。
图像一般是二维的(当然,考虑到多通道的话,也有三维卷积),下面我们以一个一维卷积作为例子,一看你就明白了:

二维卷积看这张图吧,我就不算了:

在深度学习中,当我们说“一维卷积(1D)”、“二维卷积(2D)”、“三维卷积(3D)”时,这里的“维度”指的是卷积核(Kernel)在数据上滑动的空间(或时空)方向的数量。
更高维度的卷积(如三维卷积,见本节 5. 的相关介绍)原理类似。
卷积一般可以用于做特征提取,其处理对象可以是 ①未经处理的图像域(数字图像处理)或是 ②CNN等中的特征图(机器学习,卷积核中的参数可以通过正向传播获得Loss,然后在反向传播的时候实施梯度下降)。
后文中的内容多涉及机器学习,其含义多为②,所以在这里举一个①的例子吧:
- 拉普拉斯锐化核为:
[ 0 1 0 1 − 4 1 0 1 0 ] \begin{bmatrix} 0 & 1 & 0 \\ 1 & -4 & 1 \\ 0 & 1 & 0 \\ \end{bmatrix} 0101−41010
其中心高权重,周围负权重,效果为增强图像中的高频细节,常应用图像锐化、细节增强、纹理分析。
由下图可以看出,在使用拉普拉斯锐化核之后,图像的所有边缘都变得更加清晰了:

(此部分的一些示例图参考:如何通俗易懂地解释卷积?)
想要了解更多关于卷积核卷积神经网络的介绍,可以参见:《深度学习理论及实战(MATLAB版·第2版) 3.1 深入浅出话“ 卷积”》
二、普通卷积(Standard Convolution)
1. 基本概念
普通卷积是最常见、最基础的卷积形式。
2. 卷积的特点
- 输入通道数 = 卷积核通道数
- 一个卷积核生成一个输出通道
- 多个卷积核生成多个输出通道
3. 普通卷积中张量各维度大小的变化
(1)普通卷积中通道数变化
普通卷积中:
- 输入通道数 = 卷积核的通道数
- 输出通道数 = 卷积核的个数
假设输入特征图是一个 三维张量(不算 batch):
(
C
i
n
,
H
i
n
,
W
i
n
)
(C_{in},\ H_{in},\ W_{in})
(Cin, Hin, Win)
普通 2D 卷积核的形状(这里的“二维”指的是卷积核进行二维滑动):
(
C
i
n
,
k
,
k
)
(C_{in},\ k,\ k)
(Cin, k, k) (一个卷积核会同时看所有输入通道,卷积核的通道数与输入的特征图的通道数保持一致)
在每个空间位置,卷积核对所有输入通道做加权求和,每一个卷积核 → 一张输出特征图(1 个输出通道)
一般而言,一个卷积层中会有多个卷积核,以提取更丰富的信息。假设有
C
o
u
t
C_{out}
Cout 个卷积核:
(
C
o
u
t
,
C
i
n
,
k
,
k
)
(C_{out},\ C_{in},\ k,\ k)
(Cout, Cin, k, k)
那么:
(
C
i
n
,
H
i
n
,
W
i
n
)
→
Conv
(
C
o
u
t
,
H
o
u
t
,
W
o
u
t
)
(C_{in}, H_{in}, W_{in}) \xrightarrow{\text{Conv}} (C_{out}, H_{out}, W_{out})
(Cin,Hin,Win)Conv(Cout,Hout,Wout)
👉 通道数从 C i n C_{in} Cin 变成 C o u t C_{out} Cout
从数学层面看通道变化:在输出位置
(
i
,
j
)
(i,j)
(i,j),第
m
m
m 个输出通道:
y
m
(
i
,
j
)
=
∑
c
=
1
C
i
n
∑
u
=
1
k
∑
v
=
1
k
w
m
,
c
(
u
,
v
)
⋅
x
c
(
i
+
u
,
j
+
v
)
y_{m(i,j)} = \sum_{c=1}^{C_{in}} \sum_{u=1}^{k} \sum_{v=1}^{k} w_{m,c}(u,v)\cdot x_c(i+u,j+v)
ym(i,j)=c=1∑Cinu=1∑kv=1∑kwm,c(u,v)⋅xc(i+u,j+v)
👉 重点看这个 “
∑
c
=
1
C
i
n
\sum_{c=1}^{C_{in}}
∑c=1Cin ”:对于一个卷积核,所有输入通道都被“融合”进了一个输出通道。(当然,如果有多个(
C
o
u
t
C_{out}
Cout 个)卷积核,那么就会有多个(
C
o
u
t
C_{out}
Cout 个)输出的通道)
从这里可以看出,为什么说“卷积在做通道间的信息融合”?这是因为每个卷积输出的通道都是所有输入通道的加权和,通道之间不再是独立的。
(2)普通卷积中空间维度(H, W)的变化
H
o
u
t
=
⌊
H
i
n
+
2
P
h
−
D
h
(
K
h
−
1
)
−
1
S
h
⌋
+
1
H_{out} = \left\lfloor \frac{H_{in} + 2P_h - D_h(K_h-1) - 1}{S_h} \right\rfloor + 1
Hout=⌊ShHin+2Ph−Dh(Kh−1)−1⌋+1
W
o
u
t
=
⌊
W
i
n
+
2
P
w
−
D
w
(
K
w
−
1
)
−
1
S
w
⌋
+
1
W_{out} = \left\lfloor \frac{W_{in} + 2P_w - D_w(K_w-1) - 1}{S_w} \right\rfloor + 1
Wout=⌊SwWin+2Pw−Dw(Kw−1)−1⌋+1
参数含义:
| 符号 | 含义 |
|---|---|
| K K K | 卷积核大小 |
| S S S | stride |
| P P P | padding |
| D D D | dilation |
4. 参数量计算
假设:
- 输入通道数:
Cin - 输出通道数:
Cout - 卷积核大小:
K × K
参数量为:
C i n × C o u t × K × K Cin \times Cout \times K \times K Cin×Cout×K×K
👉 当通道数较大时,参数量和计算量会迅速增长。
5. 三维卷积(3D Convolution)
三维卷积是普通 2D 卷积在深度维度上的推广。卷积核不再只在 H×W 平面上滑动,而是 在 H×W×D 的立体空间中滑动。
这里所说的仍然是一种普通的卷积。再次强调:
普通卷积中:
- 输入通道数 = 卷积核的通道数
- 输出通道数 = 卷积核的个数
(1)卷积核形状
2D 卷积核形状: ( C i n , k h , k w ) (C_{in}, k_h, k_w) (Cin,kh,kw) → 3D 卷积核形状: ( C i n , k d , k h , k w ) (C_{in}, k_d, k_h, k_w) (Cin,kd,kh,kw)
(2)输入输出张量
- 输入: ( N , C i n , D i n , H i n , W i n ) (N, C_{in}, D_{in}, H_{in}, W_{in}) (N,Cin,Din,Hin,Win)
- 输出: ( N , C o u t , D o u t , H o u t , W o u t ) (N, C_{out}, D_{out}, H_{out}, W_{out}) (N,Cout,Dout,Hout,Wout)
参数说明:
- N:一批数据的样本数(batch size)
- C:通道数
- D:深度(Depth)(2D 卷积中没有这个维度;视频中可理解为帧数,时序遥感影像中可理解为时间步数)
- H:高度(Height)
- W:宽度(Width)
(3)输出尺寸公式
D
o
u
t
=
⌊
D
i
n
+
2
P
d
−
K
d
S
d
⌋
+
1
D_{out} = \left\lfloor \frac{D_{in} + 2P_d - K_d}{S_d} \right\rfloor + 1
Dout=⌊SdDin+2Pd−Kd⌋+1
(H、W 方向同理)
(4)参数量
C i n × C o u t × K d × K h × K w C_{in} \times C_{out} \times K_d \times K_h \times K_w Cin×Cout×Kd×Kh×Kw
(5)典型应用场景
| 场景 | 示例 |
|---|---|
| 视频理解 | 视频分类、动作识别(C3D、I3D、SlowFast) |
| 医学影像 | CT / MRI 三维分割(3D U-Net、V-Net) |
| 3D 感知 | 体素化点云处理(VoxelNet) |
(6)与 2D 卷积的对比
| 对比点 | 2D 卷积 | 3D 卷积 |
|---|---|---|
| 滑动维度 | H, W | D, H, W |
| 卷积核维度 | 3D (C,k,k) | 4D (C,k,k,k) |
| 计算量 | 较低 | 显著增大 |
| 典型数据 | 图像 | 视频 / 体数据(如时序遥感影像等时空数据)) |
三、步长卷积(Strided Convolution)
1. 定义
步长(Stride)表示卷积核每次滑动的像素间隔。
stride = 1:逐像素滑动stride = 2:每次跳过一个像素
2. 作用
- 下采样(替代 pooling)
- 减小特征图尺寸
- 增大感受野
3. 输出尺寸计算
O u t p u t = ⌊ I n p u t − K e r n e l + 2 × P a d d i n g S t r i d e ⌋ + 1 Output = \left\lfloor \frac{Input - Kernel + 2\times Padding}{Stride} \right\rfloor + 1 Output=⌊StrideInput−Kernel+2×Padding⌋+1
四、填充卷积(Padding Convolution)
1. 为什么需要 Padding?
- 防止边缘信息丢失
- 控制输出尺寸
2. 常见 Padding 方式
| 类型 | 说明 |
|---|---|
| Valid | 不填充 |
| Same | 输出尺寸与输入相同 |
| Zero Padding | 边缘补 0 |
| Reflect / Replicate | 镜像 / 重复填充 |
五、1×1 卷积(Pointwise Convolution)
1. 定义
卷积核大小为 1×1 的卷积,又称“逐点卷积”。
关于 1×1 卷积的更多介绍,可以参考我的这篇文章:【深度学习】1×1卷积的作用与原理详解 。当然,作者本人认为本文对 1×1 卷积的介绍页足够详细了。
2. 特点:空间尺寸不变,只改变通道数
假设输入特征图
(
N
,
C
i
n
,
H
,
W
)
(N,\ C_{in},\ H,\ W)
(N, Cin, H, W),使用 1×1 卷积,卷积核个数
C
o
u
t
C_{out}
Cout,stride = 1,padding = 0,那么输出维度为:
(
N
,
C
o
u
t
,
H
,
W
)
(N,\ C_{out},\ H,\ W)
(N, Cout, H, W)
例如,输入(N, 64, 32, 32),使用 1×1 卷积,输出通道数为 128,则输出 (N, 128, 32, 32)。
也就是说,1×1 卷积只在通道维度上做线性变换,不影响空间维度。
1×1 卷积的卷积核尺寸是
(
C
i
n
,
1
,
1
)
(C_{in},\ 1,\ 1)
(Cin, 1, 1);如果有
C
o
u
t
C_{out}
Cout 个卷积核,那么形状就变为
(
C
o
u
t
,
C
i
n
,
1
,
1
)
(C_{out},\ C_{in},\ 1,\ 1)
(Cout, Cin, 1, 1)。
1×1 卷积的参数量为
C
i
n
×
C
o
u
t
C_{in} \times C_{out}
Cin×Cout,本质和一个 全连接层 是一样的参数规模(只不过共享在空间维度上)。
3. 作用
-
(1)改变通道数(升维 / 降维)
上文介绍得很清楚,容易理解。 -
(2)融合通道信息
对于固定空间位置 ( h , w ) (h, w) (h,w),输入向量
x h , w = [ x 1 x 2 ⋮ x C i n ] \mathbf{x}_{h,w} = \begin{bmatrix} x_1 \\ x_2 \\ \vdots \\ x_{C_{in}} \end{bmatrix} xh,w= x1x2⋮xCin 经过 1 × 1 1\times 1 1×1 卷积后的输出是通过线性变换得到的:
y h , w = W x h , w + b , W ∈ R C o u t × C i n . \mathbf{y}_{h,w} = W \mathbf{x}_{h,w} + b, \qquad W \in \mathbb{R}^{C_{out} \times C_{in}}. yh,w=Wxh,w+b,W∈RCout×Cin.因此, 1 × 1 1\times 1 1×1 卷积在每一个空间位置上等价于对通道维度施加一次线性映射。每一个输出通道 y k = ∑ c = 1 C i n w k , c ⋅ x c y_k = \sum_{c=1}^{C_{in}} w_{k,c} \cdot x_c yk=∑c=1Cinwk,c⋅xc,也就是说每个输出通道都是 所有输入通道的加权组合,也就是“通道融合”的含义。
相比于 3×3 卷积同时在 空间维度 + 通道维度 做操作,空间信息和通道信息混在一起,1×1 卷积完全不看邻域,只关注同一空间位置的通道关系,所以它更纯粹地建模通道之间的依赖关系。 -
(3)减少计算量(配合其他卷积)
4. 经典应用
- Inception
- ResNet
- MobileNet
👉 如果你把每个像素点当作一个样本,输入特征 C i n C_{in} Cin,输出特征 C o u t C_{out} Cout,那么 1×1 卷积 ≈ 对每个像素点做一次FC,权重在所有空间位置共享,所以它表达能力强、参数量小,非常适合做特征重组,本质是对每个像素点做一次全连接。
六、分组卷积(Group Convolution)
1. 思想
将输入通道分成 G 组,每组分别进行卷积。

(此处参考:分组卷积 Group Converlution)
2. 参数量
C i n × C o u t × K × K G \frac{C_{in} \times C_{out} \times K \times K}{G} GCin×Cout×K×K
3. 优缺点
优点
- 减少参数量
- 降低计算成本
缺点
- 不同组之间信息隔离
4. 典型模型
- AlexNet
- ResNeXt
七、深度卷积(Depthwise Convolution)
1. 定义
👉 每个输入通道单独使用一个卷积核,没有进行通道融合
上文中所提到的常规卷积每个卷积核是同时操作输入图片的每个通道。不同于常规卷积操作,Depthwise Convolution的一个卷积核负责一个通道,一个通道只被一个卷积核卷积。
2. 参数量
C
i
n
×
K
×
K
C_{in} \times K \times K
Cin×K×K
相比普通卷积大幅减少。
3. 特点
(此处参考:Depthwise卷积与Pointwise卷积)
Depthwise Convolution完成后的Feature map数量与输入层的通道数相同,无法扩展Feature map;而且这种运算对输入层的每个通道独立进行卷积运算,没有有效的利用不同通道在相同空间位置上的feature信息;因此往往需要Pointwise Convolution来将这些Feature map进行组合生成新的Feature map。
Pointwise Convolution的运算与常规卷积运算非常相似(也就是前文所说的 “1×1卷积” ),它的卷积核的尺寸为 1×1×C,C为上一层的通道数。所以这里的卷积运算会将上一步的map在深度方向上进行加权组合,生成新的Feature map。有几个卷积核就有几个输出Feature map。
这样拆成两步和常规卷积有什么不同呢?请看下文的 “深度可分离卷积(Depthwise Separable Convolution)”。
八、深度可分离卷积(Depthwise Separable Convolution)
Depthwise(DW) 卷积与Pointwise(PW) 卷积,合起来被称作 深度可分离卷积(Depthwise Separable Convolution),该结构和常规卷积操作类似,可用来提取特征,但相比于常规卷积操作,其参数量和运算成本较低。所以在一些轻量级网络中会碰到这种结构如MobileNet。
本节内容参考了:Depthwise卷积与Pointwise卷积 。
1. 定义
深度可分离卷积(Depthwise Separable Convolution)是将一个完整的卷积运算分解为两步进行:Depthwise Convolution 和 Pointwise Convolution。
- Depthwise Convolution(空间特征提取)
第二节所说的普通卷积每个卷积核是同时操作输入图片的每个通道,Depthwise Convolution 的一个卷积核只负责一个通道,一个通道只被一个卷积核卷积。
如下图所示,对一张D×W像素、C通道彩色输入图片(shape为
D
×
W
×
C
i
n
D×W×C_{in}
D×W×Cin,下图中
D
×
W
×
C
i
n
=
5
×
5
×
3
D×W×C_{in}=5×5×3
D×W×Cin=5×5×3),Depthwise Convolution 首先经过第一次卷积运算,请注意不同于普通卷积,DW完全是在二维平面内进行。卷积核的数量与上一层的通道数相同(通道和卷积核一一对应)。所以一个C通道的图像经过运算后生成了C个Feature map (如果有same padding则尺寸与输入层相同为D×W):

其中一个Filter只包含一个大小为K×K的Kernel(上图中K=3),卷积部分的参数个数(图中参数量=27):
N
d
e
p
t
h
w
i
s
e
=
C
i
n
×
K
×
K
N_{depthwise} = C_{in} × K × K
Ndepthwise=Cin×K×K
- Pointwise Convolution(通道融合)
Pointwise Convolution 的卷积核的尺寸为 1 × 1 × C i n 1×1×C_{in} 1×1×Cin, C i n C_{in} Cin为上一层的通道数。所以这里的卷积运算会将上一步的 map 在深度方向上进行加权组合,生成新的 Feature map。有几个卷积核就有几个输出Feature map(这一点与普通卷积是类似的)。如下图所示:

由于采用的是1×1卷积的方式,Pointwise Convolution中卷积涉及到的参数个数可以计算为(本图中为12):
N
p
o
i
n
t
w
i
s
e
=
1
×
1
×
C
i
n
×
C
o
u
t
N_pointwise = 1 × 1 × C_{in} × C_{out}
Npointwise=1×1×Cin×Cout
Pointwise Convolution与常规卷积的输出维度相同。
2. 参数量对比
深度可分离卷积的结构和常规卷积操作类似,可用来提取特征,但相比于常规卷积操作,其参数量和运算成本较低。
普通卷积:
C
i
n
×
C
o
u
t
×
K
×
K
C_{in} \times C_{out} \times K \times K
Cin×Cout×K×K
深度可分离卷积:
C
i
n
×
K
×
K
+
C
i
n
×
C
o
u
t
C_{in} \times K \times K + C_{in} \times C_{out}
Cin×K×K+Cin×Cout
👉 当 K=3 且通道数较大时,计算量可减少 80% 以上
3. 典型模型
- MobileNet v1 / v2
- Google 的 Xception
九、稀疏卷积(Sparse Convolution)
1. 定义
稀疏卷积是指卷积运算只在“非零(有效)位置”上进行,而不是在整个规则网格上做密集计算。由于跳过无效计算,所以可以节省计算和内存。
普通卷积默认认为输入是 致密的规则网格,每个位置都有有效数值。比如一张图像
H
×
W
×
C
H × W × C
H×W×C,每个像素都存在。
但是现实中大量数据是“稀疏”的,例如点云(Point Cloud)、体素化后的 3D 数据、高分辨率稀疏特征图等等,对全 0 区域做卷积是纯浪费。
| 对比点 | 普通卷积 | 稀疏卷积 |
|---|---|---|
| 计算位置 | 所有网格 | 仅非零位置 |
| 数据存储 | Dense Tensor | Sparse Tensor |
| 计算复杂度 | 与分辨率强相关 | 与非零点数相关 |
| 适合场景 | 图像 | 点云 / 3D / 稀疏信号 |
对于稀疏卷积来说,稀疏的是 输入数据 / 激活位置,卷积核仍然是正常的 dense 参数 ,也就是只在部分 Active Sites(激活位置) 计算,而不是遍历整个立方体。
举个例子:假设输入的特征图是这样(● 为非零元素):
· · · · ·
· · ● · ·
· · · · ·
· ● · · ·
· · · · ·
普通卷积对 25 个位置全部计算,稀疏卷积只对 ● 附近的卷积窗口计算,其他位置直接跳过。
2. 典型应用场景
- 1️⃣ 3D 点云(自动驾驶):LiDAR 点云、3D 目标检测等。
模型:SECOND、PointPillars、VoxelNet、CenterPoint(Sparse Conv Backbone) - 2️⃣ 稀疏 2D 任务:文档分析、草图识别、事件相机(Event Camera)
- 3️⃣ 高维稀疏特征:NLP 中的 Bag-of-Words(早期)、图结构映射到网格
稀疏卷积是一种只在非零(有效)位置进行卷积计算的运算方式,用于高效处理稀疏数据,能够显著减少计算量和内存消耗,尤其适合点云和 3D 感知任务。
十、空洞卷积(Dilated / Atrous Convolution)
1. 定义
在卷积核中插入空洞,扩大感受野而不增加参数量。

2. 空洞率(Dilation Rate)
d = 1:普通卷积d = 2:每个元素间隔 1 个像素
3. 感受野计算
K e f f e c t i v e = K + ( K − 1 ) × ( d − 1 ) K_{effective} = K + (K-1)\times(d-1) Keffective=K+(K−1)×(d−1)
空洞卷积的一个作用就是扩大感受野。在比较深的网络中为了增加感受野且降低计算量,总要进行下采样 ( 例如 pooling 或 stride=2 的卷积(stride-2 convolution)),这样虽然可以增加感受野,但空间分辨率降低了。为了能不丢失分辨率,且仍然扩大感受野,可以使用空洞卷积。这在目标检测、语义分割等任务中十分有用。一方面感受野大了可以检测分割大目标,另一方面分辨率高了可以精确定位目标。空洞卷积可以扩大感受野且不需要引入额外参数,但如果把分辨率增加了,算法整体计算量肯定会增加。
此外,空洞卷积还可以捕获多尺度上下文信息(注:在图像领域的上下文可以理解为图像的邻域)。空洞卷积有一个参数dilation rate可以设置,具体含义就是在卷积核中填充 dilation rate - 1 个0,因此当设置不同 dilation rate 时,感受野就会不一样,也即获取了多尺度信息。多尺度信息在视觉任务中相当重要。
4. 应用场景
- 目标检测
- 语义分割
- Dense Prediction
代表模型
- DeepLab 系列
十一、转置卷积(Transposed Convolution)
1. 定义
此处参考:什么是转置卷积?
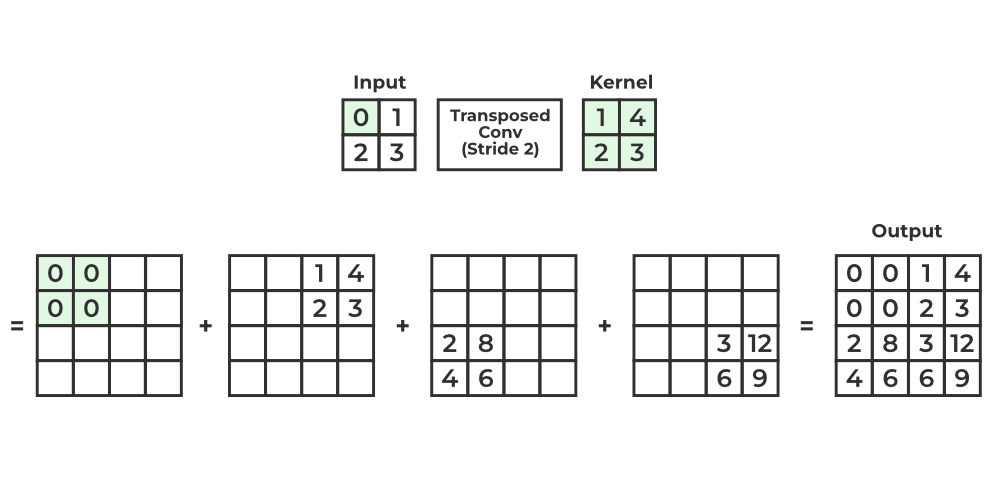
**转置卷积(Transposed Convolution)**是一种上采样方法,它生成的输出特征图大于输入特征图。有的地方也把它称为 反卷积(Deconvolution)。它可以用于多种任务,包括图像生成、图像超分、图像分割等。它们对于涉及输入数据上采样的任务尤其有用,例如将低分辨率图像转换为高分辨率图像或从一组噪声向量生成图像。
转置卷积层的工作原理与普通卷积层类似,区别在于其卷积运算方向相反。普通卷积是将卷积核在输入上滑动并逐元素进行乘法和求和,而转置卷积则是将输入在卷积核上滑动并逐元素进行乘法和求和。这样得到的输出大于输入,输出的大小可以通过层的步长和填充参数来控制。
2. 常见误解
❌ 不是卷积的逆
✅ 用于上采样
3. 作用
- 特征图放大
- 常用于解码器 / 生成模型
4. 应用
- FCN
- U-Net
- GAN
⚠️ 注意可能引入 Checkerboard Artifact
十二、亚像素卷积(Sub-pixel Convolution)
亚像素卷积是一种通过 “通道重排(Pixel Shuffle)” 实现空间分辨率提升的方法,先在低分辨率特征图上用普通卷积生成更多通道,再把这些通道重排为高分辨率图像。
⚠️Sub-pixel Convolution包括 常规卷积 + 通道重排 两方面,其中真正的卷积发生在 低分辨率空间,上采样是通过 通道 → 空间的重排 实现的。
1. 定义
假设输入特征图 I I I 的尺寸为 H × W × C H \times W \times C H×W×C,放大倍数为 r r r,输出图像的分辨率为 r H × r W rH \times rW rH×rW。
-
(1)卷积
首先使用一个普通卷积,输出通道数为 C o u t = C × r 2 C_{out} = C \times r^2 Cout=C×r2,输出张量形状为 ( H , W , C ⋅ r 2 ) (H,\ W,\ C \cdot r^2) (H, W, C⋅r2)。也就是说,卷积操作后,特征图的通道数扩大了 r 2 r^2 r2 倍。 -
(2)通过 PixelShuffle 重排通道
之后通过 PixelShuffle 重排通道,得到更高分辨率的图像:
Y = PixelShuffle ( Conv ( I ) ) Y = \text{PixelShuffle}(\text{Conv}(I)) Y=PixelShuffle(Conv(I))
具体来说,PixelShuffle 将通道维度重排为空间维度:
( H , W , C ⋅ r 2 ) ⇒ ( H ⋅ r , W ⋅ r , C ) (H,\ W,\ C \cdot r^2) \Rightarrow (H \cdot r,\ W \cdot r,\ C) (H, W, C⋅r2)⇒(H⋅r, W⋅r, C)👉 空间分辨率提高,通道数降低
PixelShuffle通过重新组织特征图中的通道,按顺序重组为高分辨率图像。 -
如果没看懂的话,我们举一个具体例子(2× 超分):
输入(H, W, 64),(1)卷积后(H, W, 64 × 2² = 256),Pixel Shuffle 后(2H, 2W, 64)。
以 (r = 2) 为例:每个低分辨率像素[a1, a2, a3, a4]
被映射成高分辨率的:
[a1 a2
 a3 a4]
👉 一个像素“拆”成了 2×2 个子像素(亚像素)
这也是 “Sub-pixel” 名字的来源。
2. 在超分领域的应用
在图像处理领域,图像超分辨率(Super-Resolution, SR)任务的目的是从低分辨率图像重建出高分辨率图像,以获取更精细的细节信息,在医学影像、卫星成像、视频增强等领域具有广泛的应用价值。而 亚像素卷积(Sub-pixel Convolution) 作为一种高效的 SR 方法,因其简单、高效、易于实现等特点受到广泛关注。
亚像素卷积通过重排通道来增加图像的分辨率。它首先使用卷积操作来增加通道维度,并将这些额外的通道作为像素数据,通过 PixelShuffle 操作将其重新组织到空间维度,实现图像的分辨率的扩大。
3. 典型应用场景
- 1️⃣ 图像超分辨率:ESPCN(Sub-pixel Conv 首次提出)、EDSR、SRGAN / ESRGAN(部分版本)
- 2️⃣ 视频超分 / 重建
亚像素卷积通过在低分辨率空间生成高维通道特征,并利用 Pixel Shuffle 将通道重排为空间维度,实现高效、稳定的上采样,广泛应用于超分辨率任务。
十三、可变形卷积(Deformable Convolution)
1. 核心思想
提出可变形卷积(Deformable Convolution)的论文:Deformable Convolutional Networks
此处的介绍参考:可变形卷积(DCN,Deformable Convolution Network)
常规卷积对输入的特征图在固定的位置(其窗口中)进行采样,这样做会产生一些问题,比如卷积核权重的固定导致同一CNN在处理一张图的不同位置区域的时候感受野尺寸都相同,这对于编码位置信息的深层卷积神经网络是不合理的。因为不同的位置可能对应有不同尺度或者不同形变的物体,这些层需要能够自动调整尺度或者感受野的方法。再比如,目标检测的效果很大程度上依赖于基于特征提取的边界框,这并不是最优的方法,尤其是对于非网格状的物体而言。

可变形卷积(Deformable Convolution) 的卷积核采样点位置可学习(下图中,(a)是普通的卷积操作,(b)、©、(d)是可变形卷积(deformable convolution,即DConv)),从而实现自适应形变。

2. 具体实现

首先把特征图输入一个卷积层conv(绿色边框,里面是白色的那个,卷积核大小为 k × k k×k k×k),输出 offset field(通道数变为 2 N 2N 2N,其中 N = k 2 N=k^2 N=k2。输出通道为 2 N = 2 k 2 2N=2k^2 2N=2k2 个的原因是:一共有 N = k 2 N=k^2 N=k2 个采样点,每个采样点需要有 x 方向偏移、 y 方向偏移)。这样就改变了原conv的采样点。
3. 优势
- 更好建模几何变化
- 对目标检测效果显著提升
4. 应用
- Deformable ConvNets
- 目标检测(如 Faster R-CNN)
十四、金字塔卷积(Pyramidal Convolution)
此处参考:金字塔卷积:Pyramidal Convolution
论文:Pyramidal Convolution: Rethinking Convolutional Neural Networks for Visual Recognition
1. 定义

PyConv 的示意如上图所示,从上往下卷积核的大小依次减小,同时在通道维度上,通道的数目依次增加(大卷积核的意思是感受野大,所以更关注全局特征,信息更抽象、更粗糙,不需要太多通道来表达,输出少量通道就能概括全局结构),最后将得到的 feature map 拼接起来。
例如:如下图所示,首先是 9×9 的卷积,16个卷积核(有多少个卷积核就会输出多少张特征图,参见普通卷积的介绍中关于通道数变化的计算),分为16组(此处参考“分组卷积”部分的介绍),因此生成 16×16=256 个 feature map(也就是输出的通道的个数);然后是 7×7 的卷积,16个卷积核,分为8组,因此生成 16×8=128 个 feature map;接着是 5×5 的卷积,16个卷积核,分为4组,因此生成 16×4=64 个 feature map;最后是 3×3 的卷积,16个卷积核,只有1组,因此生成 16×1=16 个 feature map。然后,会用1×1的卷积来使输出的维度都为 256。

2. 作用
当前CNN的实际感受野往往不足,且在下采样过程中很多的细节信息会丢失。在很多图片中,有的物体尺寸较大(建筑、沙发),有的物体尺寸较小(行人,书本)。这种尺寸的变化是普通的卷积难以适应的。金字塔卷积(Pyramid Convolution, PyConv) 包含不同尺度的卷积核,可以提取多尺度信息。
结语
卷积的演进本质是三点权衡:
- 感受野
- 计算效率
- 特征表达能力
理解不同卷积的设计动机,比死记公式更重要。在实际工程中,根据任务选择合适的卷积结构,往往比盲目堆模块更有效。
如果你在读论文的过程中还发现了有什么常用的卷积,欢迎在评论区留言,我会补充在本文中的!😄
更多推荐

 28
 0
- 0


 已为社区贡献5条内容

所有评论(0)