
机器学习——knn算法
目录
机器学习
机器学习是人工智能的核心分支,通过算法使计算机从数据中学习规律并做出预测或决策,无需显式编程。其核心任务包括分类、回归、聚类、强化学习等。
主要类型
监督学习:使用带标签的数据训练模型,如线性回归、决策树、支持向量机(SVM)。
无监督学习:从无标签数据中发现模式,如K均值聚类、主成分分析(PCA)。
强化学习:通过试错与奖励机制优化行为,典型算法包括Q学习、深度强化学习(DRL)。关键技术
特征工程:提取或转换数据特征以提升模型性能,包括归一化、降维等。
模型评估:使用准确率、召回率、F1分数等指标,结合交叉验证避免过拟合。
深度学习:基于神经网络的子领域,适用于图像、语音等复杂任务,如CNN、RNN。
应用场景
- 自然语言处理(NLP):机器翻译、情感分析。
- 计算机视觉:人脸识别、自动驾驶。
- 推荐系统:电商个性化推荐。
注:使用机器学习算法时需要安装一下库numpy scipy matplotlib pandas sklearn库
KNN算法简介
K最近邻(K-Nearest Neighbors,KNN)是一种基于实例的监督学习算法,适用于分类和回归任务。其核心思想是通过测量不同样本之间的距离,找到待预测样本的K个最近邻居,根据邻居的类别或数值进行预测。
工作原理
-
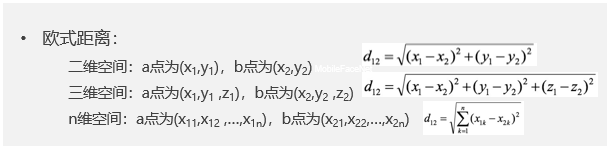
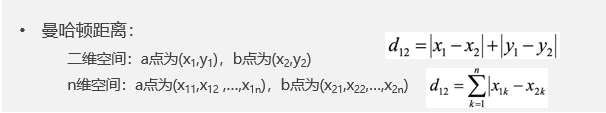
距离计算:使用欧氏距离、曼哈顿距离或其他度量方式计算待预测样本与训练集中所有样本的距离。欧氏距离公式如下:
2选择邻居:根据距离排序,选取距离最近的K个样本作为邻居。
3投票或平均:分类任务中采用多数投票法确定类别;回归任务中取邻居目标值的平均值作为预测结果。
关键参数与特点
- K值选择:K过小可能导致过拟合,K过大会引入噪声。通常通过交叉验证确定。
- 距离权重:可对邻居的投票或贡献加权(如距离倒数),使近邻影响更大。
- 算法特点:无需训练阶段(惰性学习),但对高维数据和大数据集计算效率低。
knn分类与归回
KNN分类
在分类任务中,KNN通过统计K个最近邻居的类别标签,采用多数投票法确定待预测样本的类别。具体步骤如下:
- 计算待预测样本与训练集中每个样本的距离(如欧氏距离、曼哈顿距离等)。
- 选择距离最近的K个训练样本。
- 统计这K个样本中每个类别的出现频率。
- 将频率最高的类别作为预测结果
from sklearn.neighbors import KNeighborsClassifier
KNN回归
在回归任务中,KNN通过计算K个最近邻居的目标值平均值来预测待预测样本的值。具体步骤如下:
- 计算待预测样本与训练集中每个样本的距离。
- 选择距离最近的K个训练样本。
- 计算这K个样本目标值的平均值或加权平均值。
- 将该平均值作为预测结果。
from sklearn.neighbors import KNeighborsRegressor
代码示例(Python)
数据集是datingTestSet2.txt
import pandas as pd

data = pd.read_csv('datingTestSet2.txt',sep='\t', header=None)

train_data = data.iloc[:700,:]
train_x = train_data.iloc[:,:-1]
train_y = train_data.iloc[:,-1]

test_data = data.iloc[700:,:]
test_x = test_data.iloc[:,:-1]
test_y = test_data.iloc[:,-1]

'''z标准化'''
from sklearn.preprocessing import scale
data_tra = pd.DataFrame(scale(train_x), columns=train_x.columns)

from sklearn.neighbors import KNeighborsClassifier
knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(data_tra,train_y)

'''自测'''
train_predicted = knn.predict(data_tra)
score1 = knn.score(data_tra,train_y)
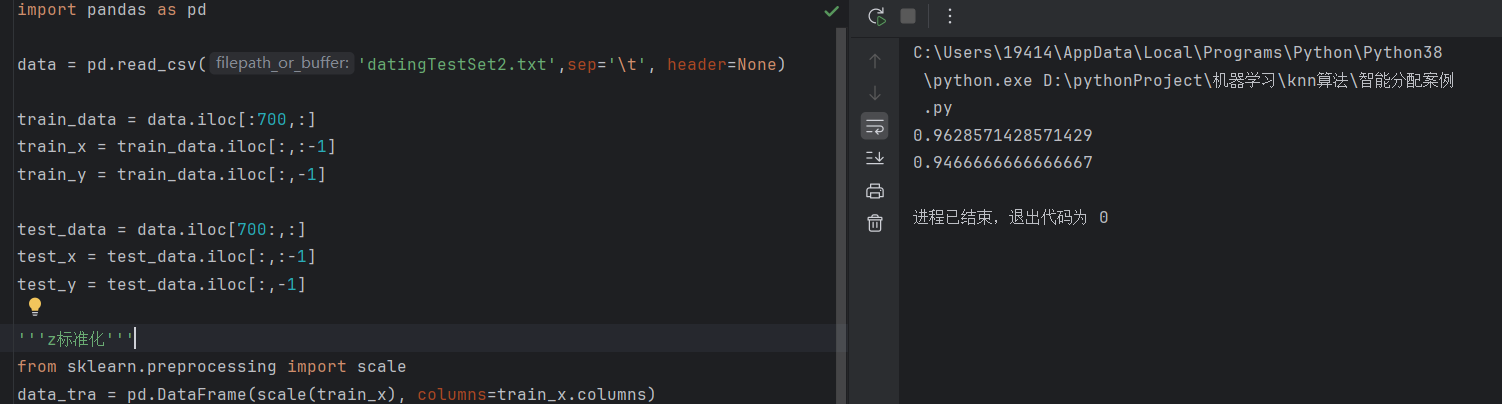
print(score1)

'''测试集测试'''
data_test = pd.DataFrame(scale(test_x), columns=test_x.columns)

test_predicted = knn.predict(data_test)
score2 = knn.score(data_test,test_y)
print(score2)
运行结果
优缺点
优点:
1.简单,易于理解,易于实现,无需训练;
2.适合对稀有事件进行分类;
3.对异常值不敏感。
缺点︰
1.样本容量比较大时,计算时间很长;
⒉.不均衡样本效果较
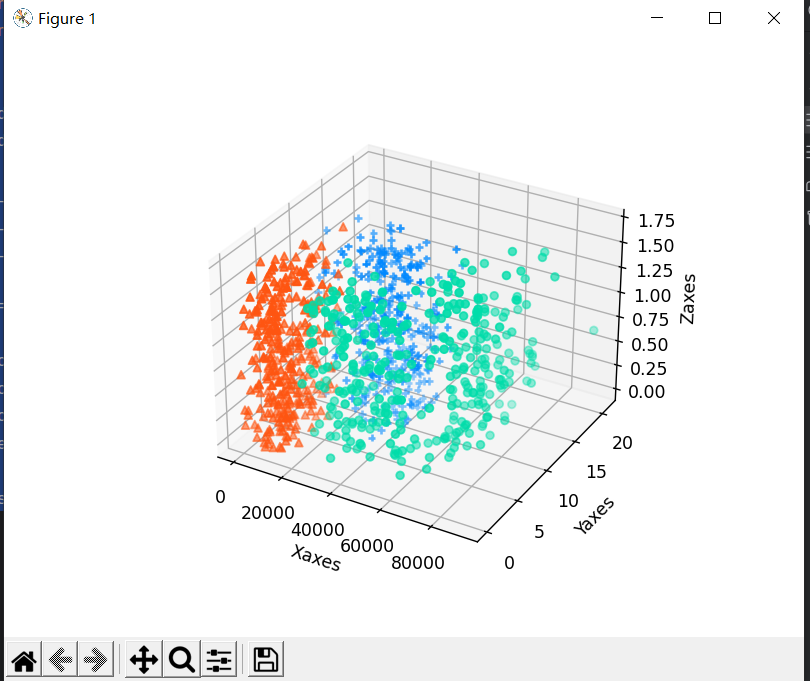
上述实例数据画图
代码:
import matplotlib.pyplot as plt
import numpy as np

data = np.loadtxt('datingTestSet2.txt')
y = data[:,-1]
x = data[:,:-1]

data_y1 = data[data[:,-1]==1]
data_y2 = data[data[:,-1]==2]
data_y3 = data[data[:,-1]==3]

fig = plt.figure()
ax = fig.add_subplot(projection='3d')
ax.scatter(data_y1[:,0],data_y1[:,1],zs=data_y1[:,2],c="#00DDAA",marker='o')
ax.scatter(data_y2[:,0],data_y2[:,1],zs=data_y2[:,2],c="#FF5511",marker='^')
ax.scatter(data_y3[:,0],data_y3[:,1],zs=data_y3[:,2],c="#0088FF",marker='+')
ax.set(xlabel="Xaxes",ylabel="Yaxes",zlabel="Zaxes")

plt.show()
效果图:
matplotlib画图
安装与导入
确保已安装 matplotlib 库,可通过以下命令安装和使用:
pip install matplotlib
import matplotlib.pyplot as plt
import numpy as np
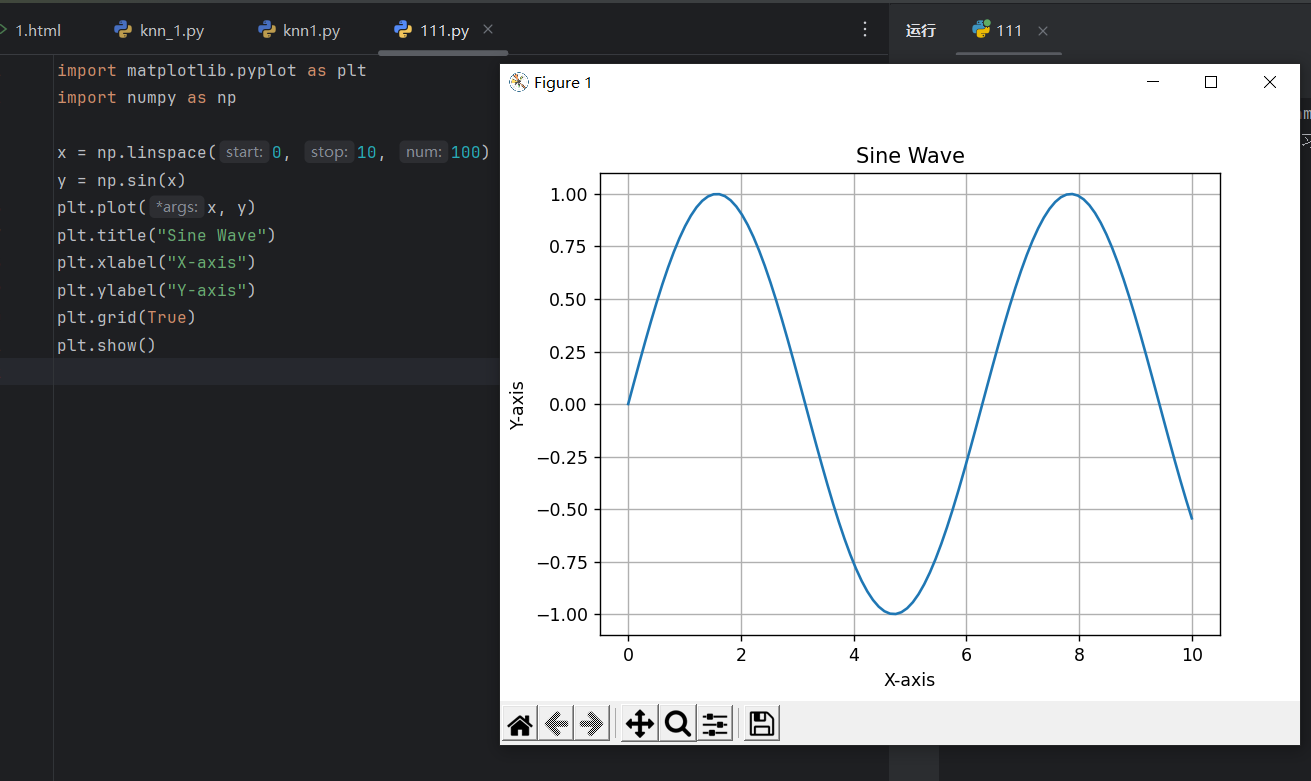
绘制简单折线图
折线图适合展示数据随时间或有序类别的变化趋势。使用plot()函数即可绘制,需准备x轴和y轴生成数据并绘制折线图:
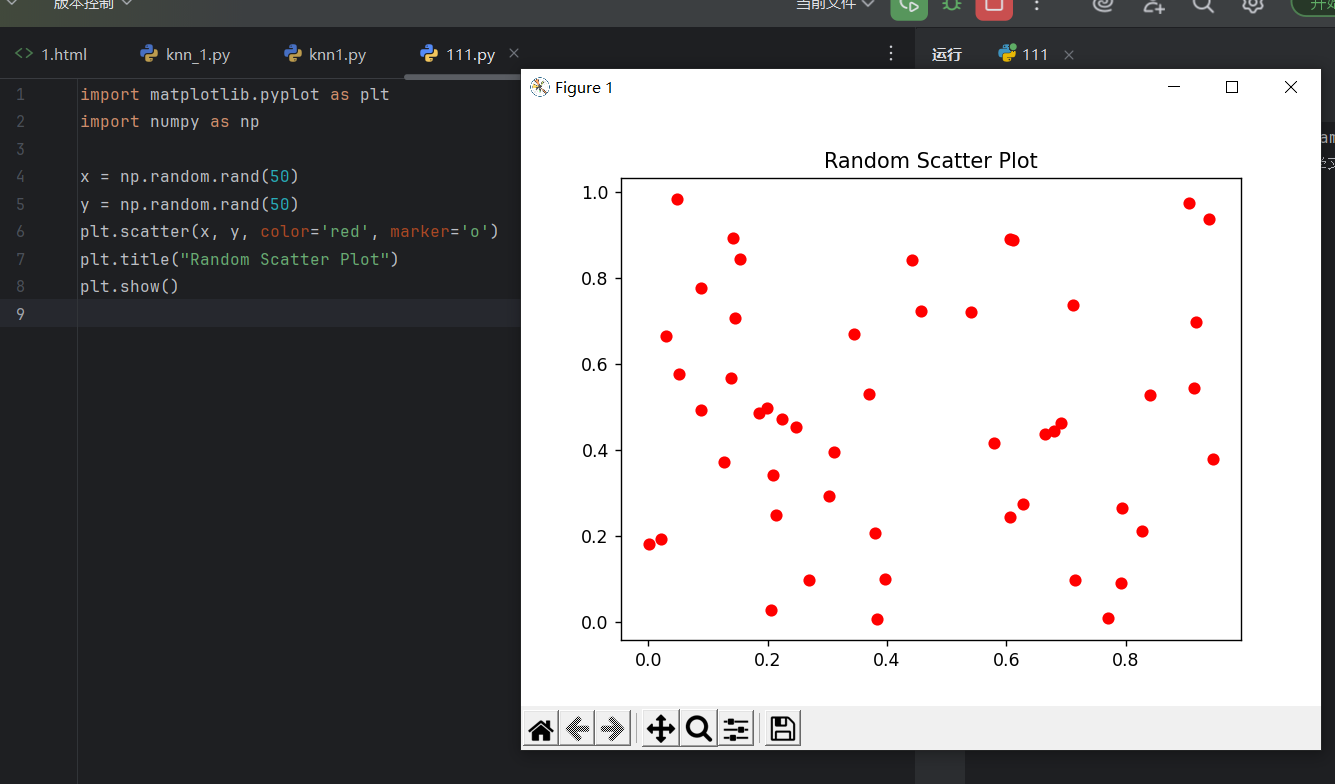
绘制散点图
散点图用于展示两个变量之间的关系或分布。使用scatter()函数,可自定义点的大小和颜色使用随机数据绘制散点图:
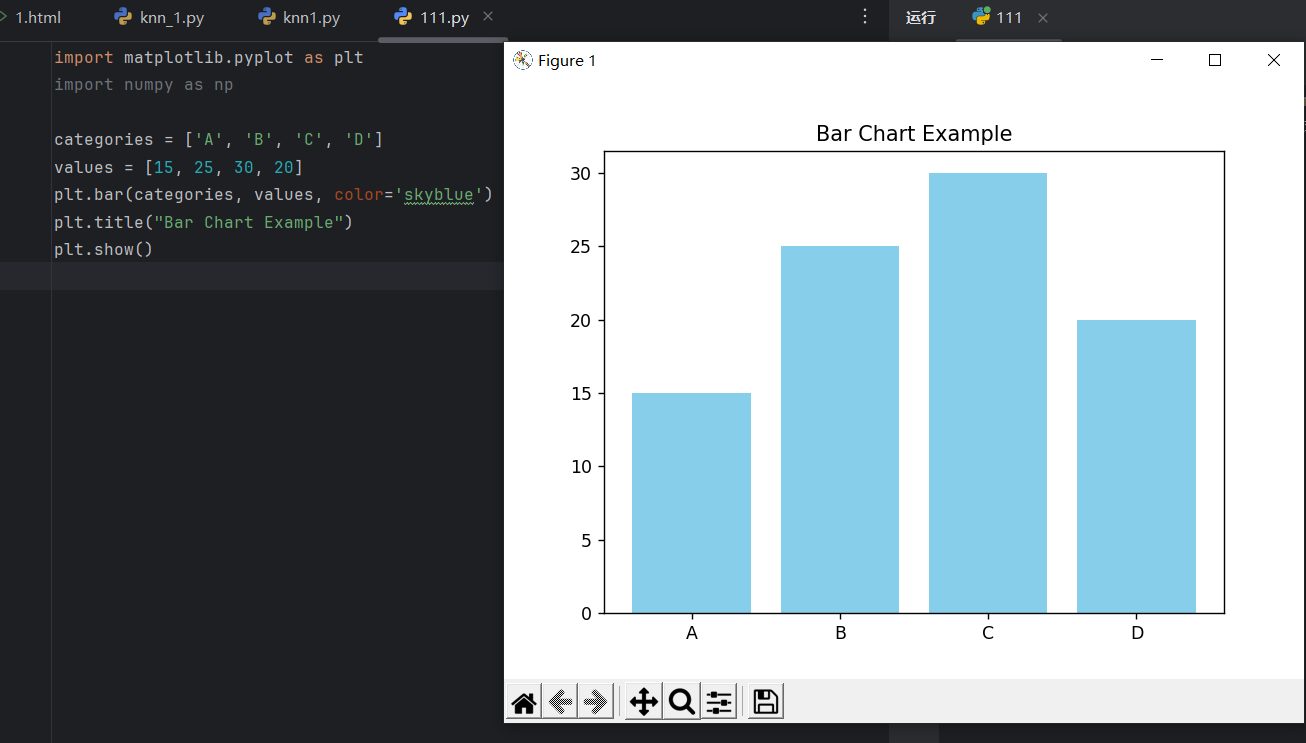
绘制柱状图
柱状图适用于分类数据对比。bar()函数可绘制垂直柱状图,barh()可绘制水平柱状图示例数据与柱状图绘制:
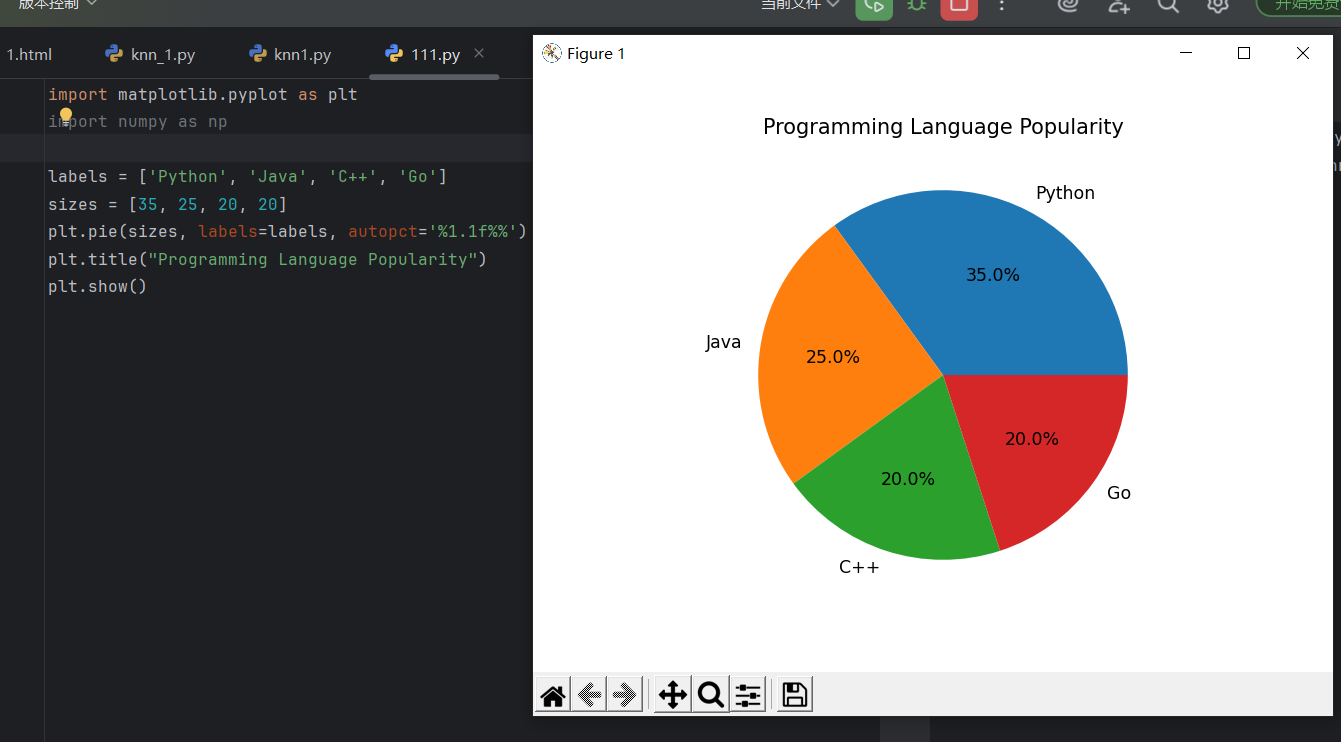
绘制饼图
饼图用于显示各部分占总体的比例。通过pie()函数实现,可突出显示某部分展示比例分布的饼图:
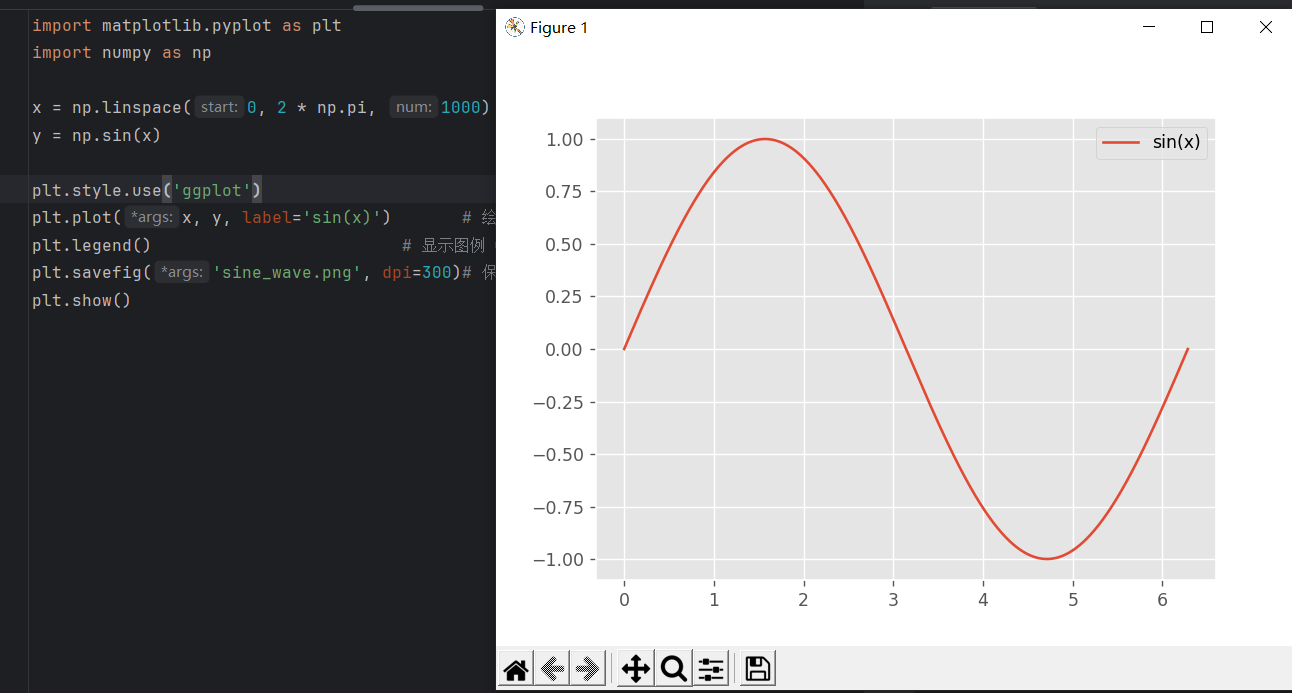
自定义样式与保存
设置全局样式并保存图像:
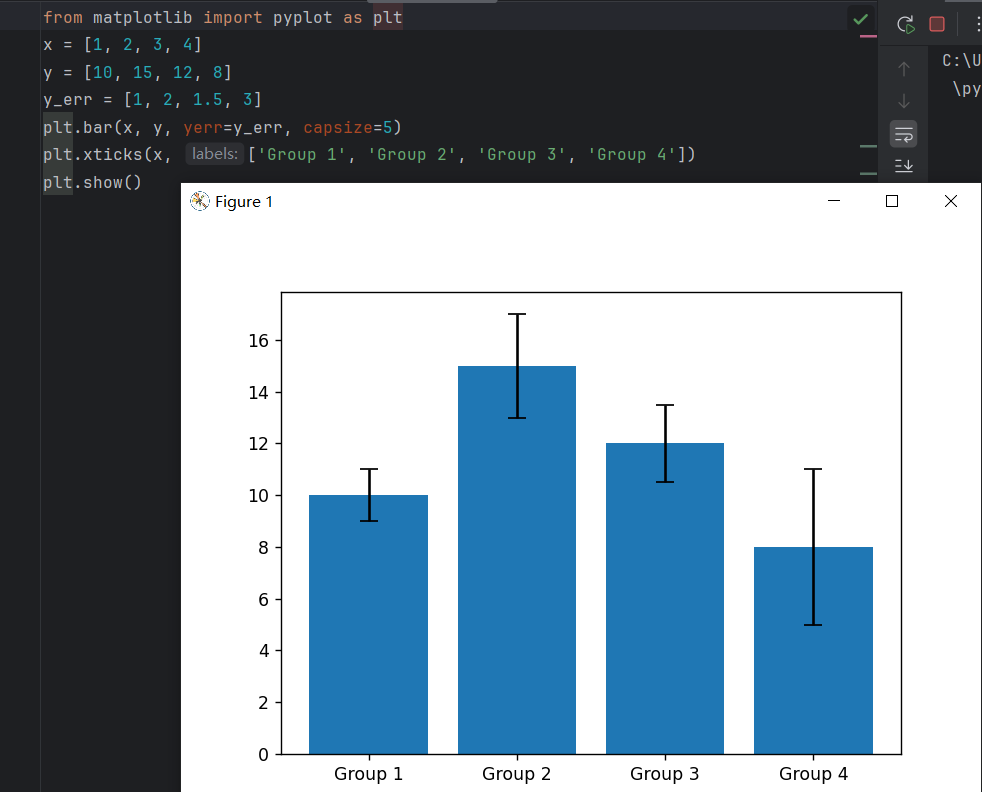
高级功能
绘制带有误差棒的柱状图:
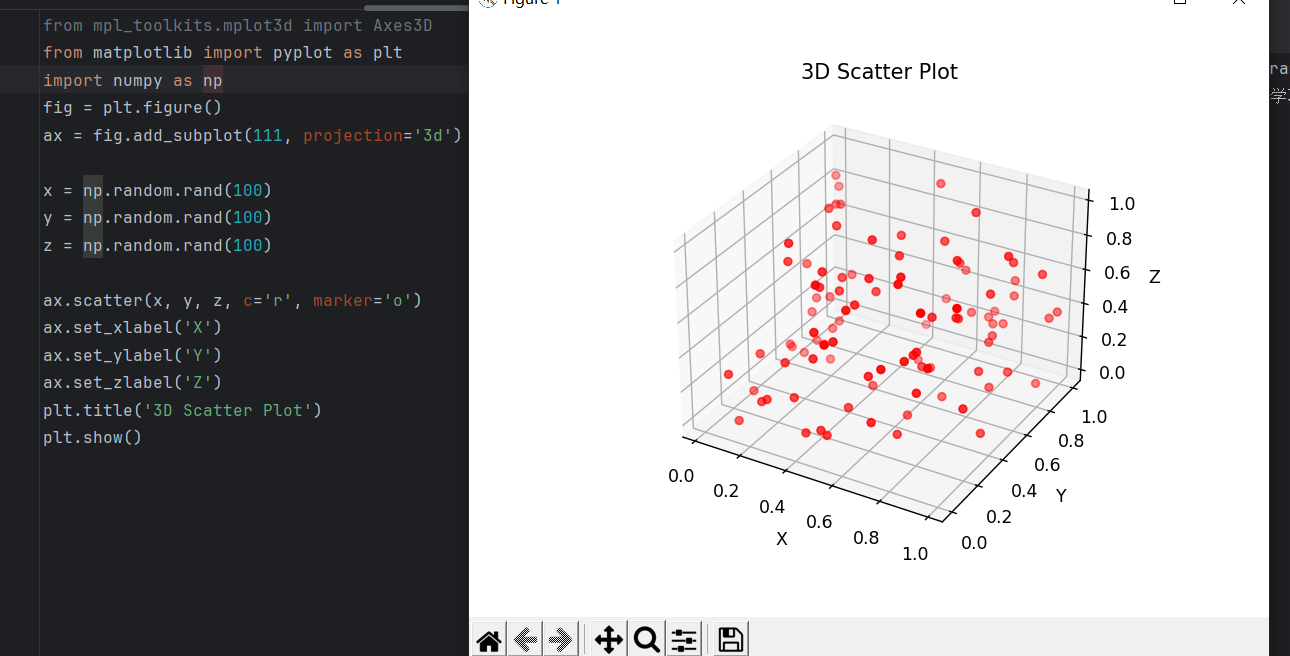
3D 绘图
Matplotlib的mpl_toolkits.mplot3d模块支持3D绘图,包括散点图、曲面图和线框图。创建3D图形需先通过fig.add_subplot指定projection='3d绘制 3D 曲面图(需导入额外模块):
更多推荐


 26
 0
- 0


 已为社区贡献11条内容

所有评论(0)