
计算机基础·cs336·MoE
·
文章目录
torch前置知识
torch.expand(a,b,c)
- 扩展至(a,b,c)的维度
- 只能扩充1的维度
- 不创建新内存,类似view
x = torch.tensor([[1], [2], [3]])
x.size()
torch.Size([3, 1])
x.expand(3, 4)
tensor([[ 1,  1,  1,  1],
        [ 2,  2,  2,  2],
        [ 3,  3,  3,  3]])
x.expand(-1, 4)   # -1 means not changing the size of that dimension
tensor([[ 1,  1,  1,  1],
        [ 2,  2,  2,  2],
        [ 3,  3,  3,  3]])
torch.repeat(a,b,c)
- 每个维度分别复制a,b,c次
- 可以扩展不为1的维度
- 创建新内存
x = torch.tensor([1, 2, 3])
x.repeat(4, 2)
tensor([[ 1,  2,  3,  1,  2,  3],
        [ 1,  2,  3,  1,  2,  3],
        [ 1,  2,  3,  1,  2,  3],
        [ 1,  2,  3,  1,  2,  3]])
x.repeat(4, 2, 1).size()
torch.Size([4, 2, 3])
torch.nonzero(as_tuple=False):
- 返回向量维度为(z,n_dim),z表示有多少个匹配的非0元素,n_dim表示对应坐标。
torch.nonzero(torch.tensor([1, 1, 1, 0, 1]))
tensor([[ 0],
        [ 1],
        [ 2],
        [ 4]])
torch.nonzero(torch.tensor([[0.6, 0.0, 0.0, 0.0],
                            [0.0, 0.4, 0.0, 0.0],
                            [0.0, 0.0, 1.2, 0.0],
                            [0.0, 0.0, 0.0,-0.4]]))
tensor([[ 0,  0],
        [ 1,  1],
        [ 2,  2],
        [ 3,  3]])
torch.nonzero(torch.tensor([1, 1, 1, 0, 1]), as_tuple=True)
(tensor([0, 1, 2, 4]),)
torch.nonzero(torch.tensor([[0.6, 0.0, 0.0, 0.0],
                            [0.0, 0.4, 0.0, 0.0],
                            [0.0, 0.0, 1.2, 0.0],
                            [0.0, 0.0, 0.0,-0.4]]), as_tuple=True)
(tensor([0, 1, 2, 3]), tensor([0, 1, 2, 3]))
torch.nonzero(torch.tensor(5), as_tuple=True)
(tensor([0]),)
torch.index_select
torch.index_select(input, dim, index, *, out=None) → Tensor- 指定维度选择指定坐标的元素
# dim=0
tensor([[[20, 21, 22, 23, 24],
         [25, 26, 27, 28, 29],
         [30, 31, 32, 33, 34],
         [35, 36, 37, 38, 39]]])
# dim=1
tensor([[[ 5,  6,  7,  8,  9]],

        [[25, 26, 27, 28, 29]]])
# dim=2
tensor([[[ 1],
         [ 6],
         [11],
         [16]],

        [[21],
         [26],
         [31],
         [36]]])
# 索引后的数组尺寸,除了dim部分,其他和原来大小一样
# 原始
torch.Size([2, 4, 5])
# dim=0
torch.Size([1, 4, 5])
# dim=1
torch.Size([2, 1, 5])
# dim=2
torch.Size([2, 4, 1])
MoE 混合专家
核心思想
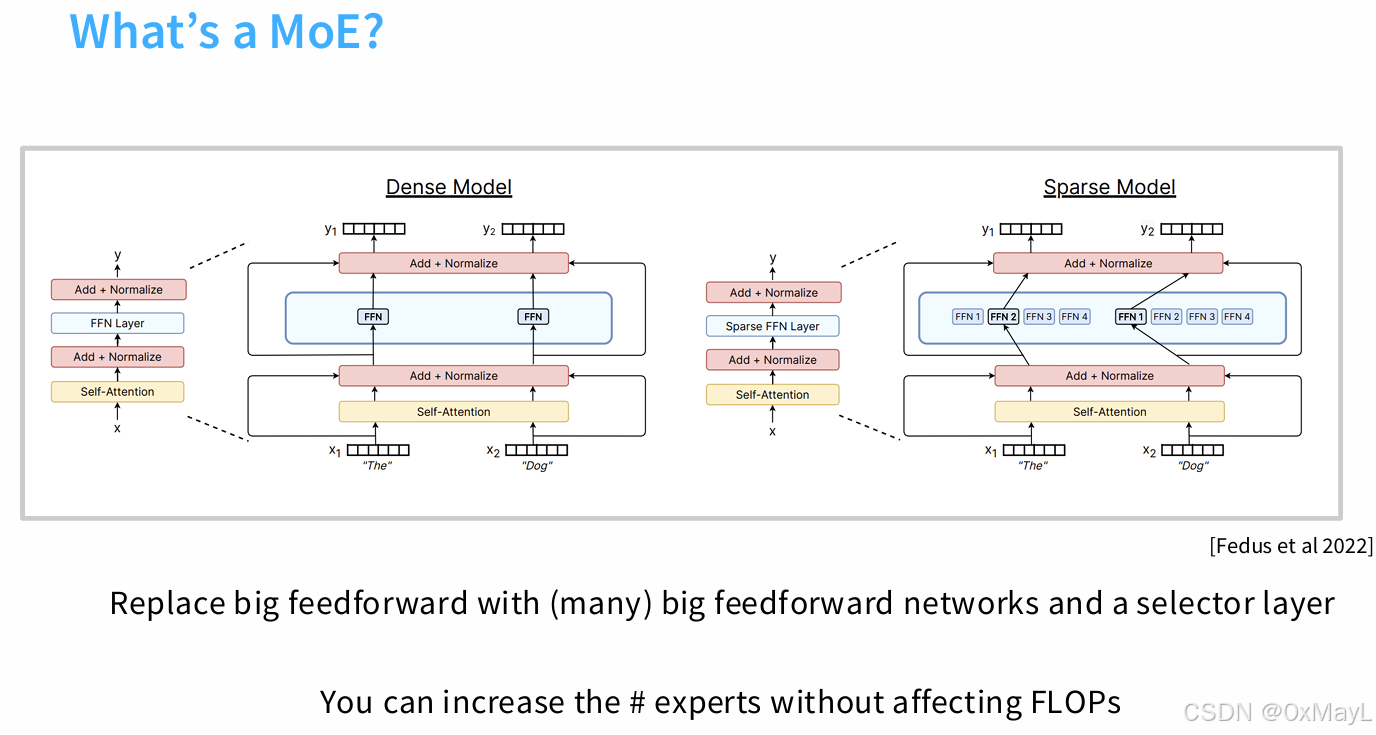
混合专家模型(Mixture of Experts,MoE)是一种先进的神经网络架构,旨在通过整合多个模型或“专家”的预测来提升整体模型性能。MoE模型的核心思想是将输入数据分配给不同的专家子模型,然后将所有子模型的输出进行合并,以生成最终结果。这种分配可以根据输入数据的特征进行动态调整,确保每个专家处理其最擅长的数据类型或任务方面,从而实现更高效、准确的预测。
优势
- 模型索然很大,但是推理速度快。例如同样的FLOPs,由于只激活少数专家,实际激活参数量比较低,推理速度比同样参数的密集模型快,而且可以得到更好的结果。
- 训练起来不像密集架构那样全部参数都要训练,只有少数专家激活并参与训练
- 分布式架构:专家可以分配到不同设备上去。
劣势
- 理论上分布式,在缺乏分布式节点和计算设备时比较鸡肋。
- 训练不稳定:路由算法往往不可微分,路由算法的学习不稳定。
MoE的基本原理
MoE的架构
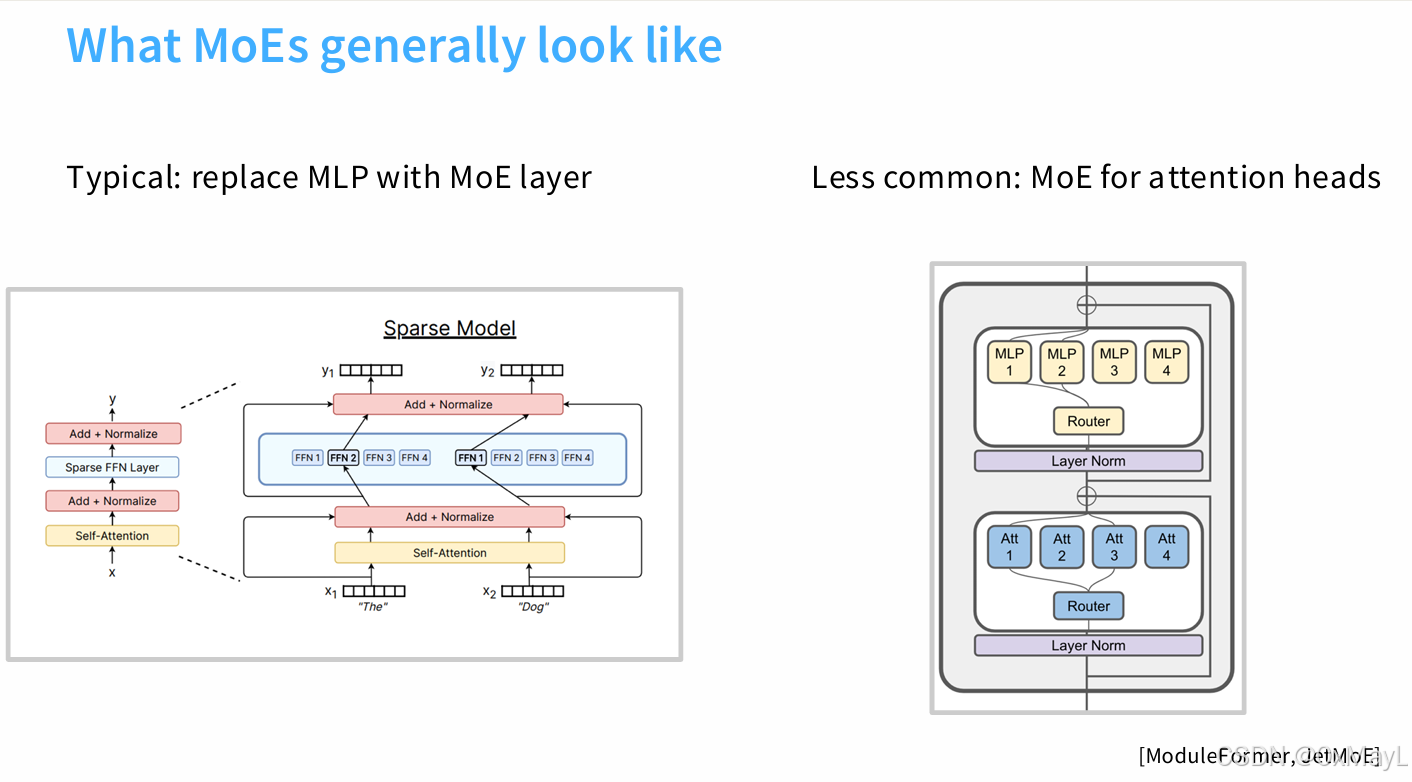
- 多个不同的MLP vs 多个不同的 Transformer头
- 注意:为了确保参数量不会爆炸,MLP的d_ff通常会大幅度减小,甚至比d_model还小
路由算法
- 基本分类:为每一个token选专家 vs 为每一个专家选token
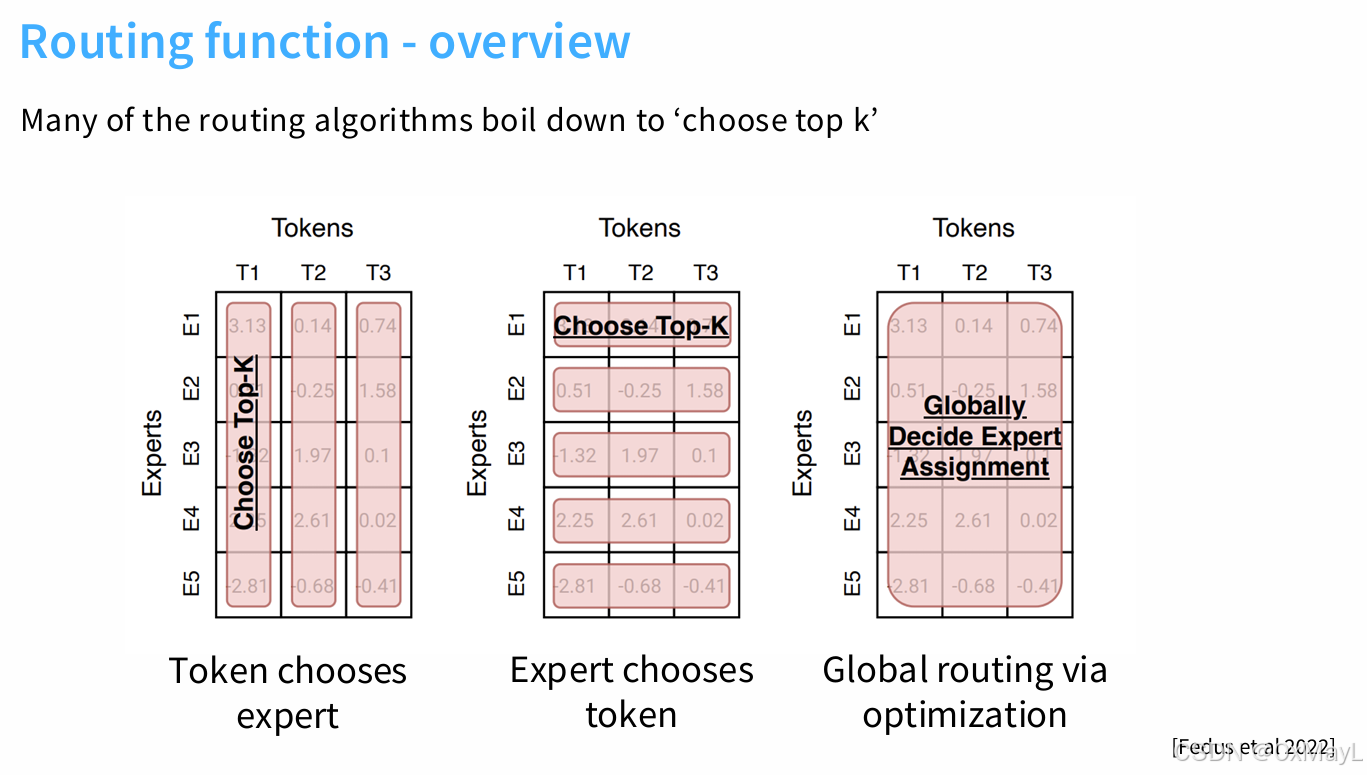
- 通常是为每一个token选专家:具体策略可以分类为 随机选择,RL算法,TOPK,哈希法。
TOPK算法
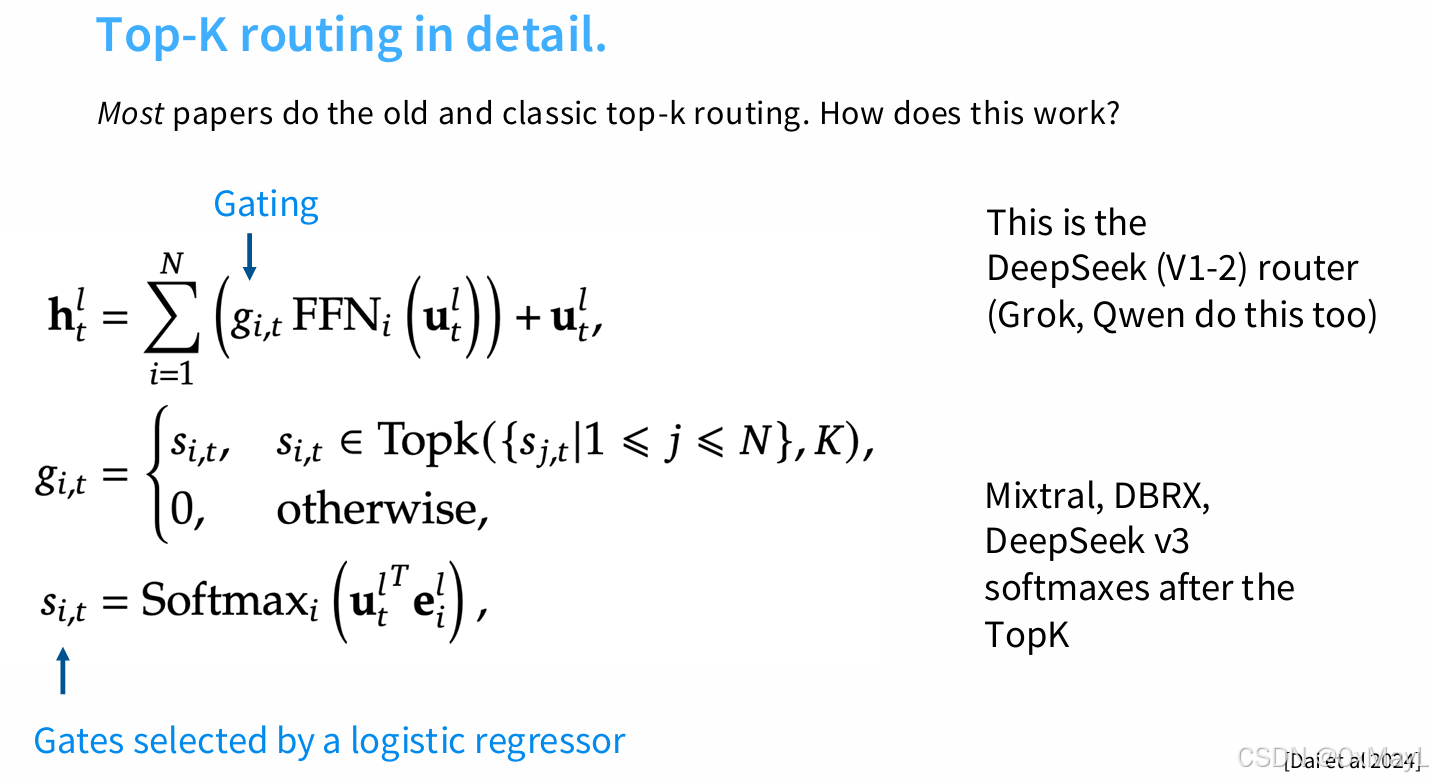
- 基本思想:将路由器认为是一个简单的MLP,给定token x,映射为专家选择的概率s,选择前K个专家。
- 将专家计算的结果和选择概率加权求和与原输入残差链接。
路由选择函数的训练目标(损失函数)
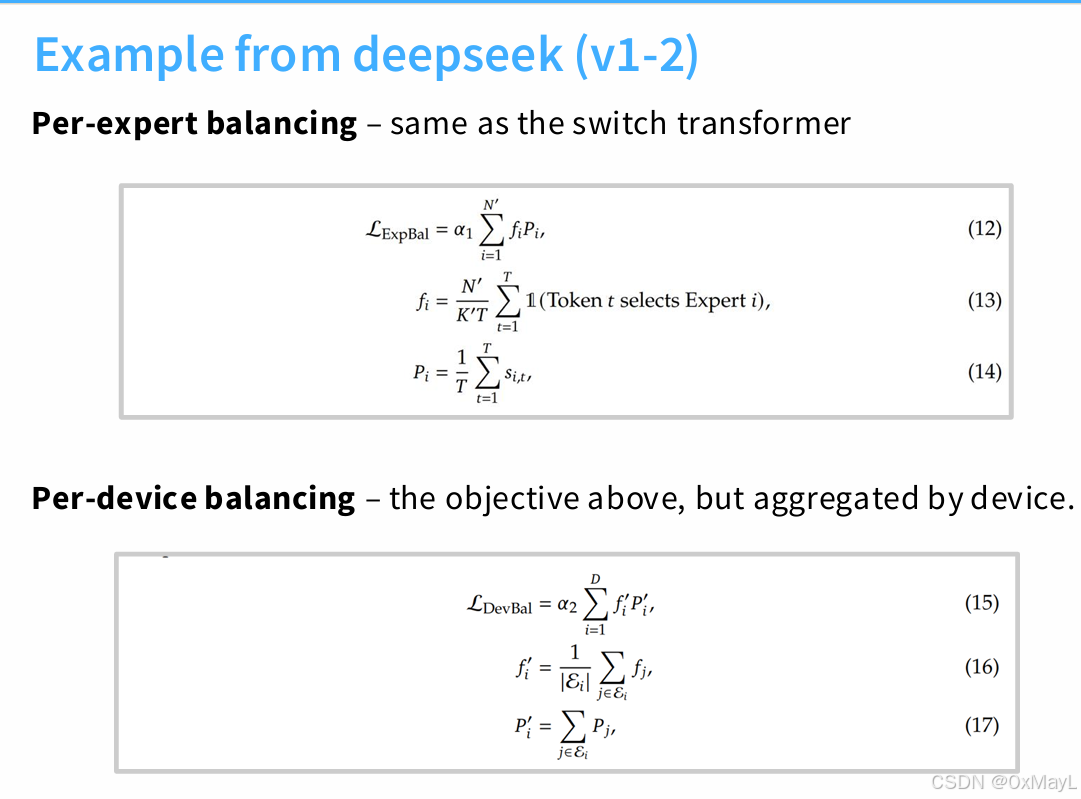
- 核心思想:避免只选择特定专家和设备
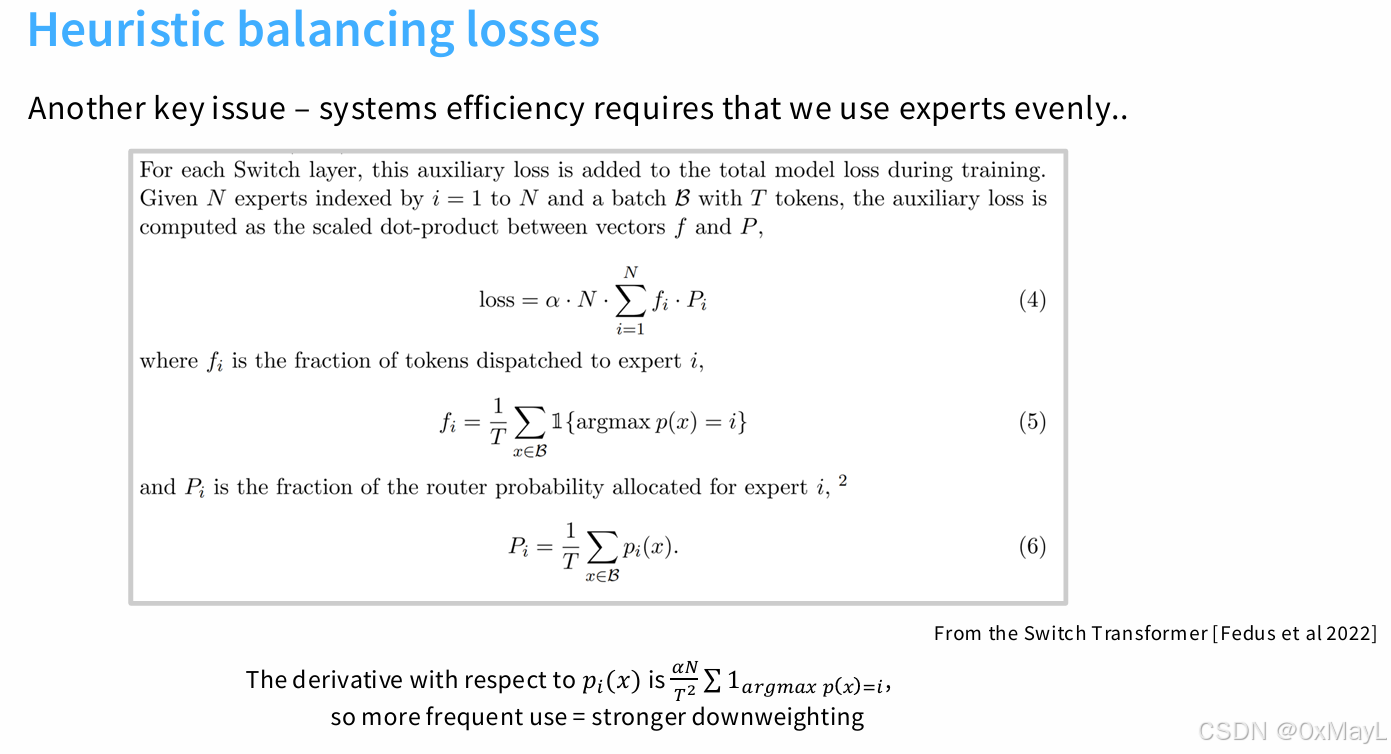
- f i f_i fi:统计所有batch/设备中实际选择专家i的比例
- P i P_i Pi :统计所有batch/设备中路由器选择专家i的概率(想选择专家i的比例)
- 惩罚路由器想选择专家i且实际选择专家i的情况。
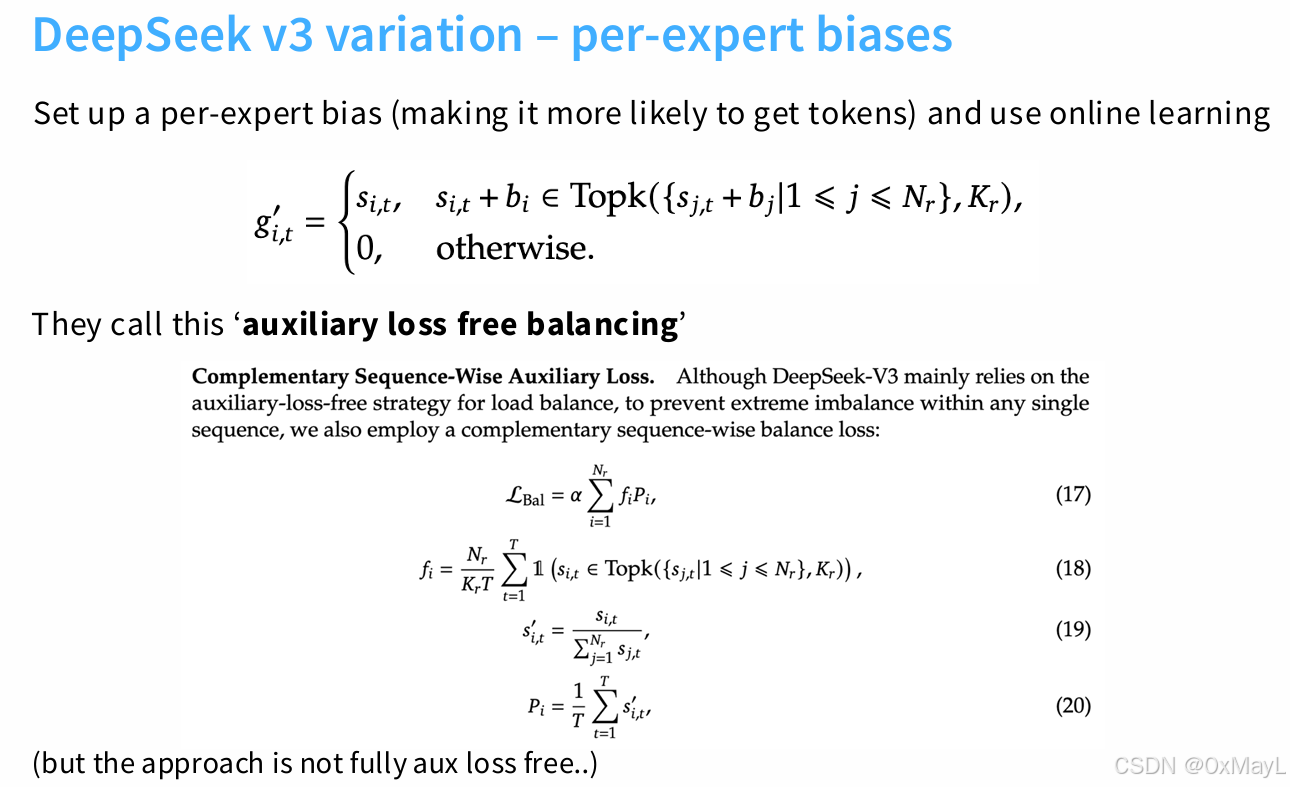
- 直接对于softmax分数进行显示调整的方法:
更多推荐

 3
 0
- 0


 已为社区贡献12条内容

所有评论(0)