
机器学习(五) 对数几率回归与极大似然法求解
上一篇讨论了如何使用线性模型进行回归学习,但是如果要做的是分类任务,如二分类其输出标记y∈{0,1},而线性回归模型产生的预测值 z=wᵀx+b 是实值,该怎么办?
5.1 对数几率回归
需要将实值z转换为0/1值,最理想的是通过"单位阶跃函数"(unit-step function)进行转换,如图所示:
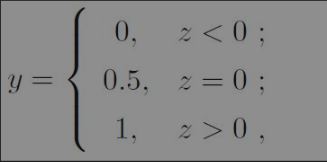
若预测值z>0则y=1判为正例,z<0则y=0判为反例,z=0则y=0.5可任意判别。
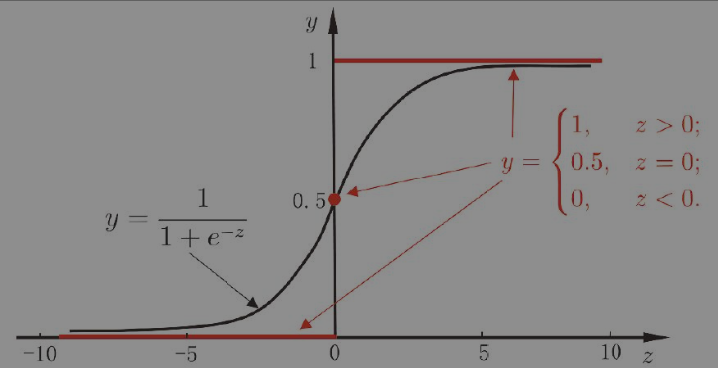
但是,单位阶跃函数不连续,希望找到能在一定程度上近似单位阶跃函数的"替代函数"(surrogate function),并且它单调可微。对数几率函数(logistic function)正是替代"单位阶跃函数"的常用函数 (对数几率函数是一种"Sigmoid函数"):
如图所示:
将需要转换的线性回归模型 z=wᵀx+b 代入,可得
变化为
<5.1.1>
z=0时y=0.5是一个临界值(可为正例或反例);
z>0时y随着z的增长也以光滑的凸曲线逐渐增长接近于1(成为正例的可能性越来越大);
z<0时y随着z的增低也以光滑的凸曲线逐渐降低接近于0(成为反例的可能性越来越大)。
y是样本x作为正例的概率,1-y是x为反例的概率,两者的比值 y/(1-y) 称为"几率"(odds),反映了x作为正例的相对可能性。<5.1.1>式实际上是用线性回归模型的预测结果去逼近真实标记的对数几率,其对应的模型称为"对数几率回归"(logit regression,有文献译为"逻辑回归")。
这种方法有很多优点,例如它是直接对类别的可能性进行建模,得到的是类别的概率预测。此外,对数几率函数是任意阶可导的凸函数,有很好的数学性质,现有的许多数值优化算法都可直接用于求取最优解。
如何求解<5.1.1>式中的w和b?
将y视为后验概率p(y=1|x),<5.1.1>式可重写为
5.2 通过"极大似然法"(maximum likelihood method)求解w和b
似然函数 L(w,b) 是所有样本条件概率的乘积:
取似然函数 L(w,b)的自然对数 (因对数函数单调递增,最大化似然等价于最大化对数似然),可得:
对w和b求偏导 (以wj为例):
p(yi=1∣xi) 是模型当前预测的概率值,而 yi 是真实标签(0或1)。导数中的 (yi−p(yi=1∣xi)) 本质上是 预测误差,用于调整参数。
由于对数似然函数 ℓ(w,b) 是凸函数 (可通过Hessian矩阵半正定证明),可通过梯度上升法迭代更新参数:
更多推荐

 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)