
大模型第二期-10分钟深度学习入门框架:pytorch精讲
各位观众老爷,有想要了解的大模型相关内容都可以评论私信,我会及时总结出来哦😀
--推一下我的机器人女友公众号-“千寻与千羽”,打造你的专属女友,赶紧尝试一下吧,有时间会出详细教程哦--
目录
一、深度学习框架
二、pytorch框架环境安装
三、pytorch张量使用
一、深度学习框架
1、什么是深度学习?
深度学习是机器学习中的一种特殊学习方法,它不依赖于数据的特征进行训练,而是自己总结特征进行预测;深度学习的主要结构就是神经网络(下一期)。
2、深度学习的框架
1)pytorch框架:Meta开发的框架,动态图模式,生态强大、入门容易,代码量少
2)Tensflow框架:Google开发的框架,静态图模式,工业部署强大,底层高效
3)PaddlePaddle框架:百度开发的框架,动态图静态图都支持,中文支持友好,适合国产化要求的项目
4)ONNX:多家国外大厂联合开发的模型文件通用格式,适用于跨框架、跨平台的模型部署
os:静态图、动态图的含义
静态图就像是提前规划好的路线,在运行之前就把整个计算流程都定义好,然后按照这个固定的流程去执行,这样可以做一些优化,让程序运行得更快。动态图呢,就比较灵活啦,它是边运行边定义计算流程,就像你走路的时候可以随时改变方向一样,更适合调试和快速开发。
二、pytorch框架环境安装
1、使用pycharmIDE进行开发,anaconda做包管理器,创建conda环境:
有需要讲解anaconda的话可以留言
最好使用管理员身份,在开始菜单找到Anaconda prompt,执行以下命令:
- 创建默认目录的conda环境:conda create -n 环境名称 python=3.12(版本号)
- 创建指定目录conda环境:conda create --prefix 绝对路径 python= 3.12(版本号)
- 切换/激活指定环境:conda activate 环境名
- 删除环境(不讲不讲,万一初学者删了出问题就完了)
- 查看所有环境:conda env list
2、nvidia相关cuda环境安装
- 查看电脑是否支持 cmd窗口执行 nvidia-smi
- 下载对应版本的驱动包:https://developer.nvidia.com/cuda-toolkit-archive
- 下载cuDNN压缩包并解压缩,注意要和cuda版本一致https://developer.nvidia.com/rdp/cudnn-archive
- 将cuDNN解压后目录下的3个文件夹和文件覆盖拷贝到cuda的v12.6(版本)目录
3、安装pytorch模块
- 下载:https://download.pytorch.org/whl/cu126/torch/,cu126是本地安装的cuda的版本号
cp310是python版本 - conda窗口到下载所在目录下
pip install "torch-2.9.1+cu126-cp310-cp310-win_amd64.whl"
4、无nvidia显卡和amd显卡,需要使用内存计算,忽略之前3步,直接
- pip install torch下载最新,不支持cuda
三、pytorch张量使用
下面详细介绍一下pytorch框架,主要分为两部分,即张量和自动微分。
张量主要作用在我看来就是对样本数据进行加工处理的,以满足模型的格式和内容需要,张量常常和numpy、pandas做数据转换,建议可以学习一下numpy和pandas。
1、张量概念分类
张量是pytorch框架的基本数据格式,其实就是数学中的数组。
0维张量也叫标量,对应数学中的数字;
1维张量也叫向量,对应数学中的一维数组;
2维张量也叫矩阵,对应数学中的二位数组;
多维张量也就是高维数组。
2、张量创建
根据指定数据创建张量
- torch.tensor()
- data = torch.tensor(10) 0维
- data = np.random.randn(2, 3) 传numpy
data = torch.tensor(data) - data = [[10., 20., 30.], [40., 50., 60.]] 传list
data = torch.tensor(data)
按照形状或根据数据创建张量
- torch.Tensor()
- data = torch.Tensor(2, 3) 2行3列
- data = torch.Tensor([10]) 一维
- data = torch.Tensor([10, 20])
创建指定类型张量torch.IntTensor、torch.FloatTensor、torch.DoubleTensor
- data = torch.IntTensor(2, 3)
- data = torch.IntTensor([2.5, 3.3])
- data = torch.ShortTensor() # int16
data = torch.LongTensor() # int64
data = torch.FloatTensor() # float32
data = torch.DoubleTensor() # float64
创建一维张量
- torch.arange(start, end, step)
- torch.linspace(start, end, steps)
创建随机张量
创建随机种子
torch.initial_seed() # 使用系统时间戳随机种子
torch.manual_seed(2026) # 自定义设置
- torch.rand(2,3) 创建数值0-1的2行3列随机张量
- torch.randn(2,3) 标准正态分布的随机张量
- torch.randint(0,10,(2,3)) 创建0-10的2行3列随机整数向量
特殊张量
- torch.ones()全1张量
- torch.zeros() 全0 张量
- torch.full([2, 3], 10) 自定义全10张量
3、类型转换
元素类型设置
- torch.tensor(dtype=) 中使用dtype指定
- t1.type(torch.DoubleTensor)
- t2=t1.int()、t2=t1.double() t2=t1.half()半精度
张量->numpy
- n1 = t1.numpy() 共享内存方式
- n1 = t1.numpy().copy() 不共享内存方式
numpy -->张量
- t1 = torch.from_numpy(n1) 共享内存方式
- t1 = torch.from_numpy(n1).clone() 不共享内存方式
- t1 = torch.tensor(numpy对象) 不共享内存方式
标量和数值转换
- num = t1.item() 获取标量数值
4、张量运算
常见运算
add、sub、mul、div、neg # 不会修改原数据
add_、sub_、mul_、div_、neg_ # 带下划线会修改原数据(共享内存)
data = torch.randint(0, 10, [2, 3])
运算函数
- 均值data.mean
- 平方torch.pow()
- 平方根 torch.sqrt()
- 求和sum()
- 指数计算 exp()
- 对数计算log()\log10()\log2()
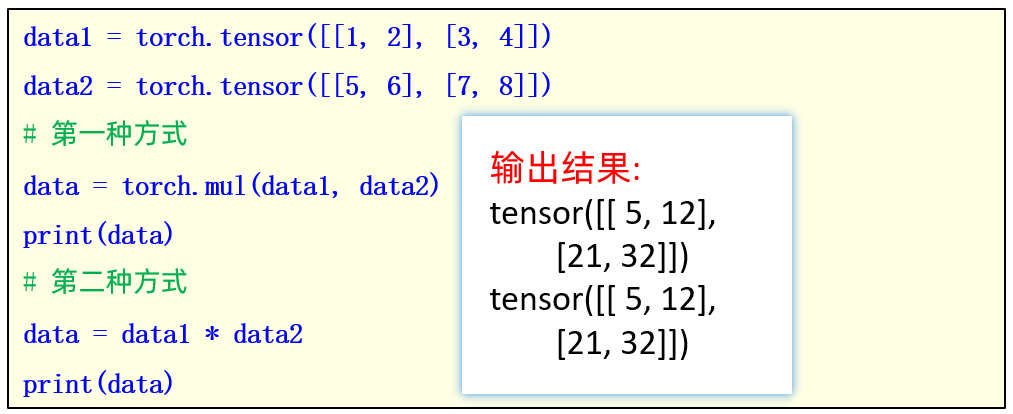
点乘:* mul()
t1 * t2,t2.mul(t1) 点乘:两个张量shape一致
对应位置相乘
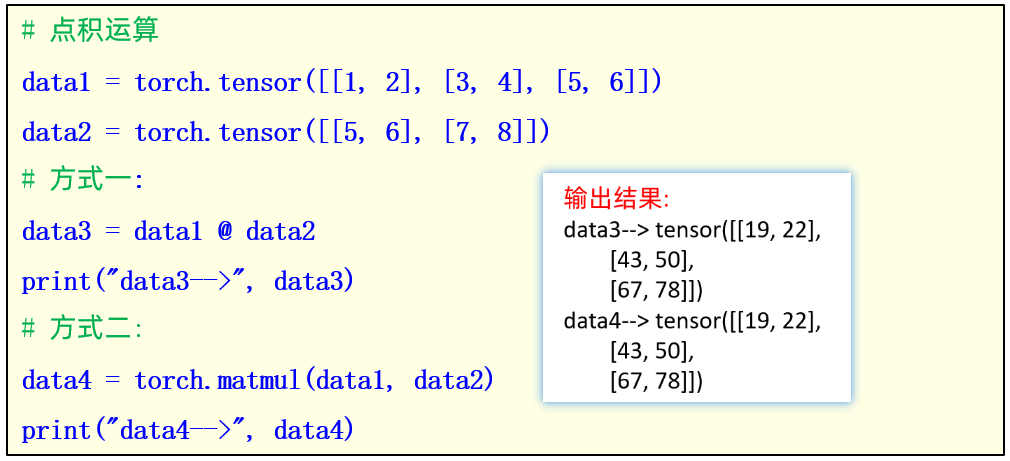
点积(矩阵乘法)
t1 @ t2 , torch.matmul(t1,t2) :矩阵乘法:t1列等于t2行
A的形状是 (m, n)
B的形状是 (n, p)
结果C的形状是 (m, p)
行列相乘
[[1, 2, 3], [4, 5, 6]] @ [[1, 2], [3, 4], [5, 6]]
第一行:[1, 2, 3] · [1, 3, 5] = 1×1 + 2×3 + 3×5 = 22
第一行:[1, 2, 3] · [2, 4, 6] = 1×2 + 2×4 + 3×6 = 28
第二行:[4, 5, 6] · [1, 3, 5] = 4×1 + 5×3 + 6×5 = 49
第二行:[4, 5, 6] · [2, 4, 6] = 4×2 + 5×4 + 6×6 = 64
最终得到【【22,28】,【49,64】】
5、索引切片
- 行列索引 data[0]第0行 data[:,0]所有行的第0列
- 列表索引 data[[0, 1], [2, 3]] # 返回 (0, 2)、(1, 3) 两个位置的元素
- 范围索引 data[:3, :2] # 前3行的前2列数据,data[2:, :2] # 第2行到最后的前2列数据
- 布尔索引 data[data[:, 2] > 5] # 第2列大于5的行数据
- 多位索引 data[1, :, :] # 获取0轴上的第2个数据 data[:, 0, :] # 获取1轴上的第一个数据
6、形状操作
1) reshape() 改变数据维度形状,要求该斌前后元素个数一致
reshape(3,2) 改成3行2列的数据
reshape(-1,2) 负1表示自动推断大小
2)view()用于修改连续张量的形状,修改后仍然连续,默认创建张量内存就是连续的
3)contiguous :把不连续张量改造为连续张量
4)squeeze/unsqueeze:移除长度是1的维度/增加长度为1的维度
squeeze(dim=0) 如果0维度上长度为1,则移除
unsqueeze(dim=0) 在0轴增加长度为1的维度
5)transpose:交换张量的两个维度
transpose(1,2) 交换第1、2维度
6)permute:重新排序张量的维度
permute(2,3,1,0) 打乱原维度重新组成维度,按照2,3,1,0的维度重排
7、张量拼接
1) torch.cat()
-
作用:在 已有维度 上拼接张量,不增加新维度。
-
要求:所有张量在除拼接维度外的其他维度上形状必须完全相同。
-
输出形状:拼接维度的尺寸等于各张量在该维度尺寸之和,其余维度不变。
-
示例:
import torch
a = torch.randn(2, 3)
b = torch.randn(2, 3)
c = torch.cat([a, b], dim=0)  # 沿第0维拼接 → 形状 (4, 3)
d = torch.cat([a, b], dim=1)  # 沿第1维拼接 → 形状 (2, 6)
2)torch.stack()
-
作用:在 新维度 上堆叠张量,会插入一个新的维度。
-
要求:所有张量形状必须 完全相同。
-
输出形状:新维度的大小等于张量个数,原张量的所有维度依次向后顺延。
-
示例:
a = torch.randn(2, 3)
b = torch.randn(2, 3)
e = torch.stack([a, b], dim=0)  # 新维度在最前 → 形状 (2, 2, 3)
f = torch.stack([a, b], dim=1)  # 新维度在第1维 → 形状 (2, 2, 3)  # 注意:此处(2,2,3)中第一个2是原第0维大小,第二个2是张量个数
g = torch.stack([a, b], dim=2)  # 新维度在最后 → 形状 (2, 3, 2)
8、自动微分torch.autograd
前向传播:模型给根据输入和当前参数计算预测值和损失的过程
反向传播:模型计算损失值和每个参数变化关系(梯度)自动微分就是为了计算这些梯度。
以线性连接为例
import torch
# 1. 当X为标量时梯度的计算
def test01():
    x = torch.tensor(5)
    # 目标值
    y = torch.tensor(0.)
    # 设置要更新的权重和偏置的初始值
    w = torch.tensor(1., requires_grad=True, dtype=torch.float32)
    b = torch.tensor(3., requires_grad=True, dtype=torch.float32)
    # 设置网络的输出值
    z = x * w + b  # 矩阵乘法
    # 设置损失函数,并进行损失的计算
    loss = torch.nn.MSELoss()
    loss = loss(z, y)
    # 自动微分
    loss.backward()
    # 打印 w,b 变量的梯度
    # backward 函数计算的梯度值会存储在张量的 grad 变量中
    print("W的梯度:", w.grad)
    print("b的梯度", b.grad)
这段代码输出结果 W的梯度: tensor(80.) b的梯度 tensor(16.)
原因分析
-
前向传播:
-
输入
x = 5,权重w = 1,偏置b = 3,则网络输出z = x * w + b = 5*1 + 3 = 8。 -
目标值
y = 0,损失函数采用均方误差(MSELoss,默认reduction='mean'),对于标量输入,损失值为loss = (z - y)² = (8 - 0)² = 64。
-
-
反向传播(梯度计算):
-
损失
loss = z²,其中z = 5w + b。 -
根据链式法则:
-
∂loss/∂z = 2z = 2*8 = 16
-
∂z/∂w = x = 5
-
∂z/∂b = 1
-
-
因此:
-
∂loss/∂w = ∂loss/∂z * ∂z/∂w = 16 * 5 = 80
-
∂loss/∂b = ∂loss/∂z * ∂z/∂b = 16 * 1 = 16
-
-
梯度值被存储在 w.grad 和 b.grad 中,即 80 和 16。
更多推荐



 12
 0
- 0


 已为社区贡献4条内容

所有评论(0)