
ClickHouse + DolphinScheduler:两个组件搞定轻量离线数仓,谁还堆 Hadoop 全家桶?
📝 摘要:只用 ClickHouse + DolphinScheduler 两个组件搭轻量离线数仓,告别 Hadoop 全家桶,适合日增千万级以下中小团队。用 Database 划分 ODS/DWD/DWS/DIM/ADS 五层,数据同步不引入 DataX,直接用 CK 原生 MySQL 表引擎挂载远端表,配 ReplacingMergeTree 按源表 update_time 去重实现全量初始化加幂等增量;再用 DolphinScheduler 的 SQL/SHELL/DEPENDENT 节点做定时增量与层间依赖调度。
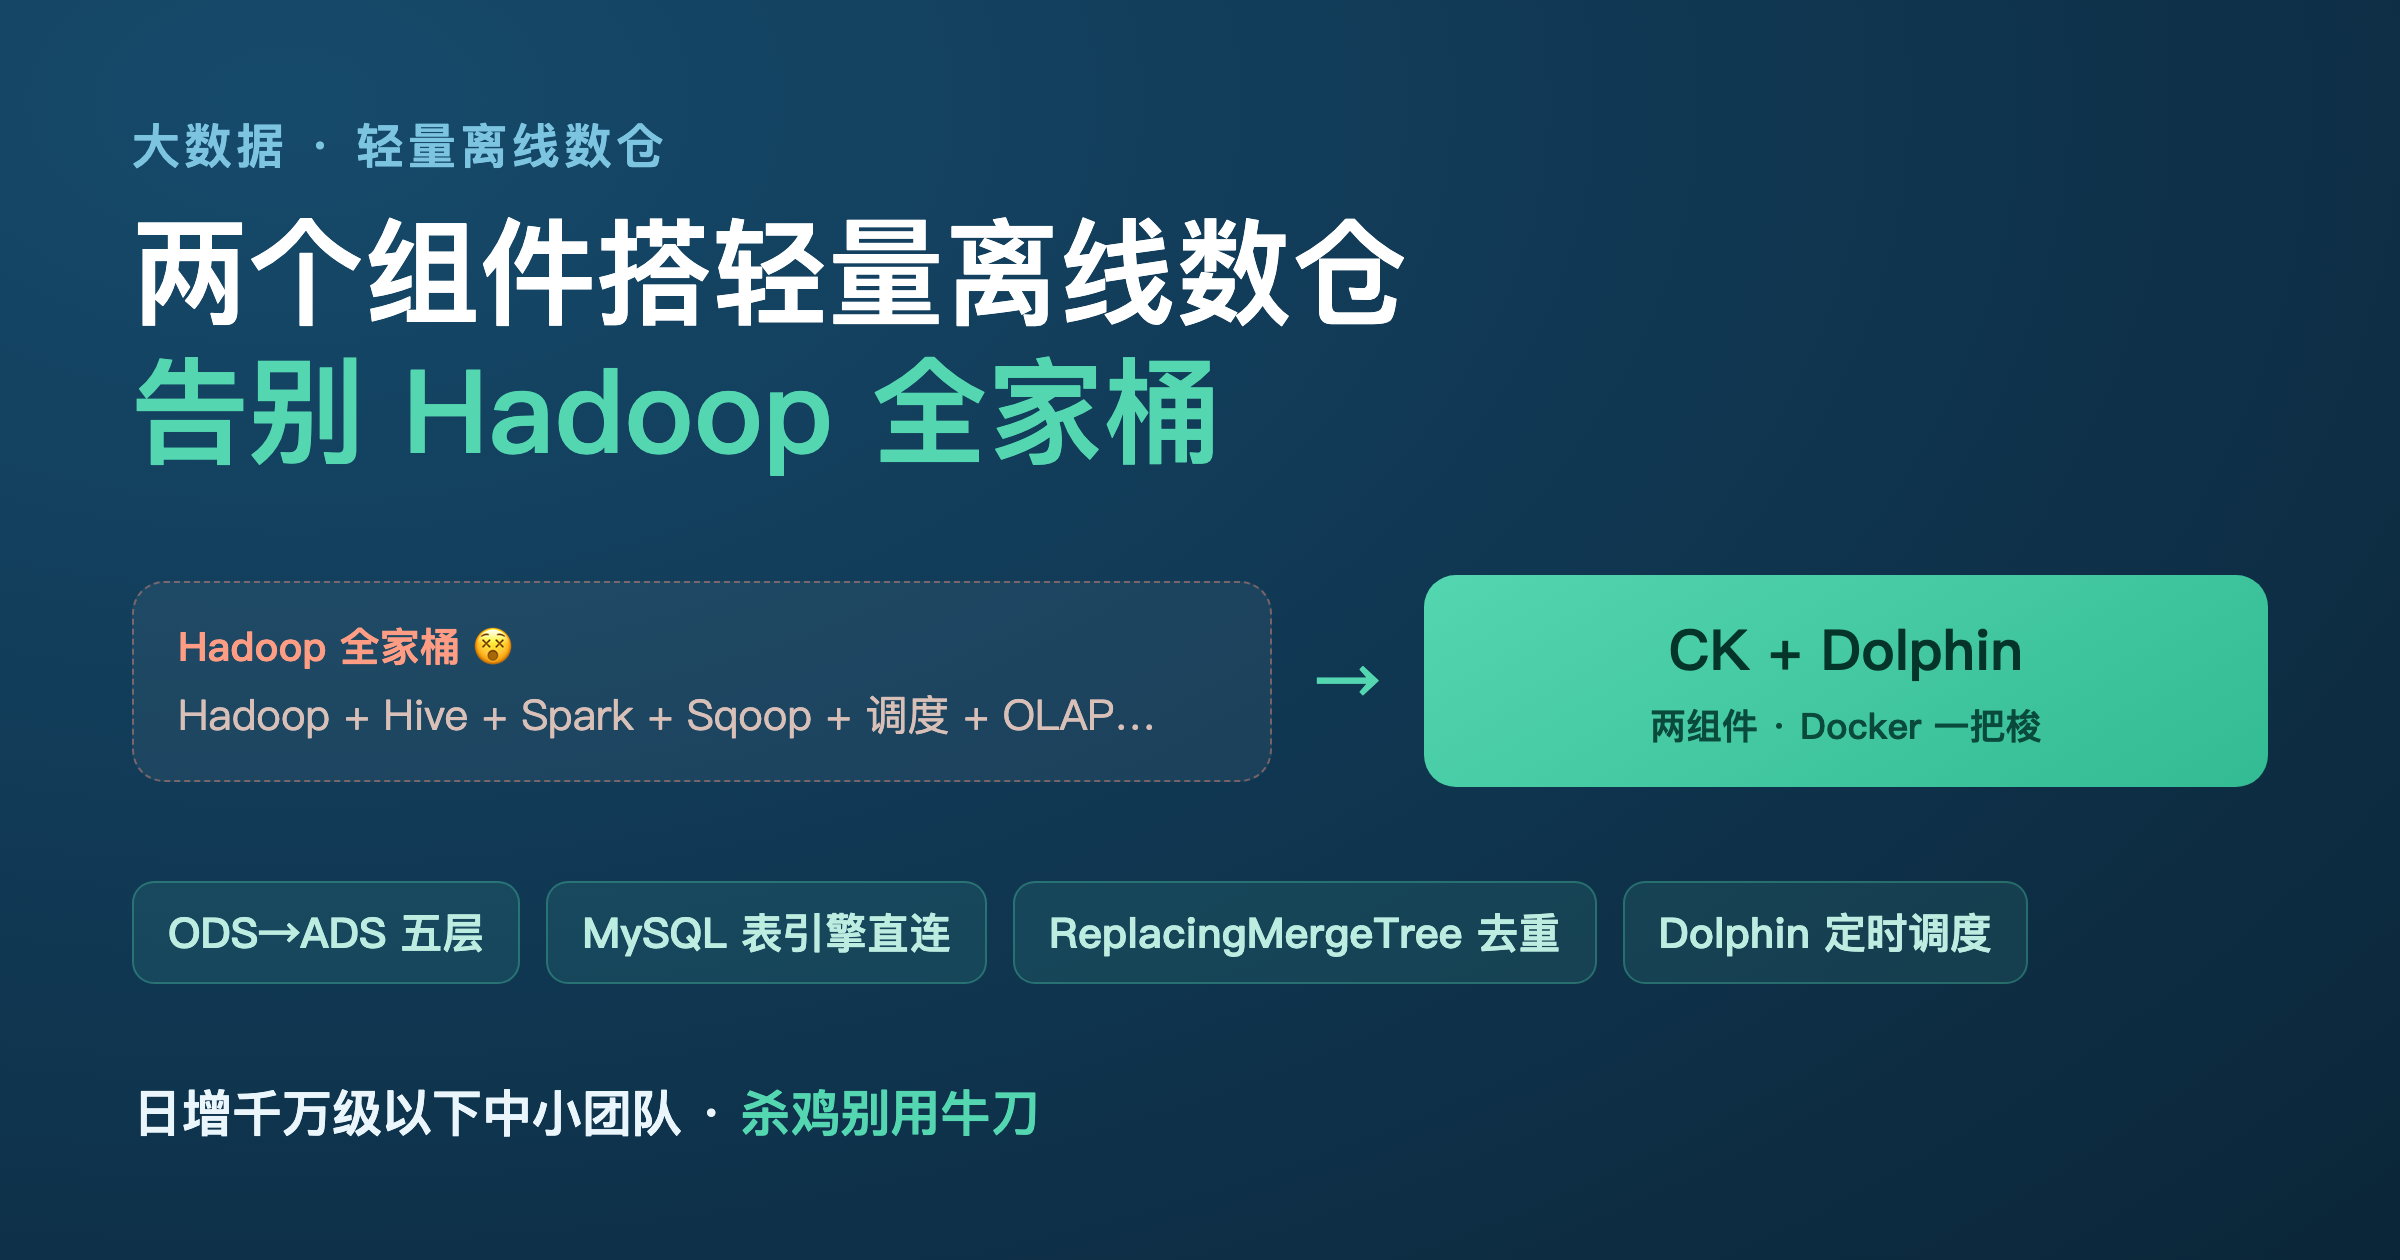
搭数仓一定要上 Hadoop 全家桶吗?本文手把手带你用 ClickHouse + DolphinScheduler 搭建一套轻量离线数仓,从建库到调度一条龙,中小团队也能拥有自己的数据底座。
前言:你是不是也被"全家桶"劝退过?
提到离线数仓,很多人脑子里自动弹出一套豪华套餐:
Hadoop + Hive + Spark + DolphinScheduler + Sqoop/DataX + 可能还要再来个 OLAP 引擎……
光是把这些组件部署完,运维同学的头发已经掉了一半,项目还没正式开始。
但现实是:不是每个团队都需要日均 PB 级的处理能力,也不是每个数仓都要搞得像 NASA 指挥中心一样复杂。对于日增数据量在千万级以下的中小团队来说,有一条"轻装上阵"的路线 —— ClickHouse + DolphinScheduler,两个组件,就能撑起一套五脏俱全的离线数仓。
两条路线对比
| 维度 | 全家桶方案 | 轻量方案 |
|---|---|---|
| 技术栈 | Hadoop + Hive + Spark + 调度 + ETL + OLAP | ClickHouse + DolphinScheduler |
| 部署复杂度 | ⭐⭐⭐⭐⭐(建议先买防脱洗发水) | ⭐⭐(Docker 一把梭) |
| 运维成本 | 高(N 个组件 = N 种报错姿势) | 低(两个组件,心里有数) |
| 适用场景 | 大规模离线计算、数据湖 | 中小规模数仓、快速交付的 BI 场景 |
| 查询性能 | 依赖引擎组合 | ClickHouse 原生 OLAP,天然快 |
不是说全家桶不好,而是杀鸡别用牛刀 —— 如果你的数据量还没大到需要 Hadoop 来扛,先试试轻量方案,省下来的时间可以多写几个需求(好吧,这可能不算好处 😅)。
一、前置准备
在开始之前,你需要先把两个核心组件部署好:
| 组件 | 参考文档 |
|---|---|
| ClickHouse | ClickHouse 25.4 基于 Docker 单机部署实战指南 |
| DolphinScheduler | DolphinScheduler 单机部署实战:Docker 一把梭,中小团队的调度神器 |
部署完这两个,我们就可以正式"搬砖"了。
二、数仓分层:先把"房间"隔好
数仓的经典分层模型,即使是轻量方案也不能含糊。在 ClickHouse 中,我们直接用 Database 来划分各层:
CREATE DATABASE IF NOT EXISTS ods;   -- 原始数据层(贴源层)
CREATE DATABASE IF NOT EXISTS dwd;   -- 明细数据层
CREATE DATABASE IF NOT EXISTS dws;   -- 汇总数据层
CREATE DATABASE IF NOT EXISTS dim;   -- 维度层
CREATE DATABASE IF NOT EXISTS ads;   -- 应用数据层(直接给 BI 用)

-- 还要一个:放「远端数据源映射表」的库,它不算数仓的一层,
-- 但下一节的 MySQL 表引擎要建在这里,别漏。
CREATE DATABASE IF NOT EXISTS source_mapping;
六句 SQL,数仓的"骨架"就搭好了。是的,就这么朴实无华。
source_mapping单独拎出来,是因为它里面放的不是数据,是「连接」——建在 ODS 里会让人误以为那是已经落库的数据。
💡 小贴士:分层不是为了好看,而是为了让数据流转有据可循 —— ODS 管"搬进来",DWD 管"洗干净",DWS 管"聚合好",ADS 管"端上桌"。每一层各司其职,后续排查问题的时候你会感谢自己。
三、数据同步:把数据"搬"进 ClickHouse
3.1 同步方案选型
数据从 MySQL、MongoDB 等业务库同步到 ClickHouse,常见方案分两大类:
| 方案 | 思路 | 代表工具 | 特点 |
|---|---|---|---|
| ETL/ELT 中间件 | 部署独立的同步工具 | DataX、Sqoop、Flink CDC | 功能强大,但多一个组件多一份运维 |
| CK 原生表引擎 | ClickHouse 直接连数据源 | MySQL 引擎、MongoDB 引擎、JDBC 引擎等 | 零额外部署,SQL 即同步 |
ClickHouse 内置了丰富的集成表引擎,支持 MySQL、MongoDB、PostgreSQL、Kafka、S3、HDFS 等几十种数据源,基本覆盖了常见的数据接入场景。
我们的选择:既然目标是"轻量",那就贯彻到底 —— 直接用 ClickHouse 原生 MySQL 表引擎,不引入额外组件,SQL 写完数据就过来了。
🎯 原则:能少一个组件就少一个,少一个组件就少一种凌晨三点被叫醒的可能。
3.2 创建数据源映射(MySQL 表引擎)
在 ClickHouse 中,通过 MySQL 表引擎直接"挂载"远端 MySQL 表:
CREATE TABLE source_mapping.member_profile
ENGINE = MySQL(
    'your-mysql-host:3306',
    'your_database',
    'member_profile',
    'your_username',
    'your_password'
);
⚠️ 注意:这里只是创建了一个"映射",数据仍然存储在 MySQL 中。每次查询这张表,ClickHouse 都会实时去 MySQL 拉数据。所以它的定位是同步的"桥梁",而不是最终存储。
3.3 创建 ODS 层目标表
接下来,在 ODS 层创建真正存储数据的本地表:
CREATE TABLE ods.ods_member_profile (
    id UInt64 COMMENT '主键ID',
    member_id String COMMENT '会员编号',
    avatar_url Nullable(String) COMMENT '头像地址',
    login_key String COMMENT '登录唯一标识',
    phone Nullable(String) COMMENT '手机号码',
    member_type Int8 DEFAULT 1 COMMENT '会员类型: 1-普通, 2-内部',
    status Nullable(Int8) COMMENT '状态: 0-禁用, 1-启用',
    secret_key Nullable(String) COMMENT '密钥(已加密)',
    nickname Nullable(String) COMMENT '昵称',
    avatar_large Nullable(String) COMMENT '大头像地址',
    create_time DateTime COMMENT '创建时间',
    update_time DateTime COMMENT '更新时间(取源表同名字段,同时兼任版本列)'
)
ENGINE = ReplacingMergeTree(update_time)
PARTITION BY toYYYYMM(create_time)
ORDER BY (member_id)
SETTINGS
    index_granularity = 256   -- 默认 8192,这里调小是为点查优化,代价见下
COMMENT 'ODS层 - 会员信息表';
几个关键设计决策解释一下:
ReplacingMergeTree:这是重点!ODS 层会反复同步增量数据,同一条记录可能被多次写入。ReplacingMergeTree会在后台 Merge 时按版本列去重(机制细节见 ClickHouse 官方 · ReplacingMergeTree)。如果用普通MergeTree,你的数据会越来越"膨胀",最终查出来一堆重复行,场面一度非常混乱 🤯PARTITION BY toYYYYMM(create_time):按月分区,方便管理和清理历史数据。⚠️ 这里有个前提,见下面那条注意ORDER BY (member_id):按业务主键排序,查询效率拉满index_granularity = 256:默认值是8192,这里调小到 1/32。好处是稀疏索引更密、按member_id点查时要扫的数据块更小;代价是主键索引本身占的内存和磁盘涨约 32 倍。会员表这种「行数不算多、但经常按 ID 捞单条」的场景划算,换成日志类大宽表就别照抄了,先用默认值。
🔴 版本列为什么必须取源表的
update_time,而不是now()?这一步选错会静默弄脏数据。官方文档写得很明确:merge 时保留的是版本列取值最大的那一行。所以版本列的含义必须是「这行数据在业务上有多新」,而不是「这行是什么时候被灌进来的」。
如果写成
_version DateTime DEFAULT now(),平时顺序跑没问题,一补数就出事:
- 10:00 那个窗口跑失败了,某会员的旧资料没同步进来;
- 11:00 正常跑,同步到该会员 10:30 修改后的新资料,版本 = 11:00;
- 下午 15:00 你去补跑 10:00 那个窗口,捞到的是该会员修改前的旧资料,而版本 =
now()= 15:00;- 15:00 > 11:00 ⇒ ClickHouse 会认为旧资料更新,把新资料覆盖掉。
而且它不报错,对数时才会发现。改用
update_time当版本列,补数捞到的旧行版本天然更小,覆盖不了新行——补几次都一样,这才叫幂等。顺带,这样做还白拿一个好处:
update_time作为真实列留在了 ODS 里,下游 DWD 想按它做增量、或者排查「这行到底啥时候变的」,都有据可查。
⚠️ 另一个前提:分区键那一列(这里是
create_time)在业务上必须是不变的。后台合并只在分区内进行,所以同一个
member_id的新旧两行一旦落到不同分区,就永远不会被合并掉。我实测过这个行为(ClickHouse 25.4,脚本与完整输出见 ods-sync-bench):同一个
member_id造两行、create_time分别落在 1 月和 2 月,OPTIMIZE TABLE ... FINAL跑完之后——
场景 合并后剩几行 查询时加 FINALcreate_time跨月🔴 2 行(新旧都在) ✅ 1 行(正确) create_time同月✅ 1 行 ✅ 1 行 两个结论都要记住:① 跨分区的重复磁盘上会一直存着,
OPTIMIZE也清不掉;② 但查询时写FINAL能跨分区拿到正确结果——后台合并和查询FINAL的行为不一样,别混为一谈。正常业务里
create_time是创建时间、不会变,所以这个坑不会触发。但如果你做过数据订正、或者从别的系统迁移过来改写过创建时间,就要留意:受影响的记录会留下永久的存储膨胀,而且任何漏写FINAL的查询都会把它重复计一遍。
3.4 初始化存量数据
首次同步,需要把 MySQL 中的全量数据灌进来:
INSERT INTO ods.ods_member_profile (
    id, member_id, avatar_url, login_key, phone,
    member_type, status, secret_key, nickname, avatar_large,
    create_time, update_time
)
SELECT
    id,
    member_id,
    ifNull(avatar_url, '')    AS avatar_url,
    login_key,
    ifNull(phone, '')         AS phone,
    member_type,
    ifNull(status, 0)         AS status,
    ifNull(secret_key, '')    AS secret_key,
    ifNull(nickname, '')      AS nickname,
    ifNull(avatar_large, '')  AS avatar_large,
    create_time,
    update_time               -- ← 版本列,必须来自源表,别用 now()
FROM source_mapping.member_profile;
执行完毕后,验证一下数据量:
SELECT count(*) FROM ods.ods_member_profile FINAL;
💡 为什么用
FINAL? 因为ReplacingMergeTree的去重发生在后台 Merge 过程中,如果 Merge 还没完成,直接count(*)可能会看到重复数据。加上FINAL关键字,ClickHouse 会在查询时强制去重,得到准确结果。(当然,FINAL有性能开销,生产环境大表慎用,验证的时候用用无妨。)
顺便说一下同步性能 —— 你可能会担心"全量灌数据会不会跑到天荒地老?"结论是不用担心,但这个数字强依赖环境,我把两组来源不同的数据都摆出来:
| 来源 | MySQL → ClickHouse | 说明 |
|---|---|---|
| 我们生产环境(多张业务表的同步统计) | ~35w 条/s | MySQL 与 CK 跨机,表更宽,含网络往返 |
| 本地压测台(可复现,见下) | ~98 万 ~ 118 万条/s | MySQL 与 CK 同机容器、11 列窄表,是上限值 |
压测台那组的完整条件:Ubuntu 22.04.5 / 4 核 7 GiB / Docker 29.6.1,表结构与本文 ODS 表一致。
200 万行耗时 1.70 秒、500 万行 5.12 秒,峰值内存 692 → 744 MiB(增长很缓,说明是流式写入,没把整表读进内存)。
⚠️ 两组差了三倍多,不是谁测错了,而是它们量的本来就不是一回事。 同机容器没有跨机网络往返,窄表每行的字节数也小得多。
⇒ 别拿任何一个当自己的容量规划依据。 要自己环境的真实数字,用下面这条 SQL 在你的 CK 上查——
written_rows和query_duration_ms是 ClickHouse 自己记的,比掐秒表准,也和上面压测台是同一口径:SELECT event_time, tables[1] AS tbl, written_rows, round(query_duration_ms / 1000, 2) AS secs, round(written_rows / (query_duration_ms / 1000)) AS rows_per_sec FROM system.query_log WHERE type = 'QueryFinish' AND query_kind = 'Insert' AND written_rows > 100000 AND event_date >= today() - 30 ORDER BY written_rows DESC LIMIT 20;📦 压测台可直接跑(造数 → 灌入 → 出速率,跑完自动清理):
ods-sync-bench,一行sh bench.sh。完整执行输出、两个踩过的坑都在里面。
四、增量调度:让 DolphinScheduler 帮你"打工"
存量数据搞定了,但数仓是要"活"的 —— 业务库每天都有新数据进来,我们需要定时增量同步。这时候就轮到 DolphinScheduler 登场了。
4.1 创建调度工作流
操作路径很简单:创建项目 → 新建工作流 → 添加 SQL 节点 → 上线定时,DolphinScheduler 的 UI 交互比较直观,这里不赘述基础操作(如有不熟悉的同学可留言评论,后续补充分享相关内容的文章)。
我们重点关注数仓场景下常用的三种节点类型:
| 模块 | 组件 | 用途 |
|---|---|---|
| 通用组件 | SQL | 执行 MySQL / ClickHouse SQL,数仓的主力 |
| 通用组件 | SHELL | 发通知(飞书/钉钉)、执行脚本等辅助操作 |
| 逻辑节点 | DEPENDENT | 依赖上游工作流,控制层级间的执行顺序 |
4.2 增量同步 SQL(核心)
在工作流中添加一个 SQL 节点,填写增量同步逻辑 —— 这才是本章的重头戏:
INSERT INTO ods.ods_member_profile (
    id, member_id, avatar_url, login_key, phone,
    member_type, status, secret_key, nickname, avatar_large,
    create_time, update_time
)
SELECT
    id,
    member_id,
    ifNull(avatar_url, '')    AS avatar_url,
    login_key,
    ifNull(phone, '')         AS phone,
    member_type,
    ifNull(status, 0)         AS status,
    ifNull(secret_key, '')    AS secret_key,
    ifNull(nickname, '')      AS nickname,
    ifNull(avatar_large, '')  AS avatar_large,
    create_time,
    update_time               -- ← 版本列,补数能幂等全靠它
FROM source_mapping.member_profile
WHERE update_time >= toDateTime('$[yyyy-MM-dd HH:00:00-1/24]')
  AND update_time <  toDateTime('$[yyyy-MM-dd HH:00:00]');
📌 增量逻辑说明:
$[yyyy-MM-dd HH:00:00-1/24]是 DolphinScheduler 的内置时间参数,表示上一个整点$[yyyy-MM-dd HH:00:00]表示当前整点- 每次只同步过去一小时内有更新的数据,配合
ReplacingMergeTree的去重机制,实现"幂等增量同步"🔍 WHERE 条件拆解:
update_time >= 开始时间:捞出该时段内新增或修改过的记录(新增时 update_time = create_time,修改时 update_time 会被刷新)update_time < 结束时间:排除掉窗口之后才发生的变更- 两个条件都卡在
update_time上,构成一个干净的半开区间[上一整点, 当前整点)⚡ 性能提示:MySQL 源表务必给
update_time建索引,否则每小时一次的增量查询会变成全表扫描,慢查询警告了解一下 🚨
🔴 上界为什么必须卡
update_time,不能卡create_time?这直接决定补数能不能还原当时的窗口。本文早期版本上界写的是
create_time < 结束时间,理由是"排除当前整点之后才创建的数据"。听着没错,但它漏了一种情况:一条 9:00 就创建、却在 11:02 被修改的老记录——
create_time是 9:00,怎么卡都在界内,于是它会被[10:00, 11:00)这个窗口捞走,尽管它的变更明明发生在 11:02。后果不是丢数据(下个窗口会再捞一次,
ReplacingMergeTree也会去重),而是窗口内容不再只由窗口决定,还取决于你什么时候跑。同一个窗口,11:05 跑和第二天补数时跑,捞到的东西不一样 ⇒ 下面那条"补数能正确还原当时的窗口"的建议就不成立了。改成两头都卡
update_time,窗口才是真正封闭的:跑多少次、什么时候跑,结果都一样。
⚠️ 这个窗口方案有个必须知道的前提:它不会「回捞」。
每次执行只处理
[上一整点, 当前整点)这一个固定窗口,窗口是按调度时间算的,不是按上次成功时间算的。所以一旦某次执行失败又没人补跑,那一小时的数据就永久留在了 MySQL 里——下一次执行只管它自己那个窗口,不会回头补。而且它不会报错:ODS 表照常有新数据进来,只是中间缺了一段,往往要等对数时才发现。三条建议:
- 在 DolphinScheduler 里给这个工作流配上失败重试 + 告警通知(它本身支持,别让失败静默过去);
- 补数时用它的「补数」功能按调度时间重跑,
$[yyyy-MM-dd HH:00:00]这类参数会跟着补数的时间走,能正确还原当时的窗口;- 窗口留一点重叠(比如下界用
-2/24往前多捞一小时)——ReplacingMergeTree会按update_time去重,多捞不会脏数据,少捞才会丢数据。⚠️ 这条成立的前提是版本列取自源表update_time;若沿用now(),重叠和补数反而会拿旧数据盖掉新数据(见上一节那段红框)。
4.3 上线定时调度
保存工作流后,上线并配置定时策略(比如每小时执行一次):

💡 调度时间小技巧:建议将执行时间比整点延后 3~5 分钟(比如每小时的第 5 分钟触发)。业务库通常有 MySQL 主从复制延迟,卡在整点跑可能漏掉最后几秒写入的数据。稍微"慢半拍",数据反而更完整。
4.4 验证同步结果
调度跑完后,查一下最新数据是否已经同步过来:
SELECT member_id, create_time, update_time
FROM ods.ods_member_profile FINAL
ORDER BY update_time DESC
LIMIT 10;
💡 这里按
update_time排序,不是create_time——增量同步捞的是「有变更」的记录。一条三个月前创建、今天被改过的老数据,按create_time排永远翻不到,你会误以为增量没生效。
看到最新的业务变更已经出现在 ODS 层,说明整个链路已经打通 🎉
五、后续建设:从 ODS 到 ADS 的数据流转
ODS 层只是起点,完整的数仓还需要继续向上构建

每一层之间的 ETL 逻辑,同样通过 DolphinScheduler 的 SQL 任务节点来调度,利用 DEPENDENT 节点控制层级间的依赖关系,确保上游跑完下游才启动。
往上一层怎么做增量? 这里就能收到前面那个决定的利息了——我们把 update_time 当成真实列留在了 ODS,所以 DWD 可以照抄同一套窗口写法,只是数据源从 MySQL 映射表换成 ODS 表:
-- 形状示意,SELECT 里换成你自己的清洗逻辑
INSERT INTO dwd.dwd_member_profile
SELECT /* 你的字段与清洗表达式 */
FROM ods.ods_member_profile FINAL
WHERE update_time >= toDateTime('$[yyyy-MM-dd HH:00:00-1/24]')
  AND update_time <  toDateTime('$[yyyy-MM-dd HH:00:00]');
⚠️ 这里的 FINAL 和前面第三节那句「生产大表慎用 FINAL」是有张力的,得说清楚怎么取舍:
- 不加
FINAL:同一条记录在 ODS 里可能还留着多个未合并的版本,会被一起带到 DWD,DWD 就脏了。 - 加
FINAL:正确,但代价是 ClickHouse 要对相关 part 做合并处理,ODS 表越大越慢。
实务上的分界:ODS 还不大时直接用 FINAL,简单省事;等它慢到影响调度了,换成显式去重,把开销限制在窗口内:
SELECT *
FROM ods.ods_member_profile
WHERE update_time >= toDateTime('$[yyyy-MM-dd HH:00:00-1/24]')
  AND update_time <  toDateTime('$[yyyy-MM-dd HH:00:00]')
ORDER BY member_id, update_time DESC
LIMIT 1 BY member_id;
LIMIT 1 BY member_id 是 ClickHouse 特有的写法:按 ORDER BY 排好之后,每个 member_id 只留第一行。比套一层 row_number() 子查询短得多,也更好读。
📌 这一段是写法示意,不是我实测过的基准——两种写法的性能拐点在哪,取决于你 ODS 的体量和 part 数量,自己拿
system.query_log量一把(方法见第三节那条 SQL)。另外一条建议是确定的:DWD 表同样用
ReplacingMergeTree(update_time),让去重逻辑逐层一致——每层各搞一套版本规则,对数时会非常痛苦。
至此,一套轻量但完整的离线数仓就搭建完成了。
六、总结
回顾一下我们做了什么:
| 步骤 | 内容 | 关键技术点 |
|---|---|---|
| 1 | 部署 ClickHouse + DolphinScheduler | Docker 部署,开箱即用 |
| 2 | 创建数仓分层(ODS/DWD/DWS/DIM/ADS) | ClickHouse Database 划分 |
| 3 | 配置数据源映射 | MySQL 表引擎,零组件接入 |
| 4 | 全量初始化 + 增量调度 | ReplacingMergeTree(版本列取源表 update_time)+ update_time 时间窗口 |
| 5 | 逐层构建数仓 | DolphinScheduler 工作流编排 |
这套方案的核心优势:
- 极简部署:只有两个组件,Docker 一把梭,半天搞定
- 零额外 ETL 组件:利用 ClickHouse 原生表引擎直连数据源,不用再折腾 DataX、Sqoop
- 天然 OLAP 能力:ClickHouse 本身就是 OLAP 引擎,数仓查询不需要再套一层
- 调度灵活:DolphinScheduler 支持 DAG 编排、依赖管理、失败重试、告警通知,麻雀虽小五脏俱全
三个别踩的坑(正文各有展开,这里汇总一遍,都是不报错但会静默出问题的):
| 坑 | 后果 | 怎么避 |
|---|---|---|
版本列用 now() | 补数时用旧数据覆盖新数据 | 版本列取源表 update_time |
增量窗口上界卡 create_time | 同一窗口不同时刻跑,捞到的数据不一样,补数还原不了 | 上下界都卡 update_time |
| 分区键那列在业务上会变 | 同主键的行落到不同分区,后台永远合并不掉 | 分区键选不可变的列;查询记得带 FINAL |
当然,这套方案也有其适用边界 —— 如果你的数据量级已经到了 TB/PB 级别,或者需要复杂的流批一体处理,那还是老老实实上大数据全家桶吧。工具没有高低之分,只有合不合适。
📣 如果这篇文章帮你少踩了一个坑,或者让你对轻量数仓有了新的思路,欢迎 点赞 👍 收藏 ⭐ 关注,你的支持是我持续输出的动力!有任何问题也欢迎评论区交流,我们一起把数仓这件事搞得明明白白 💪
延伸阅读
- ClickHouse + Flink + DolphinScheduler:中小厂三件套搞定离线+实时数仓,告别 Hadoop 全家桶 —— 本文离线数仓的升级版,加上 Flink CDC 补齐秒级实时链路。
- trade 是数据域还是主题域?数仓分层里最容易搞混的一对概念,一篇讲透 —— 分好 ODS/DWD/DWS 只是第一步,再厘清数据域与主题域这对易混概念。
- ClickHouse 内存爆了?一次增量 SQL 从 8.6 GiB 干到 115 MiB 的实战复盘 —— 数仓跑起来后,增量同步 SQL 把内存打爆的真实优化案例。
🏷️ 标签:ClickHouse DolphinScheduler 离线数仓 数仓分层 MySQL表引擎 ReplacingMergeTree
📅 最后更新:2026-09-14,订正三处照抄就会出问题的地方,另补两条实测结论,跟着早期版本搭过的建议回头看一眼:
🔴 版本列从
_version DateTime DEFAULT now()改成直接用源表的update_time。ReplacingMergeTree保留的是版本列最大的那一行,用now()意味着版本表示「什么时候灌进来的」而不是「数据有多新」——一旦补数或窗口重叠,就会用旧数据静默覆盖新数据,而本文第四节恰恰建议了这两件事。改用update_time后补数才真正幂等,并且update_time作为真实列留在 ODS,下游可以拿它做增量。🔴 补上
CREATE DATABASE source_mapping。第三节的 MySQL 表引擎建在这个库里,而第二节只建了 ODS/DWD/DWS/DIM/ADS 五层,照抄会在第一步就报库不存在。§3.3 补一条实测发现的注意事项:
ReplacingMergeTree的后台合并只在分区内做,同一主键的行若因create_time被订正而落到不同分区,就永远合并不掉;但查询时的FINAL能跨分区。两者行为不同,实测脚本与输出在ods-sync-bench目录。🔴 增量窗口的上界从
create_time < 结束时间改成update_time < 结束时间。原写法会把「早就创建、但在窗口之后才被修改」的老记录捞进本窗口,导致同一个窗口在不同时刻跑,捞到的数据不一样——而本文恰恰建议「补数时按调度时间重跑,能正确还原当时的窗口」,这个承诺在原写法下不成立。两头都卡update_time后窗口才真正封闭。§4.4 的验证 SQL 同理,从ORDER BY create_time改成ORDER BY update_time(按创建时间排,永远看不到被修改的老数据,会误判增量没生效)。§5 顺带补了 DWD 层的增量写法。同步速率那组数字补上了可复现的来源。原文只有「~35w 条/s」加一句「基于多张业务表的实际同步统计」,读者无从验证。现在并列生产与本地压测两组(差三倍多,因为一个跨机一个同机),并附上可直接跑的压测台 ods-sync-bench 与一条在自己生产 CK 上取数的 SQL。
另:
index_granularity = 256补上代价说明(默认 8192,调小换点查、代价是索引开销涨约 32 倍,大宽表别照抄)、正文顶部补引封面。
更多推荐


 12
 0
- 0


 已为社区贡献15条内容

所有评论(0)