
机器学习之决策树
概述
决策树算法是一种监督学习算法,英文是Decision tree。
决策树是一种树形结构,树中每个内部节点表示一个特征上的判断,每个分支代表一个判断结果的输出,每个叶子节点代表一种分类结果.
决策树的建立过程:
1.特征选择:选取有较强分类能力的特征。
2.决策树生成:根据选择的特征生成决策树。
3.决策树也易过拟合,采用剪枝的方法缓解过拟合。
决策树算法的经典解释
1. 核心思想:模拟人类决策过程
决策树算法是一种监督学习算法,既可以用于分类任务,也可以用于回归任务。
它的核心思想非常直观:模拟人类做决策时的思考过程。
当我们面临多个选择时,我们会根据最重要的因素一步一步地问自己“是”还是“不是”,最终到达一个结论。决策树就是把这种“如果...就...”的规则组合成了一棵树状结构。2. 直观类比:相亲决策
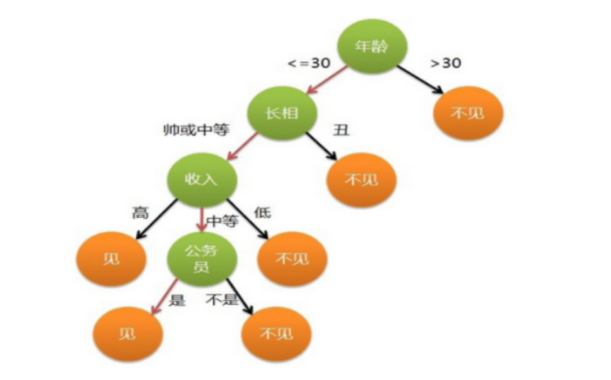
为了更形象地说明,我可以举一个生活中的例子:比如相亲时决定“见不见面”。
根节点:代表全部候选人。
第一个问题(分裂):我们会问第一个最重要的问题,比如“收入高吗?”。如果“是”,走左边;如果“否”,走右边。
内部节点:在第一个问题之后,我们还会继续问第二个问题,比如“长得帅吗?”或者“性格好吗?”。每一个问题节点,都是对数据的进一步细分。
叶子节点:经过一连串的问题后,我们最终到达了一个结论:“见”或者“不见”。这个最终的结论点就是叶子节点。
整个过程就像把数据一层层地筛选和分类。
3. 构建过程:寻找最佳分裂点
那么,算法是怎么知道先问“收入”而不是先问“长相”的呢?这就涉及到了决策树的核心构建逻辑:让数据从“混乱”变“纯净”。
在构建树的过程中,算法会计算每一个特征(比如收入、长相)能把数据分得多“纯”。它会选择一个特征作为节点,使得分裂之后,子节点中的数据类别尽可能单一。
衡量混乱程度的指标:通常使用信息增益、基尼系数或增益率。
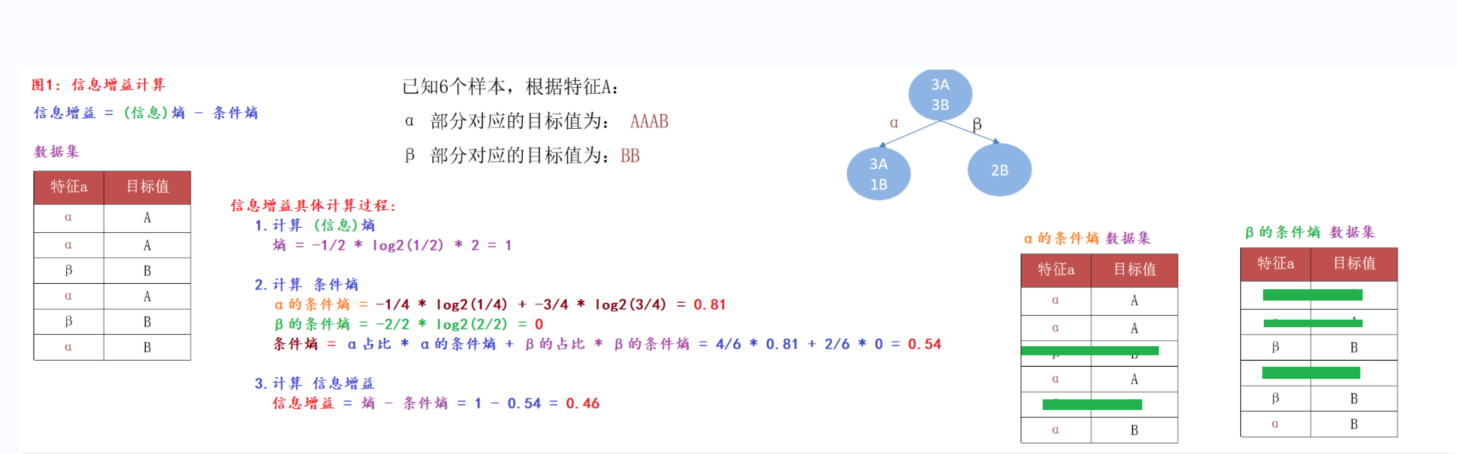
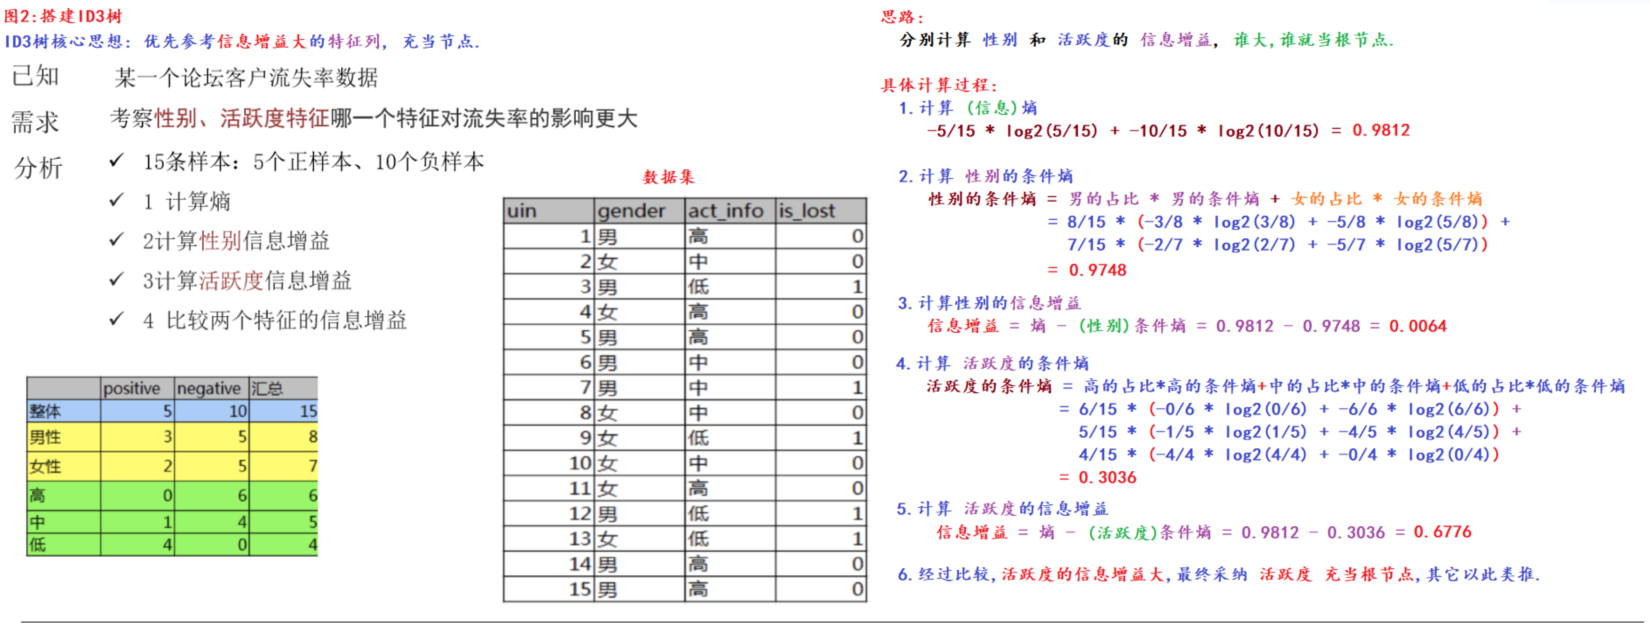
信息增益:衡量分裂前后“不确定性”的减少量。减少得越多,说明这个特征分类能力越强。优先选择信息增益和信息增益率高的特征.
基尼系数:衡量从一个数据集中随机抽取两个样本,其类别不一致的概率。基尼系数越小,纯度越高。
算法会递归地对每个节点重复这个过程,直到数据被分完或达到预设的停止条件。
4. 优缺点分析(展示全面思考)
作为一个算法,它也有两面性:
优点:
可解释性强:这是它最大的优势。决策过程像流程图一样清晰,可以直观地展示特征的重要性,甚至能转换成SQL语句或规则,方便业务理解。
数据预处理简单:它对数据缩放不敏感,既不需要归一化,也不需要标准化,同时能很好地处理数值型和类别型特征。
缺点:
容易过拟合:如果不加以限制(比如不剪枝),决策树可能会为了完美拟合训练数据而生长得过于复杂,把噪声也学进去,导致泛化能力变差。所谓泛化能力是指模型在未见过的数据(测试集)上的表现能力.
不稳定:数据的一点点微小变化,可能会导致生成完全不同的树结构。
偏向于多值特征:如果不做处理,它倾向于选择那些取值较多的特征进行分裂。
5. 总结
总的来说,决策树是一种基于规则、具有白盒特性的基础模型。虽然单棵决策树存在过拟合和不稳定的问题,但它是很多高级集成算法(如随机森林、梯度提升树 XGBoost/LightGBM)的基石。在实际应用中,我们很少直接使用单棵树,而是利用它的集成版本,在保留可解释性的同时,大幅提升预测精度。
回答要点解析(给面试者的建议):
结构清晰:从思想 -> 举例 -> 原理 -> 优缺点,逻辑递进。
通俗易懂:用“相亲”这种生活例子降低理解门槛,展示沟通能力。
术语准确:根节点、叶子节点、信息增益、基尼系数、过拟合等关键词必须准确。
展现深度:提到它是集成学习的基础,说明你不仅懂单棵树,还有更广阔的视野。
诚实客观:既说优点(可解释性强),也说缺点(易过拟合),体现辩证思维。
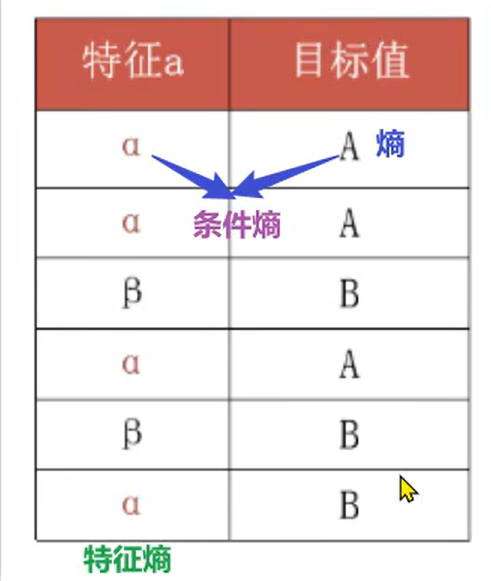
信息增益计算
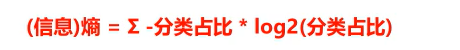
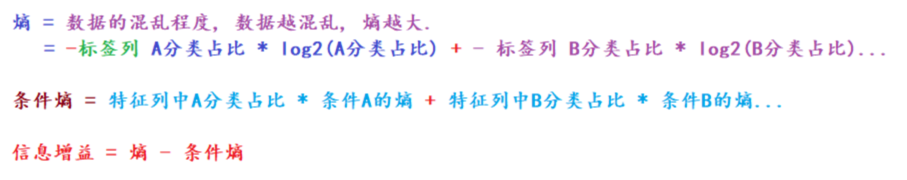
熵代表数据的混乱程度,
熵越大,数据的不确定程度越高,信息越多
熵越小,数据越规整,不确定程度越低
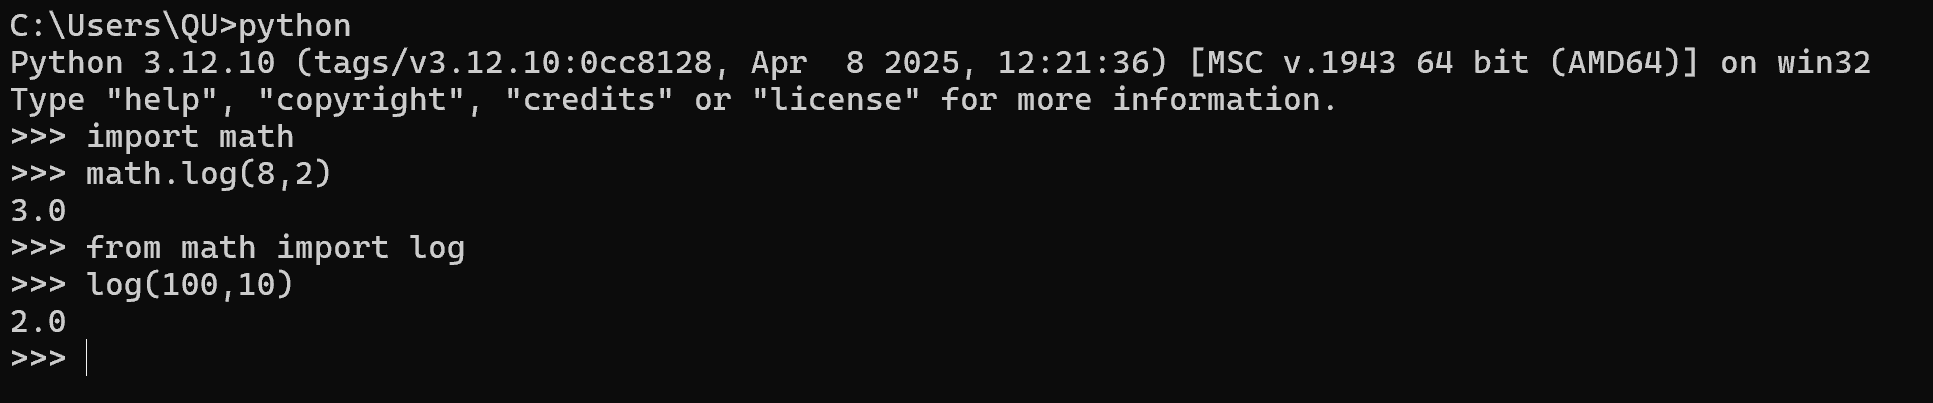
tips:在python中如何使用对数计算
搭建ID3树
计算C4.5树的 信息增益率
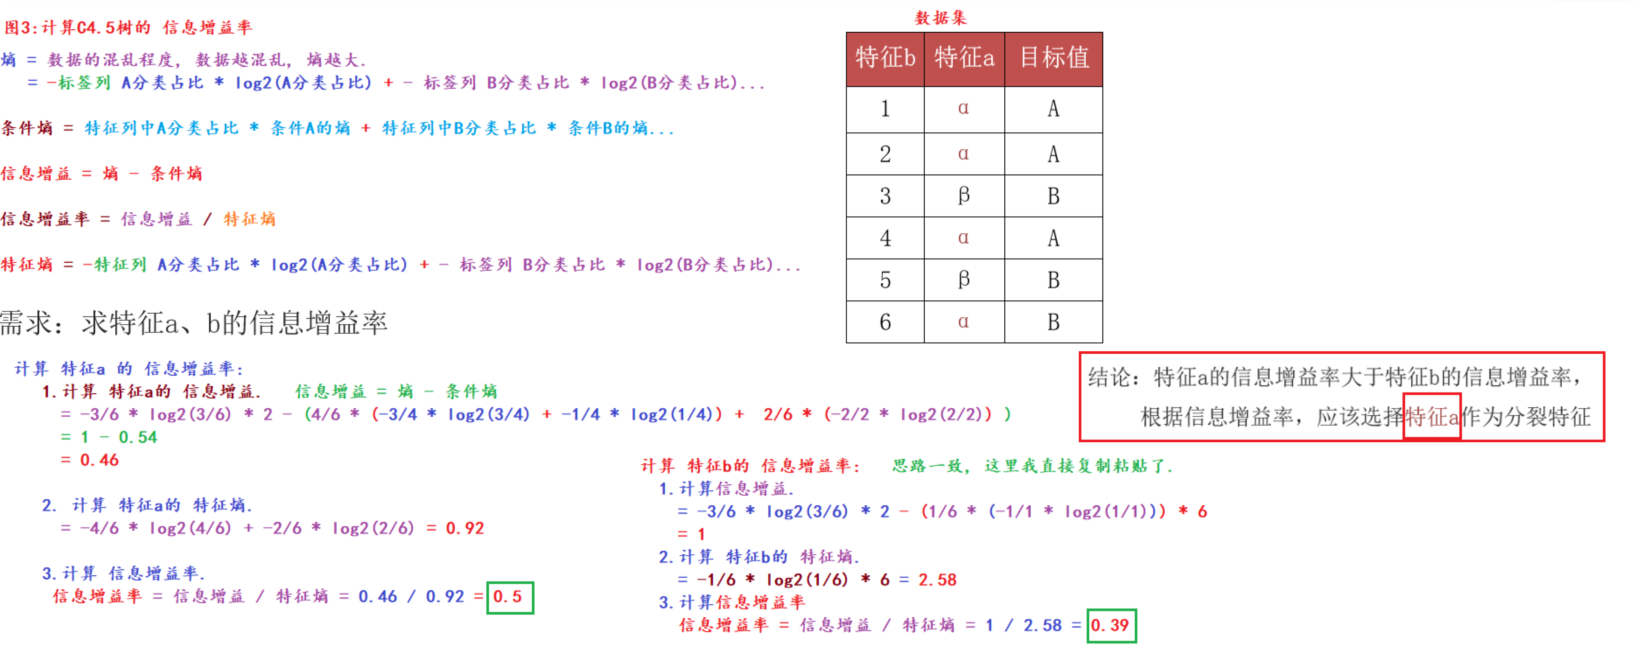
优先选择信息增益和信息增益率高的特征列作为决策树的根节点
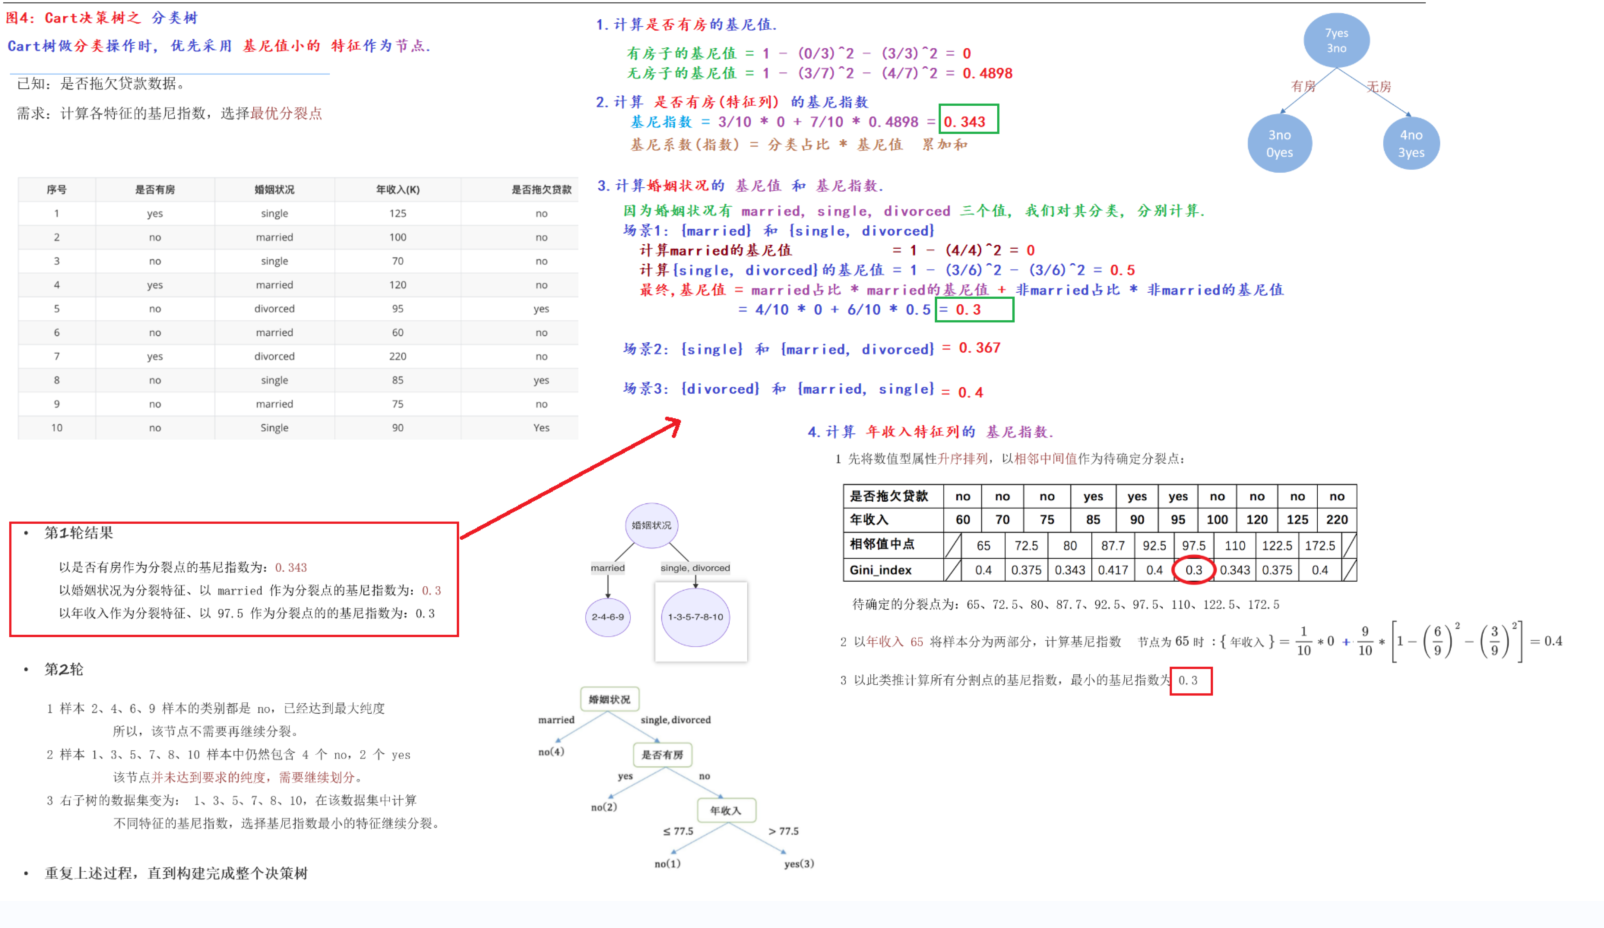
Cart决策树之 分类树
Cart决策树的作用:分类和回归
基尼指数的作用:特征筛选,基尼指数值越小,说明优先选择该特征.
基尼值 = 1 - ∑ 各分类概率平方
基尼指数 = ∑ 各分类占比 * 当前分类的基尼值
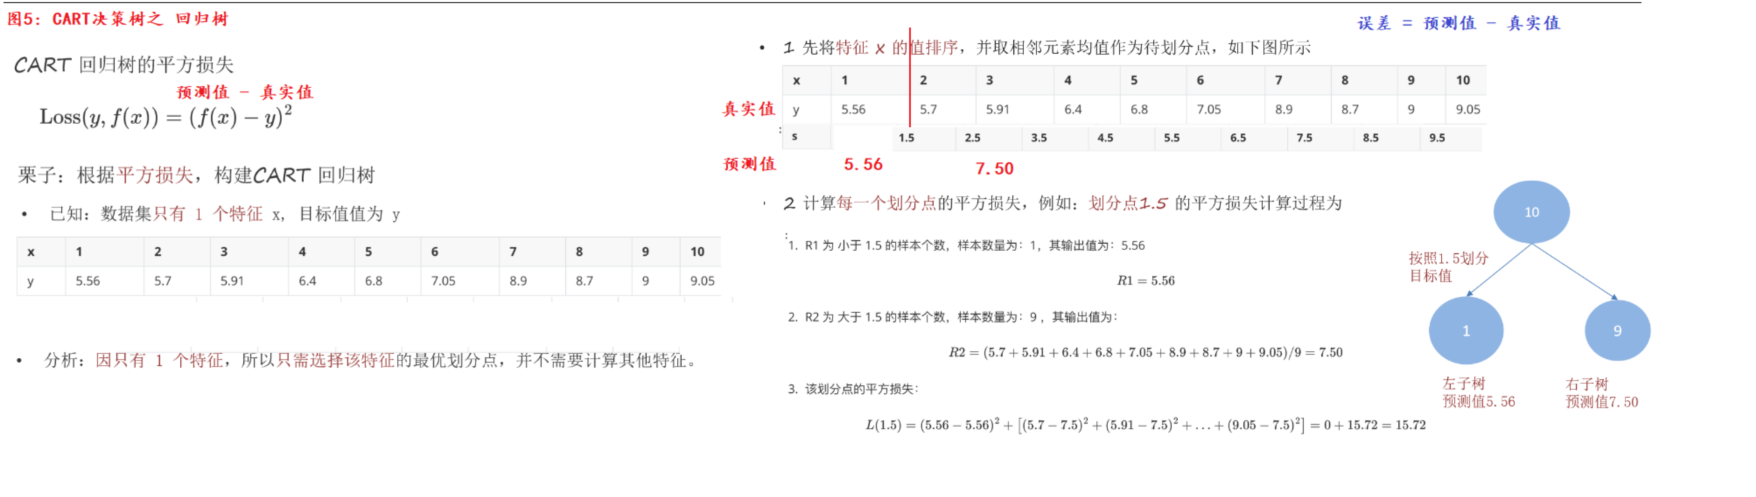
Cart决策树之 回归树
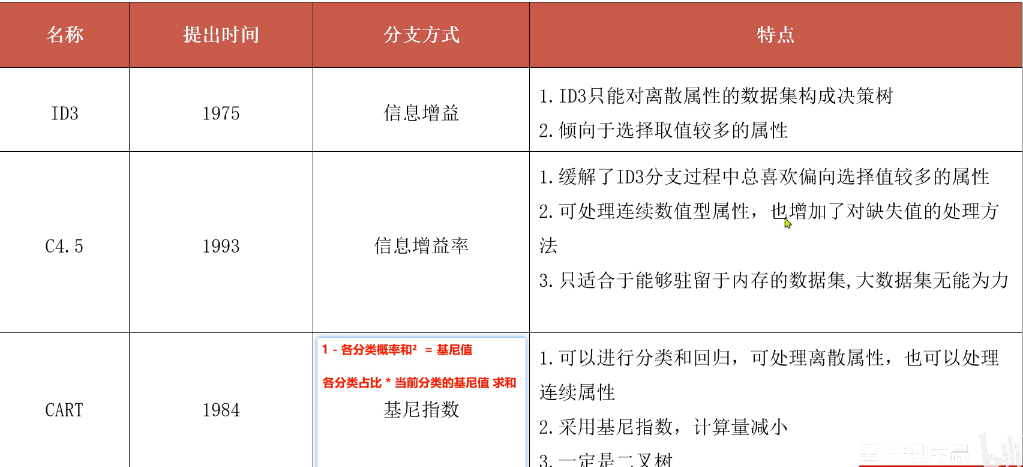
ID3-C4.5-Cart的比较
决策树与二叉树的关系
决策树(如CART算法)在处理多类别特征(如婚姻状况:单身、已婚、离婚)时,确实通常不会直接按照三个分支去分裂,而是会转换成二分类(即分成两个组)来考虑。
具体原因如下:
1. CART 算法的本质是二叉树
CART(分类与回归树) 的核心特征是生成二叉树。它不擅长一次性生成三个分支(即三叉树)。
为了将“婚姻状况”(3个类别)应用于二叉树,算法必须找到一个最佳分裂点,将数据分成两个子集。
因此,需要将所有可能的二元划分(即“把这三个类别分成两堆”)都尝试一遍:
{单身} vs {已婚,离婚}
{已婚} vs {单身,离婚}
{离婚} vs {已婚,单身}
然后计算每种划分方式的基尼指数,选择基尼指数最小(即纯度提升最大)的那一种划分方式作为最终分裂点。
2. 为什么不分三个叉?
虽然从逻辑上讲,有三个值分三个叉似乎更直观,但在决策树建模中,不推荐这样做(或者说CART不支持这样做),主要有几个原因:
数据碎片化:如果直接分成三类,每个节点的数据量会迅速减少。对于只有10条数据的小样本,分三个叉会导致某些节点数据太少,无法进行后续分裂或导致过拟合。
计算效率与稀疏性:多叉树会导致树变得更宽、更浅,但对于取值很多的类别特征(例如“职业”有几十种),分多叉会让模型变得极其稀疏且难以泛化。
CART的设计:CART是一种二叉树算法,它在数学上被设计为每次只做一个“是非”判断。对于多类别特征,它通过“超类别划分”来处理,即把多个类别合并到一边。
3. 补充:ID3 与 C4.5 的区别
这里有一个细节值得注意:
C4.5 算法:处理多类别特征时,可以支持多分支(即分三叉)。它通常直接按每个取值分一个分支,利用“信息增益率”来选择特征。
CART 算法:无论特征是离散的还是连续的,它永远只生成二叉树。对于离散特征,它通过将类别组合成两个子集来实现二分裂。
基尼指数是 CART 算法的分裂依据。因此,这里采用的是 CART 的逻辑,所以必须将婚姻状况分成两类来算,找到最优组合。
总结:
之所以分成二分类(如单身/非单身、已婚/非婚等)来算,是因为这是在用CART算法构建二叉树。算法需要从所有可能的二元划分组合中,选出基尼指数最小(即节点纯度最高)的那一组作为最终分裂方式。
案例
"""
案例: 演示 CART 分类回归决策树的 分类功能.
"""

# 导包
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import classification_report
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree


# 1. 加载数据.
data = pd.read_csv('./data/train.csv')
# data.info()

# 2. 数据的预处理.
# 2.1 提取特征和标签.
x = data[['Pclass', 'Sex', 'Age']]
y = data['Survived']
# print(x.head(5))
# print(y.head(5))

# 2.2 发现Age列有确实, 我们用该列的 平均值做填充.
# x['Age'].fillna(x['Age'].mean(), inplace=True)      # 会报警告, 但是可以用.
# x['Age'] = x['Age'].fillna(x['Age'].mean())           # 会报警告, 因为是直接修改源数据的.

# 解决方案, copy()数据之后再改.
x = x.copy()                                          # 拷贝数据, 不写也行.
x['Age'] = x['Age'].fillna(x['Age'].mean())           # 会报警告, 因为是直接修改源数据的.

# 2.3 查看处理后的数据集.
# x.info()

# 2.4 针对于 Sex列, 进行one-hot编码.
x = pd.get_dummies(x, columns=['Sex'])
# x.info()

# 2.5 划分训练集和测试集.
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=23)

# 3. 特征工程.

# 4. 模型训练
# 参数: max_depth=10 意思是: 绘制的 决策树结构, 最多10层.
estimator = DecisionTreeClassifier(max_depth=10)
estimator.fit(x_train, y_train)

# 5. 模型预测.
y_pred = estimator.predict(x_test)
print(f'预测值为: {y_pred}')

# 6. 模型评估.
print(f'分类评估报告: \n {classification_report(y_test, y_pred)}')

# 7. 绘制 决策树 图.
plt.figure(figsize=(30, 20))    # 设置图片大小, 30 * 100(dpi) * 20 * 100(dpi) = 3000 * 2000像素
# 参1: 模型对象, 参2: 是否用颜色填充, 参3: 绘制的 决策树结构, 最多10层.
plot_tree(estimator, filled=True, max_depth=10)
plt.savefig('./data/my_titanic.png')
plt.show()
CART分类树和回归树的特点及其构建过程
cart分类树
采用基尼指数,计算量减小,一定是二叉树,预测输出的是一个离散值,使用叶子节点多数类别作为预测类别
构建过程:各个特征先分类,计算基尼值,计算基尼指数。如果是多个值,将值排序,以相邻中间值作为待确定分裂点,计算出两部分的基尼指数,比较出最小的基尼指数,为该特征的基尼指数。比较各个特征的基尼指数,优先选择最小的特征。
cart回归树:
预测输出的是一个连续值,使用平方损失作为划分、构建树的依据,采用叶子节点里均值作为预测输出
构建过程:将特征值排序,以相邻中间值作为待划分点,根据划分点,将数据集分为两部分,两部分平方损失相加作为该切分点平方损失,取最小的平方损失的划分点,作为当前特征的划分点,依次类推,计算所以特征的最优划分点和对应损失值,比较所有特征的最小平方损失的划分点,作为当前树的分裂点
决策树剪枝的方法有哪些?及各自的特点是什么?
预剪枝:
使决策树的很多分支没有展开,不单降低了过拟合风险,还显著减少了决策树的训练、测试时间开销但是有些分支的当前划分虽不能提升泛化性能,但后续划分却有可能导致性能的显著提高;预剪枝决策树也带来了欠拟合的风险
后剪枝:
比预剪枝保留了更多的分支。一般情况下,后剪枝决策树的欠拟合风险很小,泛化性能往往优于预剪枝但是训练时间开销比未剪枝的决策树和预剪枝的决策树都要大得多。
更多推荐


 39
 0
- 0


 已为社区贡献26条内容

所有评论(0)