
C++ STL 关联容器详解(一):set 的原理,接口与实战
一. 前言
在之前的文章中,我们已经熟悉了 string、vector、list、deque 等 序列式容器。这类容器的本质是线性序列,元素之间没有严格的逻辑约束,其存储顺序仅取决于插入的先后或人为指定的索引。你可以随意交换两个元素的位置,而不会破坏容器本身的结构属性
然而,当我们需要从海量数据中快速检索目标时,序列式容器往往显得力不从心。这时,关联式容器(Associative Containers) 便登场了。与序列式容器不同,关联式容器的逻辑结构通常是非线性的,其内部元素通过关键字(Key) 进行组织。在这种结构中,元素的位置与值是强绑定的,一旦破坏了这种逻辑关联,整个存储结构就会失效
本系列章节我们将重点探讨基于红黑树(平衡二叉搜索树) 实现的 set 与 map 系列:
-
set:专注于 Key 搜索 场景,用于高效判断元素是否存在
-
map:专注于 Key-Value 映射 场景,实现键与值的精准关联
二. set 的本质
很多人初次接触集合(set)时,往往简单地认为它只是一个有序且不重复的元素集合。然而,这样的理解还远远不够深入,要真正掌握集合,必须深入了解其底层实现原理
底层数据结构
std::set 的底层实现基于红黑树(Red-Black Tree),这是一种特殊的自平衡二叉搜索树。红黑树通过特定的规则维护树的平衡性,确保在最坏情况下也能保持较高的操作效率。
这意味着:
-
元素自动按 key 排序
-
插入、删除、查找时间复杂度都是 O(log n)
-
最坏情况下树的高度不超过 2log(n + 1)
为什么不是 O(n)
因为红黑树是一种高度近似平衡的二叉搜索树,树的高度始终控制在 log n 级别,这也是 set 性能稳定的根本原因,对于100万个元素,普通BST最坏可能需要100万次比较,而红黑树最多只需约20次(log₂10⁶≈20)
Key 和 Value 的统一
在 set<T> 中
value_type == key_type == T
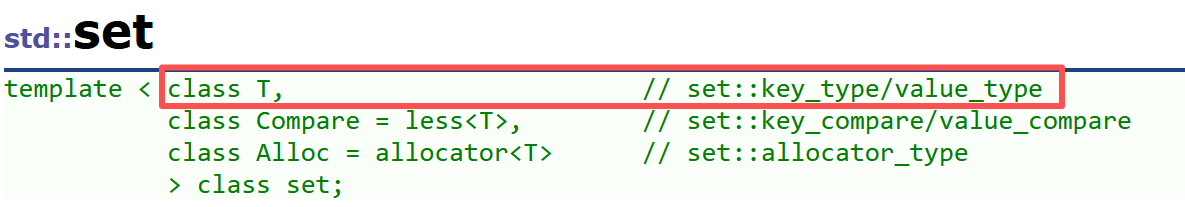
也就是说 value 就是 key,而更重要的一点是
value 的类型是 const T
这意味着当我们想要通过迭代器修改 set 中的值时
std::set<int> s = {1, 2, 3};
auto it = s.begin();

*it = 10; // 编译报错 error: assignment of read-only location
为什么不允许修改
要深入理解 std::set 的本质,最直接的方法是分析其源码实现(以 GCC 的 libstdc++ 为例)。实际上,set 本质上是一个高度专一的封装器,其核心功能几乎完全依赖于底层的红黑树结构
通过源码,我们可以从以下两个层面看清为什么 set 的元素不可修改
1. 容器定义
在 set 的源代码中我们可以看到它是如何定义底层红黑树的。请注意它传给红黑树的模板参数:
// 简化自 GCC libstdc++ <bits/stl_set.h>
template<typename _Key, typename _Compare = std::less<_Key>,
         typename _Alloc = std::allocator<_Key>>
class set {
public:
  // 注意这里!
  typedef _Key     key_type;
  typedef _Key     value_type;

private:
  // 底层红黑树定义
  typedef typename __gnu_cxx::__alloc_traits<_Alloc>::template
    rebind<_Key>::other _Key_alloc_type;

  typedef _Rb_tree<key_type, value_type, _Identity<value_type>,
                   key_compare, _Key_alloc_type> _Rep_type;

  _Rep_type _M_t;  // 这就是那棵红黑树
};
-
在 set 中,红黑树的 key_type 和 value_type 全都是 _Key。
-
_Identity<value_type> 作为函数对象,其作用是让红黑树直接从元素本身获取键值,无需额外处理
2. 迭代器定义
这是回答为什么不能修改的最直接证据。在 set 的类定义中,你会发现这样一行:
// 摘自 <bits/stl_set.h>
typedef typename _Rep_type::const_iterator iterator;
typedef typename _Rep_type::const_iterator const_iterator;
在 set 的实现中,iterator 和 const_iterator 实际上是同一种类型:红黑树的 const_iterator
这意味着,当你写 *it = newValue 时,你实际上是在尝试对一个 const 引用进行赋值。编译器在看到 typedef 的那一刻就已经决定了这行代码无法通过编译
multiset
| 特性 | std::set | std::multiset |
| 唯一性 | 键必须唯一 | 允许键重复 |
| 插入行为 | 插入重复键会失败 | 插入重复键总能成功 |
| 底层实现 | 红黑树 | 红黑树 |
| 常用场景 | 数据过滤、唯一性校验 | 动态排序、频率统计 |
三. set 常用接口使用
插入(insert)
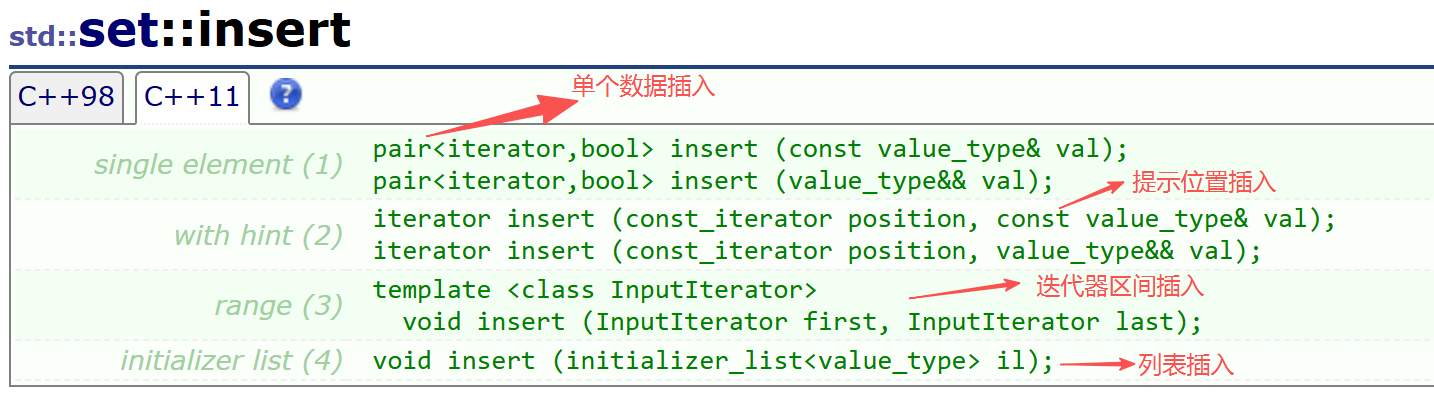
我们可以看到,单个数据插入时返回值是 pair<iterator, bool>
什么是 pair?
一个简单的结构体模板,把两个可能不同类型的值(T1 和 T2)组合成一个单元。只有两个公开成员:first 和 second
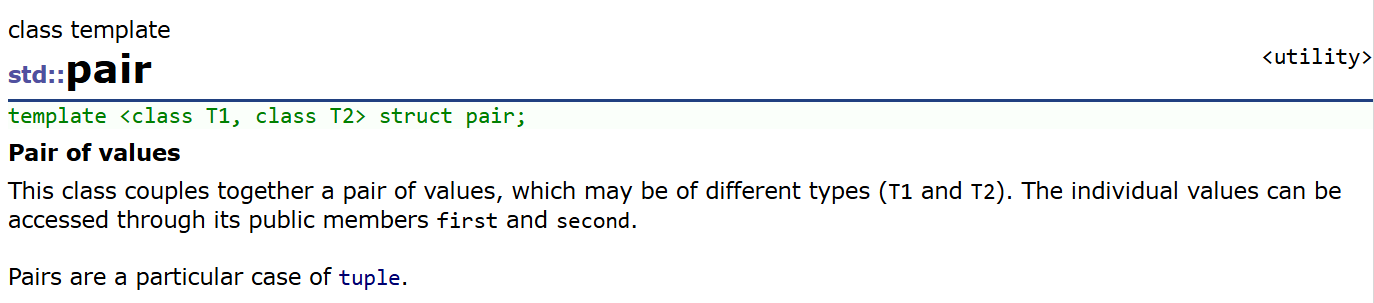
在 set 中,pair.first 返回的是指向该元素的迭代器,而 pair.second 返回的则是插入结果
std::set<int> s;
auto ret = s.insert(10);
if(ret.second == false)
    std::cout << "插入失败!" << std::endl;
查找(find)
1. 算法库 std::find:线性搜索
std::find 是一个泛型算法。它对容器的内部结构一无所知,它只拿到了两个迭代器:begin 和 end
具体实现类似于:
template<class InputIterator, class T>
  InputIterator find (InputIterator first, InputIterator last, const T& val)
{
  while (first!=last) {
    if (*first==val) return first;
    ++first;
  }
  return last;
}
-
工作原理: 该算法采用线性查找方式,逐个比对元素
-
复杂度: O(n)。如果你有一百万个元素,最坏的情况它要比较一百万次
-
为什么这么慢? 为确保通用性(兼容list、vector、forward_list等各类容器),该算法无法针对特定数据结构进行优化,因此效率受限
2. 成员函数 set::find:对数搜索
set::find 是 set 专门为自己定制的。它非常清楚自己的底层是一棵红黑树
-
工作原理: 它利用了“左子树比根小,右子树比根大”的特性。每比较一次,它就能直接排除掉一半的搜索空间
-
复杂度: O(log n)
-
数据对比: 如果有一百万个元素:std::find 最多需要走 1,000,000 步。set::find 最多只需要走 20 步左右(log₂10⁶≈20)
在 C++ STL 中有一个不成文的准则:如果容器有同名的成员函数,永远优先使用成员函数,而不是算法库里的通用版本。 比如 set::find 优于 std::find,list::sort 优于 std::sort
删除(erase)
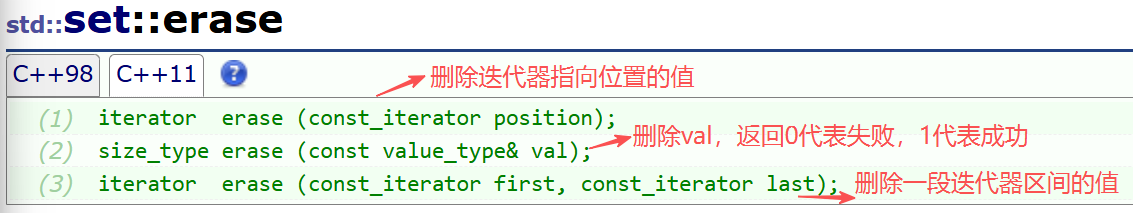
循环删除时正确写法:
for(auto it = s.begin(); it != s.end(); )
{
    if(*it % 2 == 0)
        it = s.erase(it);
    else
        ++it;
}
注意千万不要这么写:
erase(it);
++it;
1. 核心原因:迭代器失效(Iterator Invalidation)
这是最根本的理由。iterator 在底层本质上是指向红黑树节点的一个包装指针
-
当你执行 s.erase(it) 时,该迭代器所指向的那个节点被彻底销毁并从树中移除了。此时,it 变成了一个野指针
-
紧接着执行 ++it,相当于对野指针进行直接操作。结果就是未定义行为,程序可能会直接崩溃(Crash),或者产生诡异的逻辑错误
2. 为什么 it = s.erase(it) 是标准答案?
在 C++11 及以后的标准中,关联式容器的 erase 接口会返回一个指向被删除元素之后那个元素的有效迭代器。
在销毁旧节点之前,它已为你找到下一个落脚点,并将该位置交还给你,确保循环能够安全持续执行,避免出现踩空的情况
3. 关于 C98 的返回值
C++98 标准下的 set::erase 方法返回值为 void,这个特性值得注意
所对应的正确写法就是
// C++98 的写法
s.erase(it++);
原理:it++ 是后置递增操作,它会先创建 it 的副本传递给 erase 函数。在 erase 函数执行之前,原始的 it 已经自动指向下一个节点
lower_bound / upper_bound
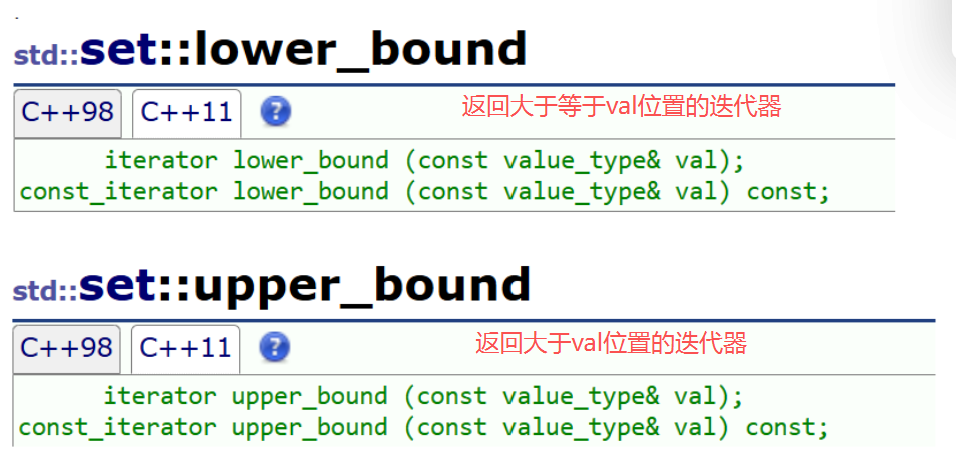
通常用于区间查询,找第一个不小于某值的元素,二分替代等
例如删除一个区间
// 删除 [30, 100) 的区间
s.erase(s.lower_bound(30), s.upper_bound(100));
经典实战:LeetCode 349. 两个数组的交集
在掌握了 set 的接口后,我们来看这道经典的面试题
1. 题目描述
给定两个数组 nums1 和 nums2 ,返回它们的交集。输出结果中的每个元素一定是唯一的。可以不考虑输出结果的顺序
2. 为什么这道题要选 set
这道题有两个核心需求:
-
去重:结果集中的元素必须唯一。
-
查找:需要快速判断数组 B 中的元素是否在数组 A 中出现过。
这正是 set 的专长所在。借助其底层红黑树结构,我们既能实现 O(log n) 的高效查找,又能自动完成数据去重
3. 代码实现
class Solution
{
public:
    vector<int> intersection(vector<int>& nums1, vector<int>& nums2)
    {
        // 先将两个数组的值分别存入 set
        set<int> s1(nums1.begin(), nums1.end());
        set<int> s2(nums2.begin(), nums2.end());

        vector<int> ret;
        // 查找同时出现在两个数组中的值加入到 ret 中
        auto it1 = s1.begin();
        auto it2 = s2.begin();
        while(it1 != s1.end() && it2 != s2.end())
        {
            // 较小的++,相等的就是交集
            if(*it1 < *it2) ++it1;
            else if(*it1 > *it2) ++it2;
            else
            {
                ret.push_back(*it1);
                ++it1;
                ++it2;
            }
        }
        return ret;
    }
}
4. 时间复杂度分析
假设 nums1 的长度为 N,nums2 的长度为 M
构建 set
-
set<int> s1:将 N 个元素插入红黑树,每次插入是 O(log N),总计 O(N log N)
-
set<int> s2:将 M 个元素插入红黑树,每次插入是 O(log M),总计 O(M log M)
双指针遍历
每次循环中,要么 it1 前进,要么 it2 前进,或者两者同时前进。最坏情况下需要走完两个集合中所有的唯一元素。复杂度:O(N + M)
总时间复杂度 = O(NlogN + MlogM) + O(N + M)
由于 NlogN 的增长速度快于 N,最终简化为:O(NlogN + MlogM)
5. 空间复杂度分析:
由于创建了两个额外的 set 来存储数据,最坏情况下空间复杂度为 O(N + M)
经典实战:LeetCode 142. 环形链表 II
1. 题目描述
给定一个链表的头节点 head,返回链表开始入环的第一个节点。如果链表无环,则返回 null
要求:不得修改链表
2. 解题思路
这道题的核心难点在于:如何判断回到了同一个节点
想象你在一个未知的迷宫中行走,为了防止迷路,你每经过一个路口,就在本子上记录下这个路口的唯一标识
-
当你走到一个路口,发现它已经在你的本子上了,说明你绕回来了,这个路口就是环的入口
-
如果你走到了死胡同(nullptr),说明这根本不是一个环。
这个本子就是 std::set,而路口的唯一标识就是节点的内存地址
关键细节: 为什么存指针而不存 val? 因为链表中可能有多个节点存储相同的数值(比如好几个节点都存了 1),但每个节点的内存地址在内存中是绝对唯一的,通过存储指针,我们能准确判断节点的物理位置,而非仅依据逻辑数值
3. 代码实现
/**
 * Definition for singly-linked list.
 * struct ListNode {
 * int val;
 * ListNode *next;
 * ListNode(int x) : val(x), next(NULL) {}
 * };
 */
class Solution
{
public:
    ListNode* detectCycle(ListNode* head)
    {
        // 先定义一个 set 用来存储节点的指针
        std::set<ListNode*> s;

        ListNode* cur = head;
        while(cur != nullptr)
        {
            // 1. 先在 set 中查找是否已经出现过
            // 如果出现过则说明找到了环的入口
            if(set.count(cur) != 0)
                return cur;

            // 2. 没出现过则放入 set 中
            s.insert(cur);

            // 3. cur 继续遍历下一个节点
            cur = cur->next;
        }
        // 如果循环结束还没找到重复,说明没有环
        return nullptr;
    }

}
4. 复杂度分析
-
时间复杂度:O(nlogn)
-
我们需要遍历链表中的 n 个节点
-
每次在 std::set 中进行 count 或 insert 操作,底层红黑树的查找/插入开销是 O(log n)
-
-
空间复杂度:O(n)
-
最坏情况下(环在链表末端或无环),我们需要把链表中所有 n 个节点的地址都存进 set 中
-
四. 总结
-
本质:这不是普通的集合,而是一棵严格遵循红黑树结构的有序容器。需要特别注意的是,set中的元素都是只读的(const类型)。若需要修改元素,必须先执行erase操作删除旧值,再通过 insert 插入新值
-
性能:优先使用成员函数(如 s.find())。标准库算法 std::find 是线性扫描 O(n),而 set::find 则具有对数级复杂度 O(log n),性能优势显著
-
安全:在循环中删除元素时,必须使用 it = s.erase(it) 的正确写法。直接删除会导致迭代器失效,引发未定义行为。
在 C++ 的学习进程中,比起熟练调用接口,更核心的竞争力在于理解其背后的设计哲学。当我们开始思考 const 约束对红黑树稳定性的意义,或序列式容器在内存操作中的边界效应时,我们便超越了API 调用者的范畴,进入了底层驱动的开发视野。
下一篇博文,我们将更进一步,解析具备映射属性的 std::map,共同领略键值对(Key-Value)模式在复杂场景下的应用魅力
更多推荐


 8
 0
- 0


 已为社区贡献9条内容

所有评论(0)