
动手学深度学习(李沐)笔记:数据操作(Data Manipulation)
·
学深度学习第一步不是模型,而是数据怎么在框架里流动。在 PyTorch 里,几乎所有数据都会被表示成 Tensor(张量)。这一节我按“能写代码就算会”的标准,把最常用的数据操作过一遍。
环境:Python + PyTorch(CPU/GPU 都可)
1. Tensor 是什么:多维数组 + 可上 GPU + 支持自动求导
Tensor 本质上就是一个多维数组,但它比 numpy.ndarray 更适合深度学习:
-
可以放到 GPU(
.to("cuda")) -
可以做自动求导(后面反向传播用)
-
运算 API 更适合神经网络
2. 创建张量:最常用的 5 种方式
import torch

# 1) 直接创建(Python 列表 -> Tensor)
x = torch.tensor([1.0, 2.0, 3.0])

# 2) 指定形状,生成全 0 / 全 1
a = torch.zeros(2, 3)
b = torch.ones(2, 3)

# 3) 生成随机数(均匀分布)
c = torch.rand(2, 3)

# 4) 正态分布随机数
d = torch.randn(2, 3)

# 5) 等差序列
e = torch.arange(0, 10, 2)  # 0,2,4,6,8
经验:
-
写网络时最常见的是
zeros/ones/randn -
Debug 数据范围时常用
arange
3. 形状与维度:shape / numel / reshape
X = torch.arange(12)
print(X.shape)     # torch.Size([12])
print(X.numel())   # 12

X = X.reshape(3, 4)
print(X)
print(X.shape)     # torch.Size([3, 4])
关键点:
-
reshape不改数据本身,只是换“视图/结构”(多数情况下是 O(1)) -
numel()是元素总数(排错非常好用)
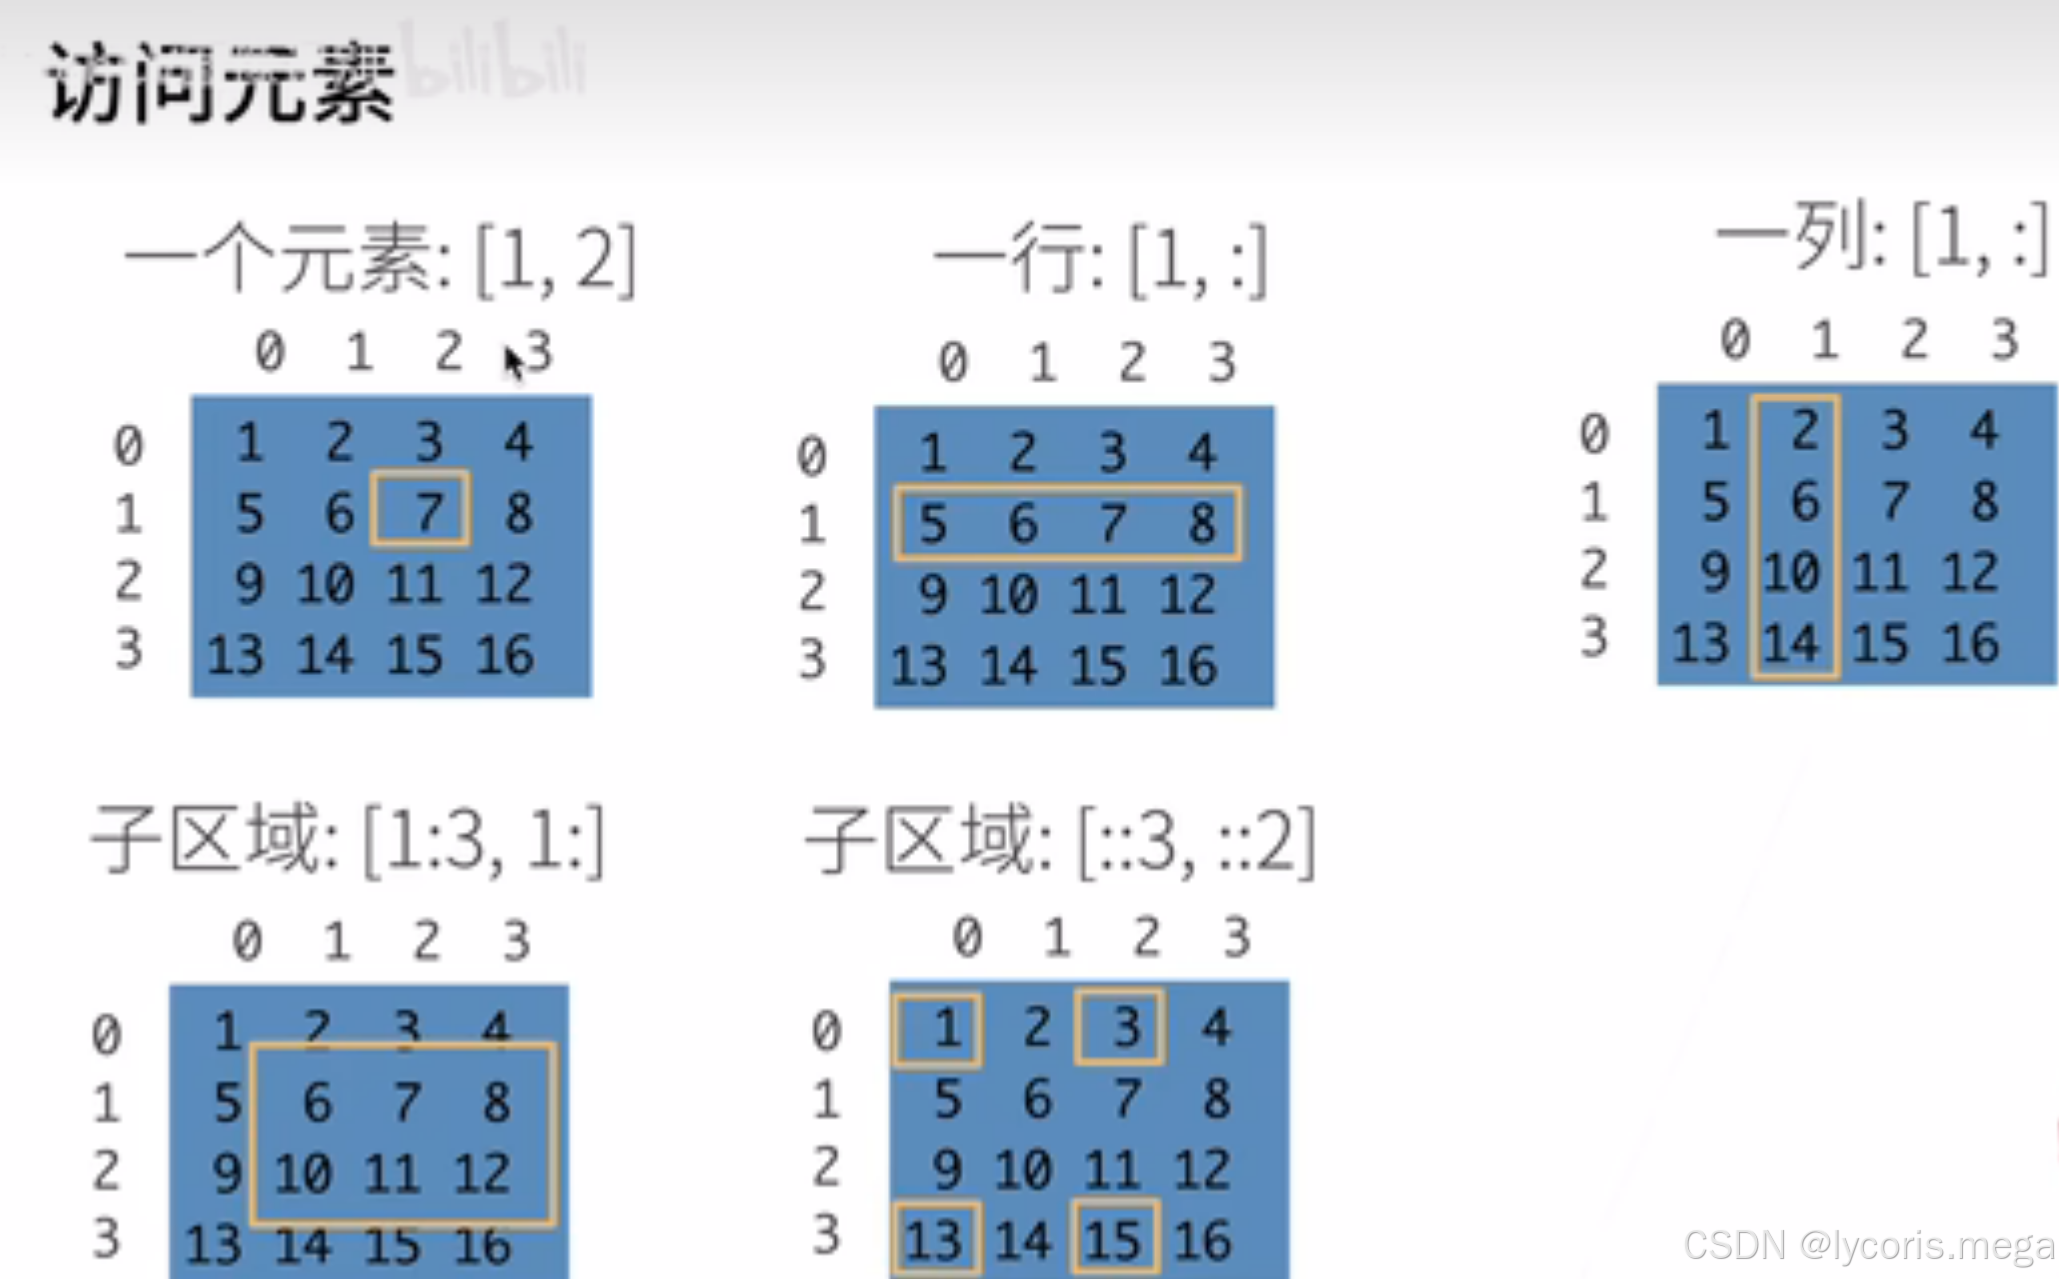
4. 索引与切片:和 Python/Numpy 很像
X = torch.arange(12).reshape(3, 4)

print(X[0])        # 第 0 行
print(X[:, 1])     # 第 1 列
print(X[1, 2])     # 第 1 行第 2 列

print(X[0:2, :])   # 前两行
修改某一块数据:
X[0:2, :] = 100
print(X)
5. 拼接与切分:cat / stack / split(非常常用)
cat:沿某个维度拼接(维度不增加)
A = torch.ones(2, 3)
B = torch.zeros(2, 3)

C0 = torch.cat((A, B), dim=0)  # 行方向拼
C1 = torch.cat((A, B), dim=1)  # 列方向拼
stack:拼起来并新增一个维度
S = torch.stack((A, B), dim=0) # shape: (2, 2, 3)
记忆法:
-
cat:拼在一起,维度不变 -
stack:摞起来,维度 +1
6. 逐元素运算:加减乘除、指数、比较
X = torch.tensor([1.0, 2.0, 4.0, 8.0])
Y = torch.tensor([2.0, 2.0, 2.0, 2.0])

print(X + Y)
print(X - Y)
print(X * Y)
print(X / Y)
print(X ** Y)      # 幂
比较与生成 mask:
print(X == Y)
print(X > Y)
7. 广播机制(Broadcasting):写深度学习一定会遇到
广播解决的问题:不同形状的张量怎么做运算?
A = torch.arange(3).reshape(3, 1)  # (3,1)
B = torch.arange(2).reshape(1, 2)  # (1,2)

print(A + B)  # (3,2)
解释一下:
-
A 会被“复制扩展”成 (3,2)
-
B 也会被“复制扩展”成 (3,2)
-
然后逐元素相加
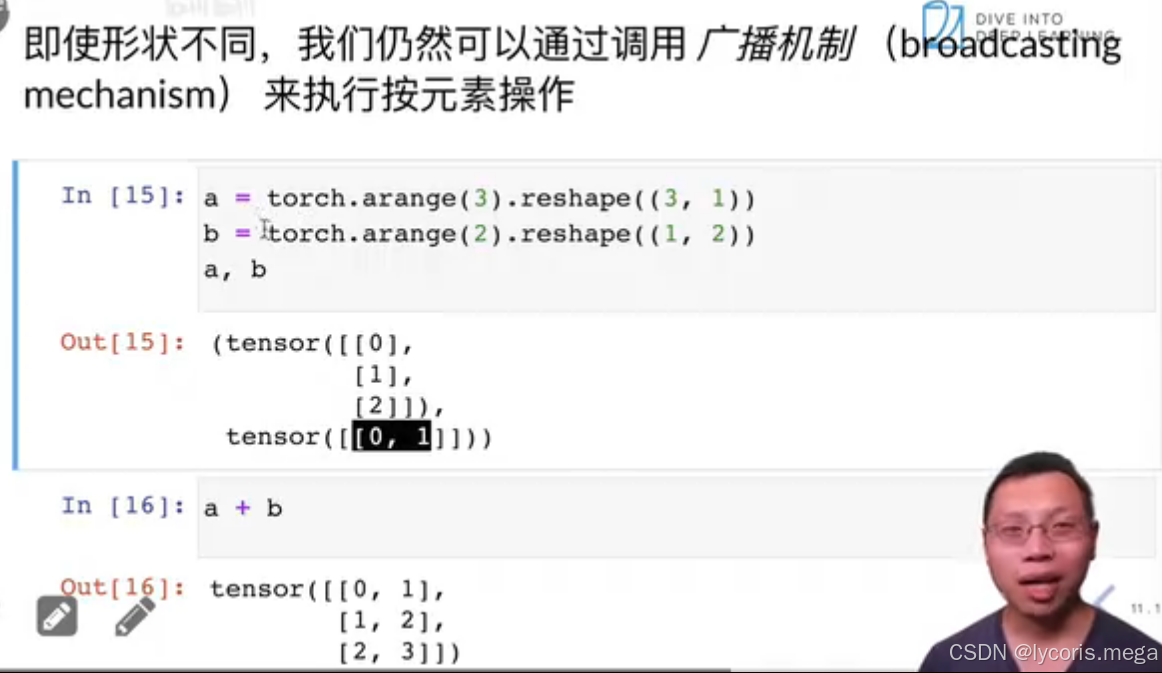
本质规则:从后往前对齐维度:
-
维度相等 ✅
-
其中一个维度是 1 ✅(可广播)
-
否则 ❌ 报错
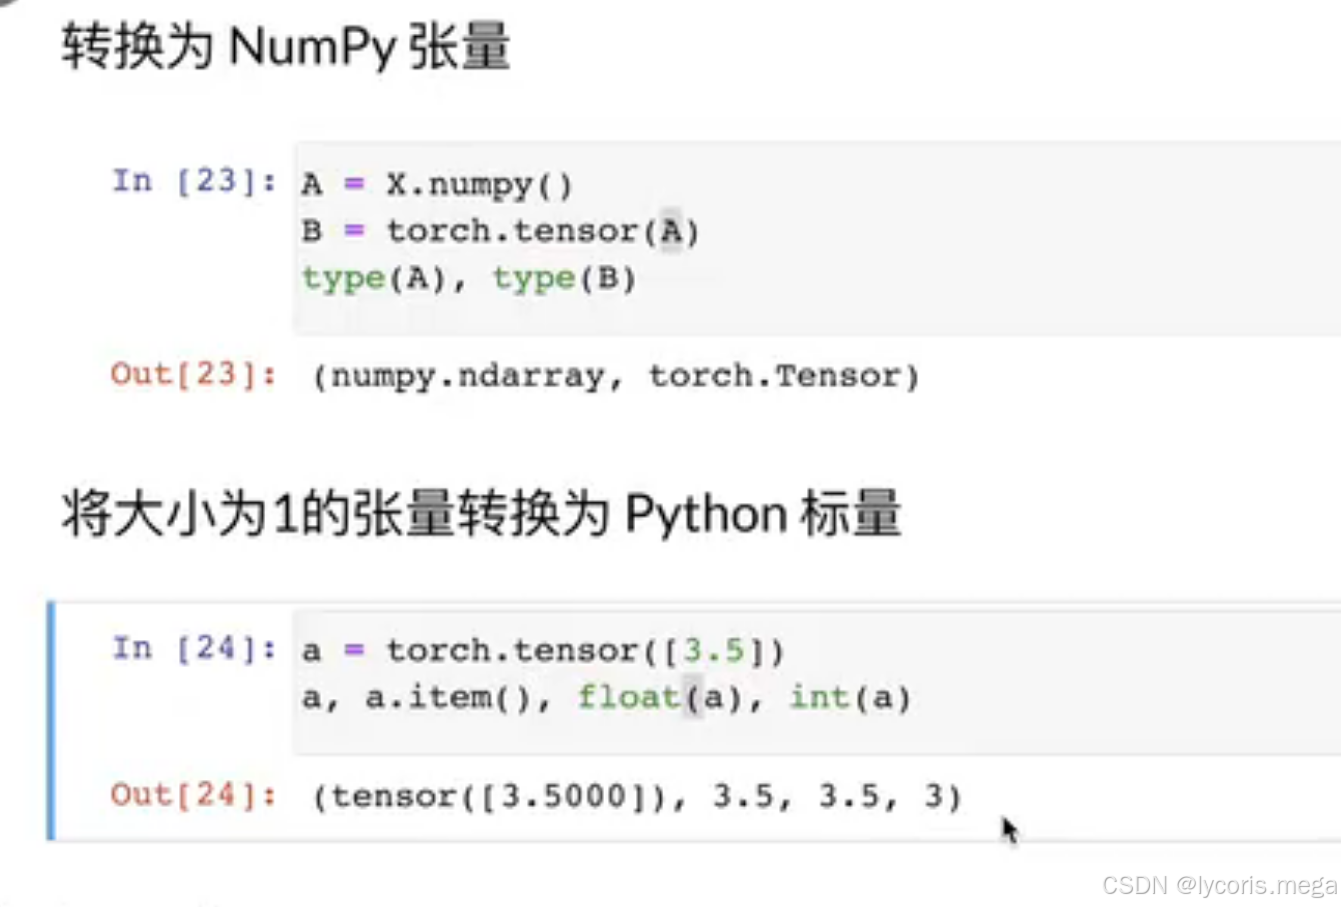
8. 转 numpy / 转 Python 数值:调试时常用
X = torch.arange(6).reshape(2, 3)

# Tensor -> numpy
npX = X.numpy()

# 只有一个元素的 Tensor -> Python 标量
s = torch.tensor([3.14]).item()
9. 保存与加载:模型训练离不开
保存 tensor:
X = torch.arange(12).reshape(3, 4)
torch.save(X, "X.pt")
加载:
Y = torch.load("X.pt")
print(Y)
(后面保存模型参数也用同样思路)
10. 本节最容易踩坑的点(我自己的总结)
-
reshape 维度要对:元素总数必须一致,否则直接报错
-
cat和stack容易混:一个不增维,一个增维 -
广播不是“随便加”,是严格规则:不满足会报 shape mismatch
-
.item()只能用于单元素 tensor
结语:为什么“数据操作”值得单独学?
因为你后面会不断遇到这些问题:
-
我的 batch 维是第几维?
-
这个张量怎么从 (N, C, H, W) 变到 (N, H, W, C)?
-
为什么 loss 能算,但反向传播报维度错?
-
为什么加法能跑(广播),但 cat 报错?
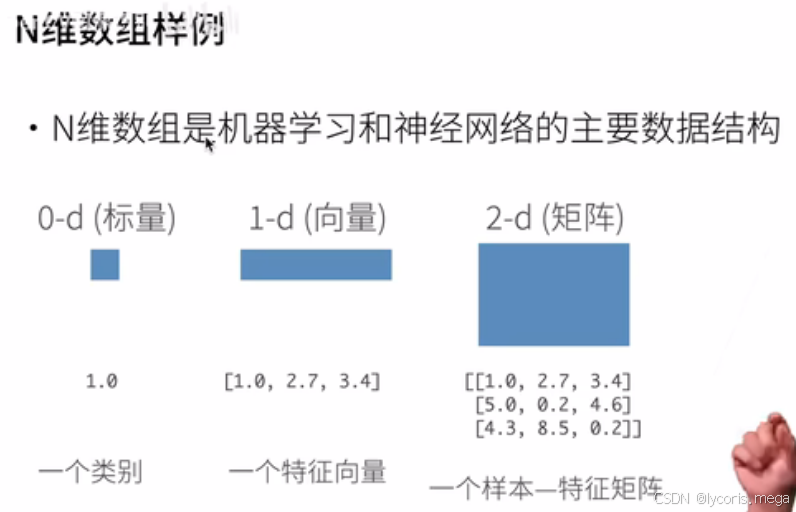
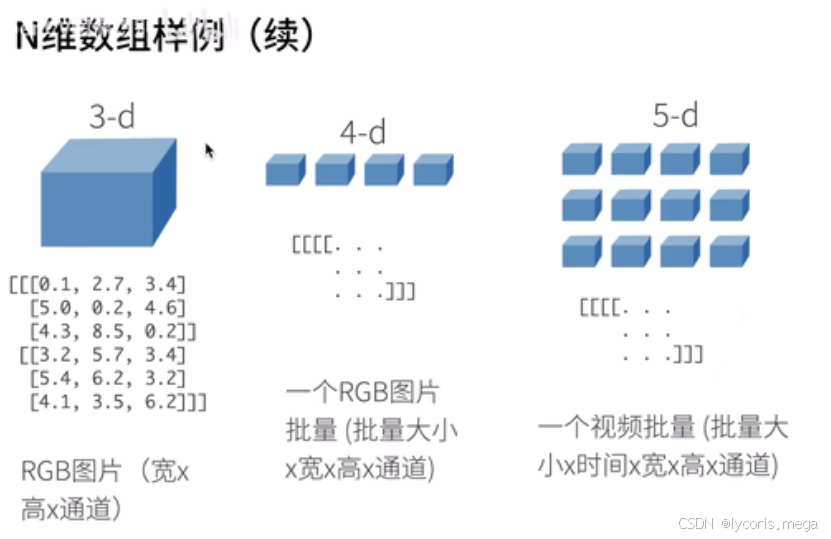
更多推荐

 7
 0
- 0


 已为社区贡献101条内容

所有评论(0)