
动手学深度学习(李沐)笔记:数据预处理(Data Preprocessing)
做深度学习时,模型结构往往不是最难的,最折磨人的是:数据脏、缺、乱、不统一。这一节按李沐的流程,完整走一遍:
-
生成/读取 CSV
-
处理缺失值(NaN)
-
类别特征编码(one-hot)
-
转成 Tensor 供模型训练
你把这套跑通,后面做 Kaggle / 蓝桥杯建模题都更稳。
1. 准备:导入库 + 读 CSV
李沐这一节核心是 pandas(负责表格) + torch(负责张量)。
import os
import pandas as pd
import torch
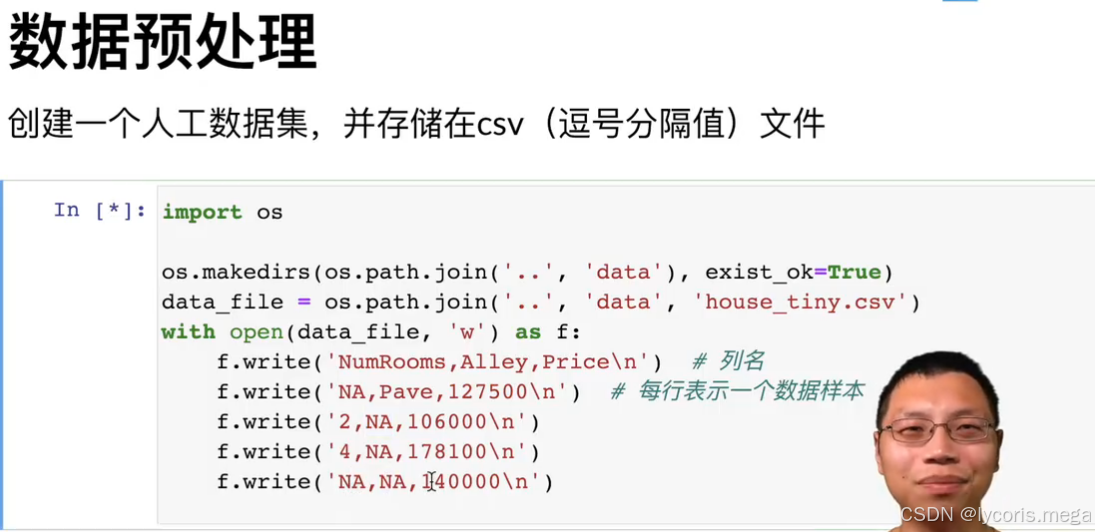
假设我们有一个 house_tiny.csv(李沐示例常用“房价”这种结构)。如果你本地没有,也可以先用代码造一个(方便复现实验):
os.makedirs("data", exist_ok=True)

data_file = os.path.join("data", "house_tiny.csv")
with open(data_file, "w") as f:
    f.write("NumRooms,Alley,Price\n")
    f.write("NA,Pave,127500\n")
    f.write("2,NA,106000\n")
    f.write("4,NA,178100\n")
    f.write("NA,NA,140000\n")
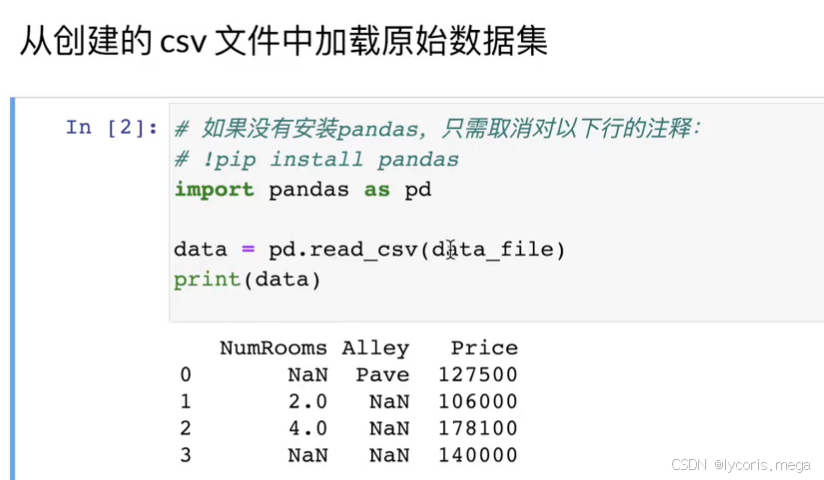
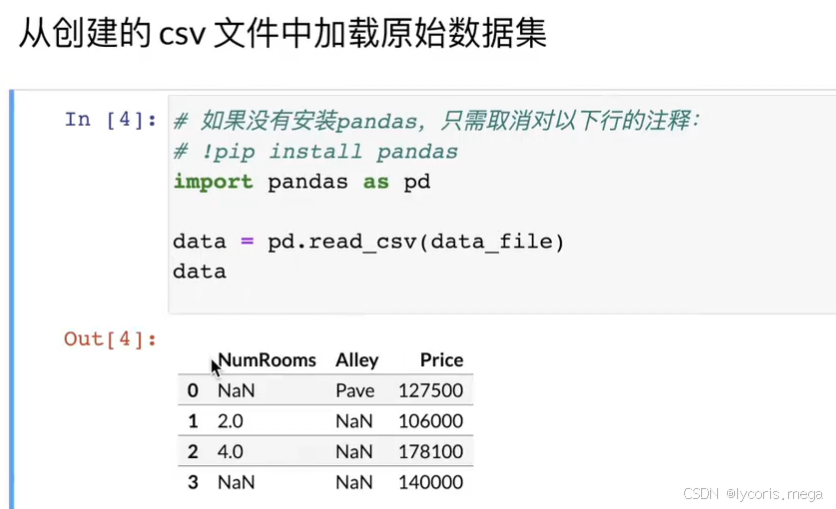
读入:
data = pd.read_csv(data_file)
print(data)
你会看到 NA 被识别成缺失值(NaN)。
2. 分离特征与标签:inputs / outputs
一般我们会把最后一列当作标签(Price),其他列当特征:
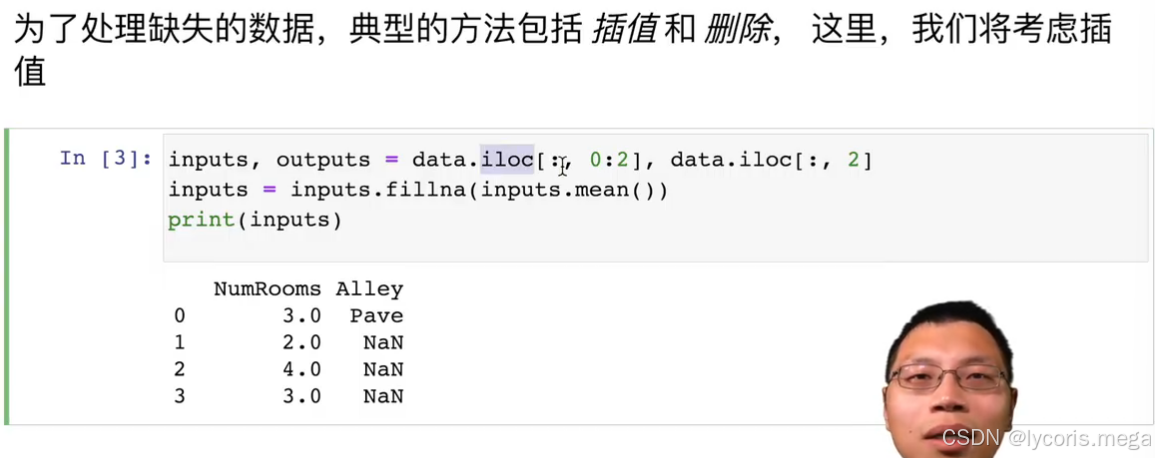
inputs, outputs = data.iloc[:, 0:2], data.iloc[:, 2]
print(inputs)
print(outputs)
-
inputs:NumRooms、Alley -
outputs:Price(回归标签)
3. 处理缺失值(最常用):均值填充
数值特征缺失最常见处理:用该列均值填充(baseline 但有效)。
inputs_num = inputs.iloc[:, 0]  # NumRooms
inputs.iloc[:, 0] = inputs_num.fillna(inputs_num.mean())
print(inputs)
解释:
-
fillna(均值)让 NumRooms 不再有 NaN -
这是“最朴素但最稳”的预处理之一(尤其 baseline)
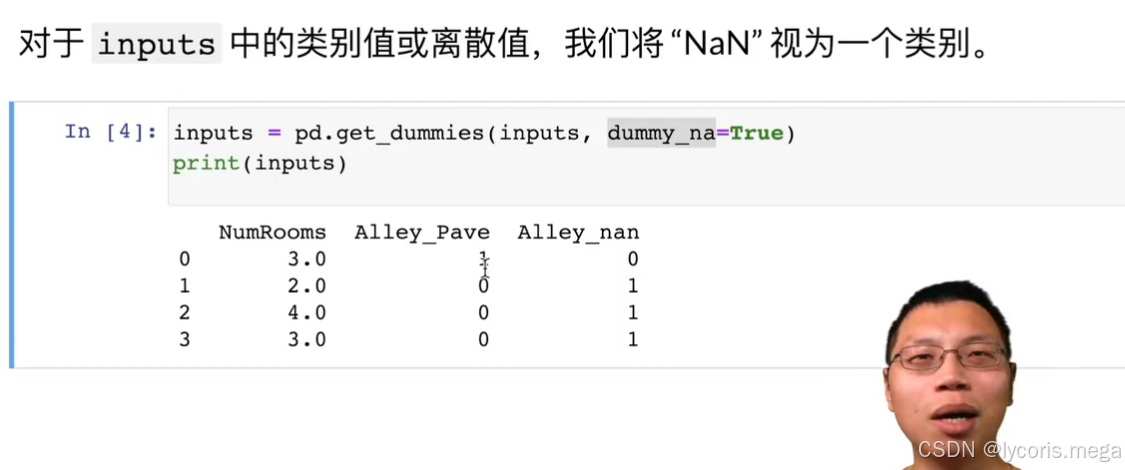
4. 类别特征处理:one-hot 编码
Alley 是类别特征(Pave / NA / …),模型不能直接吃字符串,所以需要 one-hot:
inputs = pd.get_dummies(inputs, dummy_na=True)
print(inputs)
dummy_na=True 的效果很关键:它会把缺失值也当成一种类别。
最终列可能长这样:
-
NumRooms
-
Alley_Pave
-
Alley_nan
这样模型就能把“是否缺失”也当作信息学习(有时反而有用)。
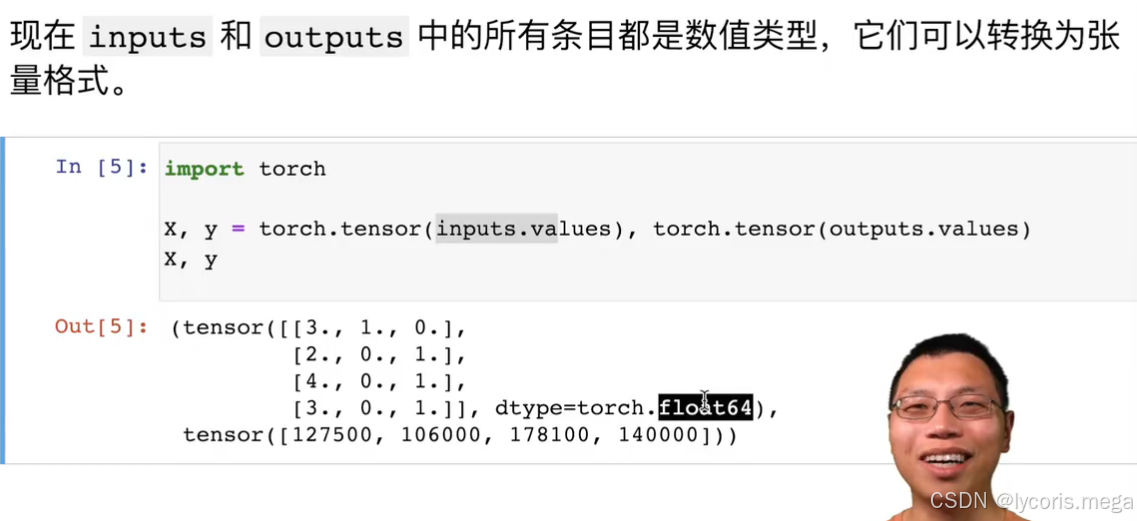
5. 转成 Tensor(PyTorch 训练输入)
pandas → numpy → torch:
X = torch.tensor(inputs.to_numpy(dtype=float))
y = torch.tensor(outputs.to_numpy(dtype=float)).reshape(-1, 1)

print(X)
print(y)
print(X.shape, y.shape)
注意点:
-
dtype=float:避免 one-hot 后数据变成 object 类型 -
y.reshape(-1, 1):把标签转成列向量,更符合线性回归/MLP输入
6. 本节最容易踩的坑(我踩过的那种)
-
one-hot 之后 dtype 变 object
解决:to_numpy(dtype=float)或astype(float) -
标签 y 维度不对
训练时常见报错:(n,)vs(n,1)
解决:reshape(-1,1) -
缺失值处理顺序
-
数值特征:均值填充
-
类别特征:
get_dummies(dummy_na=True)
不要反过来,不然你会搞出奇怪的列。
-
7. 小结:李沐这节想让你掌握什么?
这一节其实就是深度学习数据预处理的“最小闭环”:
-
读入表格(CSV)
-
数值缺失:均值填充
-
类别特征:one-hot(缺失也编码)
-
转 Tensor:准备喂给模型
这套流程是你后面做回归/分类任务的基本模板。
更多推荐

 6
 0
- 0


 已为社区贡献101条内容

所有评论(0)