
动手学深度学习(李沐)笔记:线性回归(Linear Regression)= 最小训练闭环
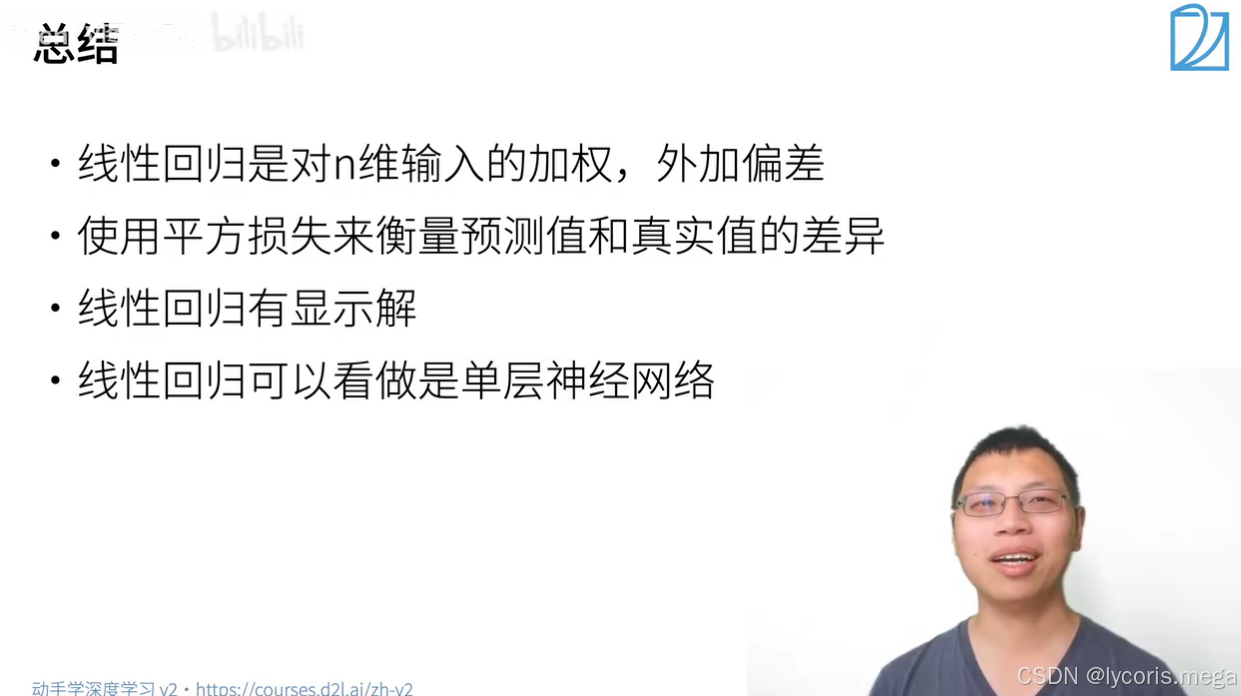
线性回归是深度学习里最经典的“第一性模型”:
你会第一次把下面这套完整闭环跑通:
数据 → 模型 → 损失 → 梯度 → 更新参数 → 训练收敛
而且它非常贴近你前面学的两章:
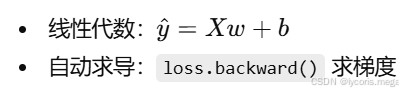
1. 模型:( \hat{y} = Xw + b )
假设每个样本有 (d) 个特征:
-
(X \in \mathbb{R}^{n \times d})(n 个样本)
-
(w \in \mathbb{R}^{d \times 1})
-
(b \in \mathbb{R})
-
输出:(\hat{y} \in \mathbb{R}^{n \times 1})
y_hat = X @ w + b
直觉:线性回归就是把特征加权求和(大量点积),再加一个偏置。
2. 损失函数:平方损失(MSE)
常用的是均方误差(MSE):
[
L(y, \hat{y}) = \frac{1}{n}\sum_{i=1}^n (y_i - \hat{y}_i)^2
]
实现时最常见写法:
loss = ((y_hat - y) ** 2).mean() / 2
除以 2 是为了求导后更简洁(李沐也经常这么写),不影响最优解位置。
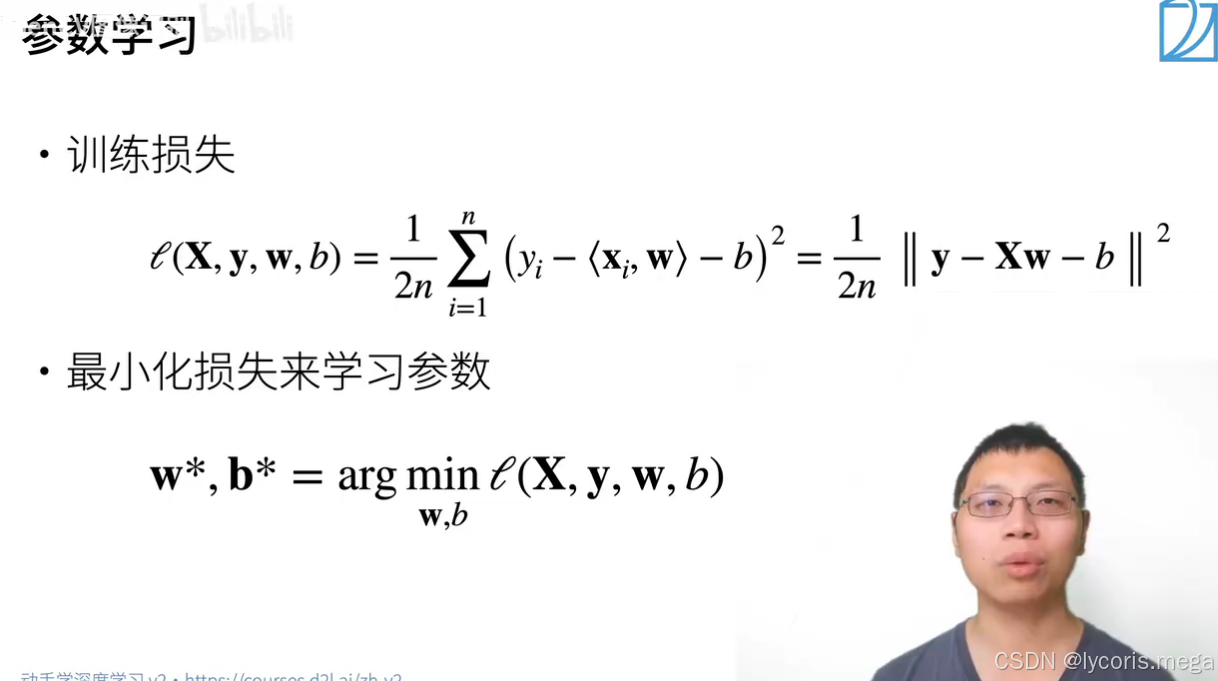
3. 优化:小批量随机梯度下降(SGD)
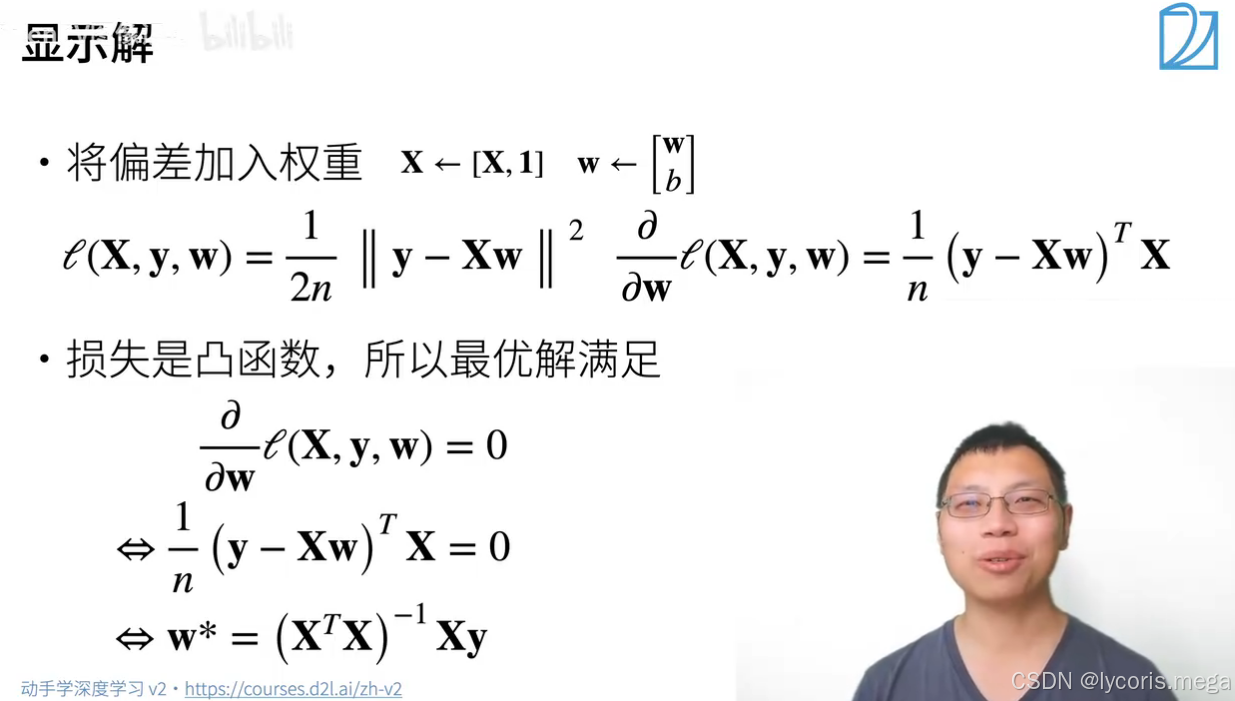
梯度下降更新公式:
[
w \leftarrow w - \eta \frac{\partial L}{\partial w}, \quad b \leftarrow b - \eta \frac{\partial L}{\partial b}
]
其中:
-
(\eta) 是学习率(
lr) -
梯度由
autograd自动给你算出来
4. 从零实现:造数据 → 初始化参数 → 训练循环(可跑通)
下面代码完整复现“李沐线性回归训练闭环”:
(造一个有噪声的线性数据集,训练把参数学回来)
import torch

# 1) 造数据:y = Xw + b + noise
torch.manual_seed(0)
n, d = 1000, 2
true_w = torch.tensor([[2.0], [-3.4]])
true_b = 4.2

X = torch.randn(n, d)
noise = torch.randn(n, 1) * 0.01
y = X @ true_w + true_b + noise

# 2) 初始化参数(要学的)
w = torch.randn(d, 1, requires_grad=True)
b = torch.zeros(1, requires_grad=True)

# 3) 超参数
lr = 0.03
batch_size = 32
num_epochs = 5

def data_iter(batch_size, X, y):
    idx = torch.randperm(X.shape[0])
    for i in range(0, X.shape[0], batch_size):
        j = idx[i:i+batch_size]
        yield X[j], y[j]

# 4) 训练
for epoch in range(num_epochs):
    for X_batch, y_batch in data_iter(batch_size, X, y):
        y_hat = X_batch @ w + b
        loss = ((y_hat - y_batch) ** 2).mean() / 2

        loss.backward()

        # 手写 SGD 更新(注意:更新参数时不建图)
        with torch.no_grad():
            w -= lr * w.grad
            b -= lr * b.grad
            w.grad.zero_()
            b.grad.zero_()

    # 每个 epoch 打印一下全量 loss
    with torch.no_grad():
        train_loss = (((X @ w + b) - y) ** 2).mean().item() / 2
    print(f"epoch {epoch+1}, loss {train_loss:.6f}")

print("learned w:", w.reshape(-1).tolist())
print("learned b:", b.item())
print("true w:", true_w.reshape(-1).tolist())
print("true b:", true_b)
你跑完会看到:
-
loss 快速下降
-
学到的
w, b非常接近true_w, true_b
5. 训练循环里最关键的 3 个细节(必考点)
5.1 loss.backward() 后梯度会累加 → 必须清零
w.grad.zero_()
b.grad.zero_()
5.2 参数更新要 no_grad(),否则会把更新步骤也记录进计算图
with torch.no_grad():
    w -= lr * w.grad
5.3 batch 的意义:更快、更稳、更泛化
-
全量梯度下降:每步算 n 个样本,慢
-
SGD:每步只看 1 个样本,噪声大
-
mini-batch:折中(最常用)
6. 线性回归为什么是“深度学习入门第一模型”?
因为它把所有训练本质都展示出来了:
-
前向:
y_hat = X @ w + b -
损失:
(y_hat - y)^2 -
反向:
loss.backward() -
更新:
w -= lr * grad
你学会这一套,后面 softmax、MLP、CNN 都只是把“模型结构”换掉。
更多推荐

 3
 0
- 0


 已为社区贡献101条内容

所有评论(0)