
动手学深度学习(李沐)笔记:线性回归从零开始实现(纯手写训练闭环)
·
线性回归是深度学习训练的最小闭环:
-
模型:
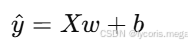
-
损失:平方损失(MSE)
-
求导:
autograd -
更新:手写 SGD
这篇目标很明确:不用任何高级封装,你要把“参数怎么动起来”彻底弄明白。
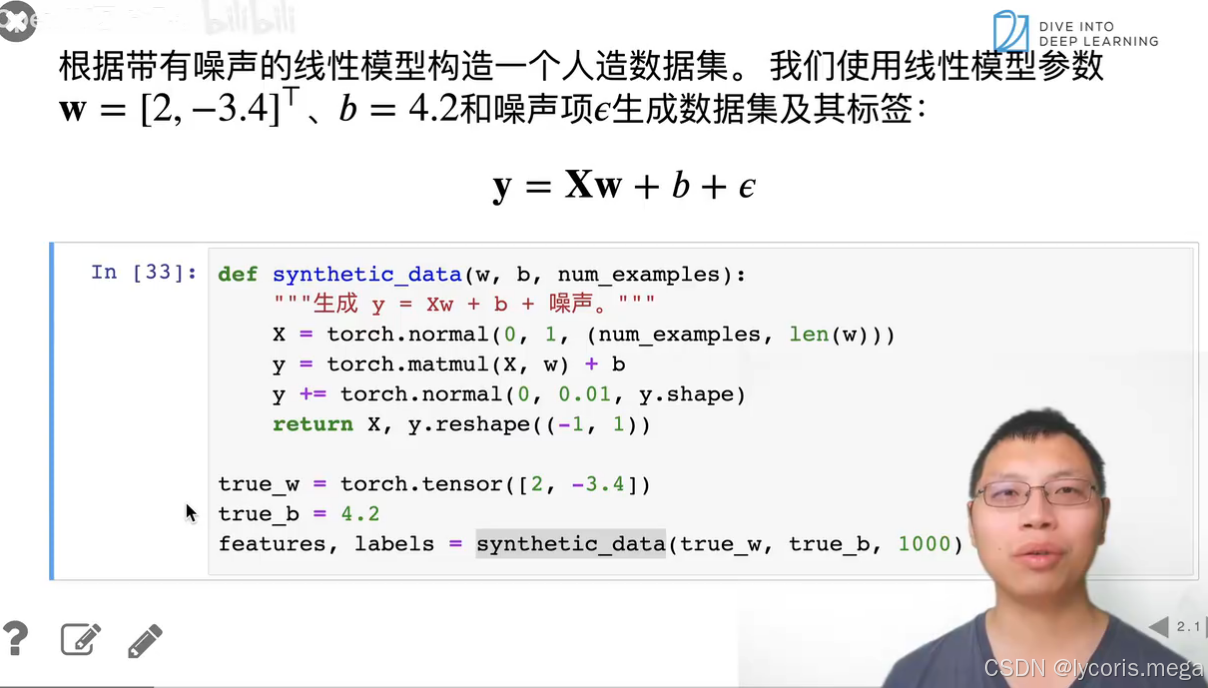
1. 先造一个可控的数据集
我们用已知的真实参数 ((w^*, b^*)) 生成数据,并加一点噪声:
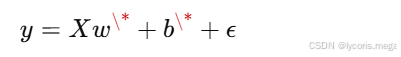
import torch
from torch.utils import data

torch.manual_seed(0)

def synthetic_data(w, b, num_examples):
    """生成 y = Xw + b + noise"""
    X = torch.randn(num_examples, len(w))
    y = X @ w + b
    y += torch.randn(num_examples, 1) * 0.01
    return X, y

true_w = torch.tensor([2.0, -3.4])
true_b = 4.2
features, labels = synthetic_data(true_w, true_b, 1000)

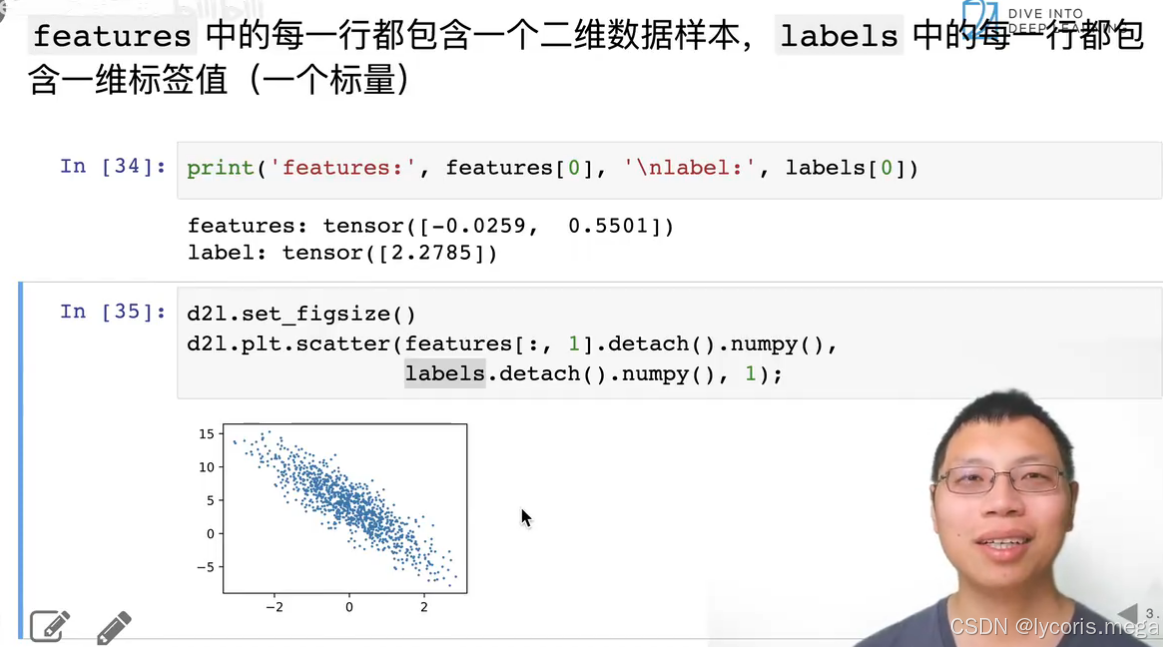
print(features.shape, labels.shape)  # (1000,2) (1000,1)
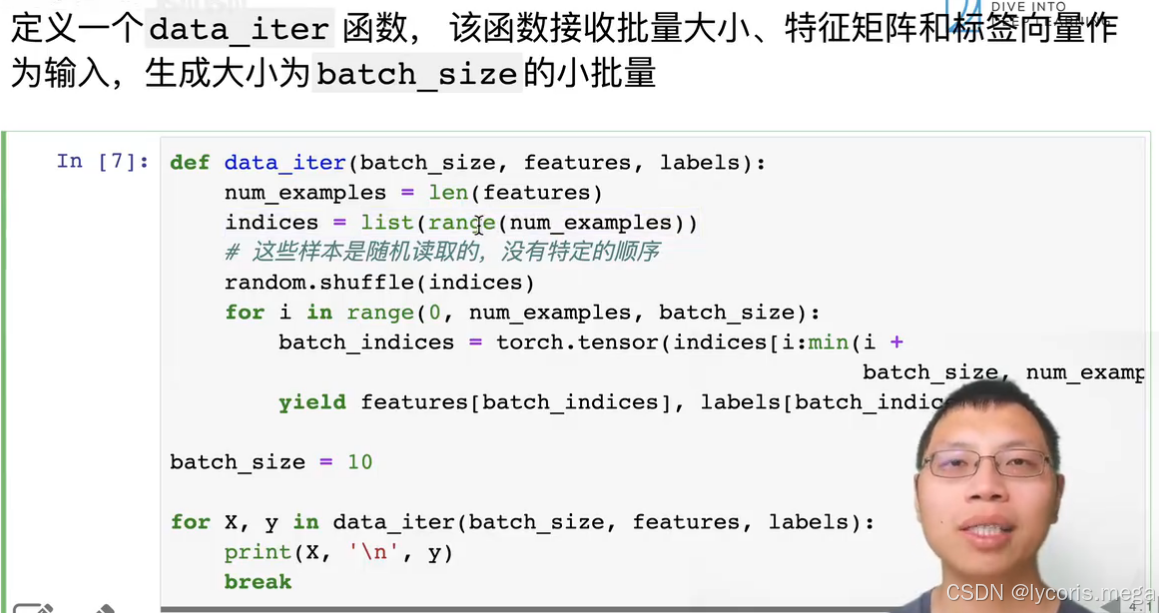
2. 读取小批量数据:DataLoader(但训练仍是手写)
def load_array(data_arrays, batch_size, is_train=True):
    dataset = data.TensorDataset(*data_arrays)
    return data.DataLoader(dataset, batch_size, shuffle=is_train)

batch_size = 32
data_iter = load_array((features, labels), batch_size)

# 看一眼 batch 的形状
X_batch, y_batch = next(iter(data_iter))
print(X_batch.shape, y_batch.shape)  # (32,2) (32,1)
注意:DataLoader 只是帮你分 batch,不算“高级模型封装”。
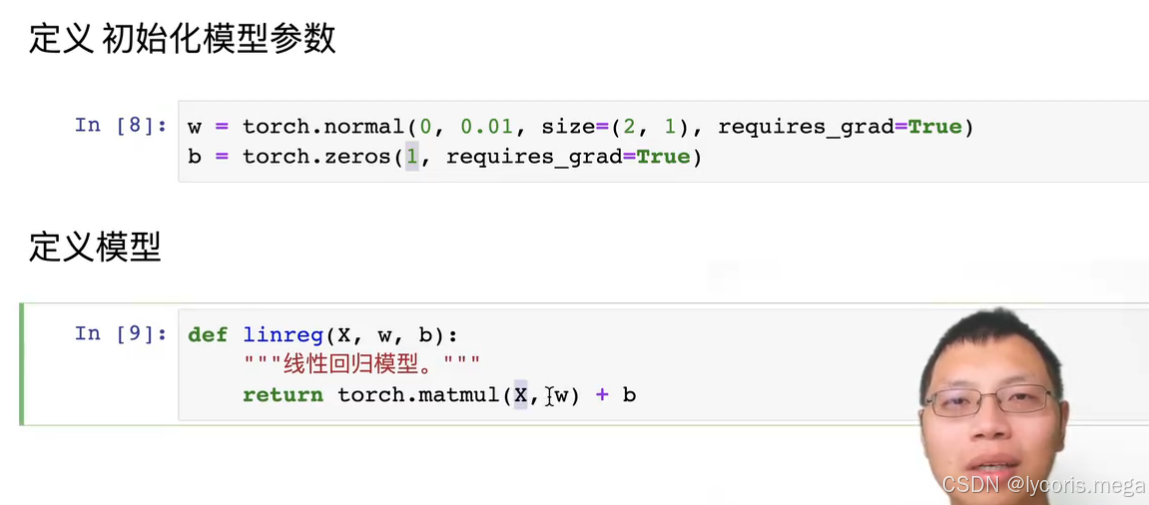
3. 初始化参数:w、b 都是要学的
w = torch.normal(0, 0.01, size=(2, 1), requires_grad=True)
b = torch.zeros(1, requires_grad=True)
-
w.shape=(d,1),方便写X @ w -
requires_grad=True才能自动求导
4. 定义模型、损失、优化器(手写)
4.1 线性回归模型
def linreg(X, w, b):
    return X @ w + b
4.2 平方损失
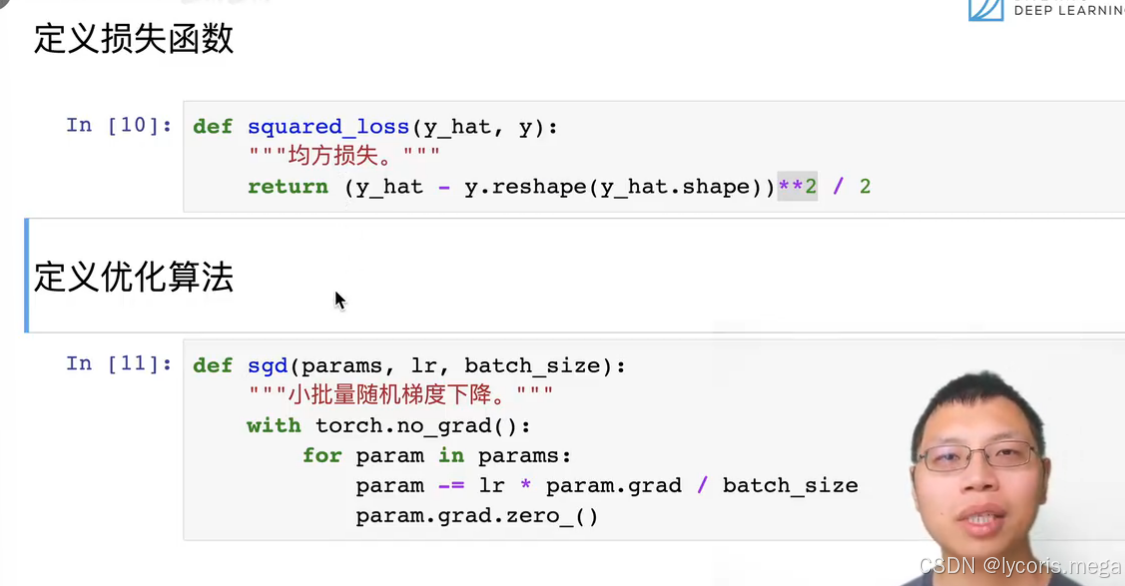
这里写成“每个样本的损失”,后面再 mean():
def squared_loss(y_hat, y):
    return (y_hat - y.reshape(y_hat.shape)) ** 2 / 2
4.3 手写 SGD
核心更新公式: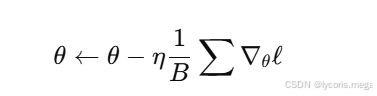
def sgd(params, lr, batch_size):
    with torch.no_grad():  # 更新时不建图
        for param in params:
            param -= lr * param.grad / batch_size
            param.grad.zero_()
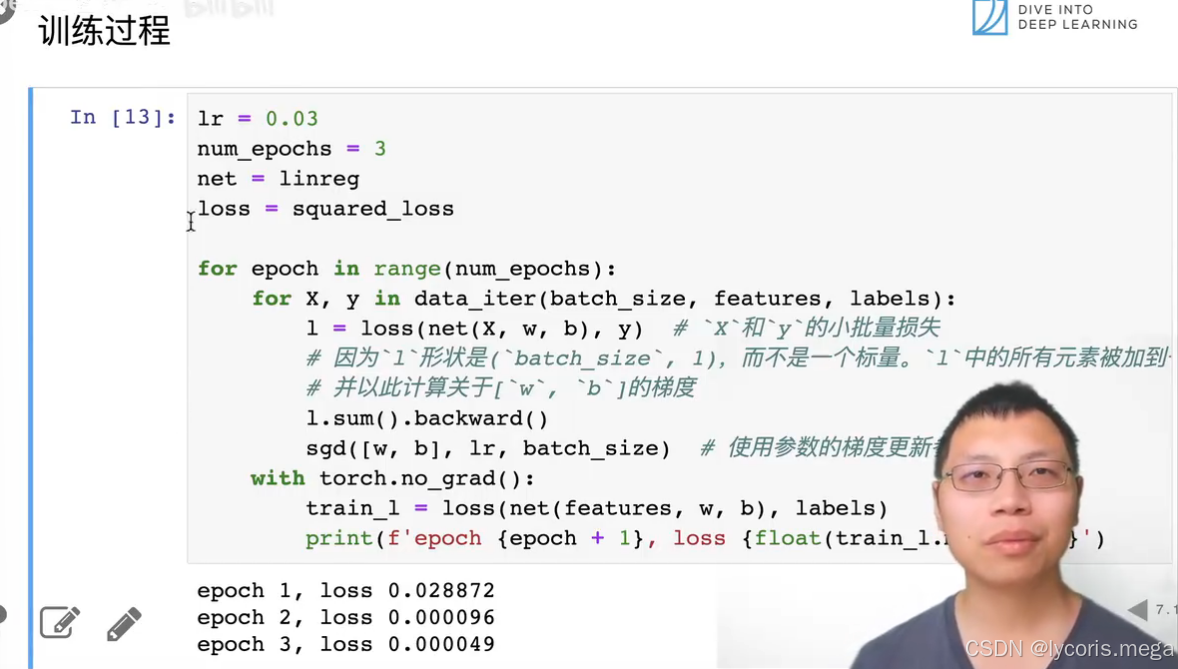
5. 训练:把闭环跑起来
lr = 0.03
num_epochs = 3
net = linreg
loss = squared_loss

for epoch in range(num_epochs):
    for X, y in data_iter:
        y_hat = net(X, w, b)
        l = loss(y_hat, y)        # (batch,1)
        l.sum().backward()        # 变标量再反传
        sgd([w, b], lr, batch_size)

    with torch.no_grad():
        train_l = loss(net(features, w, b), labels).mean()
    print(f"epoch {epoch+1}, loss {train_l.item():.6f}")

print("w error:", true_w - w.reshape(true_w.shape))
print("b error:", true_b - b)
print("learned w:", w.reshape(-1).tolist(), " learned b:", b.item())
你会看到:
-
loss 快速下降到很小
-
学到的
w, b非常接近true_w, true_b
6. 这一节最关键的“从零”细节(面试/作业常考)
6.1 为什么要 l.sum().backward()?
因为 l 是一个 batch 的向量损失,backward()更自然的是标量。
sum() 相当于对 batch 里的损失求和,再反向传播。
6.2 为什么更新要写 with torch.no_grad()?
否则“参数更新”也会被记录进计算图,图会越来越大,显存爆炸。
6.3 为什么梯度要 zero_()?
梯度默认累加,不清零会导致“越训越偏”。
7. 小结:你已经具备训练任何神经网络的最小能力
线性回归从零实现,看似简单,但它包含了深度学习训练的核心骨架:
-
前向(模型)
-
损失
-
反向(autograd)
-
参数更新(SGD)
后面 softmax、MLP、CNN 只是在“前向函数”更复杂而已。
更多推荐

 2
 0
- 0


 已为社区贡献101条内容

所有评论(0)