
动手学深度学习(李沐)笔记:基础优化方法(Optimization Basics)
训练神经网络,本质上是在做一件事:最小化损失函数
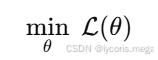
其中 (\theta) 是模型参数(权重、偏置等)。优化算法决定了你怎么更新参数:
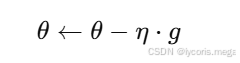
(\eta) 是学习率(learning rate),(g) 是梯度或其变体。
这篇把李沐常讲的“基础优化方法”按直觉 + 公式 + PyTorch 用法 + 常见坑梳理一遍。
1. 为什么需要“优化算法”?
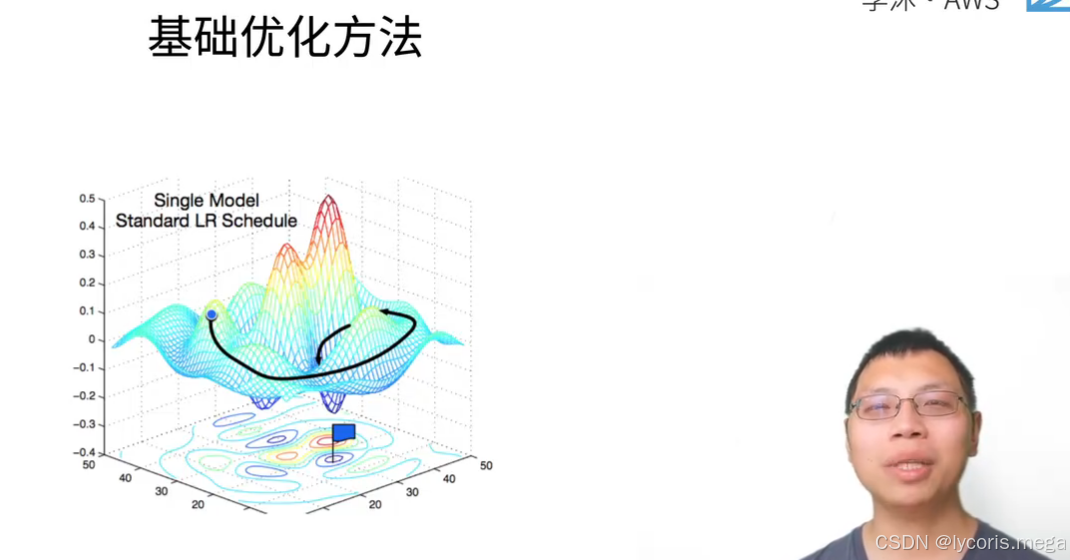
因为深度学习的损失函数通常:
-
维度极高(百万/十亿参数)
-
非凸(有山谷、鞍点、噪声)
-
数据量大(无法每一步用全量数据)
所以最常见策略是:小批量随机梯度下降(mini-batch SGD)。
2. 梯度下降家族:BGD / SGD / Mini-batch
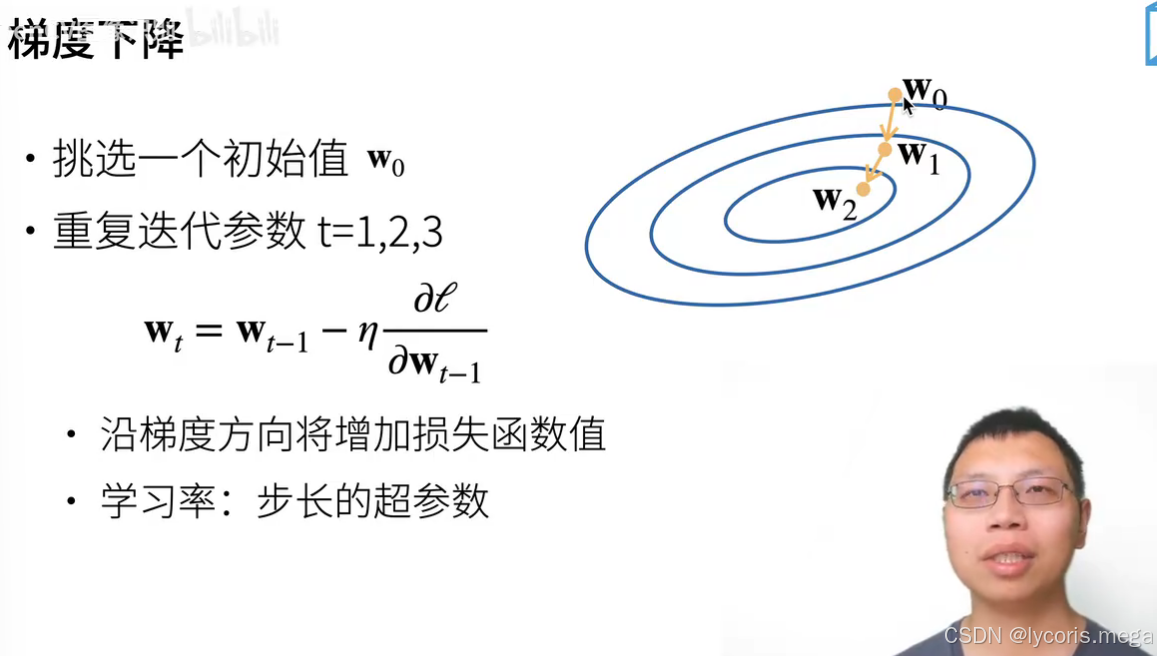
假设损失是样本损失的平均:
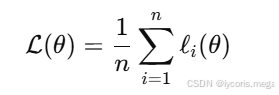
2.1 批量梯度下降(Batch GD)
每步用全部 n 个样本计算梯度:稳定但慢。
2.2 随机梯度下降(SGD)
每步只用 1 个样本:快但抖动大。
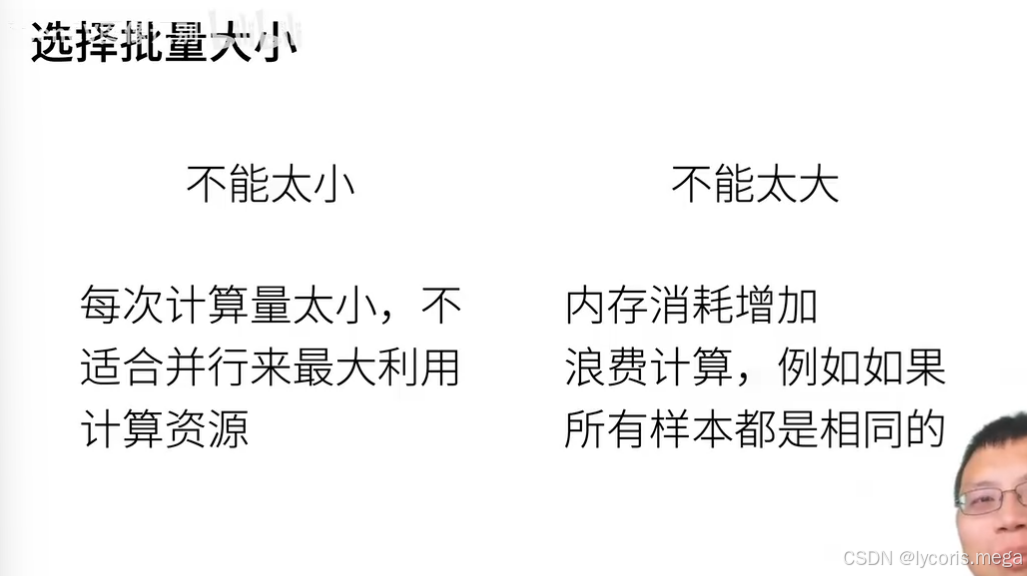
2.3 小批量 SGD(Mini-batch SGD)
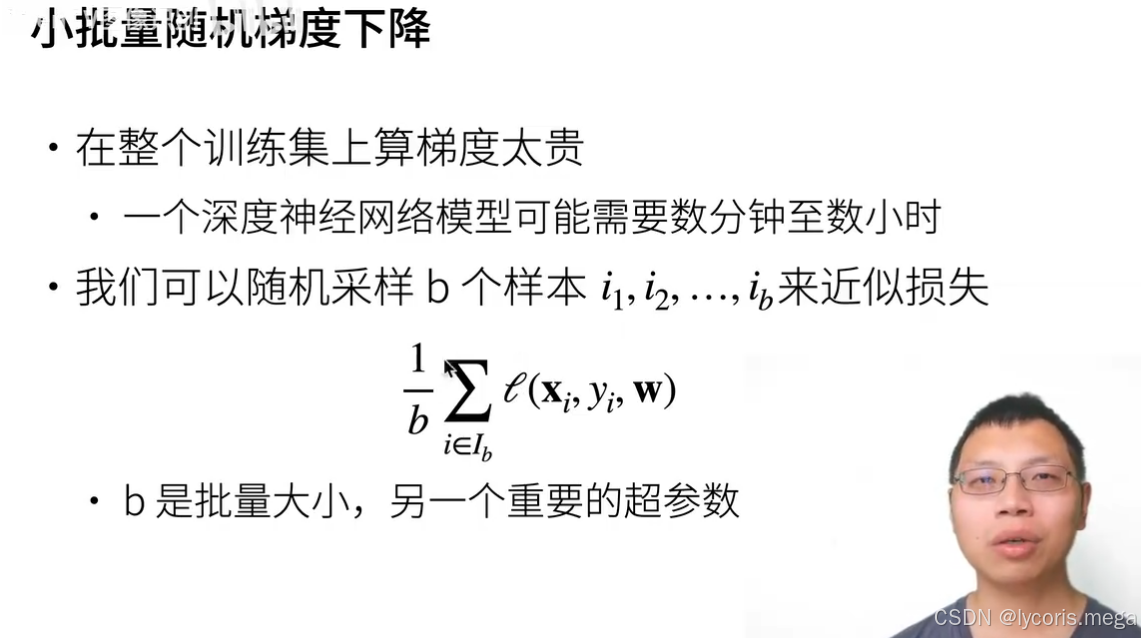
每步用一小批 B:深度学习默认选择(兼顾效率与稳定)。
更新式(最常见):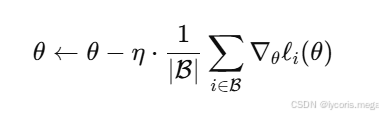
3. 学习率(lr):最重要的超参数,没有之一
-
lr 太大:loss 震荡、发散
-
lr 太小:收敛慢,像“挪着走”
-
常见技巧:学习率衰减(schedule),比如训练后期逐步变小
实战感受:你调参 80% 的时间都在调 lr。
4. 动量法(Momentum):让下降方向“更有惯性”
SGD 会在狭长山谷里左右抖动(某个方向梯度大来回震),动量可以抑制抖动,加速沿主方向前进。
典型形式: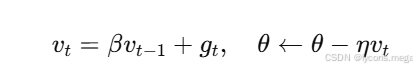
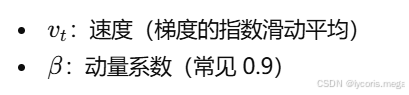
直觉:
-
方向一致的梯度会累积 → 加速
-
来回震荡的方向会互相抵消 → 稳定
PyTorch 用法:
torch.optim.SGD(params, lr=0.1, momentum=0.9)
5. 自适应学习率方法:AdaGrad / RMSProp / Adam
这些方法核心思想:不同参数用不同“有效学习率”。
5.1 AdaGrad:越学越“保守”
累积平方梯度:
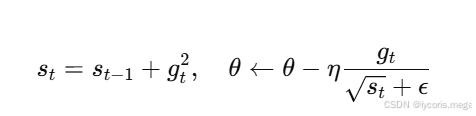
问题:(s_t) 一直增大 → 后期学习率趋近 0 → 可能“提前停滞”。
PyTorch:
torch.optim.Adagrad(params, lr=0.1)
5.2 RMSProp:解决 AdaGrad 过早衰减
把“累积”换成“滑动平均”:
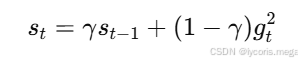
这样不会无限增大。
PyTorch:
torch.optim.RMSprop(params, lr=0.001, alpha=0.99)
5.3 Adam:动量 + RMSProp(最常用默认优化器)
Adam 同时维护:
-
一阶矩:梯度平均(动量)
-
二阶矩:平方梯度平均(自适应 lr)
PyTorch:
torch.optim.Adam(params, lr=0.001, betas=(0.9, 0.999))
经验结论(工程常识):
-
线性模型/凸问题:SGD(+momentum) 很强
-
深层网络:Adam 作为默认 baseline 很省心
-
最终追极致泛化:很多任务会 Adam 预热 → SGD 精调(看领域)
6. 小实验:同一线性回归任务,对比 SGD vs Momentum vs Adam
下面代码跑一个合成线性回归,记录每个 epoch 的 loss(你写博客可以直接贴输出截图)。
import torch

torch.manual_seed(0)

# 数据:y = Xw + b + noise
n, d = 2000, 2
true_w = torch.tensor([[2.0], [-3.4]])
true_b = 4.2
X = torch.randn(n, d)
y = X @ true_w + true_b + torch.randn(n, 1) * 0.01

def train(optim_name="sgd", lr=0.03, momentum=0.9, epochs=10, batch_size=64):
    w = torch.randn(d, 1, requires_grad=True)
    b = torch.zeros(1, requires_grad=True)
    params = [w, b]

    if optim_name == "sgd":
        opt = torch.optim.SGD(params, lr=lr)
    elif optim_name == "momentum":
        opt = torch.optim.SGD(params, lr=lr, momentum=momentum)
    elif optim_name == "adam":
        opt = torch.optim.Adam(params, lr=0.001)  # Adam 通常更小 lr
    else:
        raise ValueError("unknown optimizer")

    def data_iter():
        idx = torch.randperm(n)
        for i in range(0, n, batch_size):
            j = idx[i:i+batch_size]
            yield X[j], y[j]

    losses = []
    for epoch in range(epochs):
        for Xb, yb in data_iter():
            y_hat = Xb @ w + b
            loss = ((y_hat - yb) ** 2).mean() / 2

            opt.zero_grad()
            loss.backward()
            opt.step()

        with torch.no_grad():
            full_loss = (((X @ w + b) - y) ** 2).mean().item() / 2
        losses.append(full_loss)

    return losses

print("SGD:", train("sgd", lr=0.03, epochs=8))
print("Momentum:", train("momentum", lr=0.03, epochs=8))
print("Adam:", train("adam", epochs=8))
你通常会观察到:
-
Momentum 比纯 SGD 更稳、更快
-
Adam 很快把 loss 拉下去(对超参数更不敏感)
7. 常见坑:优化器用错导致“训练假努力”
-
忘了清梯度
-
手写更新:
w.grad.zero_() -
用优化器:
opt.zero_grad()
-
学习率不匹配
-
SGD 常用
1e-1 ~ 1e-2 ~ 1e-3(看任务) -
Adam 常从
1e-3起步更稳
-
batch_size 变了但 lr 不调整
-
batch 变大,梯度更稳定,lr 往往可以适当增大(不是绝对,但常见)
-
loss 降不下去就怪模型
-
先查:lr、数据标准化、梯度是否为 None、是否进入
no_grad了
结语:怎么选优化器(李沐风格的“够用策略”)
-
学习/作业/小项目:Adam(省心 baseline)
-
想要更稳的 SGD:SGD + momentum(经常更泛化)
-
lr 是第一优先级:调对 lr,比换优化器更有效
更多推荐

 5
 0
- 0


 已为社区贡献101条内容

所有评论(0)