
C++ STL 关联容器详解(二):map 的原理,接口与实战
一. 前言
在上一篇文章中,我们已经详细介绍了 STL 关联容器中的 set,并分析了它的核心特点
set 本质上可以理解为:
一个只存储 key 的有序集合
但在实际开发中,我们往往不仅需要存储一个值,还需要建立键值之间的映射关系
例如:
- 学生姓名 -> 分数
- 单词 -> 出现次数
- 用户ID -> 用户信息
这种 Key -> Value 的映射关系,正是 map 容器要解决的问题。在 STL 中,map 可以看作是:
key 有序 + key 不重复 + key-value 映射
其底层结构同样是红黑树,因此所有基本操作(插入、删除、查找)依然保持 O(log n)
本文将全面解析 map 的使用方法和设计理念,主要内容包括:map 的基本概念,常用接口操作,实际开发中的典型应用场景。阅读本文后,您将深入理解为什么 map 被誉为 STL 中最实用且功能强大的容器之一
二. map 的底层原理与逻辑结构
与 set 类似,std::map 也是 STL 中最重要的 关联式容器(Associative Container) 之一。
它用于维护 键值对(Key -> Value)的映射关系,并保证所有键按照一定规则自动排序
在理解 map 的使用之前,我们首先需要理解它的底层结构与逻辑模型
2.1 底层红黑树支撑
红黑树是一种自平衡二叉搜索树,其核心目标是:
保证树的高度始终维持在 O(log N) 级别
这意味着插入、删除和查找操作的时间复杂度均为 O(log N)。红黑树通过颜色规则和旋转操作来维持平衡状态。当插入或删除节点导致平衡被破坏时,它会通过旋转(Rotation)和变色(Recoloring)操作来恢复平衡(后续将详细介绍)
得益于这样的设计,map 在保持元素有序性的同时,还能提供高效的检索性能
2. 键值对语义
与 set 不同,map 并不是简单存储一个值,而是存储键值对(Key-Value Pair)
其内部存储类型为
std::pair<const Key, T>
其中 first 指向的就是 Key,而 second 则指向 Value
例如
std::pair<std::string, int> pair("apple", 10);
std::map<std::string, int> mymap;
mymap.insert(pair);
实际上存储的节点就是 ("apple", 10),这里需要特别注意的一点是 Key 是 const 类型,也就是说
it->first = "banana"; // 不允许修改 key
这是因为 Key 决定了红黑树的排序结构。如果允许修改 key,就可能破坏整棵树的有序性。因此 STL 在设计上直接将 key 设为 const,从语法层面避免这种问题
3. 严格弱序(Strict Weak Ordering)
严格弱序(Strict Weak Ordering) 是 C++ STL 算法和关联式容器(如 std::map, std::set)能够正常运行的底层数学契约
1. 严格弱序的四大准则
在 C++ 中,一个合格的比较谓词 f(a, b) 必须满足以下四个数学特性:
-
非自反性(Irreflexivity):f(a, a) 必须为假。即:一个元素不能比自己小
-
非对称性(Asymmetry):如果 f(a, b) 为真,那么 f(b, a) 必须为假。即:如果 a < b,那么 b < a 绝不能成立
-
传递性(Transitivity):如果 f(a, b) 为真且 f(b, c) 为真,那么 f(a, c) 必须为真。
即:a < b 且 b < c => a < c -
等价传递性(Transitivity of Equivalence):如果 a 与 b 等价,且 b 与 c 等价,那么 a 必须与 c 等价
注意:这里的等价定义为:!(a < b) && !(b < a)
2. 为什么它是 map 的核心设计
这是很多开发者容易忽略的一点:std::map 在判断两个键(Key)是否相等时,根本不使用 operator==
核心点一:等价(Equivalence) vs 相等(Equality)
在 std::map 里,判断一个键是否存在,使用的是等价逻辑:!(a < b) && !(b < a)
如果 a 不小于 b,且 b 也不小于 a,map 就认为它们是同一个键
设计意义:这极大地简化了对用户自定义类型的要求。你只需要重载一个 operator<,map 就能自动推导出大于、小于和等于三种关系。如果要求用户同时提供 operator< 和 operator== 且必须保持逻辑同步,出错的概率会大大增加
核心点二:红黑树的路径唯一性
std::map 的底层是红黑树。在插入节点时,算法需要根据比较结果决定向左走还是向右走
-
如果比较规则违反了严格弱序(例如你使用了 a <= b),那么在处理 a == b 的情况时,a <= b 和 b <= a 都会返回 true
-
如果 a < b 是 true 表示往左走。如果 b < a 是 true 表示往右走,此时,算法会发现往左走也行,往右走也行,红黑树的查找路径将变得不可预测
-
后果:你可能刚插入了一个键,但在查找它时,算法却在另一条路径上做无用功,导致逻辑上的数据丢失
核心点三:全序关系的性能优化
严格弱序保证了集合中的元素可以排成一条逻辑上的直线(全序关系)。这使得 std::map 能够通过 O(log N) 的时间复杂度快速定位元素,而不需要扫描整个容器。这种设计的精妙之处在于,它用最少的约束(只需一个小于号)实现了最高效的组织结构
总结
严格弱序是 std::map 能够维持唯一性和有序性的逻辑支柱。它通过一套简洁的数学定义,解决了在非线性结构中如何精准定位数据的问题
三. 构造方式与迭代器特性
在理解了 std::map 的底层结构之后,接下来我们来看它在实际开发中的基本使用方式
3.1 初始化方式
std::map 支持多种构造方式,能够适应不同的数据初始化场景
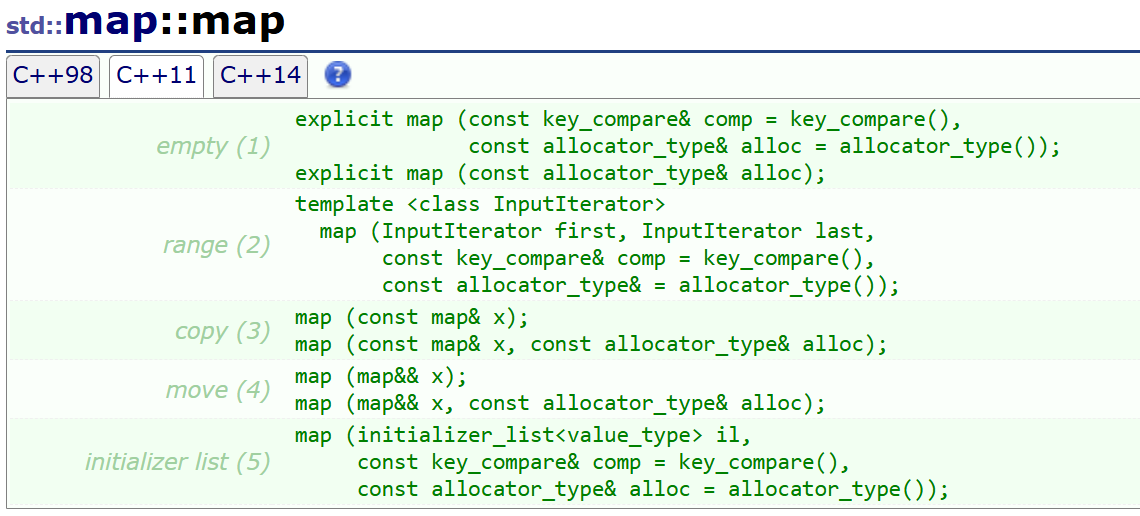
(1)默认构造
最常见的方式是直接创建一个空的 map。此时 map 内部会初始化一颗空的红黑树结构,等待后续插入元素
std::map<std::string, int> mymap;
(2)区间构造
map 支持通过迭代器区间构造容器,这种方式常用于从其他容器导入数据或是批量初始化 map
std::vector<std::pair<std::string,int>> vec = {
    {"apple",1},
    {"banana",2},
    {"orange",3}
};

std::map<std::string,int> mp(vec.begin(), vec.end());
(3)拷贝构造
一个 map 复制另一个 map 中的所有节点
std::map<int,int> mp1 = {
    {1,10},
    {2,20}
};

std::map<int,int> mp2(mp1);
(4)移动构造(C++11)
移动构造会转移内部红黑树结构,避免不必要的拷贝开销
std::map<int,int> mp2(std::move(mp1));
(5)初始化列表构造
C++11 之后可以使用初始化列表直接构造 map
std::map<std::string, int> mp = {
    {"apple", 3},
    {"banana", 5},
    {"orange", 2}
};
map 会自动按照 key 排序,即使初始化顺序不同,最终内部结构仍然按照 key 排列
3.2 map 的迭代器特性
map 的迭代器与 vector 等顺序容器不同,它只支持双向迭代器(Bidirectional Iterator),而不是随机访问迭代器。这意味着:
++it
--it
是允许的,但是
it + 1  // 不允许
it + 10 // 不允许
1. 为什么 map 不能随机访问
原因在于 map 的底层结构是红黑树,一种自平衡二叉树,而不是连续内存结构
例如 vector 的存储类似于
[ a ][ b ][ c ][ d ]
可以直接通过地址偏移量计算来访问元素,但 map 的结构更像是这样
        8
      /   \
     3     10
    / \      \
   1   6      14
节点分布在内存的不同位置,因此只能通过树结构遍历访问元素
2. 遍历与输出
map 的迭代器遍历顺序其实就是红黑树的中序遍历,而二叉搜索树的中序遍历是天然有序的
因此
for(auto &e : mp)
{
    std::cout << e.first << " " << e.second << std::endl;
}
输出结果一定是按照 key 升序的排列,这也是 map 具备自动排序能力的原因
而 map 也同样支持反向遍历
for(auto it = mp.rbegin(); it != mp.rend(); ++it)
{
    std::cout << it->first << std::endl;
}
输出结果为降序。反向迭代器本质上就是对普通迭代器的适配封装
小结
std::map 提供了灵活的构造方式,使其能够方便地从不同数据源初始化容器。同时,由于底层结构是红黑树,map 的迭代器具有以下特点
1.只支持双向遍历 2.遍历顺序等价于红黑树的中序遍历 3.输出结果天然按 key 有序
理解这一点,有助于我们更好地掌握 map 的遍历方式以及其排序特性
四. 元素插入机制的对比与选择
在 std::map 中,插入元素的方式主要有三种:
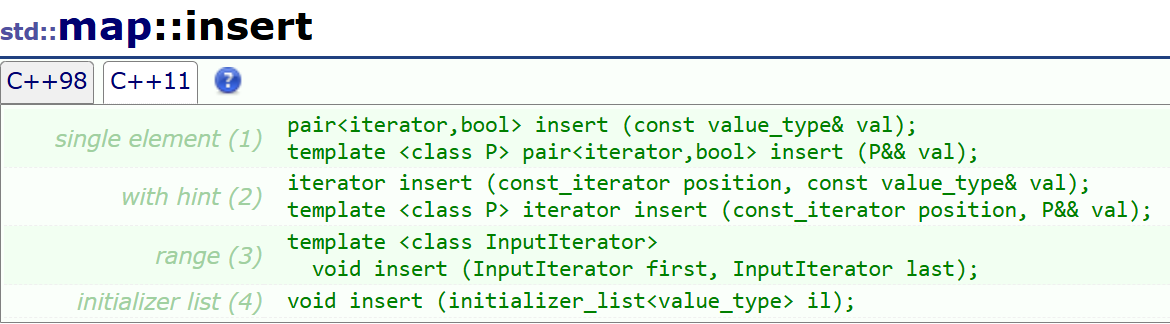
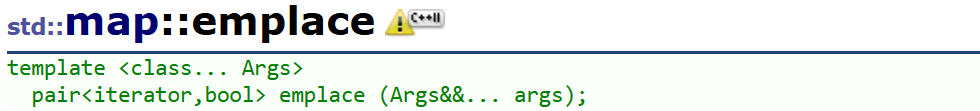
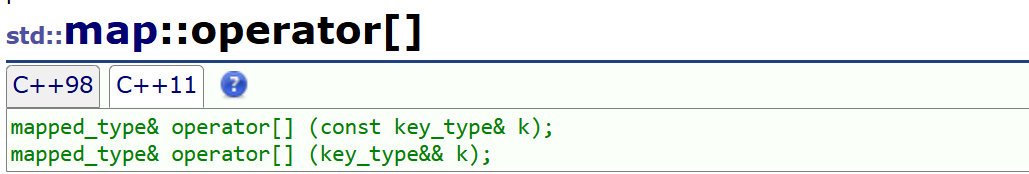
虽然它们都可以向 map 中添加元素,但三者在返回值、性能以及语义行为上存在明显区别。理解这些差异,有助于我们在不同场景中选择更合适的接口
4.1 insert 接口解析
最经典的插入方式是 insert
std::map<std::string,int> mp;
auto ret = mp.insert({"apple", 3});
而返回值类型为
std::pair<iterator,bool>
其中 first 代表指向元素位置的迭代器,second 代表是否插入成功。若 second 为 false 则表明插入失败,此时 first 并不为空,而是指向那个已经在集合中存在的旧元素
例如:
if(ret.second)
{
    std::cout << "插入成功" << std::endl;
}
else
{
    std::cout << "key 已经存在" << std::endl;
}
如果 key 已经存在,map 不会插入新节点而是返回已有元素的位置,因为 map 的 key 必须唯一
4.2 emplace 的性能优势
C++11 引入了 emplace,其核心思想是 原位构造(In-place Construction)
简单来说:insert 好比外部构造对象后移入容器,而 emplace 则是在容器内部原地构造对象
1. 核心差异
为了更好的直观理解,我们可以模拟一个简化的 map 节点插入过程
加入我们要向容器插入一个自定义类 Person
struct Person
{
    string name;
    int age;
    Person(string n, int a) : name(n), age(a) { cout << "构造对象\n"; }
    Person(const Person& p) : name(p.name), age(p.age) { cout << "拷贝对象\n"; }
};
使用 insert 的路径:
-
产生临时对象:mymap.insert(Person("Ace", 18))。编译器先调用构造函数创建一个临时对象
-
分配节点内存:map 在红黑树中申请一个新节点的空间
-
拷贝:将临时对象拷贝到新节点的内存中
-
销毁临时对象:语句结束,临时对象析构
代价:1次构造 + 1次拷贝(或移动) + 1次析构
使用 emplace 的路径:
-
传递参数:mymap.emplace("Ace", 18)。注意,这里传的是参数而不是对象
-
分配节点内存:map 申请空间
-
原位构造:在刚才申请好的内存空间上,直接调用 Person 的构造函数,把参数填进去
代价:仅 1 次构造
2. 模拟实现
我们可以通过以下这段伪代码来理解两者的差异
template <typename T>
class MyMap
{
public:
    // 模拟 insert: 接收已经构造好的对象
    void insert(const T& val)
    {
        // 1. 分配原始内存 (未构造)
        void* ptr = allocate_node_memory();

        // 2. 调用拷贝构造函数,在申请的空间上创建副本
        new (ptr) T(val);

        cout << "--- insert 结束 ---\n";
    }

    // 模拟 emplace: 接收构造参数 (可变参数模板 + 万能引用)
    template <typename... Args>
    void emplace(Args&&... args)
    {
        // 1. 分配原始内存 (未构造)
        void* ptr = allocate_node_memory();

        // 2. 原位构造:直接在目标内存调用构造函数,转发参数
        // 这里的 std::forward 保证了参数的完美转发
        new (ptr) T(std::forward<Args>(args)...);

        cout << "--- emplace 结束 ---\n";
    }

private:
    void* allocate_node_memory() { return malloc(sizeof(T)); }
};
4.3 operator[] 与 insert
operator[] 是 map 中另一个非常常见的接口
mymap["apple"] = 5;
这段代码的语义其实是
如果 key 不存在则插入,如果已存在则修改 value 的值
等价逻辑可以理解为
if(key 不存在)
{
    插入 pair(key, T())
}

返回 value 的引用
因此 operaor[] 常被用于统计类问题,例如:
std::map<std::string,int> count;

for(auto &word : words)
{
    count[word]++;
}
这里的逻辑为
如果不存在则默认构造 int = 0,存在则++
三种插入方式对比
| 接口 | 是否允许覆盖 | 是否可能创建默认值 | 是否返回插入结果 |
|---|---|---|---|
| insert | 不覆盖 | 否 | 是 |
| emplace | 不覆盖 | 否 | 是 |
| operator[] | 可以覆盖 | 会 | 否 |
一句话概括
insert / emplace -> 严格插入 operator[] -> 查找 + 修改
五. operator[] 的实现机制
5.1 operator[] 的核心逻辑
在 STL 的实现中,operator[] 的核心逻辑大致如下:
mapped_type& operator[](const key_type& key)
{
    auto ret = insert(std::make_pair(key, mapped_type()));
    return ret.first->second;
}
可以看到,它内部其实复用了 insert 接口。具体执行流程为
尝试插入 (key, value)
↓
如果 key 已存在 → 返回已有节点
↓
如果 key 不存在 → 插入默认值节点
↓
返回 value 的引用
其中 mapped_type() 表示 value 的默认构造函数
例如:
map<string, int> mp;
mp["apple"];
即使没有赋值,这行代码仍然会插入 ("apple", 0),因为 int 的默认值是 0
5.2 注意点
虽然 operator[] 很方便,但在某些情况下可能带来隐藏副作用
例如:
map<string,int> mp;

if(mp["apple"] == 0)
{
    cout << "不存在" << endl;
}
很多人会误以为只是做了一次查询,但实际上 map 中已经插入了("apple", 0),这就有可能会导致容器意外增长,在大型系统中,这种行为甚至可能造成逻辑错误或性能问题
因此在只想查询是否存在时,更推荐使用
mp.find(key)
而如果希望之访问已存在的 key,那么可以使用 at() 函数
map<string,int> mp;
mp.at("apple");
如果 key 不存在则抛出异常:std::out_of_range,这使得 at() 成为一种更安全的访问方式
| 接口 | key 不存在 |
|---|---|
| operator[] | 插入默认节点 |
| find | 返回 end() |
| at | 抛出异常 |
六. 检索与删除操作
STL 为 map 提供了多种不同的接口,每个接口适用于不同的场景
6.1 多维度检索接口
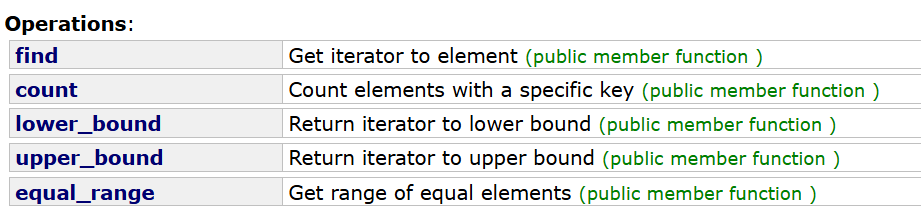
(1)find
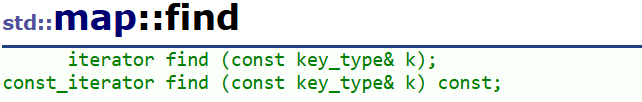
find 是最常用的查找接口,返回值为 iterator,如果找到返回该元素位置迭代器,如果没找到则返回 mymap.end()
auto it = mp.find("apple");
if(it != mp.end())
{
    cout << it->second << endl;
}
时间复杂度:O(log N)
(2)count
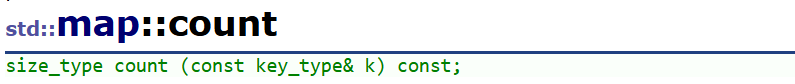
count 用于统计 key 出现的次数,返回值为 0 或 1,因为 map 里 key 是唯一的
if(mp.count("apple"))
{
    cout << "存在" << endl;
}
不过在 map 中,count 的使用场景其实并不多,因为 find 更灵活
(3)lower_bound / upper_bound
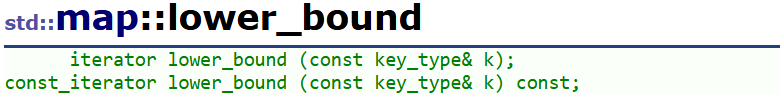
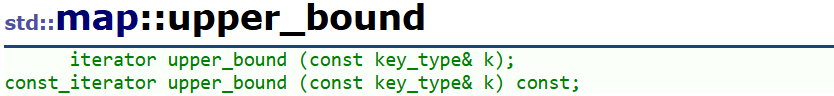
分别用于查找第一个 >= key 的元素或第一个 > key 的元素
auto it1 = mp.lower_bound(30);
auto it2 = mp.upper_bound(30);
如果 map 为 10 20 30 40 50,结果 it1 指向 30,it2 指向 40
(4)equal_range
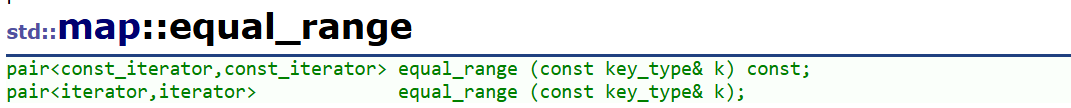
equal_range 可以同时获得 lower_bound,upper_bound
auto ret = mp.equal_range(key);

ret.first   // lower_bound
ret.second  // upper_bound
6.2 删除操作
map 提供了三种删除方式
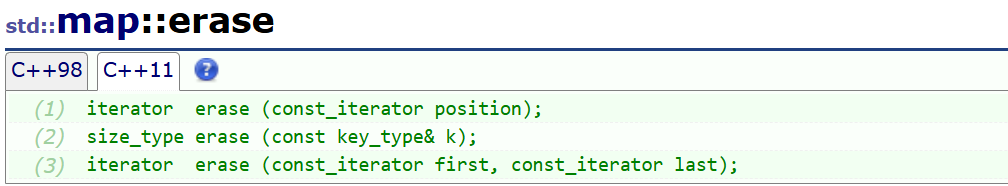
(1)按迭代器删除
删除迭代器指向的元素,返回指向下一个位置的迭代器,删除失败则返回 end()
示例:
auto it = mp.find("apple");

if(it != mp.end())
{
    mp.erase(it);
}
复杂度:O(log N)
(2)按 key 删除
返回值为删除的元素数量,而在 map 中只有 0 或 1
示例:
mp.erase("apple");
复杂度:O(log N)
(3)按区间删除
删除一段区间的所有元素(左闭右开)
示例:删除 begin 到 50 之前的所有元素
mp.erase(mp.begin(), mp.find(50));
复杂度:O(k log N),其中 k 为删除元素数量
6.3 循环删除时的迭代器安全问题
在遍历 map 时删除元素,需要特别注意迭代器失效问题
错误示例:
for(auto it = mp.begin(); it != mp.end(); ++it)
{
    if(it->second == 0)
    {
        mp.erase(it);   // it 已失效
    }
}
正确示例:
for(auto it = mp.begin(); it != mp.end();)
{
    if(it->second == 0)
    {
        it = mp.erase(it);
    }
    else
    {
        ++it;
    }
}
原因是 erase(iterator) 会返回下一个有效迭代器,利用这一点可以安全的继续遍历
小结
std::map 提供了一套丰富的查找与删除接口,使其能够灵活应对不同的数据访问需求
| 操作 | 接口 | 复杂度 |
|---|---|---|
| 查找 | find | O(log N) |
| 查找 | count | O(log N) |
| 区间查找 | lower_bound / upper_bound | O(log N) |
| 删除 | erase(key) | O(log N) |
| 删除 | erase(iterator) | O(log N) |
配合红黑树的平衡特性,map 能够在保证有序性的同时提供稳定的检索效率
七. 关联式容器变体:multimap
在前面的内容中我们介绍了 std::map 的基本特性:key 有序且唯一,key -> value 映射等,但在某些实际场景中,一个 key 可能对应多个 value
例如一个学生可能对应多门课程,一个单词对应多个出现位置等,如果使用 map,由于 key 必须唯一,后续插入就会失败。而为了解决这个问题,STL 提供了 std::multimap,它允许多个相同 key 的节点同时存在
7.1 基本结构
multimap 的模板定义与 map 十分相似:
template<
    class Key,
    class T,
    class Compare = less<Key>,
    class Alloc = allocator<pair<const Key, T>>
> class multimap;
其底层结构依然是红黑树,唯一的区别是该红黑树允许插入重复 key 的节点
例如:
std::multimap<string,int> mm;

mm.insert({"apple",1});
mm.insert({"apple",2});
mm.insert({"apple",3});
此时容器中会存在三个 key 为 apple 的节点
7.2 为什么 multimap 不提供 operator[]
multimap 没有提供 operator[] 接口的原因其实很简单:operator[] 默认 key 唯一
以 map 为例:mymap["apple"] = 5 会查找 key 并返回唯一的 value。但 multimap 允许一个 key 对应多个 value,如果使用 mymultimap["apple"] 就会出现问题——无法确定应该返回哪个 value。因此 STL 在设计时直接移除了这个接口
7.3 查找方式
由于 key 可以重复,因此查找方式与 map 有一点区别
例如
auto it = mm.find("apple");
此时返回的是第一个匹配的节点,如果需要获得所有相同 key 的元素,可以使用 equal_range
equal_range 会返回一个区间范围
auto range = mm.equal_range("apple");
返回值类型为 pair<iterator, iterator>,其中 range.first -> 第一个 apple,range.second -> 最后一个 apple 的下一个位置
我们可以这样遍历
for(auto it = range.first; it != range.second; ++it)
{
    cout << it->first << " " << it->second << endl;
}
这样就可以获取所有相同 key 的节点
小结
std::multimap 可以看作是允许重复 key 的 map
其核心特点包括:
底层仍然是红黑树,允许多个相同 key,不提供 operator[],支持 equal_range 范围查询
在需要处理 一对多关系的数据结构 时,multimap 会比 map 更加合适
经典实战:LeetCode 138. 随即链表的深拷贝
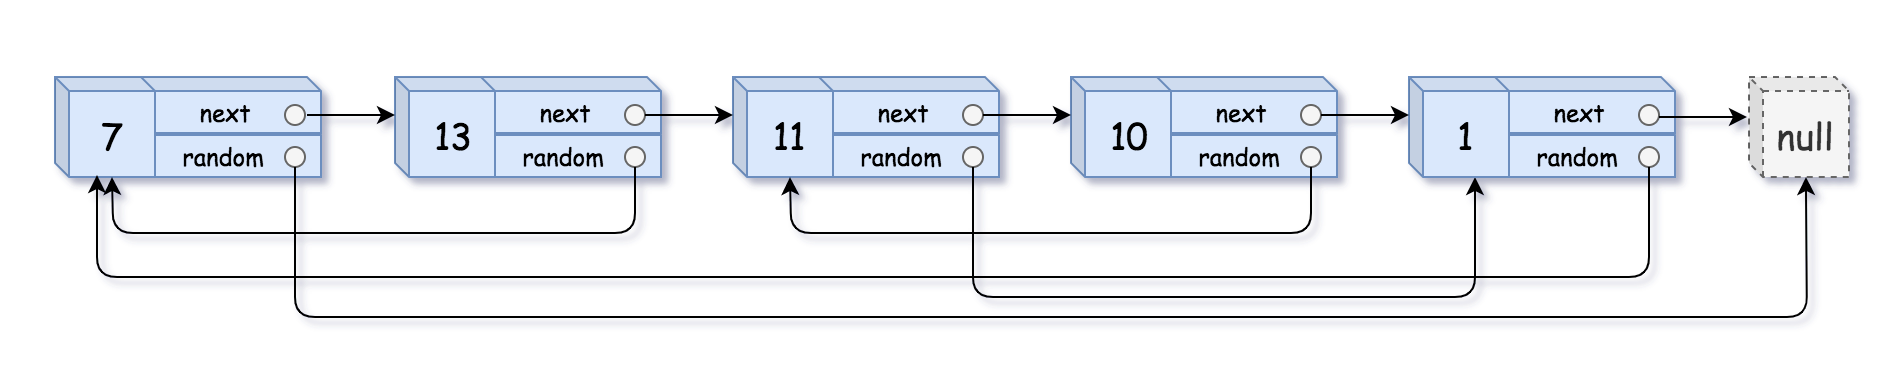
给你一个长度为 n 的链表,每个节点包含一个额外增加的随机指针 random ,该指针可以指向链表中的任何节点或空节点
构造这个链表的 深拷贝。 深拷贝应该正好由 n 个 全新 节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的 next 指针和 random 指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点
1. 核心问题
随机链表深拷贝的难点在于:如何确保原链表中的每一个物理节点,在目标链表中都有且仅有一个对应的副本?
如果我们直接进行递归或迭代创建,极易陷入无限循环或创建重复的冗余节点。因此,我们需要建立一种从原节点地址到新节点地址的映射关系,这正是 std::map<Node*, Node*> 的核心应用场景
2. 解题思路
算法的实现通常分为两个阶段:
-
阶段一(构建映射):遍历原链表,为每个节点创建一个副本,并将 (原节点地址, 新节点地址) 存入 map。此时仅完成节点的物理创建,暂不处理指针指向
-
阶段二(关系链接):再次遍历原链表, (原节点地址, 新节点地址) 存入 map。此时仅完成节点的物理创建,暂不处理指针指向
3. 代码实现
/*
// Definition for a Node.
class Node {
public:
    int val;
    Node* next;
    Node* random;

    Node(int _val) : val(_val), next(NULL), random(NULL) {}
};
*/

class Solution {
public:
    Node* copyRandomList(Node* head) {
        if(head == nullptr) return nullptr;

        // 核心数据结构,建立 原节点指针 -> 新节点指针 的映射
        std::map<Node*, Node*> nodeMap;

        // 1. 第一次遍历,完成新节点的创建
        Node* cur = head;
        while(cur)
        {
            nodeMap[cur] = new Node(cur->val);
            cur = cur->next;
        }

        // 2. 第二次遍历,完成新链表的指针链接
        cur = head;
        while(cur)
        {
            // nodeMap[cur] 对应新链表节点
            // nodeMap[cur->next] 对应原 next 节点在 map 中对应的副本
            nodeMap[cur]->next = nodeMap[cur->next];
            nodeMap[cur]->random = nodeMap[cur->random];
            cur = cur->next;
        }
        return nodeMap[head];
    }
};
4. 复杂度分析
由于 std::map 的底层为红黑树,每次 operator[] 操作的开销为 O(log n)。若链表长度为 n,则总时间复杂度为 O(nlog n);空间复杂度为 O(n),用于存储映射关系
经典实战:LeetCode 692. 前 K 个高频单词
给定一个单词列表 words 和一个整数 k ,返回前 k 个出现次数最多的单词
返回的答案应该按单词出现频率由高到低排序。如果不同的单词有相同出现频率,按字典顺序排序
示例 :
输入: words = ["i", "love", "leetcode", "i", "love", "coding"], k = 2
输出: ["i", "love"]
解析: "i" 和 "love" 为出现次数最多的两个单词,均为2次。注意,按字母顺序 "i" 在 "love" 之前。
1. 解题思路
-
阶段一:统计映射
利用 std::map<std::string, int> 统计词频。此时,map 利用红黑树特性,已隐式完成了单词的去重及字典序排列 -
阶段二:多准则排序
由于 std::map 仅支持按 Key(单词)排序,无法直接按 Value(频率)排序,我们需要将数据转移至 std::vector 中,并利用 std::sort 进行重构
2. 代码实现
class Solution {
public:
    struct Compare{
        bool operator()(pair<string, int> x, pair<string, int> y){
            // 准则 A:频率不同时,按频率降序排列
            if (x.second != y.second) {
                return x.second > y.second;
            }

            // 准则 B:频率相同时,按字典序升序排列
            return x.first < y.first;
        }
    }

    vector<string> topKFrequent(vector<string>& words, int k) {
        // 1. 利用 map 进行词频统计
        map<string, int> countMap;
        for(auto& word : words) { countMap[word]++; }

        // 2. 将映射关系存到 vector,来进行自定义排序
        vector<pair<string, int>> v(countMap.begin(), countMap.end());

        // 3. 进行排序,注意这里要传仿函数来自定义比较逻辑
        sort(v.begin(), v.end(), Compare());

        // 4. 从排好序的 vector 中提取前 k 个词汇
        vector<string> ret;
        for(int i = 0; i < k; i++){
            ret.bush_back(v[i].first);
        }
        return ret;
    }
};
4. 复杂度分析
-
时间复杂度:O(N log M + M log M)
N 为总单词数,M 为去重后的单词数。统计过程耗时 O(N log M),排序过程耗时 O(M log M)
-
空间复杂度:O(M)
需额外空间存储统计映射及排序辅助容器
在本解法中,我们使用了 std::sort 并显式定义了频率相同时的字典序逻辑。实际上,由于第一步使用的 std::map 本身就是有序的,如果后续使用 std::stable_sort(稳定排序)并仅指定频率降序准则,同样可以达成目标。这种对容器原生有序性的二次利用,体现了对 STL 体系结构的深度洞察
八. 总结
纵观全篇,从 std::set 的红黑树机理到 std::map 在复杂算法中的多维应用,我们可以清晰地看到:关联式容器的精髓绝非仅仅停留在对 API 的机械调用,而在于对其设计哲学的深度理解
当我们开始审视 set 迭代器的常量约束,或是剖析在元素移动时导致的迭代器失效,乃至在随机链表复制等场景中巧妙建立映射时,我们便完成了从接口使用者向高效开发者的身份转变
关联式容器的世界博大精深,set 与 map 仅仅是窥见其逻辑美感的一个切口。在接下来的专题中,我们将目光转向哈希容器,继续探索 unordered_series 在极致性能追求下的另一面
更多推荐


 8
 0
- 0


 已为社区贡献9条内容

所有评论(0)