
Docker——namespace
Docker利用Linux内核的Namespace(命名空间)技术来实现容器的隔离。可以把它理解为为每个容器打造了一个“幻觉”,让容器内的进程误以为自己独占了整个操作系统。它通过封装和抽象内核的全局资源,使得不同容器内的进程只能看到和自己相关的资源,从而实现彼此之间的隔离。Docker容器本质上是宿主机上的进程。docker通过namespace实现了资源隔离,通过cgroups实现了资源限制,通过写时拷⻉机制(copyon-write)实现了⾼效的⽂件操作。
Linux内核提供了多种Namespace,而Docker主要使用了以下6种来实现容器的核心隔离功能
docker中的六种namespace:
| Namespace类型 | 隔离的资源 | 核心作用 | 在容器中的体现 |
|---|---|---|---|
| PID Namespace | 进程ID | 隔离进程ID号,使得不同Namespace中的进程可以有相同的PID。 | 容器内的第一个进程会看到自己的PID为"1",但在宿主机上,它可能是一个普通的进程ID,如"1234"。 |
| NET Namespace | 网络资源 | 隔离网络设备、IP地址、端口、路由表、防火墙规则等网络栈。 | 每个容器都拥有自己独立的网络栈,包括虚拟网卡、IP地址和端口。例如,多个容器可以在各自内部监听80端口而不会冲突。 |
| IPC Namespace | 进程间通信 | 隔离System V IPC和POSIX消息队列等进程间通信资源。 | 确保不同容器内的进程无法通过共享内存、消息队列等方式直接通信。 |
| MNT Namespace | 文件系统挂载点 | 隔离文件系统的挂载点,使得每个容器看到不同的文件系统层次结构。 | 容器内的进程看到的根目录、/etc、/var等文件,都是容器镜像提供的,与宿主机和其他容器的文件系统隔离。在MNT Namespace中的挂载操作也不会影响宿主机。 |
| UTS Namespace | 主机名和域名 | 隔离主机名(hostname)和域名(domain name)。 | 每个容器都可以拥有自己独立的主机名,在网络上被视为一个独立的节点。 |
| User Namespace | 用户和用户组ID | 隔离用户和用户组ID。允许一个进程在容器内拥有root权限,但在宿主机上只是一个普通用户。 | 这大大提高了安全性。即使容器被攻破,攻击者获得的"root"权限在宿主机上也是受限的 |
Namespace是如何被创建和管理的?
Linux内核提供了一套完整的API来操作Namespace,Docker正是通过它们来构建容器的:
-
clone():这是Docker创建容器时最常用的方法。在创建新进程的同时,通过指定标志位(如CLONE_NEWNS,CLONE_NEWPID)来为新进程创建新的Namespace。 -
setns():允许一个进程加入到已有的Namespace中。这在docker exec命令中很关键,它让exec进程能够加入到目标容器的各种Namespace中,从而在容器内部执行命令。 -
unshare():使一个进程脱离当前的Namespace,并加入到新的Namespace。它可以在不创建新进程的情况下,将当前进程隔离到新的Namespace中。 -
/proc/[pid]/ns/文件:每个进程的Namespace信息都可以通过这个目录下的文件查看。如果两个进程指向的Namespace ID相同,就说明它们在同一个Namespace下。
你可以通过 ls -l /proc/self/ns/ 命令,来查看当前进程所属的各种Namespace的ID。你会发现,即使是在宿主机上运行的不同进程,它们的某些Namespace ID也可能是相同的,这表示它们共享了某些资源。
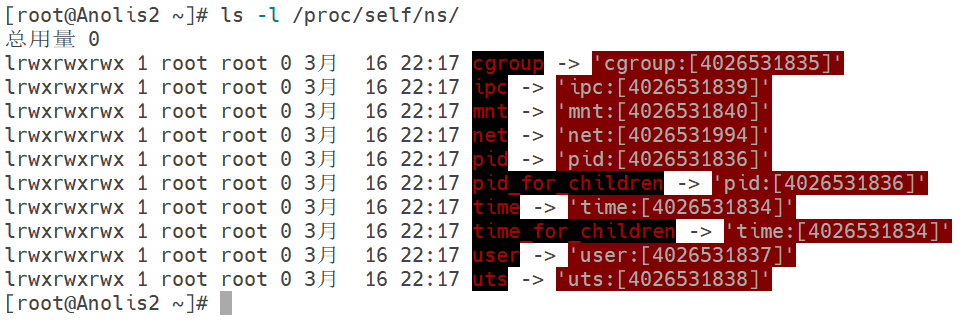
如果两个进程指向的namespace编号相同,就说明它们在同⼀个namespace下,否则便在不同namespace⾥⾯。/proc/[pid]/ns⾥设置这些link的另外⼀个作⽤是,⼀旦上述linux⽂件被打开,只要打开的⽂件描述符(fd)存在,那么就算该namespace下的所有进程都已经结束,这个namespace也会⼀直存在,后续进程也可以再加⼊进来。在Docker中,通过⽂件描述符定位和加⼊⼀个存在的namespace是最基本的⽅式。
namespace的API包括clone()、setns()以及unshare(),还有/proc下的部分⽂件。为了确定隔离的到底是哪6项namespace,在使⽤这些API时,通常需要指定以下6个参数⼀个或多个,通过 | (位或)操作来实现。这6个参数分别是CLONE_NEWUTS、CLONE_NEWIPC、CLONE_NEWPID、CLONE_NEWNET、CLONE_NEWNS、CLONE_NEWUSER
⊙ 通过clone()在创建新进程的同时创建namespace
使⽤clone()来创建⼀个独⽴namespace的进程,是最常⻅的做法,也是docker使⽤namespace最基本的⽅法,它的调⽤⽅式如下:
int clone(int (*child_func)(void *), void *child_stack, int flags, void*arg);
⊙ 通过setns()加⼊⼀个已经存在的namespace
上⾯提到,在进程都结束的情况下,也可以通过挂载的形式把namespace保留下来,,保留namespace的⽬的是为以后有进程加⼊做准备。在docker中,使⽤docker exec 命令在已经运⾏着的容器中执⾏⼀个新的命令,就需要⽤到该⽅法。通过setns()系统调⽤,进程从原先的namespace加⼊某个已经存在的namespace。通常为了不影响进程的调⽤者,也为了使新加⼊的pid namespace⽣效,会在setns()函数执⾏后使⽤clone()创建⼦进程继续执⾏命令,让原先的进程结束运⾏。
⊙ 通过unshare()在原先进程上进⾏namespace隔离
最后要说明的系统调⽤是unshare(),它与clone()很像,不同的是,unshare()运⾏在原先的进程上,不需要启动⼀个新进程。调⽤unshare()的主要作⽤就是,不启动新进程就可以起到隔离的效果,docker⽬前并没有使⽤这个系统调⽤。
⊙ fork()系统调⽤
系统调⽤函数fork()并不属于namespace的API。当程序调⽤fork()函数时,系统会创建新的进程,为其分配资源,例如存储数据和代码的空间,然后把原来进程的所有值都复制到新进程中,只有少量数值与原来的进程值不同,相当于复制了本身。
下⾯给出⼀段实例代码,命名为fork_example.c。
#include <unistd.h>
#include <stdio.h>
int main(){
pid_t fpid; // fpod表示fork函数返回的值
//int count=0;
fpid=fork();
if (fpid < 0)printf("error in fork!");
else if (fpid == 0) {
   printf("I am child. Process id is %d\n",getpid());
  }
else {
  printf("i am parent. Process id is %d\n",getpid());
  }
  return 0;
}
编译并执⾏,结果如下
使⽤fork()后,⽗进程有义务监控⼦进程的运⾏情况,并在⼦进程退出后⾃⼰才能正常退出,否则⼦进程就会成为“孤⼉”进程。
[root@Anolis2 ~]# gcc -Wall fork_example.c && ./a.out
i am parent. Process id is 71649
I am child. Process id is 71650
在执行fpid = fork()的时候,内核会克隆一个和父进程完全一样的子进程(复制代码、内存、堆栈),父子进程同时执行fork之后的代码,两个进程独立运行,互不干扰这就是 Linux 多进程、多任务 的基础原理。
UTS namespace
UTS(UNIX Time-sharing System) namespace 提供了主机名和域名的隔离,这样每个Docker容器就可以拥有独⽴的主机名和域名了,在⽹络上可以被视作⼀个独⽴的节点,⽽⾮宿主机上的⼀个进程。docker中,每个镜像基本都以⾃身所提供的服务名称来命名镜像的hostname,且不会对宿主机产⽣任何影响,其原理就是利⽤了UTS namespace。通过下⾯代码来感受⼀下UTS隔离的效果。
[root@Anolis2 ~]# vi uts.c
#define _GNU_SOURCE
#include <sys/types.h>
#include <sys/wait.h>
#include <stdio.h>
#include <sched.h>
#include <signal.h>
#include <unistd.h>
#define STACK_SIZE (1024 * 1024)
static char child_stack[STACK_SIZE];
char* const child_args[] = {
    "/bin/bash",
    NULL
};
    int child_main(void* args) {
    printf("在子进程中 !\n");
    execv(child_args[0], child_args);
    return 1;
}
    int main() {
    printf("程序开始: \n");
    int child_pid = clone(child_main, child_stack + STACK_SIZE, SIGCHLD, NULL);
    waitpid(child_pid, NULL, 0);
    printf("已退出\n");
    return 0;
}
[root@Anolis2 ~]# gcc -Wall uts.c -o uts.o && ./uts.o
程序开始:
在子进程中 !
[root@Anolis2 ~]# exit
exit
已退出
clone() = 容器的进程创建器
通过不同的标志(CLONE_NEWUTS/CLONE_NEWPID/CLONE_NEWNET),实现不同资源的隔离
下⾯将修改代码,加⼊UTS隔离。运⾏代码需要root权限,以防⽌普通⽤户任意修改系统主机名导致set-user-ID相关的应⽤运⾏出错。
int child_main(void* args) { printf("在⼦进程中 !\n"); sethostname("NewNamespace", 12); execv(child_args[0], child_args); return 1; } int main() { printf("程序开始: \n"); int child_pid = clone(child_main, child_stack + STACK_SIZE, CLONE_NEWUTS | SIGCHLD, NULL); waitpid(child_pid, NULL, 0); printf("已退出\n"); return 0; }
[root@docker ~]# gcc -Wall uts.c -o uts.o && ./uts.o
程序开始:
在⼦进程中 !
[root@NewNamespace ~]# exit
exit
已退出
[root@vlnx251106 ~]#
IPC namespace
进程间通信(Inter-Process Communication, IPC)涉及的IPC资源包括常⻅的信号量、消息队列和共享内存。申请IPC资源就申请了⼀个全局唯⼀的32位ID,所以IPC namespace中实际上包含了系统IPC标识符以及实现POSIX消息队列的⽂件系统。在同⼀个IPC namespace下的进程彼此可⻅,不同IPC namesapace下的进程则互相不可⻅。
IPC namespace在实现代码上与UTC namespace相似,只是标识位有所变化,需要加上CLONE_NEWIPC参数。主要改动如下,其它部分不变,程序名称改为ipc.c
- int child_pid = clone(child_main, child_stack + STACK_SIZE, CLONE_NEWIPC | CLONE_NEWUTS | SIGCHLD, NULL);
⾸先在shell中使⽤ipcmk -Q 命令创建⼀个memssage queue。
[root@docker ~]# ipcmk -Q
Message queue id: 0
通过ipcs -q 可以查看到已经开启的message queue ,序号为 0.
[root@vlnx251106 ~]# ipcs -q
------ Message Queues --------
key msqid owner perms used-bytes messages
0xb2954a75 0 root 644 0 0
然后可以编译运⾏加⼊了IPC namespace隔离的ipc.c,在新建的⼦进程中调⽤的shell中执⾏ipcs -q查看message queue。
[root@docker ~]# gcc -Wall ipc.c -o ipc.o && ./ipc.o
程序开始:
在⼦进程中 !
[root@NewNamespace ~]# ipcs -q
------ Message Queues --------
key msqid owner perms used-bytes messages
[root@NewNamespace ~]# exit
exit
已退出
从结果显示中可以发现,⼦进程找不到原先声明的message queue了,已经实现了IPC的隔离⽬前使⽤IPC namespace机制的系统不多,其中⽐较有名的有PostgreSQL。Docker当前也使⽤IPC namespace实现了容器与宿主机、容器与容器之间的IPC隔离。
PID namespace
PID namespace隔离⾮常实⽤,它对进程PID重新标号,即两个不同namespace 下的进程可以有相同的PID。每个PID namespace都有⾃⼰的计数程序。内核为所有的PID namespace维护了⼀个树状结构,最顶层的是系统初始时创建的,被称为 root namespace。它创建的新PID namespace被称为 child namespace(树的⼦节点),⽽原先的PID namespace就是新创建的PID namespace的parent namespace(树的⽗节点)。通过这种⽅式,不同的PID namespace会形成⼀个层级体系。所属的⽗节点可以看到⼦节点中的进程,并可以通过信号等⽅式对⼦节点中的进程产⽣影响。反过来,⼦节点却不能看到⽗节点PIDnamespace中的任何内容,由此产⽣如下结论。
- 每个PID namespace中的第⼀个进程“PID 1”,都会像传统linux中的init进程⼀样拥有特权,起特殊作⽤。
- ⼀个namespace中的进程,不可能通过kill或pstrace影响⽗节点或是兄弟节点中的进程,因为其他节点的PID在这个namespace中没有任何意义。
- 如果你在新的PID namespace 中重新挂载/proc⽂件系统,会发现其下只显示同属⼀个PID namespace中的其他进程。
- 在root namespace中可以看到所有的进程,并且递归包含所有⼦节点中的进程。
到这⾥,可能已经联想到⼀种在外部监控docker中运⾏程序的⽅法了,就是监控docker daemon所在的 PID namespace下的所有进程及其⼦进程,再进⾏筛选即可。
下⾯通过运⾏代码来感受⼀下PID namespace的隔离效果。修改上⽂的代码,加⼊PID namespace的标识位,并把程序命名为pid.c。
int child_pid = clone(child_main, child_stack + STACK_SIZE, CLONE_NEWPID | CLONE_NEWIPC | CLONE_NEWUTS | SIGCHLD, NULL);
编译运⾏可以看到如下结果
[root@docker ~]# gcc -Wall pid.c -o pid.o && ./pid.o
程序开始:
在⼦进程中 !
[root@NewNamespace ~]# echo $$
1
[root@NewNamespace ~]# exit
exit
已退出
打印$$可以看到shell的PID,退出后如果再次执⾏可以看到效果如下
[root@docker ~]# echo $$
19688
已经回到了正常状态。在⼦进程的shell中执⾏ps aux/ top之类的命令,可以看到所有⽗进程的PID,那是因为还没有对⽂件系统挂载点进程隔离,ps/top之类的命令调⽤的是真实系统下的/proc⽂件内容,看到的⾃然是所有的进程。所以,与其他的namespace不同的是,为了实现⼀个稳定安全的容器,PID namespace还需要进⾏⼀些额外的⼯作才能确保进程运⾏顺利,后续逐⼀介绍。
⊙ PID namespace 中的init进程
在传统的unix系统中,pid为1 的进程是init,地位⾮常特殊。它作为所有进程的⽗进程,维护⼀张进程表,不断检查进程的状态,⼀旦有某个⼦进程因为⽗进程错误成为了“孤⼉“进程,init就会负责收养这个⼦进程并最终回收资源,结束进程。所以在要实现的容器中,启动的第⼀个进程也需要实现类似init的功能,维护所有后续启动进程的运⾏状态。
当系统中存在树状嵌套结构的PID namespace时,,若某个⼦进程成为孤⼉进程,收养该⼦进程的责任就交给了该⼦进程所属的PID namespace中的init 进程。
PID namespace维护这样⼀个树状结构,有利于系统的资源监控与回收。因此,如果确实需要在⼀个docker容器中运⾏多个进程,最先启动的命令进程应该是具有资源监控与回收等管理能⼒的,如bash。
⊙ 信号与init进程
内核还为PID namespace中的init 进程赋予了其他特权————信号屏蔽。如果init中没有编写处理某个信号的代理逻辑,那么与init在同⼀个PID namespace下的进程(即使有超级权限)发送给它的该信号都会被屏蔽。这个功能的主要作⽤是防⽌init进程被误杀。
那么,⽗节点PID namespace中的进程发送同样的信号给⼦节点中的init进程,这会被忽略么? ⽗节点中的进程发送的信号,如果不是SIGKILL(销毁进程)或SIGSTOP(暂停进程)也会被忽略。但如果发送SIGKILL或SIGSTOP,⼦节点的init会强制执⾏(⽆法通过代码捕捉进⾏特殊处理),也即是说⽗节点中的进程有权终⽌⼦节点中的进程。⼀旦init进程被销毁,同⼀PID namespace中的其他进程也随之接收到SIGKILL信号⽽被销毁。理论上,该PID namespace也不复存在了。但是如果/proc/[pid]/ns/pid处于被挂载或者打开状态,namespace就会被
保留下来。然⽽,保留下来的namespace⽆法通过setns()或者fork()创建进程,所以实际上并没有什么作⽤。
当⼀个容器内存在多个进程时,容器内的init进程可以对信号进程捕获,当SIGTERM或SIGINT等信号到来时,对其⼦进程做信息保存、资源回收等处理⼯作。在docker daemon的源码中也可以看到类似的处理⽅式,当结束信号来临时,结束容器进程并回收相应资源。
⊙ 挂载proc⽂件系统
前⾯提到,如果在新的PID namespace中使⽤ps命令查看,看到的还是所有的进程,因为与PID直接相关的/proc⽂件系统(procfs)没有挂载到⼀个与原/proc不同的位置。如果只想看到PID namespace本身应该看到的进程,需要重新挂载/proc,命令如下。
[root@NewNamespace ~]# mount -t proc proc /proc
[root@NewNamespace ~]# ps a
PID TTY STAT TIME COMMAND
1 pts/1 S 0_00 /bin/bash
16 pts/1 R+ 0_00 ps a
可以看到实际的PID namespace就只有两个进程在运⾏。
⚠ 注意:此时并没有进⾏mount namespace的隔离,所以该操作实际上已经影响了root namespace的⽂件系统。当退出新建的PID namespace以后,再执⾏ps a时,就会发现出错,再次执⾏mount -t proc proc /proc可以修复错误。后⾯还会介绍通过mount namespace来隔离⽂件系统,当我们基于mount namespace实现了容器proc⽂件系统隔离后,我们就能在docker 容器中使⽤ps等命令看到与PID namespace对应的进程列表。
⊙ unshare()和setns()
unshare()和setns()这两个API,在PID namespace中使⽤时,也有⼀些特别之处需要注意。
unshare()允许⽤户在原有进程中建⽴命令空间进⾏隔离。但创建PID namespace后,原先unshare()调⽤者进程并不进⼊新的PID namespace,接下来创建的⼦进程才会进⼊新的namespace,这个⼦进程也就随之成为新namespace中的init进程。
类似地,调⽤setns()创建新PID namespace时,调⽤者进程也不进⼊新的PID namespace,⽽是随后创建的⼦进程进⼊。
为什么创建其他namespace时unshare()和setns()会直接进⼊新的namespace,⽽唯独PID namespace例外呢?因为调⽤getpid()函数得到的PID是根据调⽤者所在的PID namespace⽽决定返回哪个PID,进⼊新的PID namespace会导致PID产⽣变化。⽽对⽤户态的程序和库函数来说,它们都认为进程的PID是⼀个常量,PID的变化会引起这些进程崩溃。
换句话说,⼀旦程序进程创建以后,那么它的PID namespace的关系就确定下来了,进程不会变更它们对应的PID namespace。在docker中,docker exec会使⽤setns()函数加⼊已经存在的命令空间,但是最终还是会调⽤clone()函数,原因就在于此。
mount namespace
mount namespace通过隔离⽂件系统挂载点对隔离⽂件系统提供⽀持,它是历史上第⼀个linux namespace,所以标志位⽐较特殊,就是CLONE_NEWNS。隔离后,不同mount namespace中的⽂件结构发⽣变化也互不影响。可以通过/proc/[pid]/mounts查看到所有挂载在当前namespace中的⽂件系统,还可以通过/proc/[pid]/mountstats看到mount namespace中⽂件设备的统计信息,包括挂载⽂件的名字、⽂件系统类型、挂载位置等。
进程在创建mount namespace时,会把当前的⽂件结构复制给新的namespace。新namespace中的所有mount操作都只影响⾃身的⽂件系统,对外界不会产⽣任何影响。这种做法⾮常严格地实现了隔离,但对某些情况可能并不适⽤。⽐如⽗节点namespace中的进程挂载了⼀张CD-ROM,这时⼦节点namespace复制的⽬录结构是⽆法⾃动挂载上这张CD-ROM的,因为这种操作会影响到⽗节点的⽂件系统。
CLONE_NEWNS⽣效之后,⼦进程进⾏的挂载与卸载操作都将只作⽤于这个mount namespace,因此在上⽂中提到的处于单独PID namespace隔离中的进程在加上mount namespace的隔离之后,即使该进程重新挂载了/proc⽂件系统,当进程退出后,root mount namespace(主机)的 /proc⽂件系统是不会被破坏的。
network namespace
解完各类namespace,构建出⼀个容器,并在容器中启动⼀个apache进程时,却出现了“80端⼝已被占⽤“的错误,原来主机上已经运⾏了⼀个apache进程,这时就需要借助network namespace技术进⾏⽹络隔离。
network namespace主要提供了关于⽹络资源的隔离,,包括⽹络设备、IPv4和IPv6协议栈、IP路由表、防⽕墙、/proc/net⽬录、/sys/class/net⽬录、套接字(socket)等。⼀个物理的⽹络设备最多存在于⼀个network namespace中,可以通过创建veth pair(虚拟⽹多存在于⼀个network namespace中,可以通过创建veth pair(虚拟⽹络设备对:有两端,类似管道,如果数据从⼀端传⼊另⼀端也能接收
到,反之亦然)在不同的network namespace间创建通道,以达到通信⽬的。
当说到network namespace时,指的未必是真正的⽹络隔离,⽽是把⽹络独⽴出来,给外部⽤户⼀种透明的感觉,仿佛在与⼀个独⽴⽹络实体进⾏通信。为了达到该⽬的,容器的经典做法就是创建⼀个veth pair,⼀端放置在新的namespace中,通常命名为eth0,⼀端放在原先的namespace中连接物理⽹络设备,在通过把多个设备接⼊⽹桥或者进⾏路由转发,来实现通信的⽬的。
在建⽴起veth pair之前,新旧namespace通过pipe(管道)通信。以docker daemon启动容器的过程为例,假设容器内初始化的进程称为init。docker daemon在宿主机上负责创建这个veth pair,把⼀端绑定到docker0⽹桥上,另⼀端接⼊新建的network namespace进程中。这个过程执⾏期间,docker daemon和init就通过pipe进⾏通信。具体来说,
就是在docker daemon完成veth pair的创建之前,init 在管道的另⼀端循环等待,直到管道另⼀端传来docker daemon关于veth设备的信息,并关闭管道。init 才结束等待的过程,并把它的“eth0”启动起来。
整个结构如下图
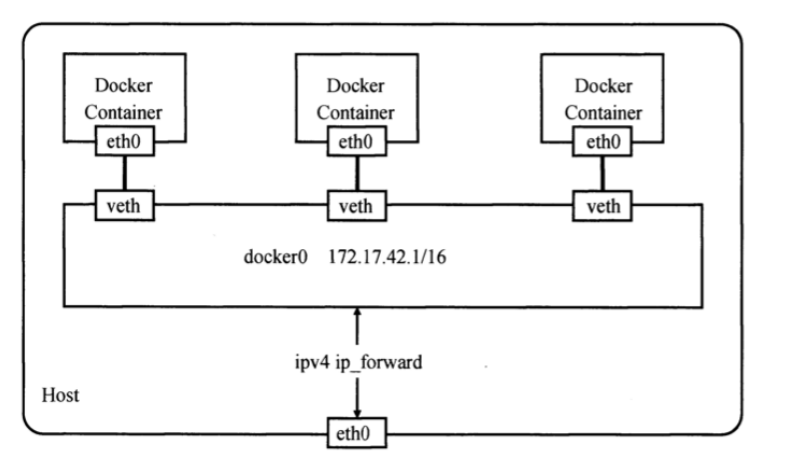
Docker⽹络示意图
与其他namespace类似,对network namespace的使⽤其实就是在创建
的时候添加CLONE_NEWNET标识位。
user namespaces
user namespace主要隔离了安全相关的标识符(identifier)和属性(attribute),包括⽤户ID、⽤户组ID、root⽬录、key(指密钥)以及特殊权限。通俗地讲,⼀个普通⽤户的进程通过clone()创建的新进程在新user namespace中可以拥有不同的⽤户和⽤户组。这意味着⼀个进程在容器外属于⼀个没有特权的普通⽤户,但是它创建的容器进程却属于拥有所有权限的超级⽤户,,这个技术为容器提供了极⼤的⾃由。
user namespace 是⽬前的6个namespace中最后⼀个⽀持的,并且直到linux内核3.8版本的时候还未完全实现(还有部分⽂件系统不⽀持)。user namespace实际上并不算完全成熟,很多发⾏版担⼼安全问题,在编译内核的时候并未开启USER_NS。docker在1.10版本中对user namespace进⾏了⽀持。只要⽤户在启动docker daemon的时候指定了 --userns-remap,那么当⽤户运⾏容器时,容器内部的root⽤户并不等于宿主机内的root⽤户,⽽是映射到宿主上的普通⽤户。在进⾏
接下来的代码实验时,请确保系统的linux内核版本⾼于3.8并且内核编译时开启了USER_NS.
linux中,特权⽤户的userID就是0,演示的最后将看到user ID⾮0的进程启动user namespace后user ID可以变为0 。使⽤user namespace的⽅法跟别的namespace相同,即调⽤clone()或unshare()时加⼊CLONE_NEWUSER标识位。修改代码并另存为userns.c,为了看到⽤户权限(Capabilities),还需要安装libcap-devel包。
⾸先包含以下头⽂件以调⽤capabilities包
#include
其次在⼦进程函数中加⼊geteuid()和getegid()得到namespace内部的user ID,通过cap_get_proc()得到当前进程的⽤户拥有的权限,并通过cap_to_text()输出。
int child_main(void* args) { printf("在⼦进程中 !\n"); sethostname("NewNamespace", 12); cap_t caps; printf("eUID = %ld; eGID = %ld; ", (long) geteuid(), (long) getegid()); caps = cap_get_proc(); printf("capabilities: %s\n", cap_to_text(caps, NULL)); execv(child_args[0], child_args); return 1; }
在主函数的clone()调⽤中加⼊标识符
int child_pid = clone(child_main, child_stack + STACK_SIZE, CLONE_NEWUSER |
SIGCHLD, NULL);
⾄此,第⼀部分的代码修改就结束了。在编译之前先查看⼀下当前⽤户的uid和gid,此时显示的是普通⽤户。
[zhaoyg@vlnx251106 ~]$ id -u1000
[zhaoyg@vlnx251106 ~]$ id -g
1000
然后开始编译运⾏,并进⼊新建的user namespace,会发现shell提示符钱的⽤户名已经变为nobody。
再次修改代码,添加设置uid和gid的函数。
void set_uid_map(pid_t pid, int inside_id, int outside_id, int length) { char path[256]; sprintf(path, "/proc/%d/uid_map", getpid()); FILE* uid_map = fopen(path, "w"); fprintf(uid_map, "%d %d %d", inside_id, outside_id, length); fclose(uid_map); } void set_gid_map(pid_t pid, int inside_id, int outside_id, int length) { char path[256]; sprintf(path, "/proc/%d/gid_map", getpid()); FILE* gid_map = fopen(path, "w"); fprintf(gid_map, "%d %d %d", inside_id, outside_id, length); fclose(gid_map); } int child_main(void* args) { cap_t caps; printf("在⼦进程中 !\n"); set_uid_map(getpid(), 0, 1000, 1); set_gid_map(getpid(), 0, 1000, 1); printf("eUID = %ld; eGID = %ld; ", (long) geteuid(), (long) getegid()); caps = cap_get_proc(); printf("capabilities: %s\n", cap_to_text(caps, NULL)); execv(child_args[0], child_args); return 1; }
编译后即可看到user已经变成了root。
[zhaoyg@vlnx251106 ~]$ gcc usernc.c -Wall -lcap -o usernc.o && ./usernc.o
⾄此,就已经完成了绑定的⼯作,可以看到演示全程都是在普通⽤户下执⾏的,最终实现了在user namespace中成为root⽤户,对应到外部则是⼀个uid为1000的普通⽤户。
如果要把user namespace与其他namespace混合使⽤,那么依旧需要root权限。解决⽅案是先以普通⽤户身份创建user namespace,然后在新建的namespace中作为root,在clone()进程加⼊其他类型的namespace隔离
docker不仅使⽤了user namespace,还使⽤了在user namespace中涉及的Capabilities机制。从内核2.2版本开始,linux把原来和超级⽤户相关的⾼级权限划分为不同的单元,称为Capability。这样管理员就可以独⽴对特定的Capability进⾏使⽤或禁⽌。docker同时使⽤ usernamespace和Capability,这在很⼤程度上加强了容器的安全性。
说到安全,namespace的6项隔离看似全⾯,实际上依旧没有完全隔离linux的资源,⽐如 selinux、cgroups以及/sys、/proc/sys、/dev/sd*等⽬录下的资源。
这⾥从namespace使⽤的API开始,结合docker逐步对6个namespace进⾏了讲解。虽然namespace技术使⽤⾮常简单,但要真正把容器做到iptables规则没有配置;user namespace中还有许多权限问题需要考虑。
更多推荐

 11
 0
- 0


 已为社区贡献17条内容

所有评论(0)