
[CVPR 2024]Continual Self-Supervised Learning: Towards Universal Multi-Modal Medical Data Representa
论文代码:https://github.com/yeerwen/MedCoSS
目录
2.3.1. Medical Self-Supervised Learning
2.3.2. Continual Learning for Knowledge Retention
2.4.2. Universal Architecture for Multi-Modal Ssl
2.4.3. Rehearsal-Based Continual Pre-Training
2.4.4. Fine-Tuning on Downstream Tasks
2.5.3. Comparing to State-of-the-Art Ssl
2.5.5. Impact of Buffer Size on Model Performance
2.5.6. Knowledge Retention in Sequential Per-Training
2.5.7. Pre-Training Order of Modality
1. 心得
(1)正文内容不多,可能需要看附录和代码能学得更仔细
2. 论文逐段精读
2.1. Abstract
①挑战:多模态自监督在表征学习上有冲突;提前收集的多模态数据无法覆盖所有真实场景
②作者提出多模态(包括临床报告、X光、CT、MRI和病理图像)持续学习自监督方法MedCoSS
2.2. Introduction
①现有的自监督都是单模态或多模态或维度有限
②作者把ViT/B作为骨干,masked modeling作为借口任务(pretext task,通常指真正任务的前置辅助任务,如真实任务是分类,辅助任务可能是求得表征)
③单模态任务在跨模态数据集上表现不好(那肯定的):
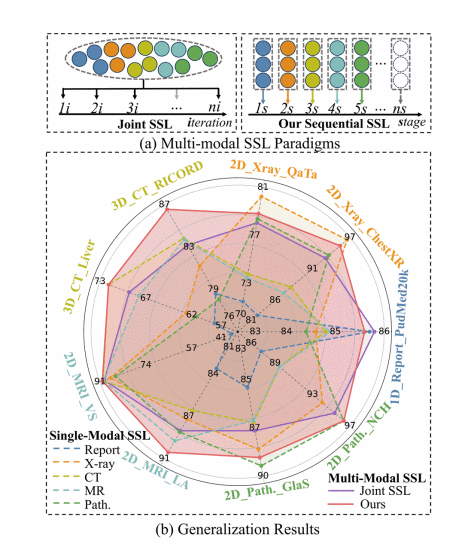
这里面(a)是说别人的自监督多模态混杂在一起了但作者分开的,更新成本低;(b)是多模态自监督(实线)泛化能力普遍强于单模态(虚线)
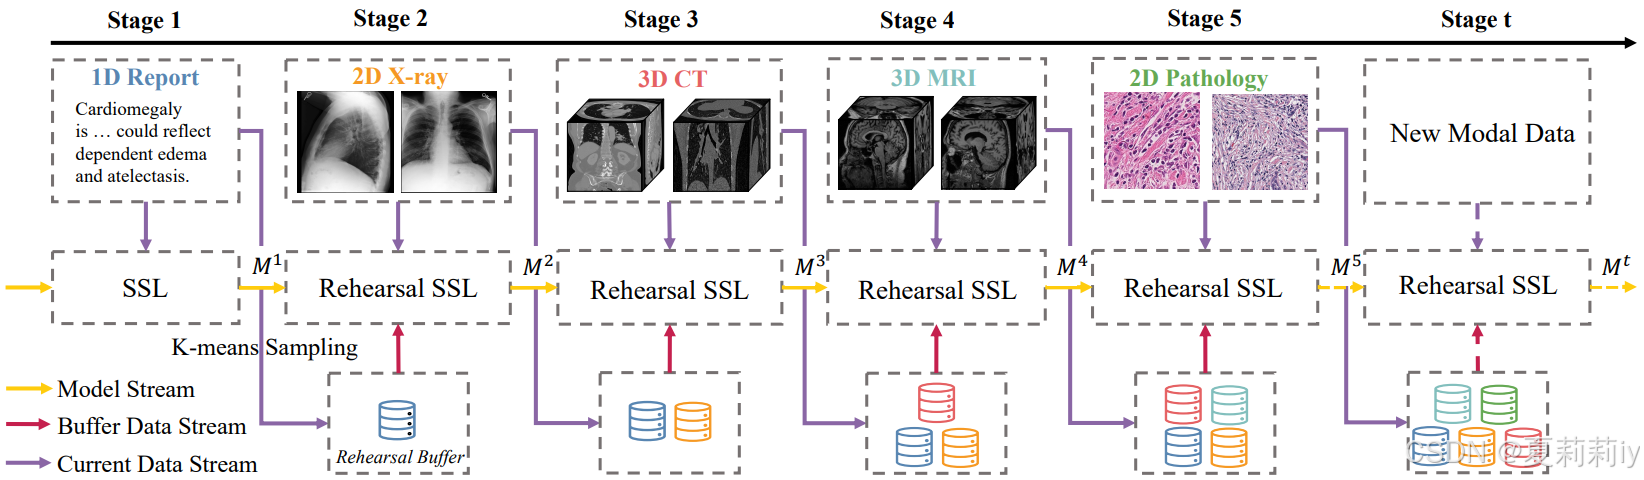
④作者的持续学习MedCoSS在排练缓冲区中保留部分(例如5%)的先前模态数据
2.3. Related Work
2.3.1. Medical Self-Supervised Learning
①无监督分为单模态无监督,配对多模态无监督和非配对多模态无监督
2.3.2. Continual Learning for Knowledge Retention
①持续学习包括:基于正则化的方法、基于演练的方法、基于优化的方法、基于表示的方法和基于架构的方法
②作者使用演练的,保留一些重要数据后续回放
2.4. Approach
2.4.1. Overview
①两步的MedCoSS分为无监督掩码建模和全监督微调:
2.4.2. Universal Architecture for Multi-Modal Ssl
①作者统一将一维(如临床报告)、二维(如X光和病理影像)或三维(如CT和MRI扫描)数据转换成token序列,其中byte pair encoding (BPE) tokenizer用于转换文本,2D/3D image patch tokenizer用于转换2维和3维影像
②数据重建:
| 针对文本(1D 临床报告) | 采用 BERT 式的掩码语言建模(MLM),随机掩码 15% 的词汇,模型通过上下文预测掩码词汇,以交叉熵损失为约束 |
| 针对视觉数据(2D/3D 图像) | 采用 MAE 式的掩码图像建模(MIM),随机掩码 75% 的图像 token 序列,模型通过未掩码部分结合可学习掩码 token,重建掩码区域的图像内容,以均方误差(MSE)损失为约束 |
2.4.3. Rehearsal-Based Continual Pre-Training
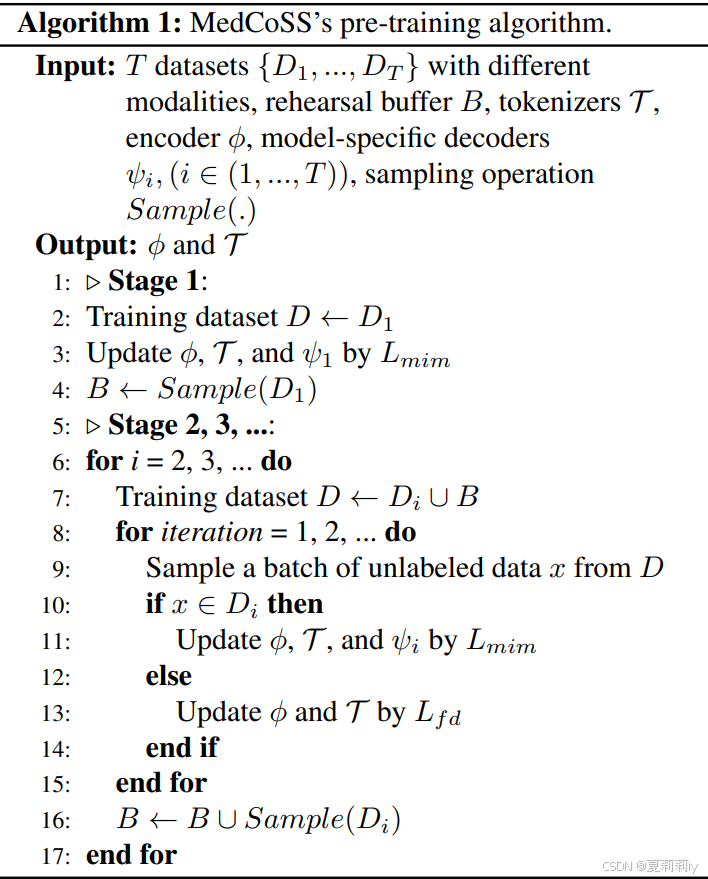
①对于个无标签数据
,每个数据是不同的模态。作者在每个阶段只训练一个模态
②作者每个模态会使用一个编码器和三个tokenizers
(这些是可学习的模型,冻结后会得到
和
):
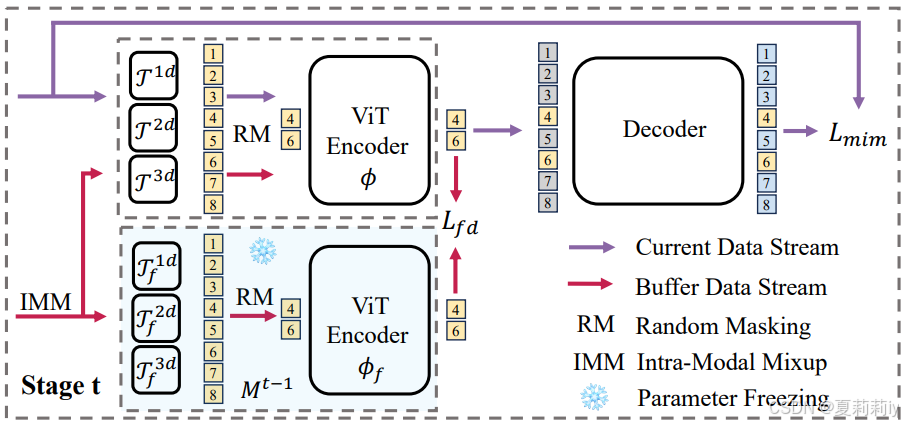
③为了记录以前的模态,建立排演缓冲区:
这个缓冲区中的数据是每个模态使用k means聚类(类别数是子集大小的1%)得到每个离聚类中心最近的点
④对文本进行增强,即将原始句子复制一份,将复制的打乱顺序,然后增强的句子每个字是从原始的或打乱的里面抽一个:
其中,
代表二元掩码序列
⑤对视觉图像进行增强(和文本一样,只是打乱的是像素):
⑥算法:
2.4.4. Fine-Tuning on Downstream Tasks
①使用MLP进行分类,使用卷积来分割
2.5. Experiment
2.5.1. Datasets
①数据集统计:
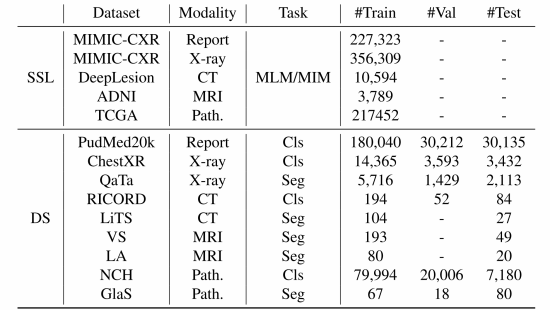
模态类型:报告、X光、CT、MRI和病理影像(Path.);
2.5.2. Implementation Details
①一维向量长度维112,二维patch大小为224×224,三维为16×192×192
②数据增强:对二维图像使用随机裁剪、调整大小和翻转,三维图像用镜像增强
③批量:512
④epoch:300
⑤采样数:
2.5.3. Comparing to State-of-the-Art Ssl
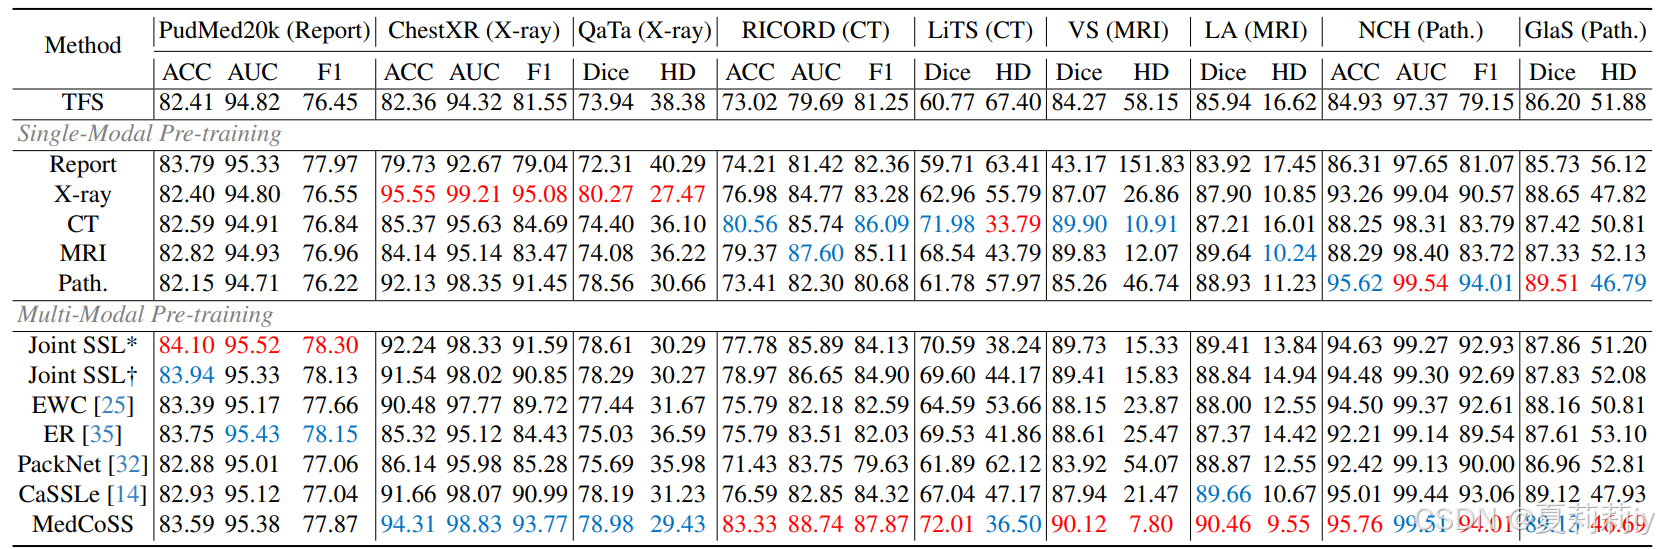
①性能比较:
2.5.4. Ablation Studies
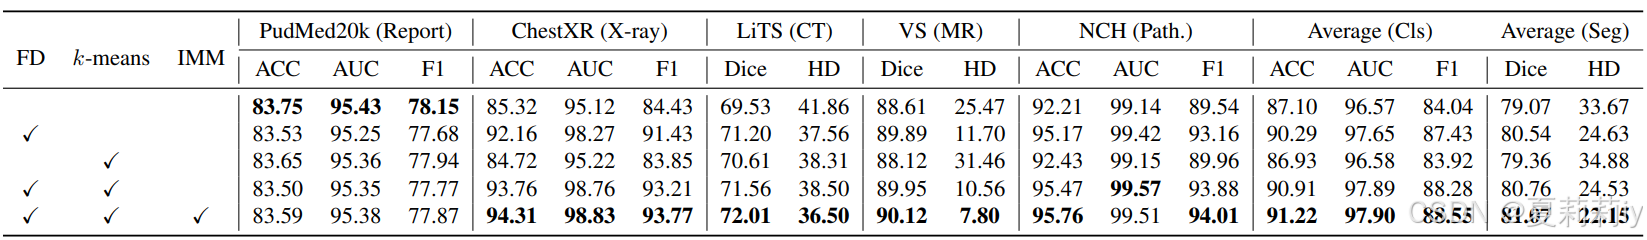
①对特征细致化(FD)、k均值、模态内混合(IMM)进行消融:
2.5.5. Impact of Buffer Size on Model Performance
①缓冲区平衡实验:
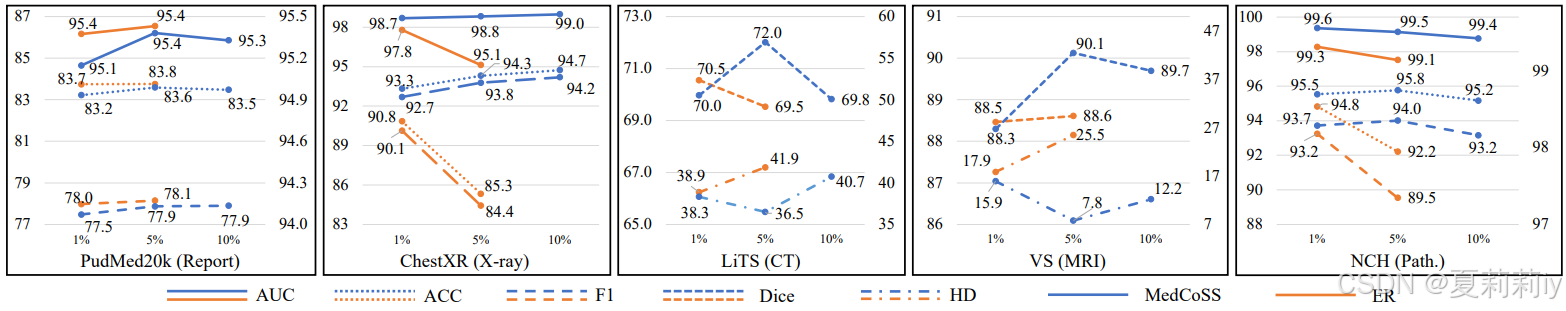
2.5.6. Knowledge Retention in Sequential Per-Training
①预训练期间的性能变化:
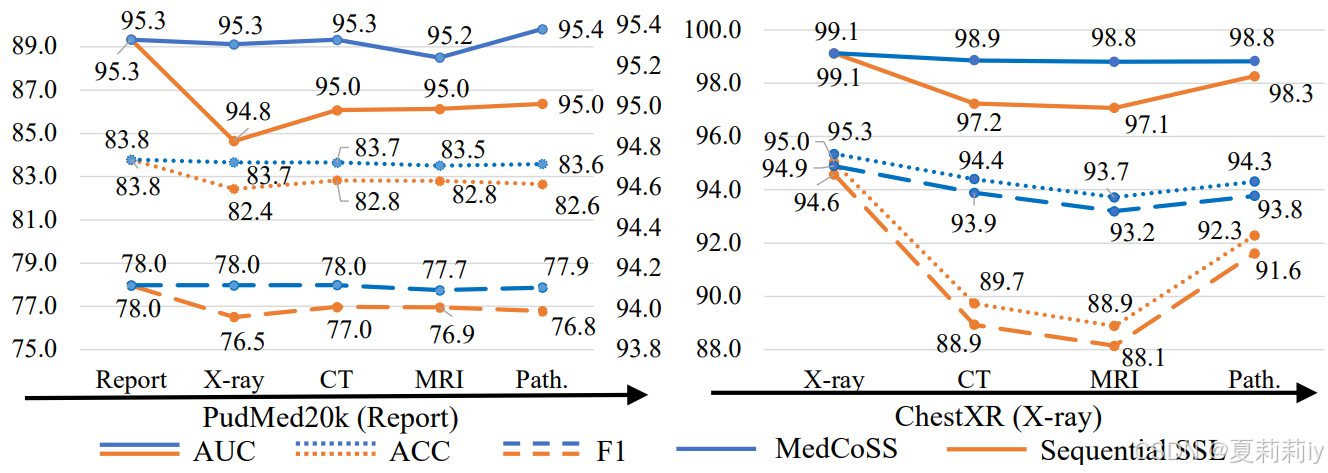
2.5.7. Pre-Training Order of Modality
①不同预训练顺序下的表现:

2.6. Conclusion
~
更多推荐

 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)