
云原生笔记
概述大纲
云平台
- 云服务器作为应用的最终载体
- VPC为所有云服务器提供网络隔离
- 所有云服务器都是绑定某个私有网络
- 安全组控制每个服务器的防火墙规则
- 公网IP使得资源可访问
- 端口转发的方式访问到具体服务器
 行成局域网 VPC

可固定IP数量
| 维度 | 具体好处 | 简要说明 |
|---|---|---|
| 网络隔离安全 | 独立私有网络空间 | 资源与公网、其他租户逻辑隔离,避免直接暴露 |
| 自定义安全组 / 防火墙 | 精细控制入站、出站流量,只开放必要端口 | |
| 子网分段规划 | 可划分公网子网、私有子网,核心数据不触达公网 | |
| 网络可控性 | 自定义网段与 IP | 自由规划内网 IP 段(如 192.168.xx、10.xx),不冲突 |
| 路由表自主管理 | 控制流量走向,指定哪些子网走公网、哪些走内网 | |
| 弹性公网 IP 绑定 | 可独立申请、解绑公网 IP,灵活对外提供服务 | |
| 访问与连接 | 支持 VPN / 专线接入 | 企业本地机房与云上 VPC 安全互通,构建混合云 |
| 同区域 / 跨区域互联 | VPC 对等连接,实现多业务系统内网互通 | |
| 内网访问云服务 | 走内网访问数据库、对象存储等,更安全更快 | |
| 性能与成本 | 内网流量低延迟、免费 | 同 VPC 内云产品内网通信,速度快且不计公网流量费 |
| 带宽灵活控制 | 独立管理公网出口带宽,避免资源争抢 | |
| 运维与扩展 | 架构标准化 | 适合按环境划分(开发 / 测试 / 生产),互不干扰 |
| 高可用与容灾 | 跨可用区部署资源,VPC 统一网络平面 | |
| 易扩展迁移 | 网络架构稳定,新增资源可直接加入现有规划 |
Docker
入门
Docker是一种虚拟化容器技术。Docker基于镜像,可以秒级启动各种容器。每一种容器都是一个完整的运行环境,容器之间互相隔离。
docker rm -f 容器名 # 先删容器 docker rmi 镜像名 # 再删镜像
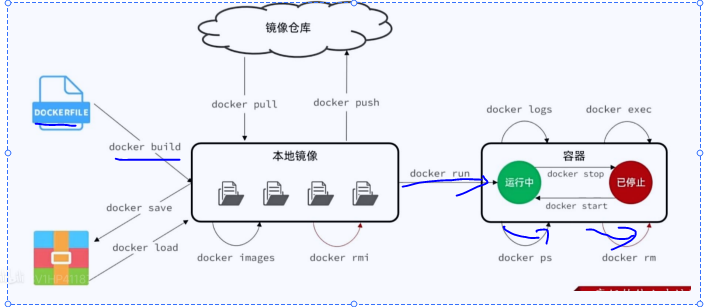
1.docker build -docker shell脚本编写
2.docker save / docker load -打包压缩 -解压
3.docker pull docker push-拉取-上传
4.docker images docker rmi-查看镜像 删除镜像
5..docker run 运行
6.docker logs- docker exec 日志退出
7.docker ps docker rm-查看容器-删除容器
docker案例基础操作
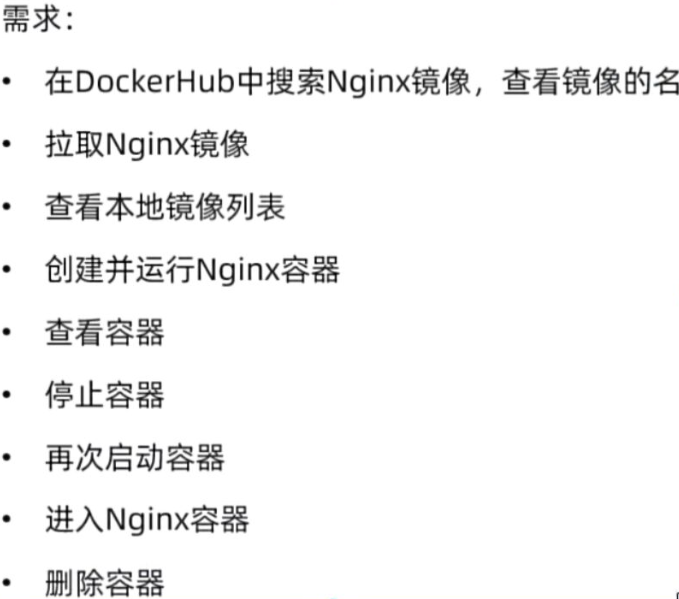
docker pull nginx

docker images
docker save -o nginx.tar nginx:latest
docker rmi nginx:latest
docker load -i nginx.tar
docker run -d --name nginx -p 80:80 nginx

docker stop nginx

docker start nginx

docker ps

docker logs -f nginx

docker exec -it nginx bash

exit

docker rm nginx

docker stop nginx

docker rm nginx
数据卷
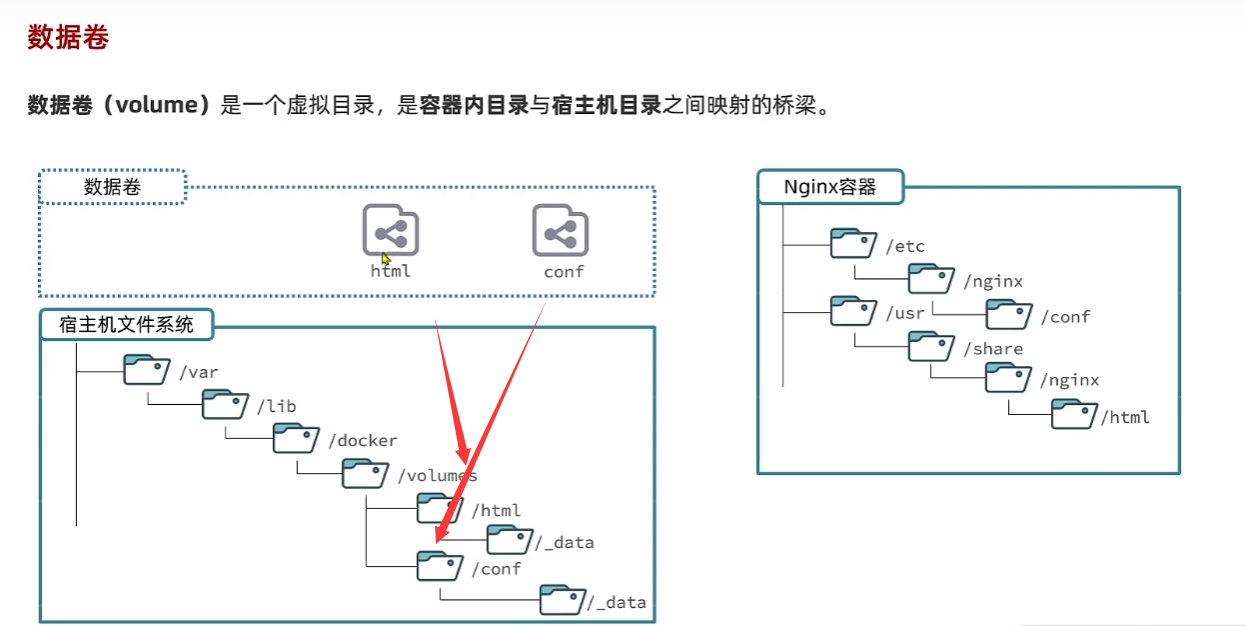
容器内的磁盘 是最小系统体 没有vim等编辑软件 如果想要更改内容就会灰常复杂 数据卷是一个虚拟目录 它将宿主机目录映射到1容器内目录 完成相互映射
映射图
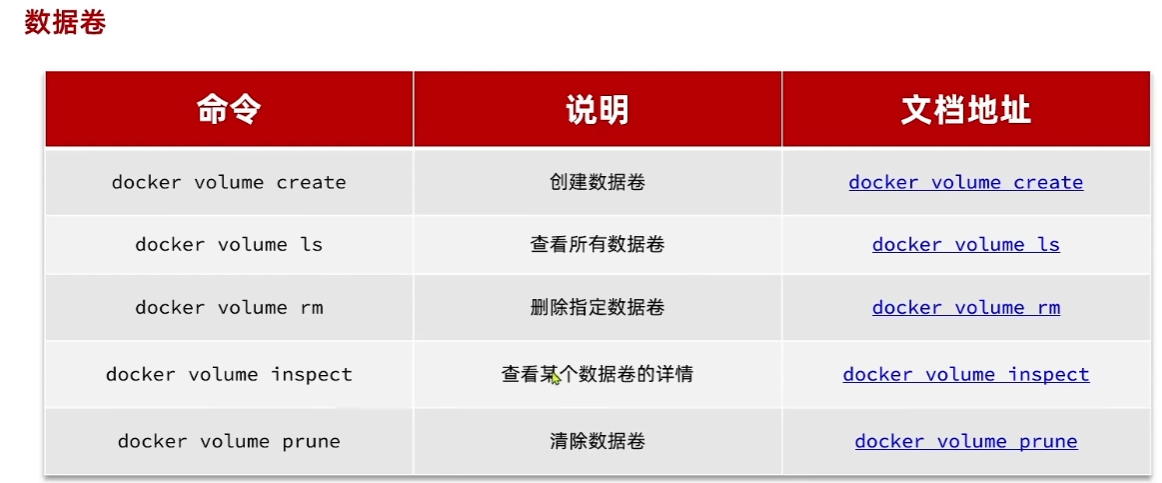
数据卷指令
数据卷挂载
run -v 参数 数据卷:容器内目录
当创建容器时,如果数据卷不存在,会自动创建数据卷
docker run -d --name nginx -p 80:80 -v html:/usr/share/nginx/html nginx
docker volume inspect html
挂载目录:/var/lib/docker/volumes/html/_data
随便修改 成功
本地目录挂载
docker inspect mysql
-mysql自带一个匿名卷


"Mounts": [
           {
               "Type": "volume",
               "Name":
"958f2ac10e1cffd31f52ef1781b9def6a1e6a4dbb29ee83151a70d2a5ad8aa61",
               "Source":
"/var/lib/docker/volumes/958f2ac10e1cffd31f52ef1781b9def6a1e6a4dbb29ee83151a
70d2a5ad8aa61/_data",
               "Destination": "/var/lib/mysql",
               "Driver": "local",
               "Mode": "",
               "RW": true,
               "Propagation": ""
           }
       ],

该目录存储这mysql的数据
mysql--容器内--本主机 匿名卷--名字很长 问题
mysql版本升级 删旧版容器 改新容器 新版本容器 生成新的卷 只能拷贝 ---
将mysql的数据映射到本地 这样每次新的mysql容器到来 我们继续指向映射地址 达到数据不变化
自定义镜像
什么是镜像:镜像包含了应用程序 程序运行的系统函数库
构建镜像就是把上述过程打包 部署jave镜像过程
1.准备linux服务器 2.安装jre并配置环境变量 3.拷贝jar包 4.运行jar包
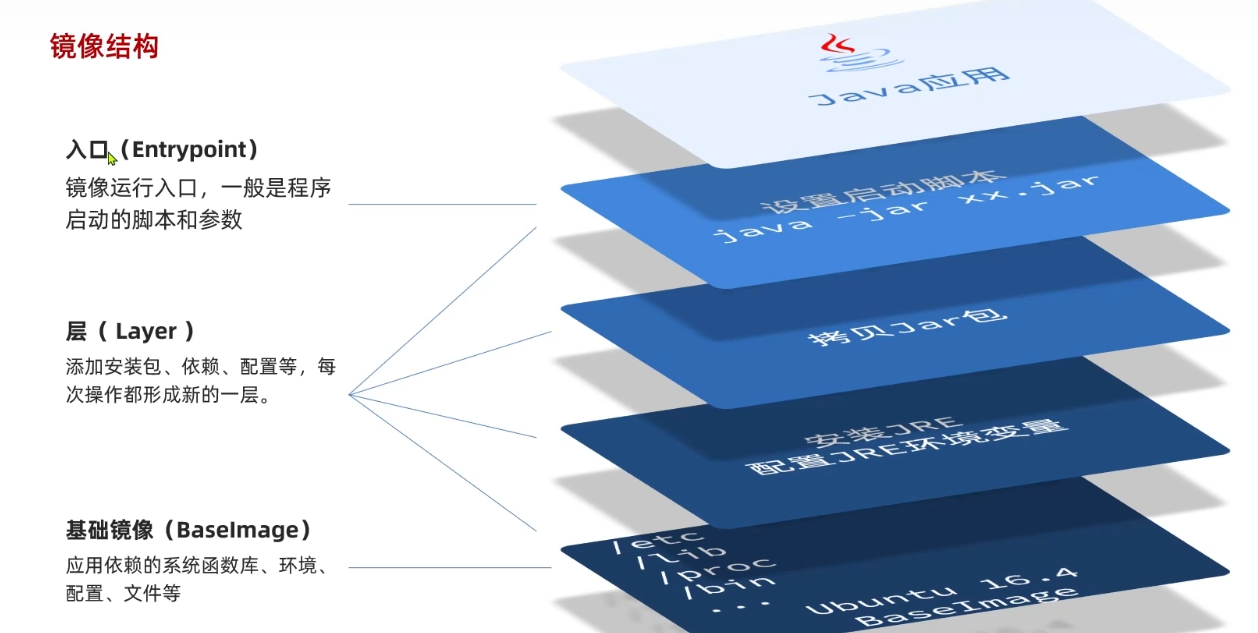
docker镜像制作
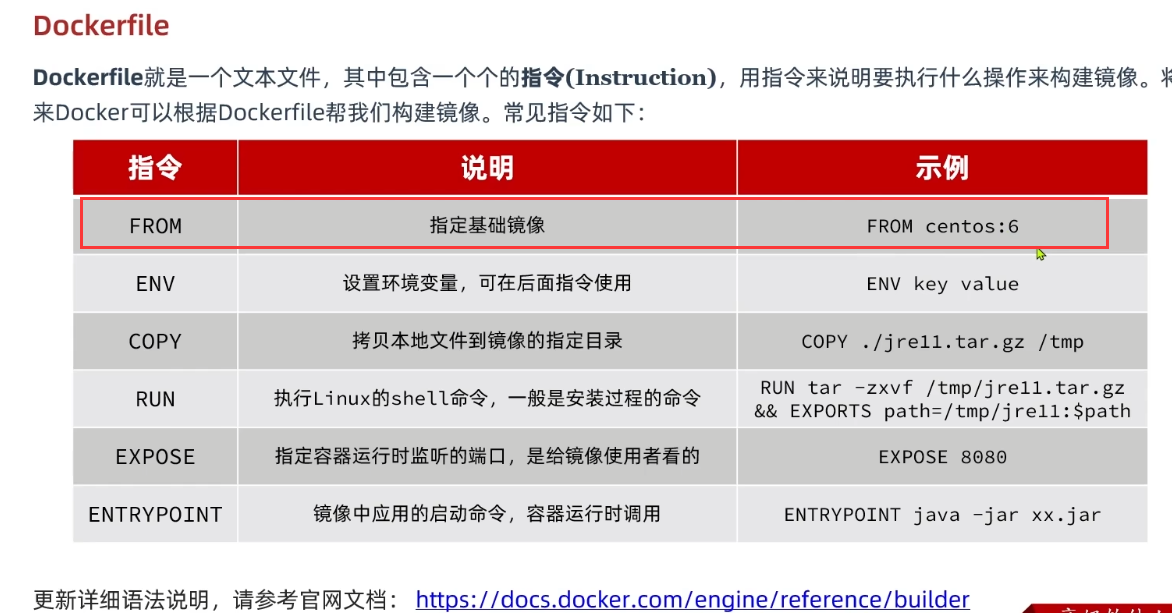
对此镜像的指令
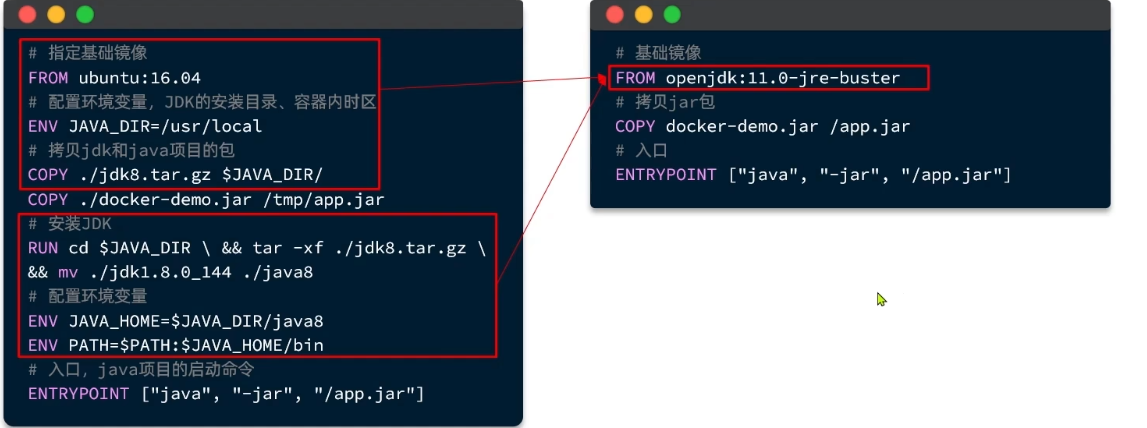
有好心人已经将基础包搭建好了 我们只需要拷贝jar包 指定入口即可
加载命令
docker build -t 容器名字 .(dockerfile的名字)--jar的镜像已经导入
容器网络互联
场景 我们的java容器要访问mysql内的资源 就需要网络互相连接
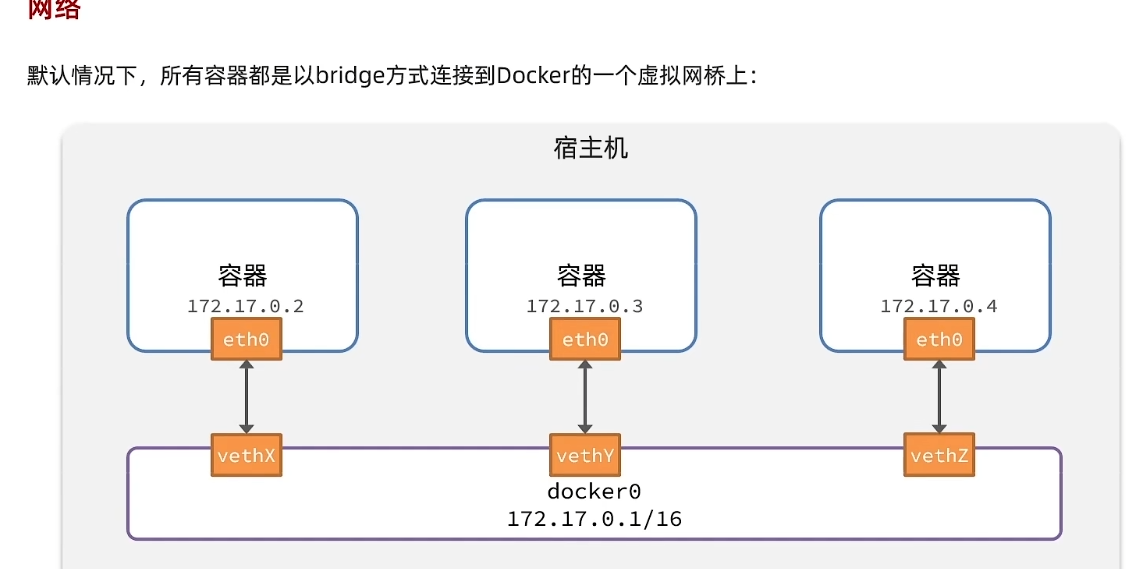
由ip绑定 如果ip改变又得更改 配置 故此我们自定义网桥
通过容器名实现互连
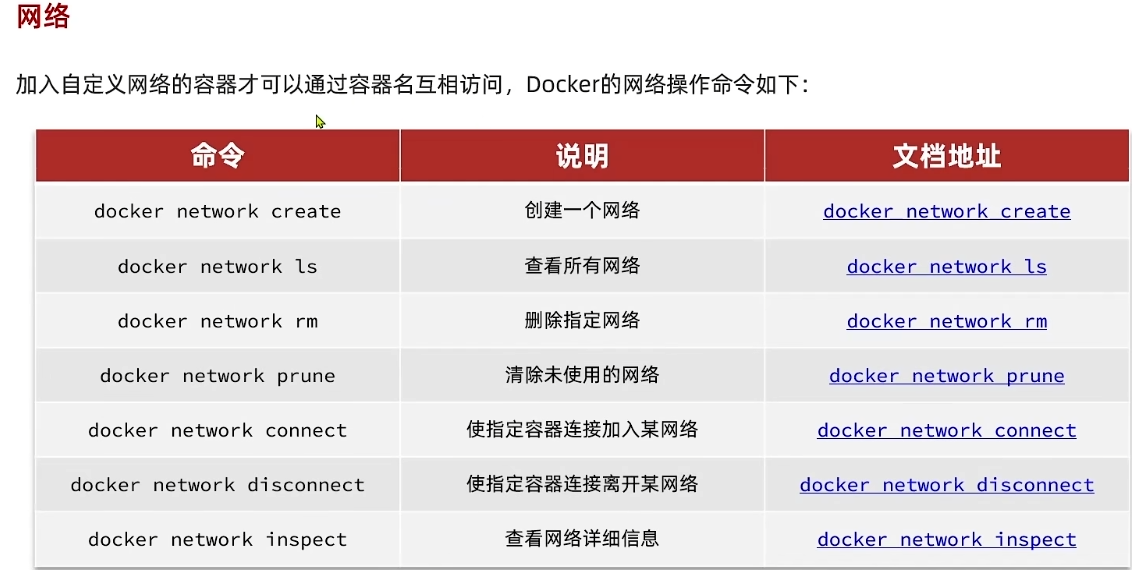
docker network create ii
docker network connect ii nginx
docker network connect ii my-mysql
docker exec -it nginx bash
root@778bbc619985:/# ping my-mysql
PING my-mysql (172.18.0.3) 56(84) bytes of data. 64 bytes from my-mysql.ii (172.18.0.3): icmp_seq=1 ttl=64 time=0.059 ms
- Nginx 可以反向代理后端服务
- 后端服务可以用
my-mysql:3306连接数据库- 所有通信走内网,不暴露端口到宿主机
Kubernetes
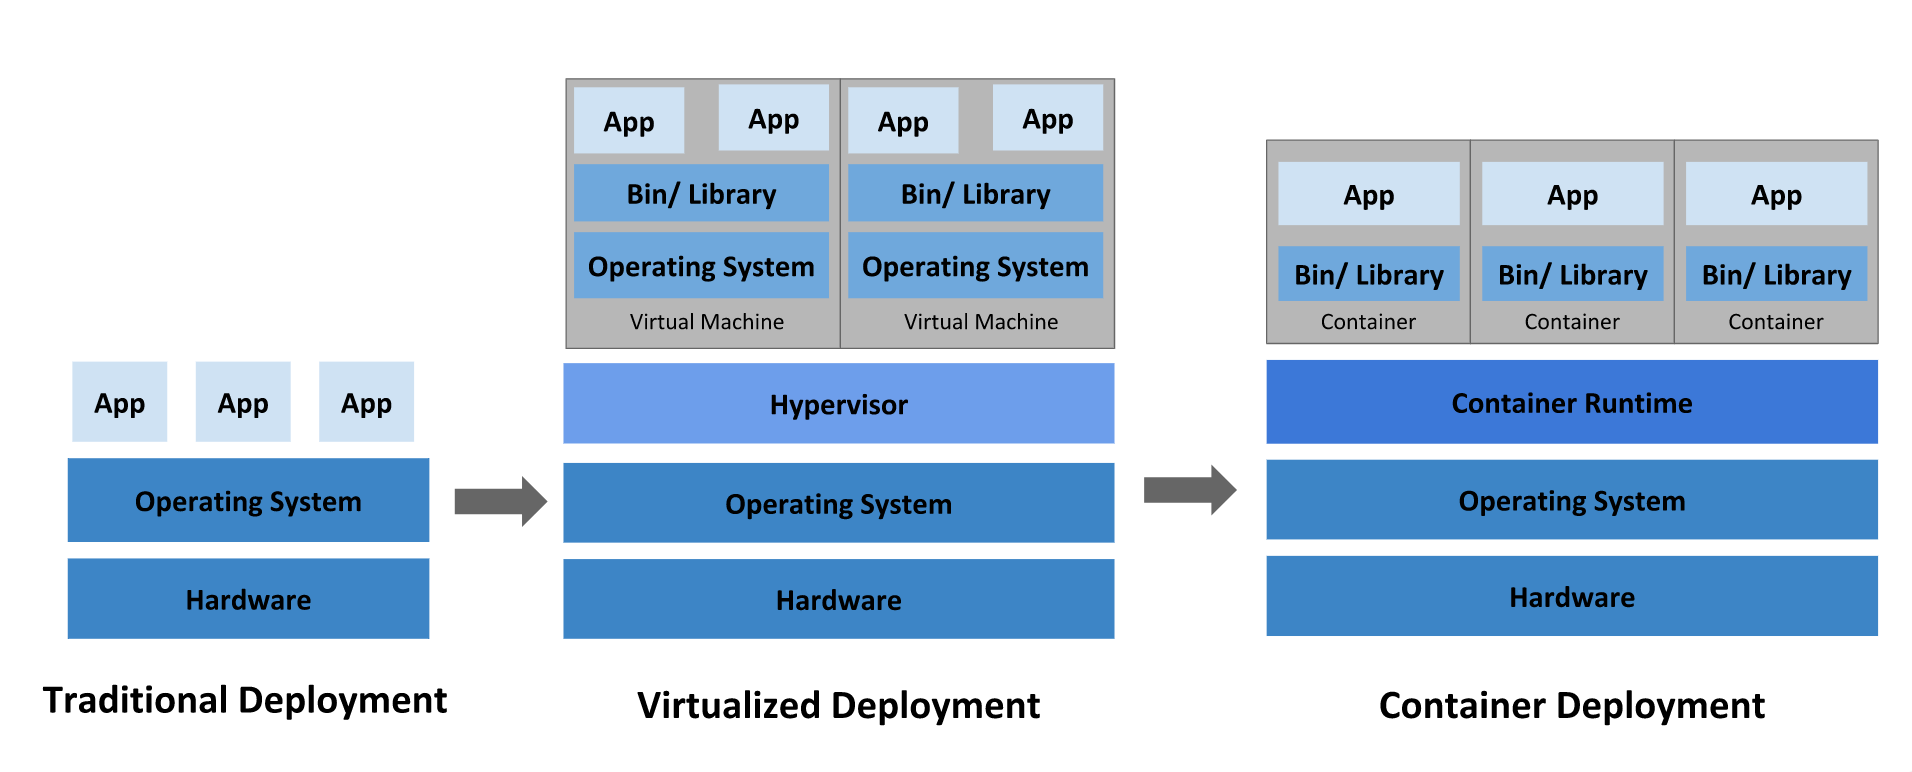
| 维度 | 传统部署 | 虚拟化部署 | 容器化部署 |
|---|---|---|---|
| 隔离级别 | 无隔离 | 硬件级 / 系统级强隔离 | 进程级弱隔离 |
| 系统开销 | 无 | 高(完整 OS) | 极低(仅应用 + 依赖) |
| 启动速度 | 秒级(应用启动) | 分钟级(系统开机) | 秒级(进程启动) |
| 镜像大小 | 无统一镜像 | GB 级 | MB 级 |
| 资源利用率 | 极低 | 中等 | 极高 |
| 适用场景 | 单应用、高性能需求 | 强隔离、多 OS 需求 | 微服务、云原生、快速迭代 |
特性
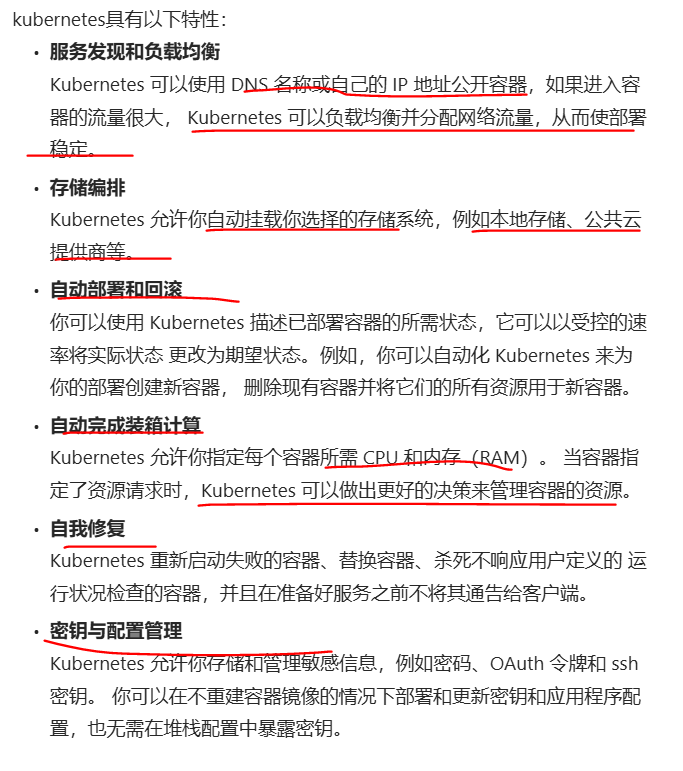
kubernetes 为你提供了一个可弹性运行分布式系统的框架。 Kubernetes 会满足你的扩展要求、故障转移、部署模式等。 例如,Kubernetes 可以轻松管理系统的 Canary 部署。
架构
工作方式
Kubernetes Cluster = N Master Node + N Worker Node:N主节点+N工作节点; N>=1
组件架构
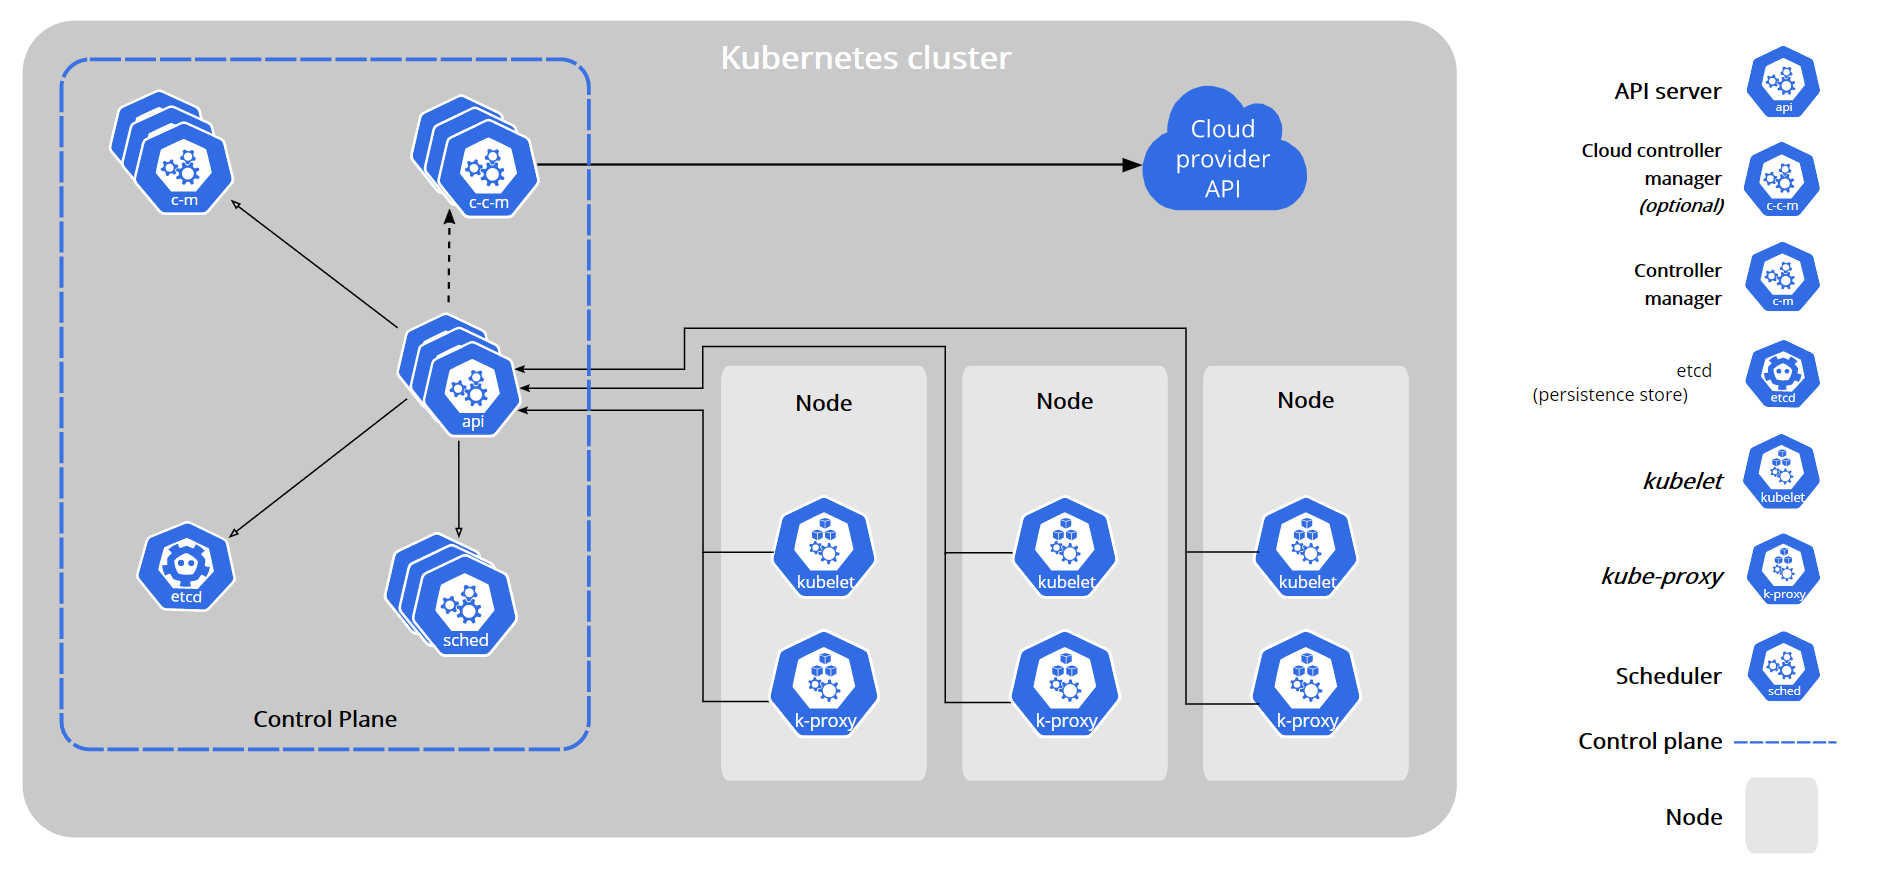
Control Plane Components
控制平面组件概述
控制平面的组件对集群做出全局决策(比如调度),以及检测和响应集群事件(例如,当不满足部署的 replicas 字段时,启动新的 pod)。
控制平面组件可以在集群中的任何节点上运行。 然而,为了简单起见,设置脚本通常会在同一个计算机上启动所有控制平面组件, 并且不会在此计算机上运行用户容器。
kube-apiserver
API 服务器是 Kubernetes 控制面的组件, 该组件公开了 Kubernetes API。 API 服务器是 Kubernetes 控制面的前端。
Kubernetes API 服务器的主要实现是 kube-apiserver。 kube-apiserver 设计上考虑了水平伸缩,也就是说,它可通过部署多个实例进行伸缩。 你可以运行 kube-apiserver 的多个实例,并在这些实例之间平衡流量。
etcd
etcd 是兼具一致性和高可用性的键值数据库,可以作为保存 Kubernetes 所有集群数据的后台数据库。
你的 Kubernetes 集群的 etcd 数据库通常需要有个备份计划。
kube-scheduler
控制平面组件,负责监视新创建的、未指定运行节点(node)的 Pods,选择节点让 Pod 在上面运行。
调度决策考虑的因素包括单个 Pod 和 Pod 集合的资源需求、硬件/软件/策略约束、亲和性和反亲和性规范、数据位置、工作负载间干扰和最后时限。
kube-controller-manager
在主节点上运行控制器的组件。
从逻辑上讲,每个控制器都是一个单独的进程, 但是为了降低复杂性,它们都被编译到同一个可执行文件,并在一个进程中运行。
这些控制器包括:
- 节点控制器(Node Controller): 负责在节点出现故障时进行通知和响应
- 任务控制器(Job controller): 监测代表一次性任务的 Job 对象,然后创建 Pods 来运行这些任务直至完成
- 端点控制器(Endpoints Controller): 填充端点(Endpoints)对象(即加入 Service 与 Pod)
- 服务帐户和令牌控制器(Service Account & Token Controllers): 为新的命名空间创建默认帐户和 API 访问令牌
cloud-controller-manager
云控制器管理器是指嵌入特定云的控制逻辑的控制平面组件。 云控制器管理器允许您链接集群到云提供商的应用编程接口中, 并把和该云平台交互的组件与只和您的集群交互的组件分离开。
cloud-controller-manager 仅运行特定于云平台的控制回路。 如果你在自己的环境中运行 Kubernetes,或者在本地计算机中运行学习环境, 所部署的环境中不需要云控制器管理器。
与 kube-controller-manager 类似,cloud-controller-manager 将若干逻辑上独立的控制回路组合到同一个可执行文件中,供你以同一进程的方式运行。 你可以对其执行水平扩容(运行不止一个副本)以提升性能或者增强容错能力。
下面的控制器都包含对云平台驱动的依赖:
- 节点控制器(Node Controller): 用于在节点终止响应后检查云提供商以确定节点是否已被删除
- 路由控制器(Route Controller): 用于在底层云基础架构中设置路由
- 服务控制器(Service Controller): 用于创建、更新和删除云提供商负载均衡器
Node 组件
节点组件在每个节点上运行,维护运行的 Pod 并提供 Kubernetes 运行环境。
kubelet
一个在集群中每个节点(node)上运行的代理。 它保证容器(containers)都 运行在 Pod 中。
kubelet 接收一组通过各类机制提供给它的 PodSpecs,确保这些 PodSpecs 中描述的容器处于运行状态且健康。 kubelet 不会管理不是由 Kubernetes 创建的容器。
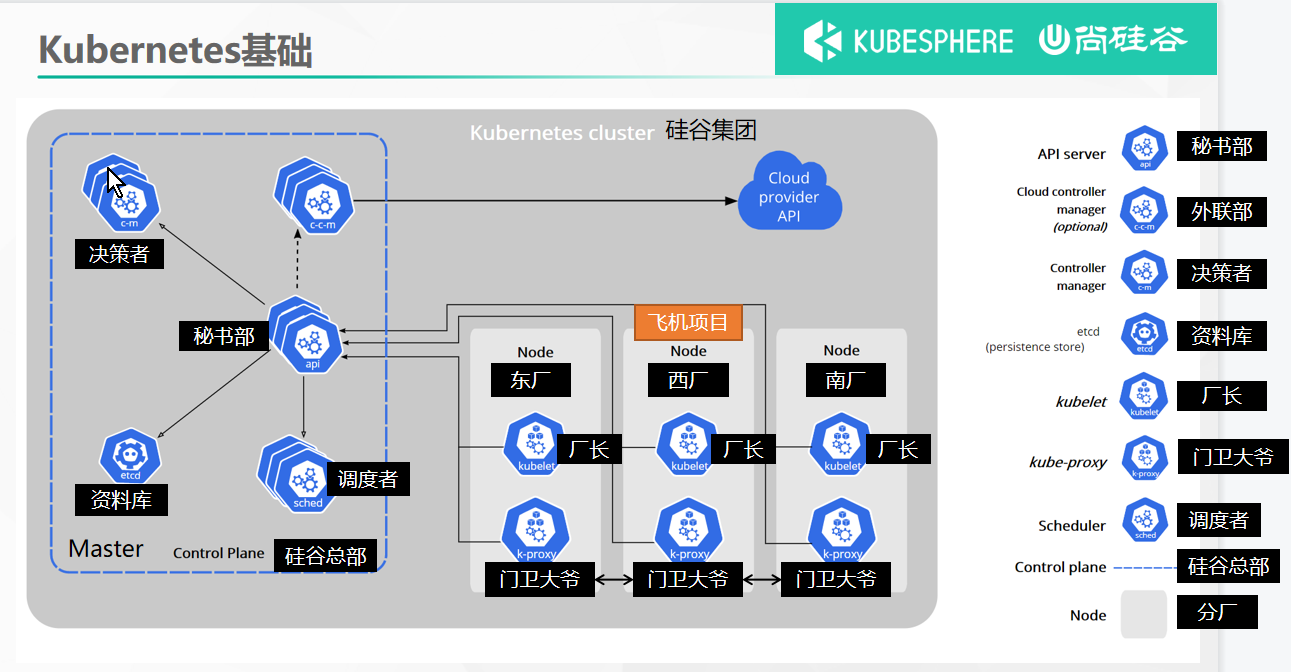
| K8s 组件 | 类比角色 | 核心职责 |
|---|---|---|
| kube-apiserver | 秘书部 | 集群入口、API 网关、认证授权 |
| etcd | 资料库 | 集群状态存储、数据一致性保障 |
| kube-scheduler | 调度者 | Pod 节点调度、资源分配 |
| kube-controller-manager | 决策者 | 集群状态监控、自动化运维、自愈 |
| cloud-controller-manager | 外联部 | 云厂商 API 对接、云资源联动 |
| kubelet | 厂长 | 节点代理、Pod 生命周期管理 |
| kube-proxy | 门卫大爷 | 节点网络规则、Service 负载均衡 |
| Master/Control Plane | 硅谷总部 | 集群管控、全局决策 |
| Node | 分厂 | 业务运行、指令执行 |
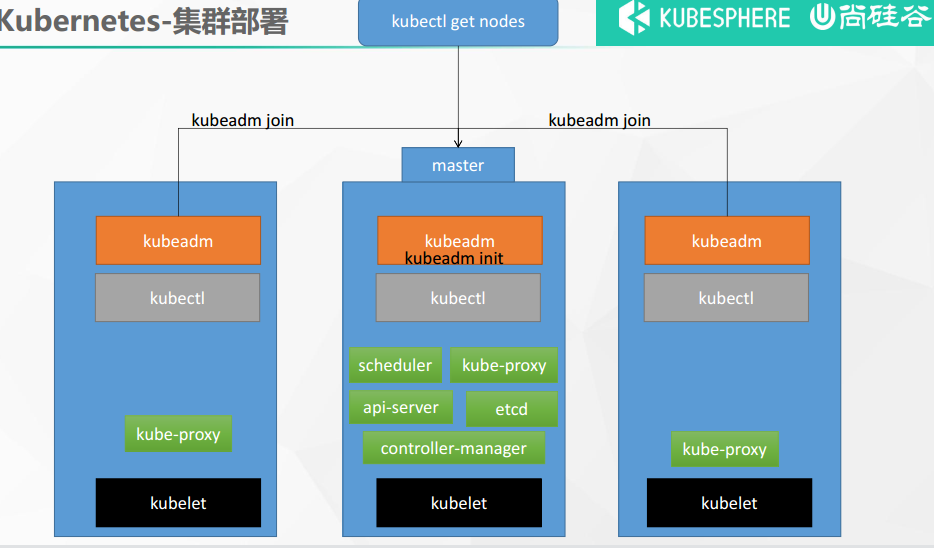
kubeadm创建集群
主从
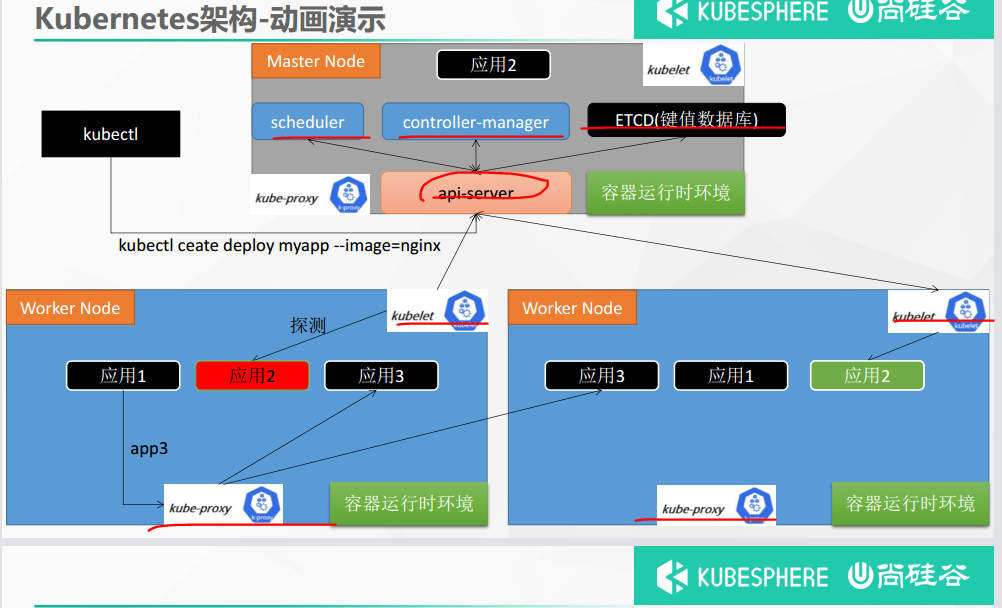
Master Node(控制平面)
Master 节点是集群的管控中心,所有调度、决策都在这里完成,核心组件如下:
| 组件 | 核心作用 | 关键细节 |
|---|---|---|
| kube-apiserver 秘书部 | 集群的「唯一入口」 | 所有操作(包括 kubectl 命令、其他组件通信)都必须通过它,是唯一能直接读写 etcd 的组件,提供 RESTful API,负责认证、授权、准入控制 |
| etcd 资料库 | 集群的「分布式数据库」 | 存储整个集群的所有状态数据(节点信息、Pod 信息、配置等),是 K8s 的「数据大脑」,保证数据一致性 |
| kube-scheduler 调度者 | 集群的「调度器」 | 负责为新创建的 Pod 选择最合适的 Worker 节点部署,会根据资源、亲和性、负载等策略调度 |
| kube-controller-manager 外联部 | 集群的「控制器管家」 | 运行各类控制器(节点控制器、副本控制器、端点控制器等),持续维护集群状态,确保实际状态与用户期望一致 |
| cloud-controller-manager(可选) | 云服务商适配组件 | 对接云厂商 API,实现云资源(负载均衡、存储、网络)的自动化管理 |
| 组件 | 核心作用 | 关键细节 |
|---|---|---|
| kubelet 厂长 | 节点的「代理管家」 | 每个 Worker 节点的核心进程,负责:1. 向 Master 汇报节点状态2. 接收 Master 指令,创建 / 启动 / 停止 Pod3. 持续监控 Pod 健康状态(存活 / 就绪探针) |
| kube-proxy 门卫 | 节点的「网络代理」 | 维护节点上的网络规则,实现 Pod 之间、Pod 与外部的网络通信,负责 Service 的负载均衡和流量转发 |
| 容器运行时(Container Runtime) | 容器的「运行引擎」 | 负责实际拉取镜像、启动 / 停止容器,常见实现:Docker、containerd、CRI-O 等 |
| Pod(应用载体) | 应用的「运行单元」 | K8s 中最小的部署单元,一个 Pod 可以包含一个或多个紧密关联的容器(图中的「应用 1/2/3」就是运行在 Pod 中) |
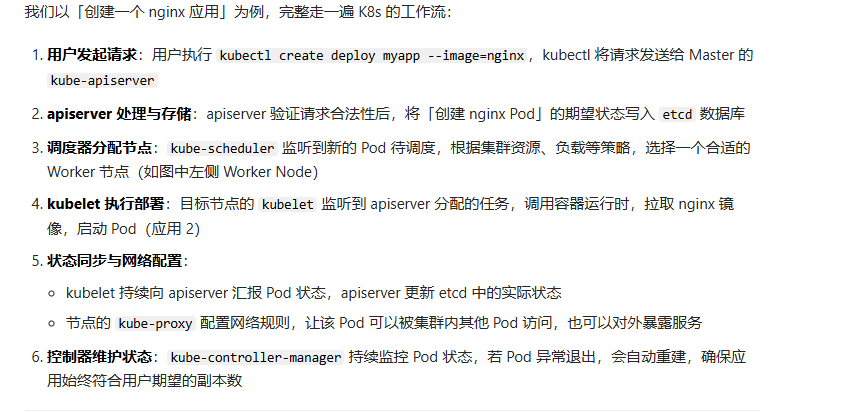
核心观念
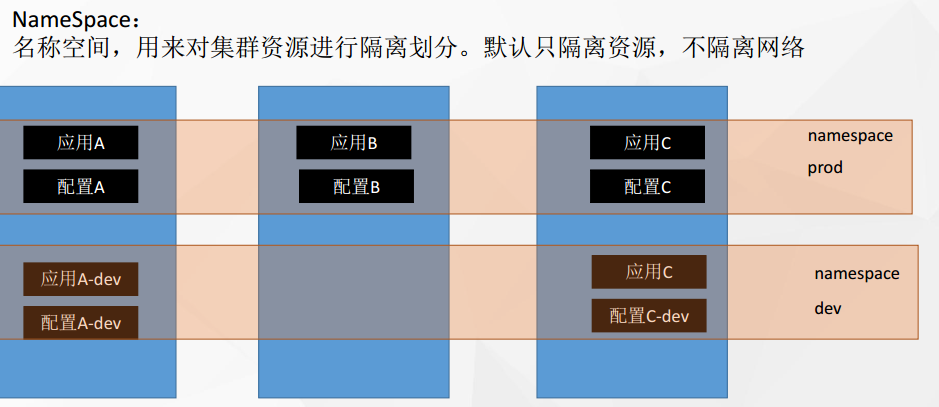
Pod
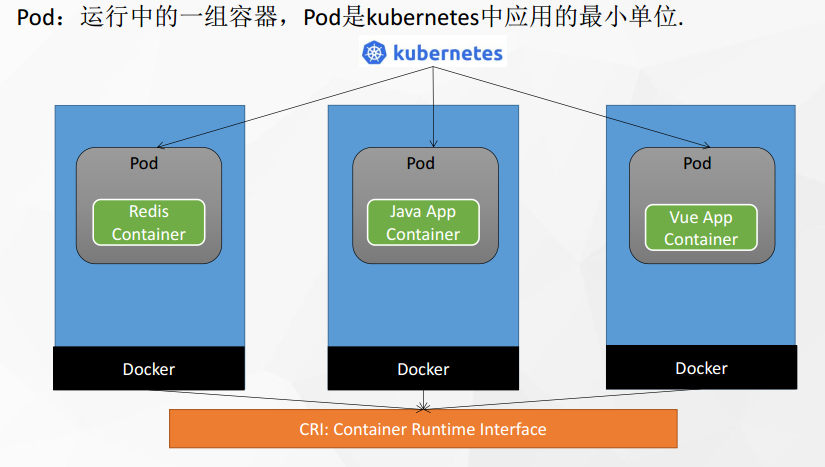
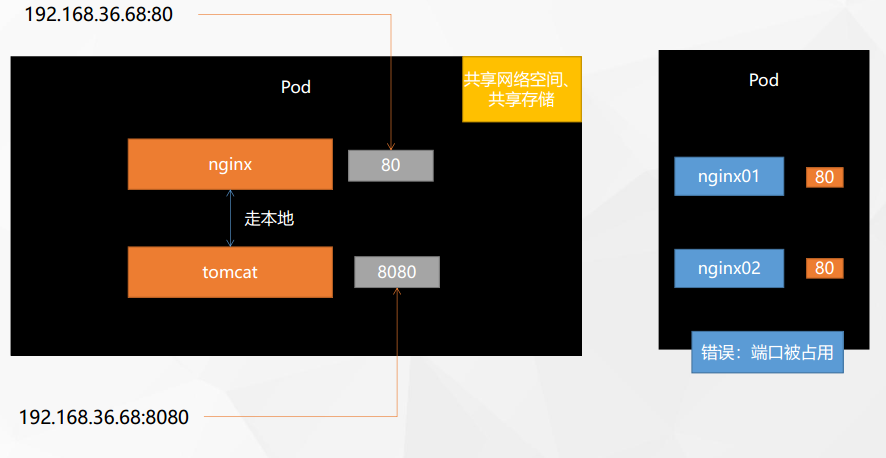
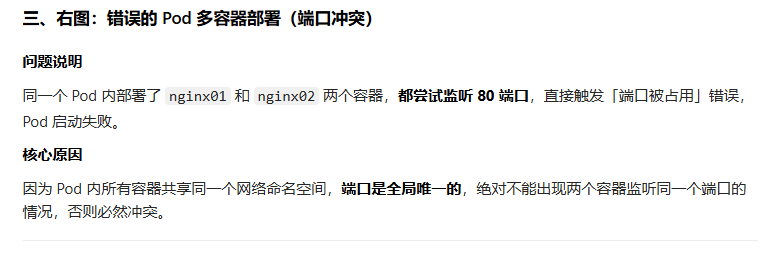
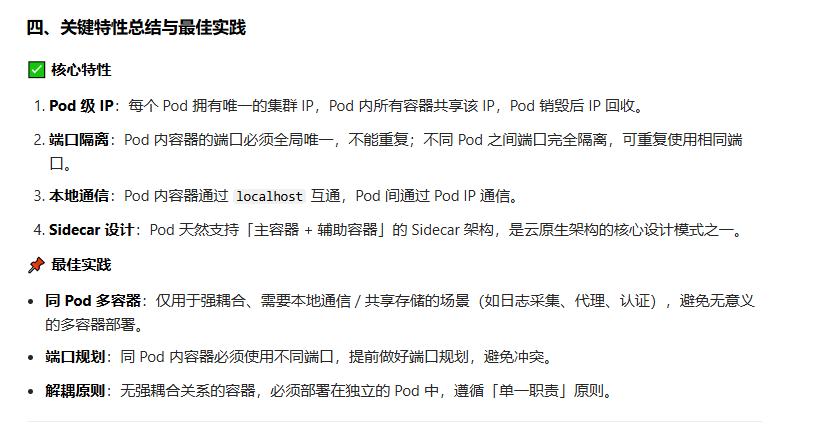
Pod 是 Kubernetes 中最小的部署单元,最核心的特性就是「共享网络命名空间 + 共享存储卷」:
- 默认遵循「一个 Pod 一个容器」:99% 的场景都应该这么做,这是 K8s 设计的初心,也是微服务的标准实践。
- 多容器仅用于 Sidecar 模式:只有当两个容器强耦合、必须同生共死、需要本地通信时,才考虑多容器,否则绝对禁止。
- 绝对避免「把多个独立应用塞进一个 Pod」:这是典型的反模式,会带来扩缩容、运维、故障恢复的一系列问题。
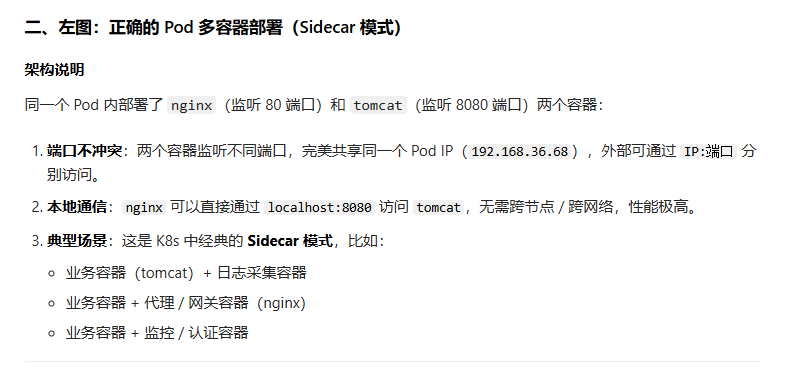
- 图中的 nginx+tomcat 是 Sidecar 模式的示例:nginx 作为代理,tomcat 作为业务容器,两者强耦合,本地通信,是合法的多容器场景;而两个 nginx 是错误的,因为是两个独立应用,端口冲突,违背设计原则
Deployment
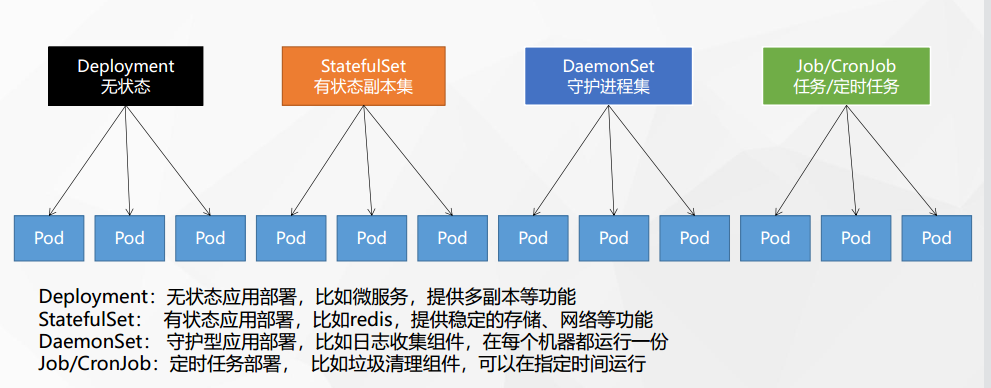
Deployment:代表一次部署,产生1个或多个Pod
Deployment:扩缩容
扩容 kubectl scale
Pod
缩容 kubectl scale
Deployment:自愈&故障转移
Deployment:滚动更新
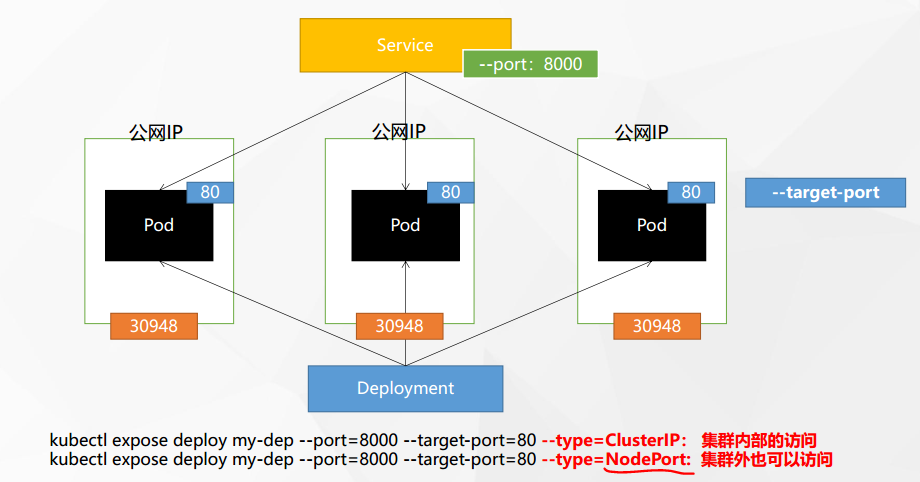
ClusterIP 模式 Service 解析
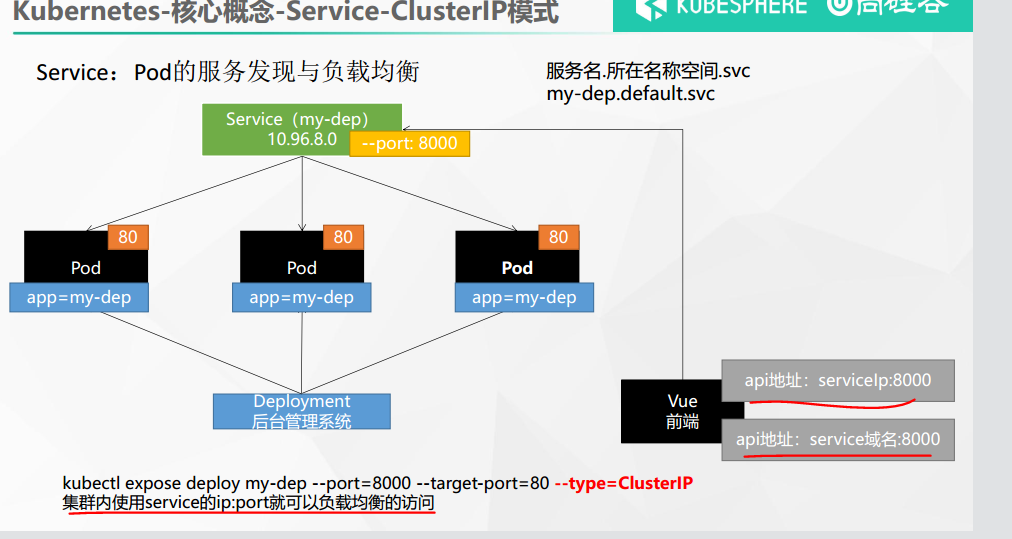
| 组件 | 作用 | 图中示例 |
|---|---|---|
| Pod | 运行应用的最小容器单元,IP 随重启 / 调度动态变化 | 3 个 app=my-dep 标签的 Pod,容器端口 80 |
| Deployment | 管理 Pod 副本的控制器,保证 Pod 数量、状态稳定 | 后台管理系统,维护 3 个 my-dep Pod |
| Service (ClusterIP) | 为 Pod 提供固定的虚拟 IP、负载均衡与服务发现 | my-dep Service,虚拟 IP 10.96.8.0,服务端口 8000 |
| K8s 核心 DNS | 为 Service 生成固定域名,实现服务名访问 | my-dep.default.svc(服务名。命名空间.svc) |
Service 类型对比
| Service 类型 | 访问范围 | 适用场景 |
|---|---|---|
| ClusterIP | 仅集群内 | 微服务内部通信(默认) |
| NodePort | 集群外通过节点 IP: 端口访问 | 临时测试、小型服务 |
| LoadBalancer | 公网访问(云厂商支持) | 生产环境对外服务 |
| ExternalName | 集群内访问外部服务 | 映射外部域名到集群内 |
kubectl expose deploy my-dep --port=8000 --target-port=80 --type=ClusterIP
expose deploy my-dep:为名为my-dep的 Deployment 创建 Service--port=8000:Service 端口--target-port=80:Pod 容器端口--type=ClusterIP:指定 Service 类型为 ClusterIP(K8s 默认类型)
- ClusterIP
- 集群内唯一默认的 Service 类型,无需额外配置即可使用
- 提供固定的访问入口,解决 Pod IP 动态变化的问题
- 内置负载均衡,自动分发流量到后端 Pod
- 支持 DNS 服务发现,微服务间通过服务名通信,解耦依赖
-
❌ 使用限制
- 仅支持集群内访问,无法直接被集群外(如公网、本地开发环境)访问
- 若需外部访问,需配合 Ingress、NodePort 或 LoadBalancer 类型 Service
# 查看 Service 信息
kubectl get svc my-dep
# 查看 Service 后端端点(关联的 Pod IP)
kubectl get endpoints my-dep
# 测试集群内访问(需在集群内 Pod 中执行)
curl my-dep.default.svc:8000
Service-NodePort
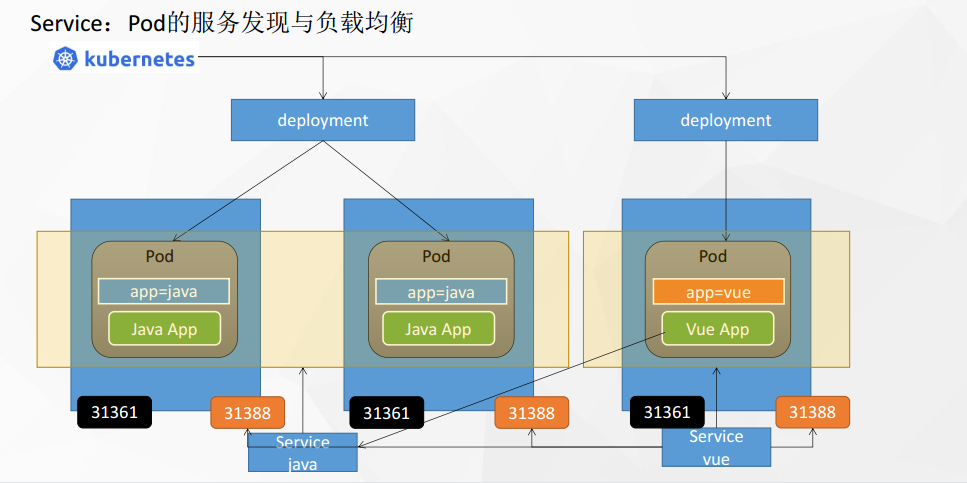
负载均衡
Ingress
Service的统一网关入口
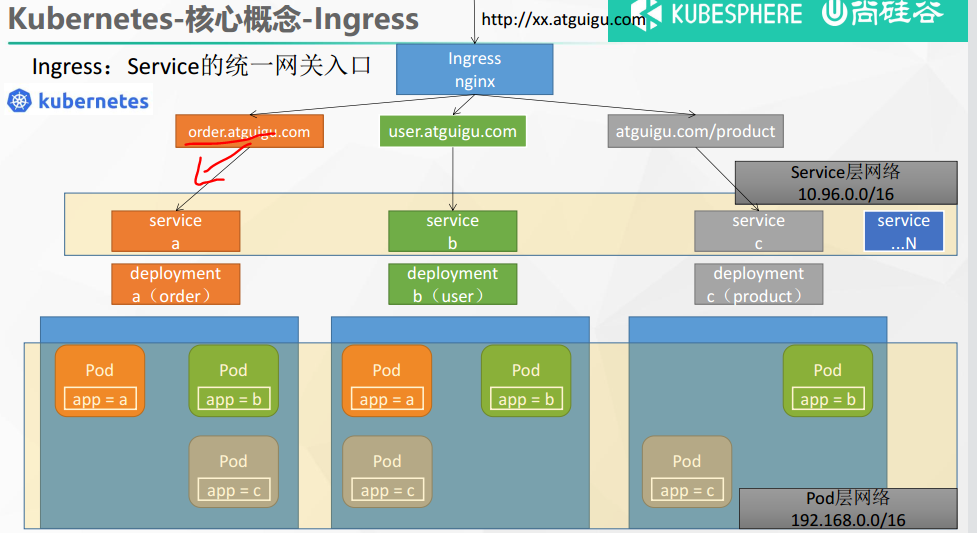
外部流量如何通过 Ingress 进入集群内部并转发给对应服务
存储抽象
K8s 中 Pod 是动态调度、随时销毁重建的,Pod 内的文件默认存在「容器可写层」,Pod 销毁后数据会彻底丢失。
- 业务需求:日志、数据库、配置文件等数据需要持久化、跨 Pod 共享、跨节点迁移。
- 解决方案:通过「存储抽象层」,把底层不同的存储系统(NFS、Ceph、GlusterFS 等)统一封装,让 Pod 用「标准接口」就能使用存储,不用关心底层是哪种存储、在哪个节点
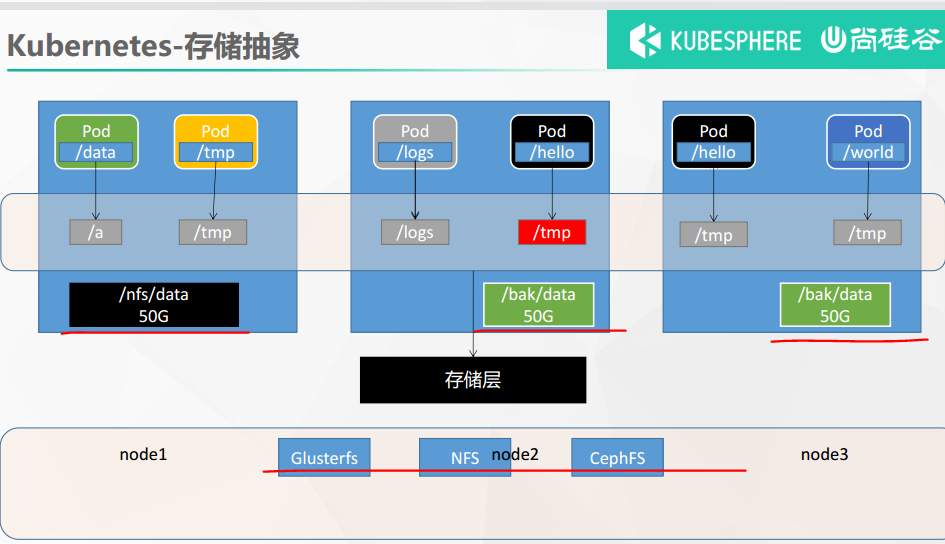
这是真正存储数据的物理 / 网络存储,K8s 通过「存储插件(CSI)」对接不同的存储系统
| 存储系统 | 特点 | 适用场景 |
|---|---|---|
| NFS | 网络文件系统,简单易用,部署成本低 | 中小集群、共享文件存储、日志存储 |
| CephFS | 分布式文件系统,高可用、可扩展、支持快照 / 配额 | 生产级大规模集群、数据库、高并发业务 |
| GlusterFS | 开源分布式文件系统,高可用、横向扩展 | 企业级共享存储、虚拟化 / 容器场景 |
NFS PV PVC
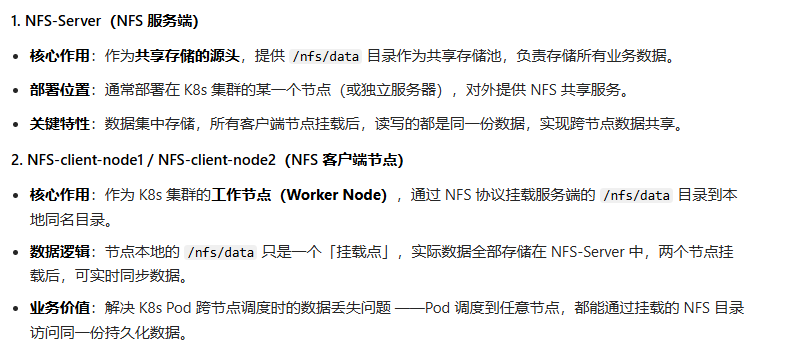
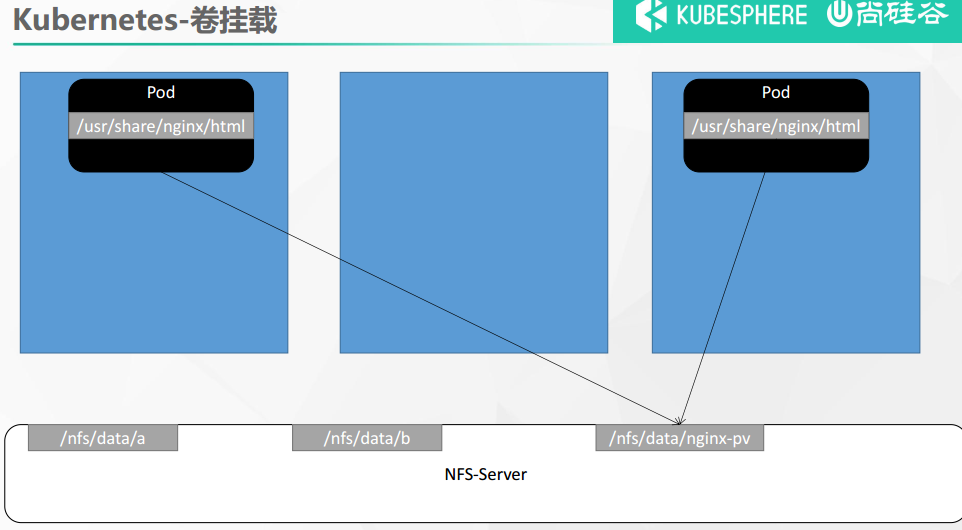
[NFS 物理存储] ←→ [PV(存储资源抽象)] ←→ [PVC(存储资源申请)] ←→ [Pod(业务应用)]
- 解耦设计:PV 是「存储池」,PVC 是「申请单」,业务(Pod)只需要通过 PVC 申请存储,完全不用关心底层是 NFS、Ceph 还是云盘;管理员只需要维护 PV,不用关心哪个业务用了存储。
- 绑定规则:K8s 会自动匹配 PVC 与 PV,匹配条件包括:存储容量、访问模式、存储类完全一致时,才会完成绑定。
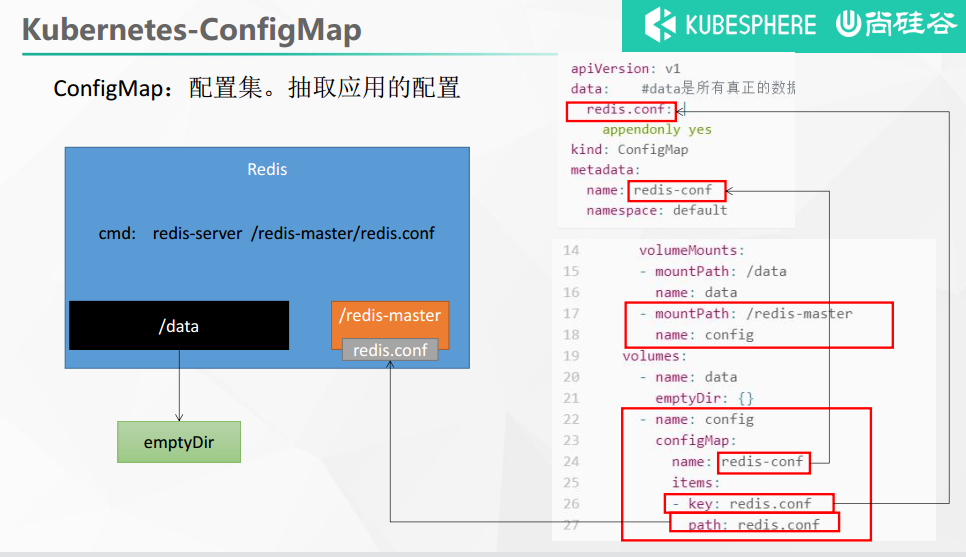
ConfigMap
ConfigMap:配置集。抽取应用的配置
Secret
更多推荐

 0
 0
- 0


 已为社区贡献12条内容

所有评论(0)