
oeasy Python 119 多维列表排序_sorted_key_lambda
·
119用lambda表达式给多维列表排序
- 这是 oeasy 系统化 Python 教程,从基础一步步讲,扎实、完整、不跳步。愿意花时间学,就能真正学会。
多维列表排序_sorted_key_lambda
回忆
- 配套视频
- 上次 我们 了解了列表的 嵌套(embedded)
- 列表项 也可以是 列表
- 可以 一直 嵌套下去
- 数字 不只是 简单的数字
- 在
结构 中的数字
- 可以 在结构中
随机
- 也可以 在结构中
排序 吗?
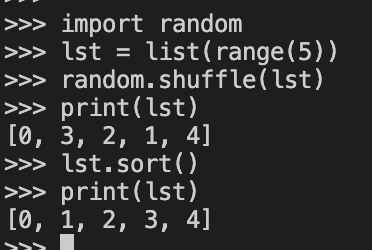
回忆排序
import random
lst = list(range(5))
print(lst)
random.shuffle(lst)
print(lst)
lst.sort()
print(lst)- 传统 排序
继续
- 构造列表
lst = [[1], [0]]
lst.sort()
lst- 真的排了
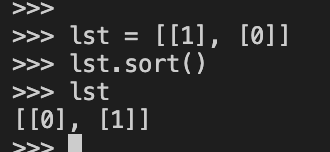
- 咋排的呢??
官方手册
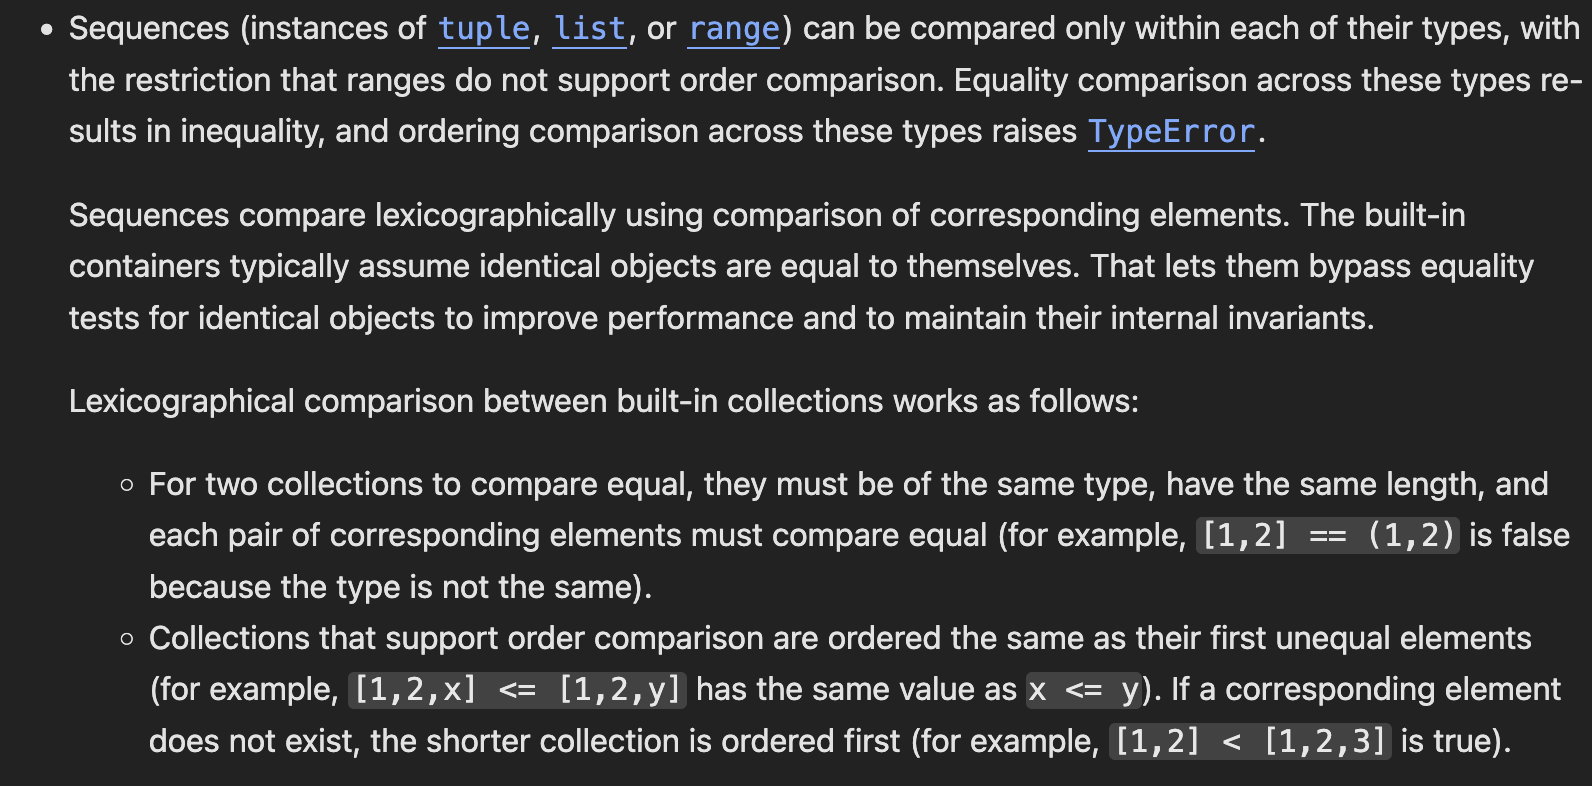
Sequences compare lexicographically ...
- lexicographically 怎么理解?
lexicographically
- lexicographically
- /ˌleksɪkəˈɡræfɪkli/
- 字典序地
|
单词 |
中文 |
|
lexicon |
词典 |
|
lexical |
词汇的 |
|
lexicology |
词汇学 |
|
lexicography |
词典编纂 |
|
lexicographer |
词典编纂者 |
|
lexicographical |
字典序的 |
|
lexicographically |
按字典序 |
- lexico - 词典编纂
|
部分 |
含义 |
作用 |
|
lexico- |
词、词汇 |
词根 |
|
-graph- |
写、记录 |
词根 |
|
-y |
名词后缀 |
表行为/学科 |
|
-ical |
形容词后缀 |
……的 |
|
-ly |
副词后缀 |
……地 |
翻译
Sequences compare lexicographically using comparison of corresponding elements.
序列的比较 字典序地进行
即依次对比 两者对应位置的 元素
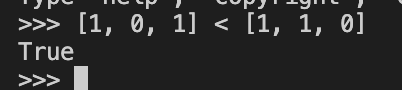
[1, 0, 1] < [1, 1, 0]- 依次对比对应位置的元素
- 先比较 第0个列表项
- 相同
- 再比较 第1个列表项
- 不相同
- 什么结构 都能排序 吗?
准备
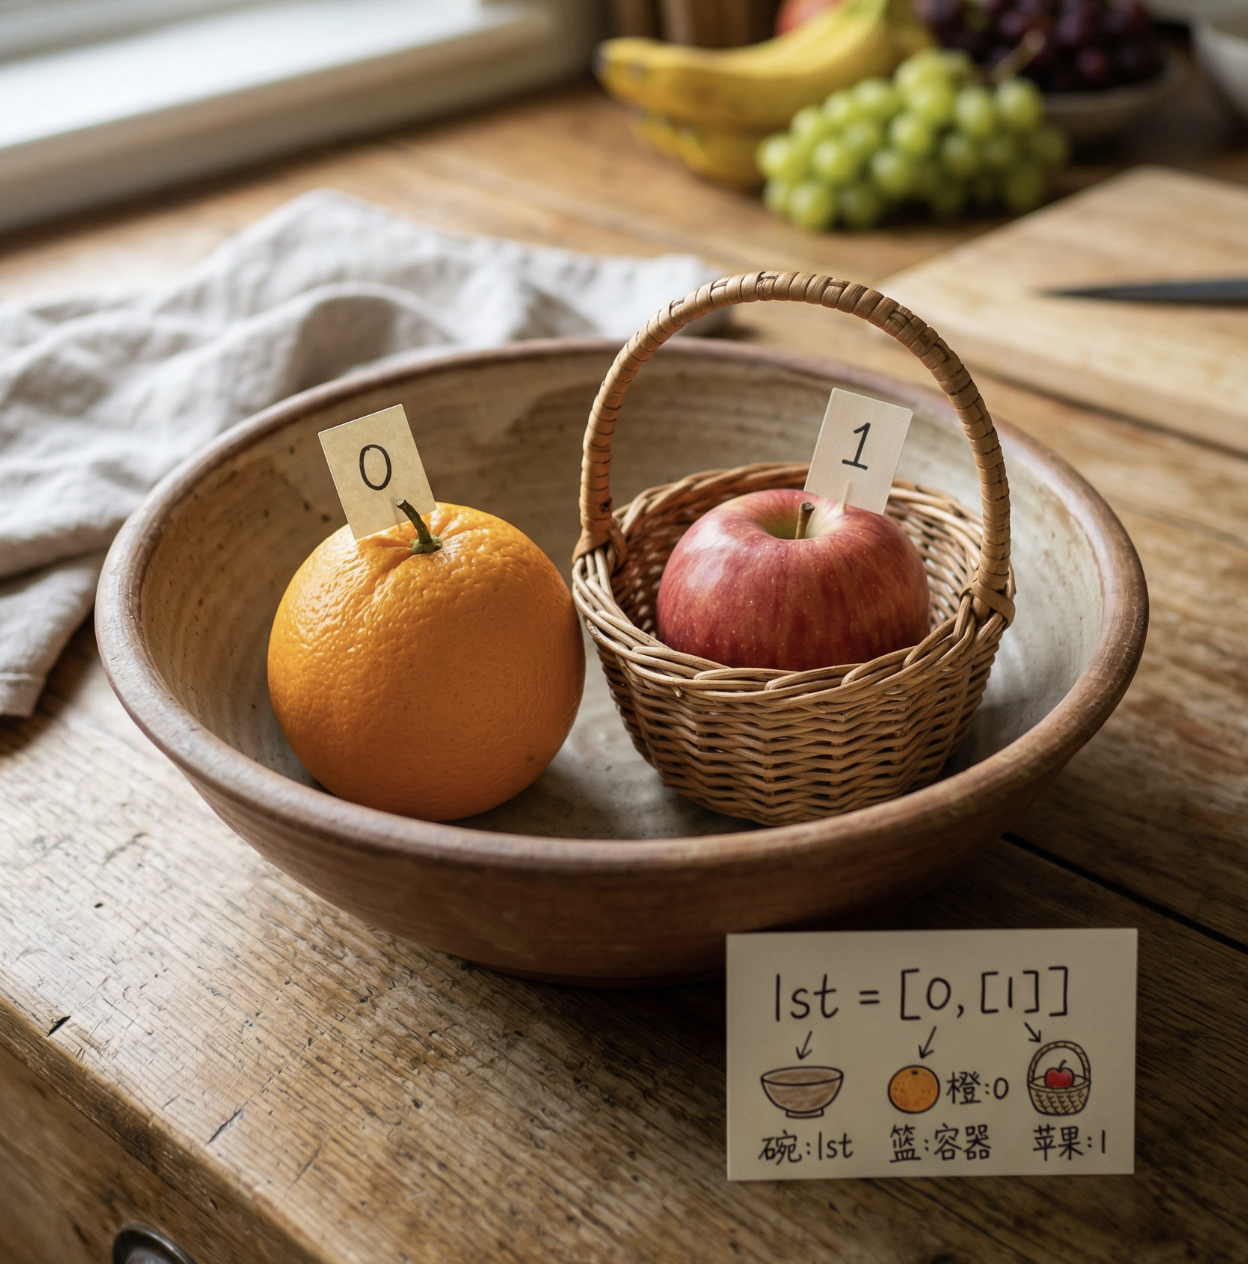
- lst 有两个列表项
- 数字0
- 列表[1]
lst = [0, [1]]
lst.sort()- 能 排序 吗?
排序前提
- 不能排序
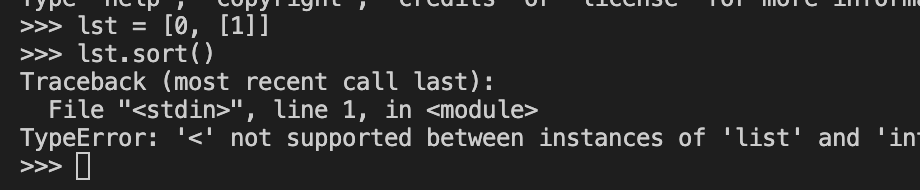
- 排序的前提
- 得能 先 比大小
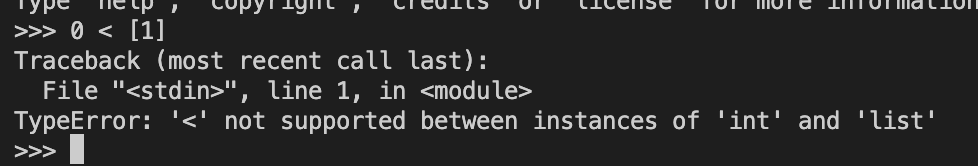
先比大小
0 < [1]- 报同样的错
-
列表型 和 整型 - 不能 比大小
- 数值 很重要
- 整体数据
结构 - 数据所在
位置 -
更重要!!!
数据结构
- 数据结构 和 位置
- 比具体的 数值 更重要
- 结构不对
- 没有 比都没法比
- 更别说排序了
- 除了 list.sort方法 之外
- 还有 什么 排序方法?
询问
- 内建函数 sorted
- 有什么
区别 来着?🤔
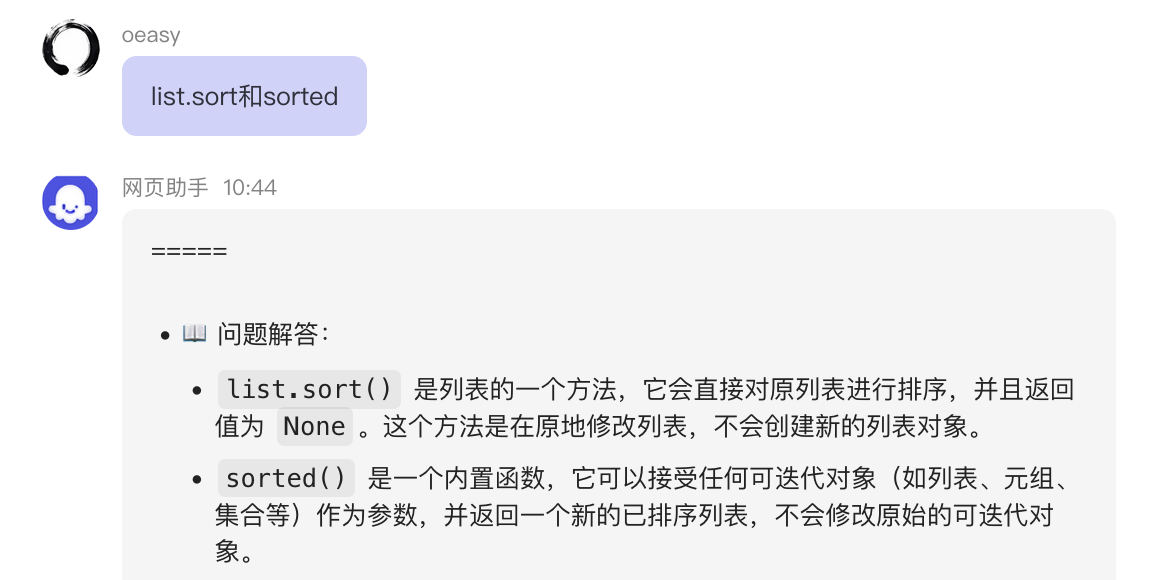
- 不同之处
- list.sort 改原列表
- sorted 是 新建列表
- 具体怎么排序?
代码
- 二维列表
- 姓名
- 数学
- 语文
student_list = [
    ["张三", 85, 92],
    ["李四", 98, 89],
    ["王五", 76, 88],
    ["赵六", 90, 95],
    ["钱七", 82, 78]
]- 想 按照 数学排序
数学 成绩
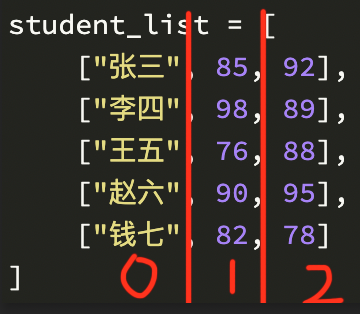
- 数学成绩
- 索引位置 为 1
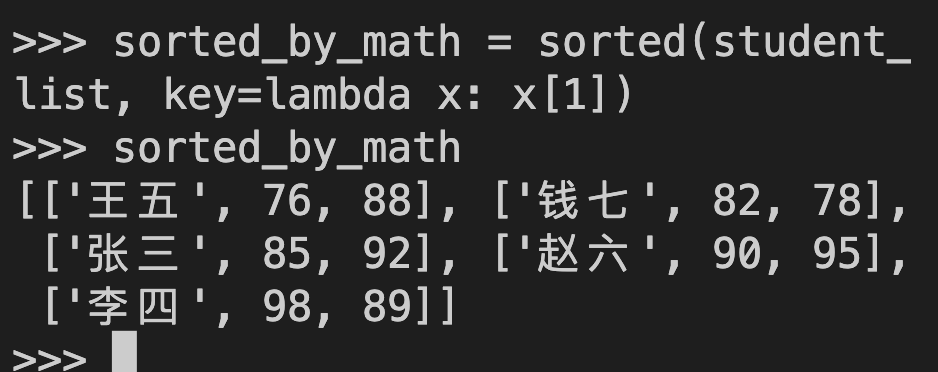
shuxue = sorted(student_list, key=lambda x: x[1])
shuxue- 排序的关键key
- 用的是 lambda
lambda x: x[1]
- 具体来说 什么是 lambda?
lambda表达式
- lambda 是
- 没有名字的临时函数
- 匿名函数
lambda x: x[1]- 适合像 排序key 这种
- 临时用一次的 简单逻辑场景
- 那 为什么叫做 lambda 呢?
lambda名字由来
- 1930 年代
- 由数学家阿隆佐・丘奇
- 提出的一套数学逻辑系统
- 核心是 “用匿名函数来表达计算逻辑”
- λ 演算
- Lambda Calculus
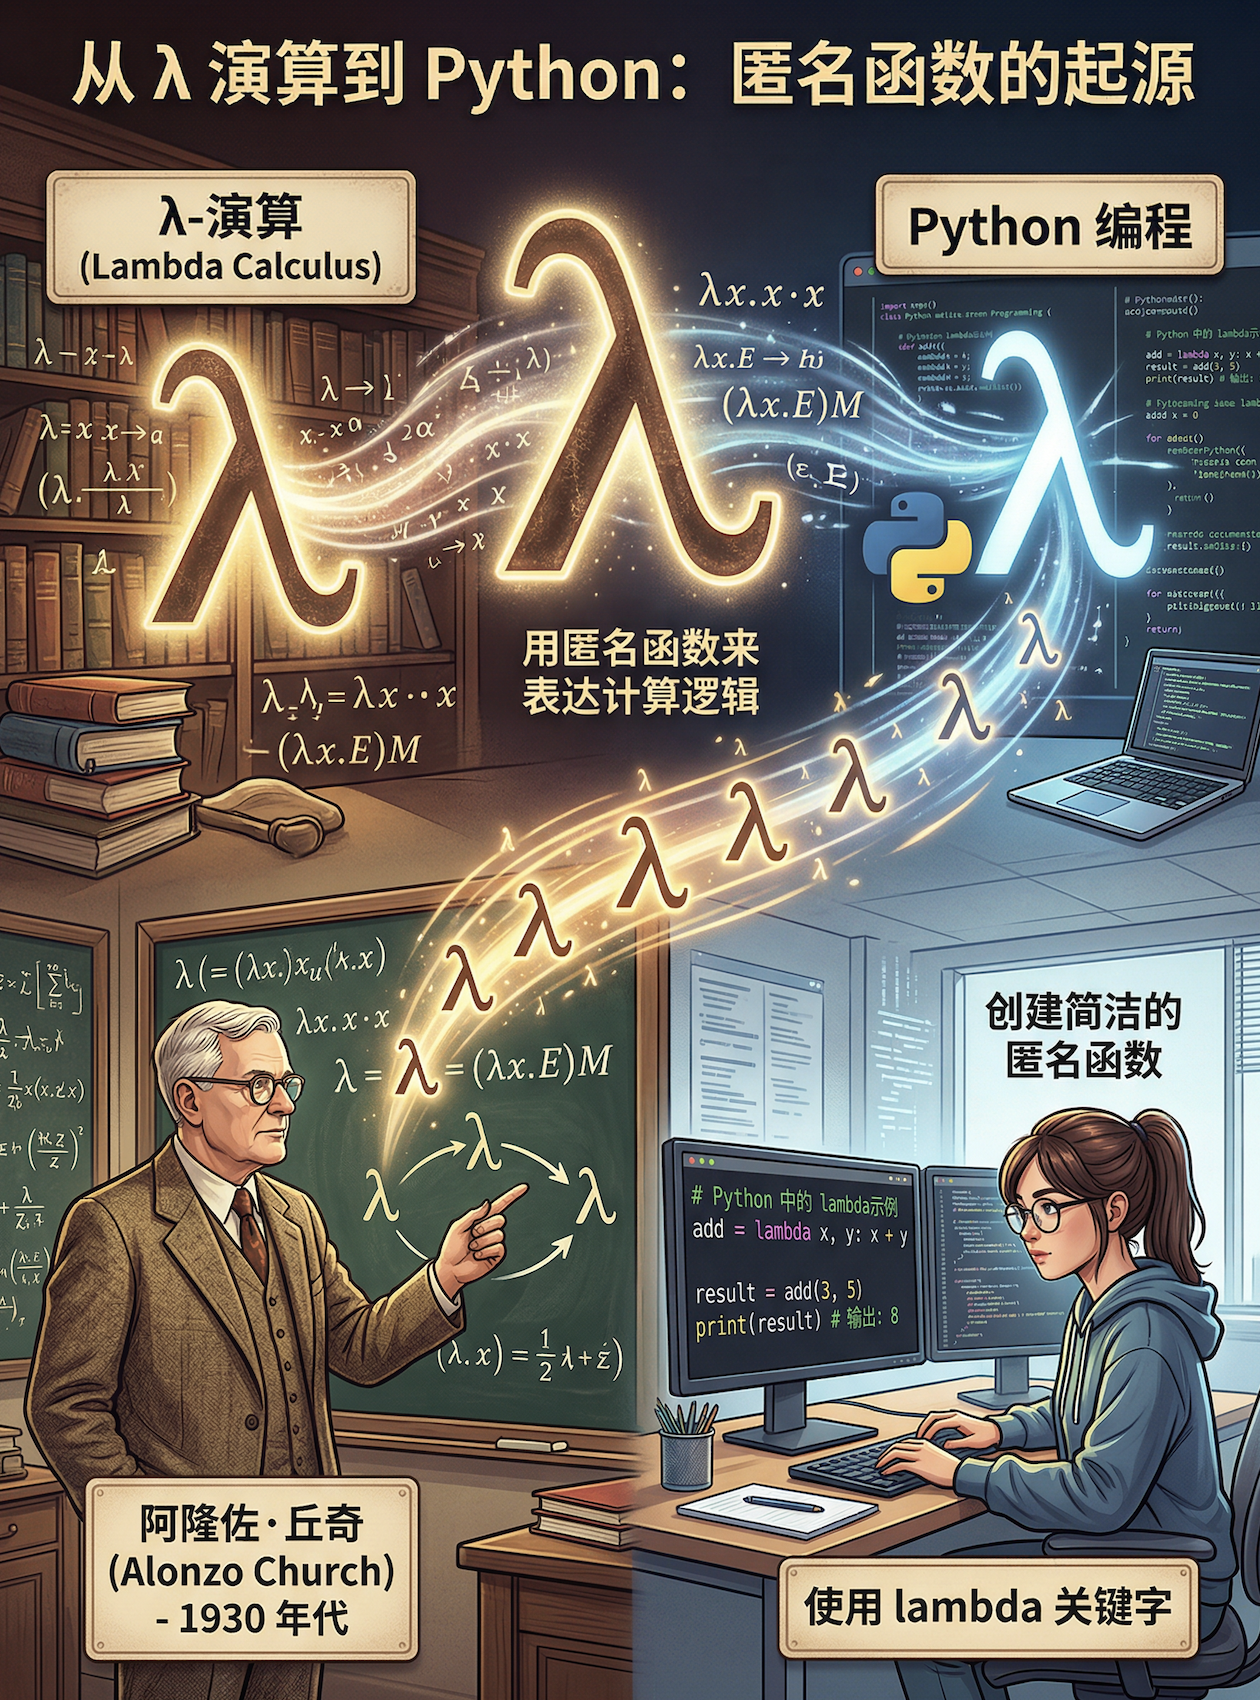
λ 演算里
- 本身就是公式
- 不用 函数名
彻底聚焦 “做什么”
而不是 “叫什么”
- 可以按照 语文成绩 排序吗?
照猫画虎
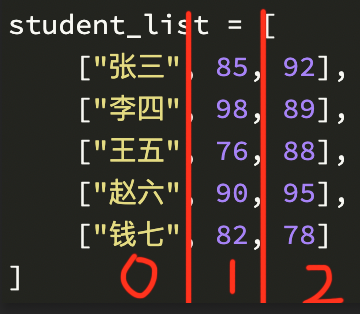
- 参考因素 修改为
- 第2项 语文成绩
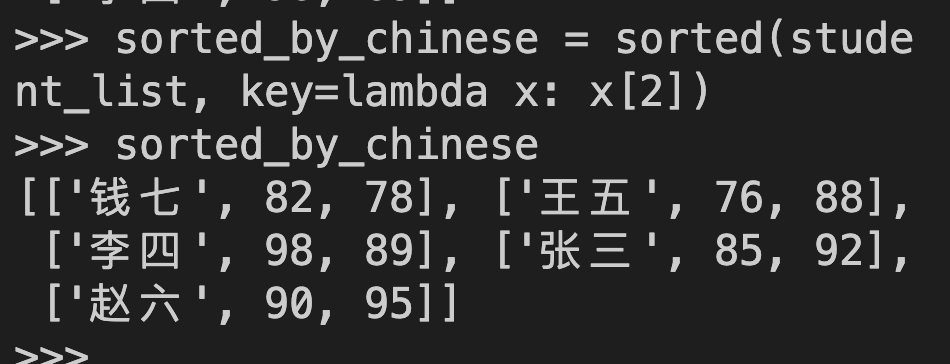
yuwen = sorted(student_list, key=lambda x: x[2])
yuwen- 效果
- 可以从 高到低吗?
reverse
help(sorted)- 查到参数
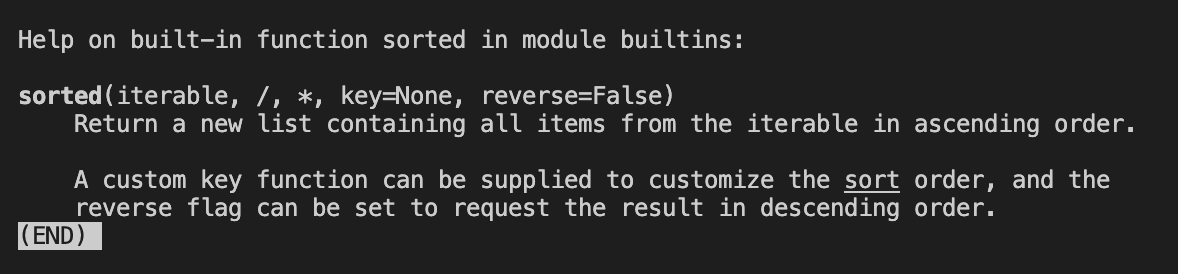
- 设置逆向
reverse=True- 从高到低
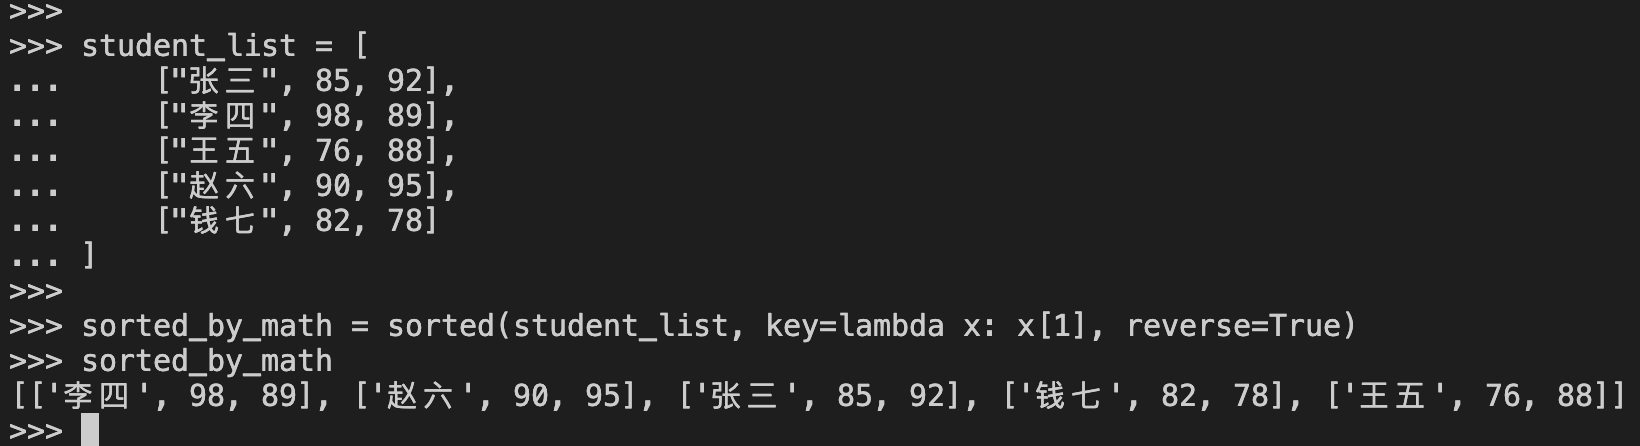
- 比较的原则是
reverse=True
- 想按平均分排序
平均分
- 平均分 = (数学 + 语文) / 2
- key=lambda x: (x[1] + x[2])/2
average = sorted(student_list, key=lambda x: (x[1] + x[2])/2, reverse=True)lambda x: (x[1] + x[2])/2
- 可以 有不同权重吗?
权重
- 按照 权重排序
- 加权分 = 数学×0.6 + 语文×0.4
- key=lambda x: x[1]*0.6 + x[2]*0.4
average = sorted(student_list, key=lambda x: x[1]*0.6 + x[2]*0.4, reverse=True)- 排序 的 核心 是 权重
反思
- 今天的 生活
- 已经离不开
- 加权排序
- 购物
- 内容推荐
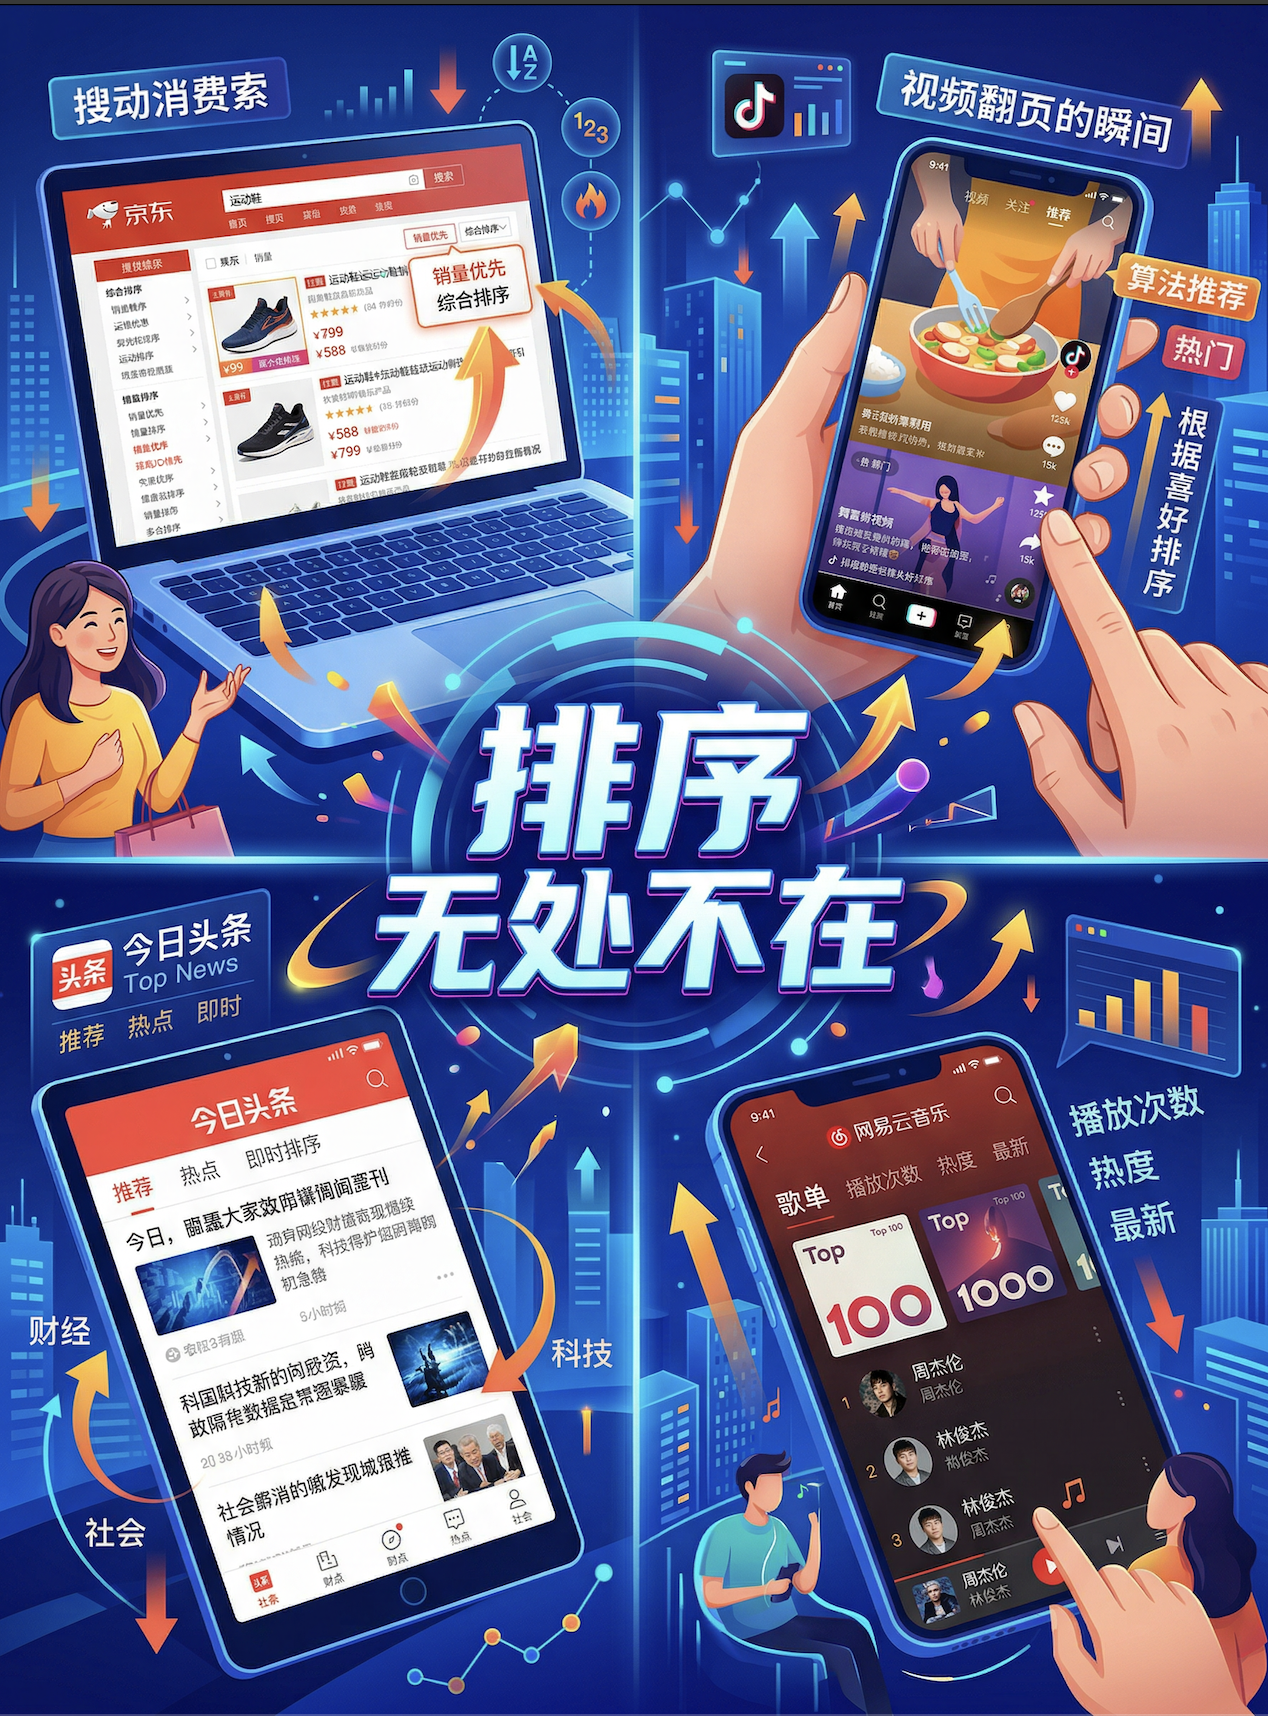
- 权重的配比 来自 lambda表达式
- 可以 按姓名 排序 吗?
姓名排序
pip install pypinyin pypinyin[stroke] # 安装拼音库+笔画扩展- 先安装类库
student_list = [
    ["张三", 85, 92],
    ["李四", 98, 89],
    ["王五", 76, 88],
    ["赵六", 90, 95],
    ["钱七", 82, 78]
]

# 按姓名拼音精准排序
try:
    from pypinyin import lazy_pinyin

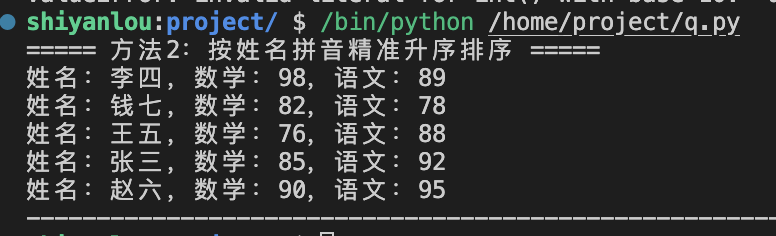
    print("===== 方法2:按姓名拼音精准升序排序 =====")
    # 按姓名的拼音字符串排序
    sorted_by_name_pinyin = sorted(student_list, key=lambda x: ''.join(lazy_pinyin(x[0])))
    for student in sorted_by_name_pinyin:
        name, math, chinese = student
        print(f"姓名:{name},数学:{math},语文:{chinese}")
except ImportError:
    print("⚠️ 未安装pypinyin库,无法执行拼音精准排序!请先执行:pip install pypinyin")
print("-" * 60)- 这次的lambda表达式
- 调用了 lazy_pinyin函数
- 还 可以 怎么排序?
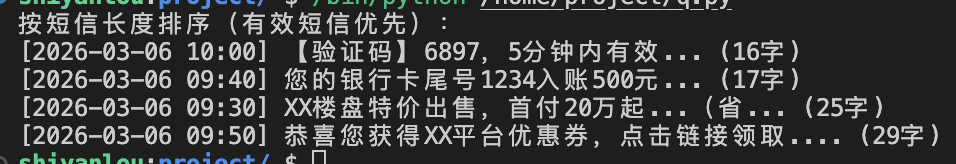
按照 字符串长度 排序
- 能 比大小
- 就能 排序
# 模拟短信数据:[内容, 发送时间]
messages = [
    ["【验证码】6897,5分钟内有效", "2026-03-06 10:00"],  # 16字
    ["恭喜您获得XX平台优惠券,点击链接领取...(省略50字)", "2026-03-06 09:50"],  # 60字
    ["您的银行卡尾号1234入账500元", "2026-03-06 09:40"],  # 18字
    ["XX楼盘特价出售,首付20万起...(省略40字)", "2026-03-06 09:30"]  # 50字
]
# 按短信内容长度升序(有效短短信在前)
sorted_messages = sorted(messages, key=lambda x: len(x[0]))
print("按短信长度排序(有效短信优先):")
for content, time in sorted_messages:
print(f"[{time}] {content[:20]}... ({len(content)}字)")- 任务达成
总结
- 这次我们 了解了 多维列表排序
- 默认是 直接比大小
- 可迭代对象students
- 对于students中的 每次迭代的x
- 可以按照 lambda表达式 排序
- 多维列表 的 赋值
- 有 什么
特点 吗??🤔
- 下次再说 👋
- 配套视频
- 本文来自 oeasy Python 系统教程。
- 想完整、扎实学 Python,
- 搜索 oeasy 即可。
更多推荐

 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)