
大模型解码:从“只顾眼前”的贪心算法,到“高瞻远瞩”的集束搜索
什么是大模型解码?
当你向 ChatGPT等大模型 提问“写一首关于夏天的诗”,它并不会像人类那样先在脑海里构思完整——而是一个字一个字地往外蹦。每生成一个汉字,模型都要计算一次整个词表的概率分布,然后决定选哪个 token(词元)。这个“决定”的过程,就是解码(Decoding)。
解码算法直接决定了生成内容的质量、多样性和速度。其中,贪心算法(Greedy Search) 和 集束搜索(Beam Search) 是最基础、最经典的两种解码算法,一个快但容易“鼠目寸光”,一个稳但需要“多算几步”。本文将介绍以上两种解码算法的原理、优缺点。
本文内容参考 大模型解码:从“只顾眼前”的贪心算法,到“高瞻远瞩”的集束搜索
自回归解码原理
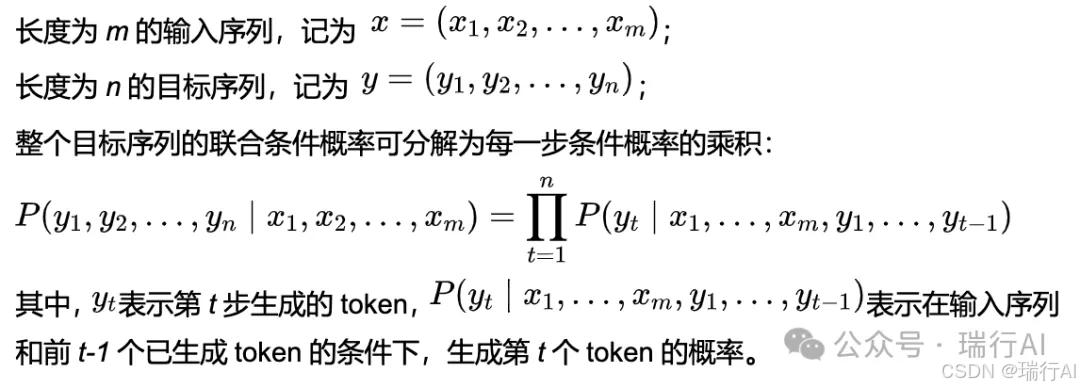
无论贪心算法还是集束搜索,均基于大模型自回归生成的核心逻辑:目标序列的生成是一个迭代过程,每一步只预测一个token,且该token的生成依赖于输入序列和已生成的所有token。其数学本质是建模“条件概率链”,即整个目标序列的联合条件概率 可分解为每一步条件概率的乘积。解码算法的差异,本质是“如何从每一步的概率分布中选择下一个token”的策略不同。
给定长度为m的输入序列,通过解码算法,生成长度为n的目标序列,计算过程如下:
贪心算法 v.s 集束搜索
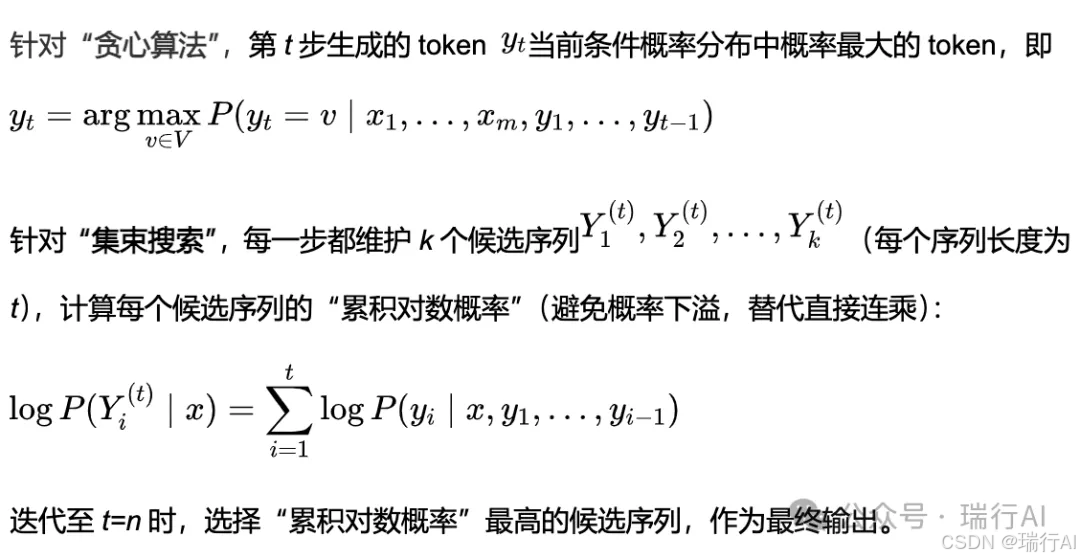
贪心算法每一步都选择当前概率最高的token,不考虑该选择对后续序列生成的影响。换句话说,它只追求“当下最优”,忽略“全局最优”,是典型的“短视”策略。适合对生成速度要求高、对生成质量要求较低的场景;缺点是容易陷入局部最优,导致生成序列重复、逻辑生硬,甚至偏离输入语义。
集束搜索每一步不只选择当前概率最高的1个token,而是保留概率最高的k个token(k称为“束宽”,beam width),将这k个token作为候选序列,继续迭代生成下一个token,最终从k个候选序列中选择全局概率最高、语义最连贯的序列作为输出。集束搜索通过保留多个候选路径,避免了贪心算法的局部最优陷阱,生成质量更高,但计算量随束宽k增大而增加(k=1时退化为贪心算法)。
图解解码过程
设定输入序列x= (机、器、学、习、的、核、心、是)(输入“机器学习的核心是”共m=8个token,生成n=4个token),下面会通过树状图演示“贪心算法”和“集束搜索”每个token的生成过程:
详细过程参考 大模型解码:从“只顾眼前”的贪心算法,到“高瞻远瞩”的集束搜索
更多推荐


 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)