
【机器学习算法】一文搞定 SVM —— 从 MMC 到 SVC,再到 SVM
参考文献:cme250_lecture5
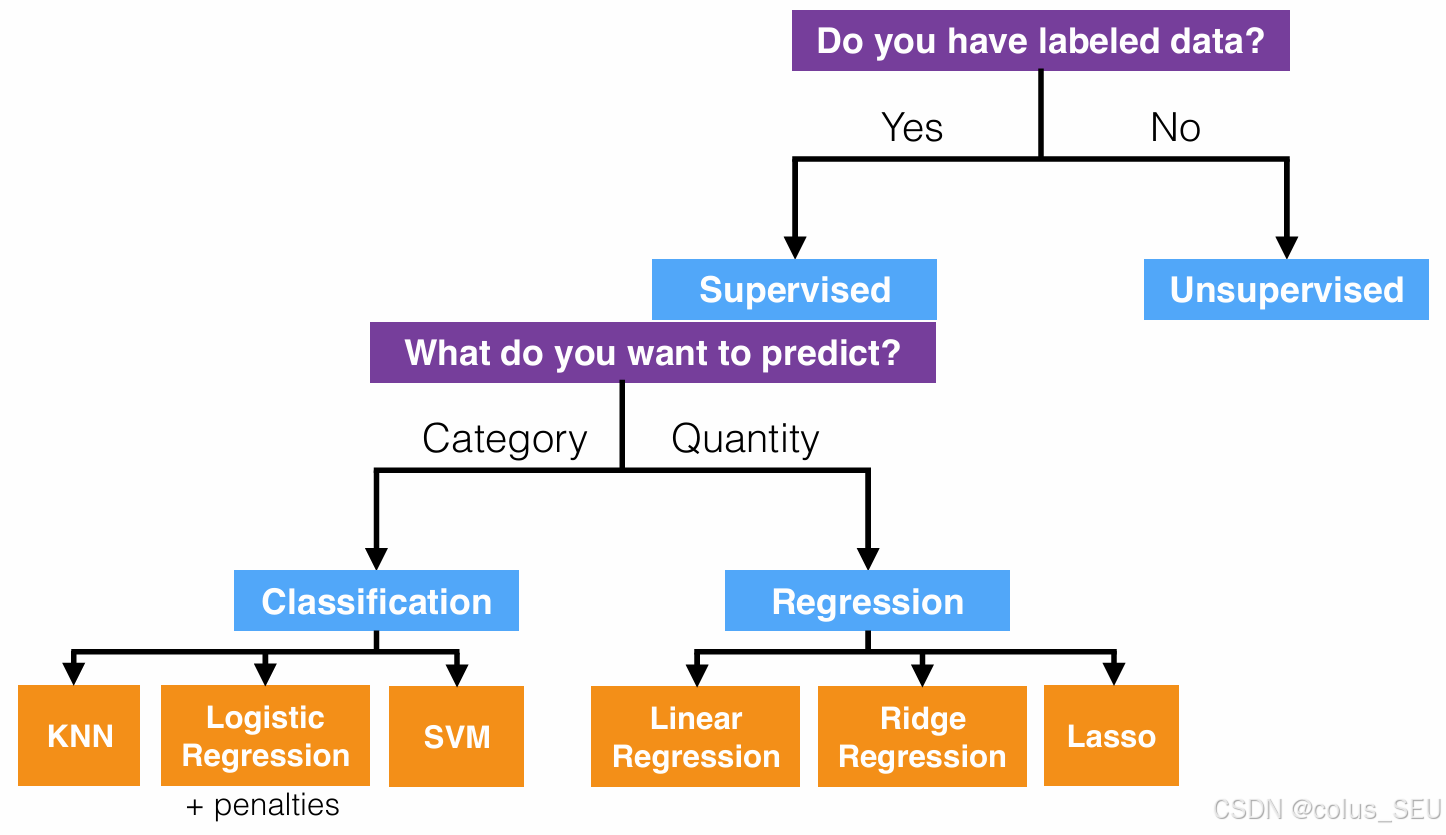
机器学习算法分类:
一、超平面(Hyperplanes)
1.1 几何定义
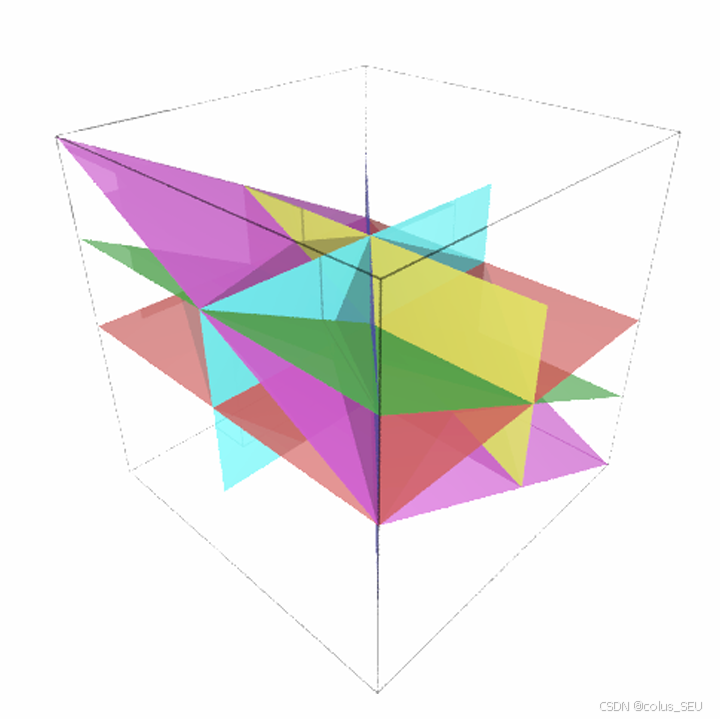
在 $p$ 维空间中,超平面是一个 $(p-1)$ 维仿射子空间(affine subspace)。
线性子空间一定要经过原点,仿射子空间则不需要。
-
在 2D 中,超平面是一个平坦的 1D 子空间,即一条直线。
-
在 3D 中,超平面是一个平坦的 2D 子空间,即一个平面。
1.2 数学定义
一个 2D 超平面(一条直线)由方程定义:
$$
\beta_0 + \beta_1 X_1 + \beta_2 X_2 = 0
$$
任何 $X = (X_1, X_2)$ 只要满足上述方程,就是超平面上的一个点。
在 $p$ 维空间中,超平面由方程定义
$$
\beta_0 + \beta_1 X_1 + \dots + \beta_p X_p = 0
$$
类似地,任何 $X = (X_1, X_2, \dots, X_p)$ 只要满足上述方程,就是超平面上的一个点。
1.3 分离超平面
不考虑超平面上的点,而是考虑满足以下条件的 $X$
$$
\beta_0 + \beta_1 X_1 + \dots + \beta_p X_p > 0
$$
该点位于超平面的一侧。对于满足以下条件的 $X$
$$
\beta_0 + \beta_1 X_1 + \dots + \beta_p X_p < 0
$$
则位于超平面的另一侧。
我们可以将超平面视为将 p 维空间分割成两半。
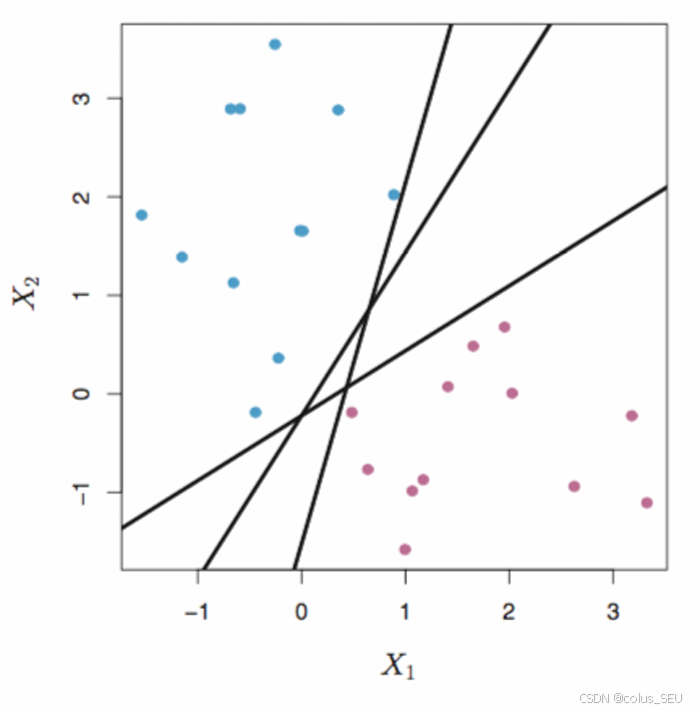
因此,我们可以使用一个超平面来进行二分类,但是显然对一组训练样本,将两类分开的超平面不止一个,那么该如何选择一个最优的超平面呢,这就引出了下一节内容:Maximal Margin Classifier(最大间隔分类器)
二、最大间隔分类器(Maximal Margin Classifier)
2.1 MMC 的理解
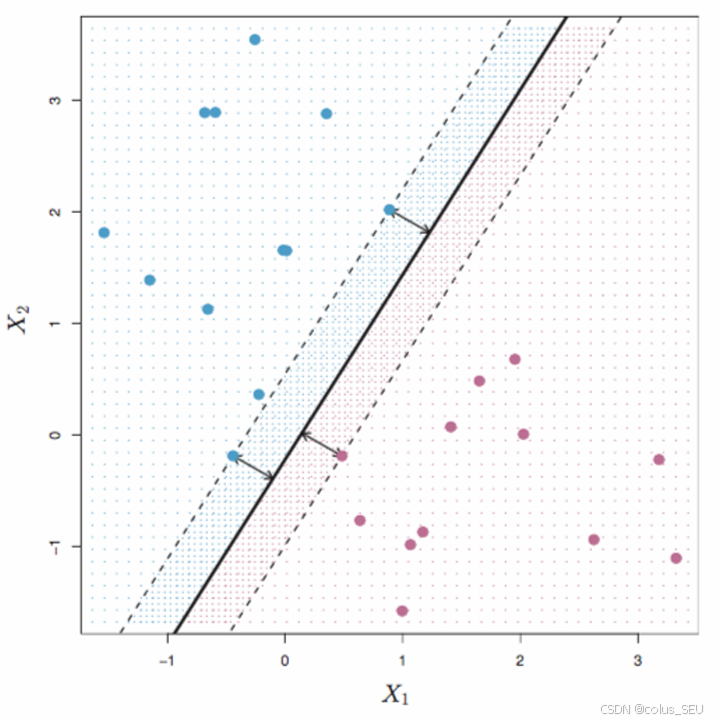
Margin:任何训练观测点与超平面之间的最小距离。
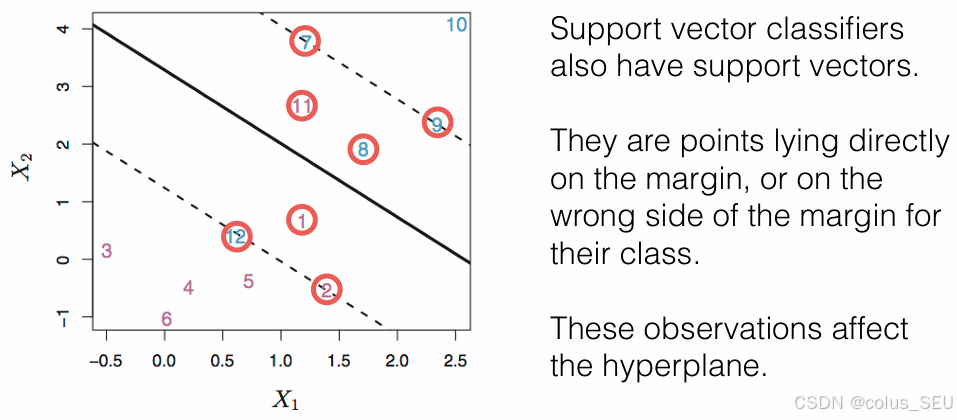
从该定义可以看出,我们并不需要用到所有的观测点,只需要用到距离分类超平面最近的点,我们称这些点为支持向量。支持向量(support vectors)到超平面的距离即为分类间隔。
如何理解‘’支持向量‘’:
支持:最大间隔超平面值取决于这些点
向量:点在高维中就是向量
2.2 MMC 的数学建模
基于观测数据 $ (\vec{x}^{(i)}, y^{(i)}), y^{(i)} \in \{-1, 1\} $,求解最大间隔超平面可以建模为以下优化问题:
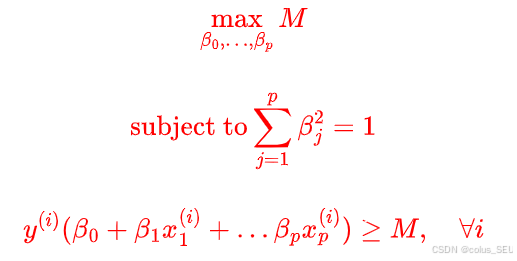
1. $ \max_{\beta_0, \dots, \beta_p} M $
表示我们要最大化间隔 𝑀,该间隔由超平面(和支持向量)决定,超平面的参数为 $ \beta_0, \dots, \beta_p $
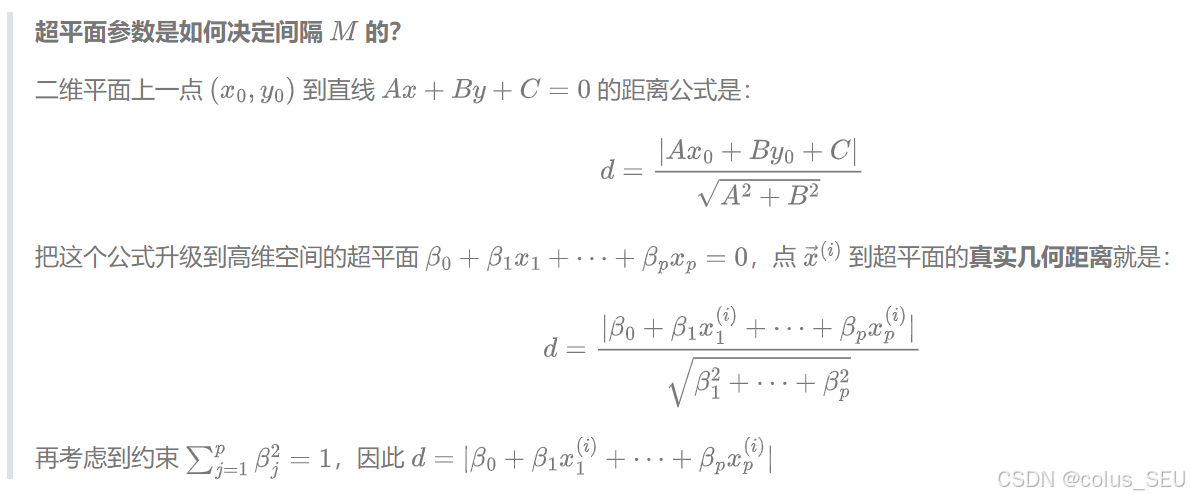
2. $ y^{(i)} (\beta_0 + \beta_1 x_1^{(i)} + \dots \beta_p x_p^{(i)}) \ge M, \quad \forall i $
这是分类正确性与间隔约束。
$\beta_0 + \beta_1 x_1^{(i)} + \dots + \beta_p x_p^{(i)}$ 是将数据点带入超平面方程的结果 。如果结果 >0,模型预测它属于一侧;如果 <0,预测属于另一侧 。
乘以 𝑦(𝑖):这是一个数学技巧。真实标签 𝑦(𝑖) 是 +1 或 −1,将它与超平面输出相乘,只要分类正确(两者同号),结果就一定是正数。
≥𝑀:这要求所有数据点都被正确分类(结果为正),且每一个(∀𝑖)数据点到超平面的距离都必须大于或等于我们设定的间隔 𝑀 。
3. $\sum_{j=1}^p \beta_j^2 = 1$
这是一个约束条件,其主要作用是防止模型将参数 𝛽𝑗 无限扩大。如果没有这个限制,模型为了最大化 𝑀,会尝试走捷径:
回顾一下约束条件 : $ y^{(i)}(\beta_0 + \beta_1 x_1^{(i)} + \dots + \beta_p x_p^{(i)}) \ge M $。我们的终极目标是:最大化 𝑀 。
假设算法非常辛苦地找到了一组参数,算出来超平面的左边式子结果是 1。那么它只能说:当前的间隔 𝑀=1。但此时,算法突然发现了一个“作弊捷径”:既然我把所有的 𝛽 放大一万倍,超平面的实际位置根本不会变(这里我们不考虑偏置 $\beta_0$ 的影响),那我干脆直接放大一万倍好了!放大后,不等式左边的结果直接变成了 10000。于是,算法高兴地宣布:在完全不移动超平面的情况下,我把间隔 𝑀 变成了 10000!
这里需要注意的是 𝑗 从 1 开始,因为 $\beta_0$ 作为偏置处理。实际上约束写成 $\sum_{j=0}^p \beta_j^2 = 1$ 也可以,分析的时候完全一样,但是后面求解的时候不方便。
2.3 MMC 的求解
我们知道 MMC 可以建模成:(记 $\beta = (\beta_1, \beta_2, ..., \beta_p)$ ,$\beta_0 = b$)
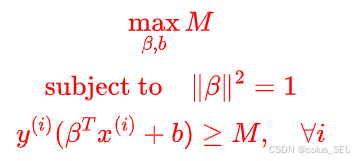
步骤 1:从直觉建模到标准“凸优化问题”的等价转化
一个优化问题是凸优化问题当且仅当其目标函数和可行域(由约束条件构成的区域)都是凸集。
注意:这个原始问题并不是凸优化问题! 因为约束条件 $ \|\beta\|^2 = 1 $ 在几何上定义的是一个球面,而球面不是凸集。
在一个集合中,任取两个点画一条线段,如果这条线段上的所有点都在这个集合内部,那么这个集合就是凸集。
球面是一个“空壳”。如果你在球面上取相对的两点,连成的线段会穿过球的内部,而球的内部并不属于“球面”这个集合。因此球面不是凸集。实心球体是凸集。
为了使用强大的凸优化数学工具,我们必须利用超平面的缩放不变性进行等价转化:
超平面的位置只由法向量的方向决定。我们可以人为地将参数 𝛽 和 𝑏 同比例缩放,强行让距离超平面最近的样本点(支持向量)满足:
$$ y^{(i)}(\beta^T x^{(i)} + b) = 1 $$
此时,几何间隔变成了 $ M = \frac{y^{(i)}(\beta^T x^{(i)} + b)}{\|\beta\|} = \frac{1}{\|\beta\|} $ 。最大化 𝑀,等价于最小化 ∥𝛽∥。为了求导方便,我们将其转化为最小化 $ \frac{1}{2}\|\beta\|^2 $。
转化后的标准 MMC 优化问题:
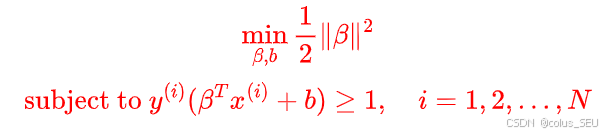
✅ 严格的凸优化判定:
-
目标函数: $ f(\beta) = \frac{1}{2}\|\beta\|^2 $ 是一个严格凸函数。
-
约束条件: $ 1 - y^{(i)} (\beta^T x^{(i)} + b) \le 0 $ 是线性的不等式约束,在 𝛽,𝑏 构成的参数空间中由不同的数据点 (𝑥(𝑖),𝑦(𝑖)) 定义了多个半空间(Half-spaces),半空间的交集必是凸集。
一个超平面把整个空间一分为二,其中的一半就叫半空间。显然,半空间是天然的凸集。
由定理:任意多个凸集的交集,依然是凸集。我们得到半空间的交集必是凸集。
结论:这是一个标准的“凸优化问题”,局部极小值即为全局唯一最小值。
步骤 2:构造拉格朗日函数 (Lagrangian)
为了处理不等式约束,我们引入拉格朗日乘子 $ \alpha_i \ge 0 $。为每一个样本点 𝑖 的约束分配一个 $ \alpha_i \ge 0 $,将其作为惩罚项加入目标函数中:
$$ \mathcal{L}(\beta, b, \alpha) = \frac{1}{2} \|\beta\|^2 - \sum_{i=1}^N \alpha_i \left[ y^{(i)}(\beta^T x^{(i)} + b) - 1 \right] $$
展开括号:
$$ \mathcal{L} = \frac{1}{2} \|\beta\|^2 - \sum_{i=1}^N \alpha_i y^{(i)} \beta^T x^{(i)} - b \sum_{i=1}^N \alpha_i y^{(i)} + \sum_{i=1}^N \alpha_i \tag{1} $$
步骤 3:求解对偶问题 (Dual Problem)
对偶函数是拉格朗日函数关于主变量的最小值。我们首先固定 𝛼,对主变量 𝛽 和 𝑏 求偏导,并令其等于 0 以求得极小值:
-
对 𝛽 求偏导:
$$ \frac{\partial \mathcal{L}}{\partial \beta} = \beta - \sum_{i=1}^N \alpha_i y^{(i)} x^{(i)} = 0 \quad \Rightarrow \quad \beta = \sum_{i=1}^N \alpha_i y^{(i)} x^{(i)} $$
(几何意义:最优超平面的法向量 𝛽 仅仅是部分训练样本特征的线性组合。)
-
对 𝑏 求偏导:
$$ \frac{\partial \mathcal{L}}{\partial b} = - \sum_{i=1}^N \alpha_i y^{(i)} = 0 \quad \Rightarrow \quad \sum_{i=1}^N \alpha_i y^{(i)} = 0 $$
代入回拉格朗日函数消去 𝛽 和 𝑏:
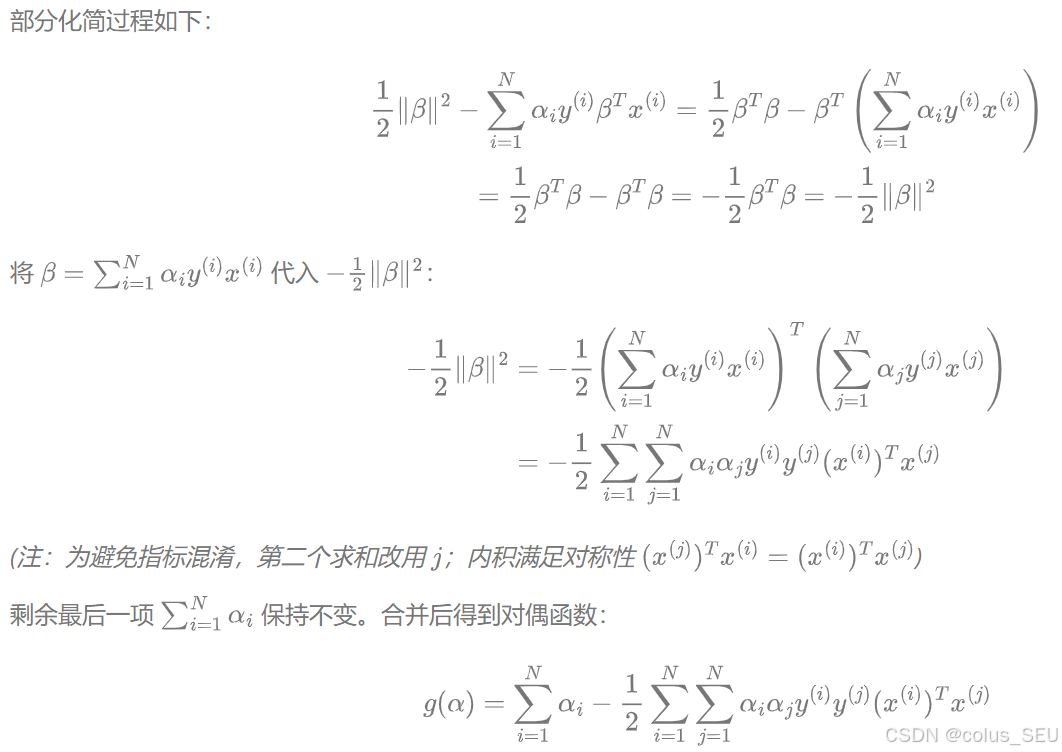
将上述两个结论代回 𝐿(𝛽,𝑏,𝛼) 中展开并化简(其中包含 𝑏 的项会因为 $ \sum \alpha_i y^{(i)} = 0 $ 而消去),最终我们将原问题转换成了只需优化 𝛼 的对偶问题:
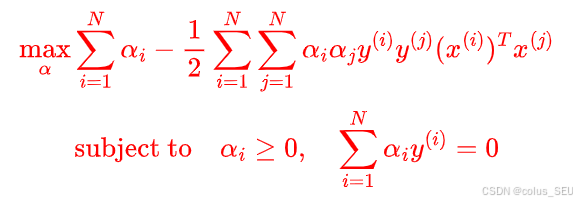
发现1
无论是目标函数还是约束条件,都只依赖于数据点之间的内积 $ (x^{(i)})^T x^{(j)} $。
发现2
我们在求导得到了 $ \beta = \sum_{i=1}^N \alpha_i y^{(i)} x^{(i)} $ 这个极其优美的公式。它说明法向量 𝛽 是数据的线性组合。但究竟是哪些数据参与了组合?
根据最优化理论,如果我们的解是全局最优的,那么它必须满足 KKT 条件(Karush-Kuhn-Tucker conditions)。其中有一条极其霸道的铁律,叫做互补松弛性(Complementary Slackness)。它规定:拉格朗日乘子 $ \alpha_i $ 与其对应的约束条件相乘,必须严格等于 0。
写成公式就是:
$$ \alpha_i \times \left[ y^{(i)}(\beta^T x^{(i)} + b) - 1 \right] = 0, \quad \forall i $$
这两个数相乘等于 0,揭示了数据点两种截然不同的命运:
-
非支持向量(安全点):如果数据点在隔离带之外(很安全),意味着 $ y^{(i)}(\beta^T x^{(i)} + b) > 1 $ 。此时方括号里的值大于 0。为了满足等式,数学法庭宣判:$ \alpha_i $ 必须等于 0!
-
支持向量(边界点):如果数据点刚好踩在隔离带虚线上,意味着 $ y^{(i)}(\beta^T x^{(i)} + b) = 1$ 。此时方括号里的值等于 0。数学法庭宣判:$ \alpha_i $ 终于允许大于 0。
物理意义升华: > 绝大多数远离边界的安全数据,它们的 $ \alpha_i =0 $。在 𝛽 的求和公式中,0×𝑥(𝑖) 直接消失了!最终,真正决定超平面方向的,仅仅只有那几个 $ \alpha_i > 0 $ 的点——它们在数学上被完美证明,就是我们在 2.1 节中定义的“支持向量”! 这也赋予了 SVM 极其强大的抗噪能力和极快的预测速度(稀疏性)。
步骤 4:凸二次规划(QP)的求解与 SMO 算法
1. 什么是二次规划(QP)问题?
如果一个数学优化问题满足以下两个条件,它就是二次规划(Quadratic Programming)问题:
-
目标函数是二次的: 变量的最高次幂为 2(如上面公式中的 $\alpha_i \alpha_j $乘积项)。
-
约束条件是线性的: 如 $\alpha_i \ge 0 $ 和 $ \sum \alpha_i y^{(i)} = 0 $ 。
由于我们这里由内积 $ (x^{(i)})^T x^{(j)} $ 构成的 Gram 矩阵是半正定的,所以这是一个凸二次规划问题,保证一定能找到全局最优解。
2. 为什么不用常规 QP 求解器?
常规的凸优化求解器(如内点法)在处理这个问题时,需要计算并存储一个大小为 𝑁×𝑁(𝑁 为样本量)的矩阵。如果你的训练集有 10 万个样本,这个矩阵将占据庞大的内存,且计算复杂度高达 $ O(N^3) $,计算机根本无法承受。
3. SVM 的专属解法:SMO 算法(序列最小最优化)
为了高效求解这个庞大的 QP 问题,John Platt 发明了 SMO (Sequential Minimal Optimization) 算法。它的核心思想是分而治之,降维打击:
-
核心矛盾: 由于存在等式约束 $ \sum \alpha_i y^{(i)} = 0 $,如果我们只改变一个 𝛼1 的值,等式就会被打破。因此,我们每次至少需要同时修改两个变量(比如 𝛼1 和 𝛼2)。
-
SMO 的策略:
-
每次循环,启发式地在所有样本中挑选出两个违反 KKT 优化条件最严重的变量 𝛼1 和 𝛼2。
-
冻结剩余所有的 𝛼(将它们视为常数)。
-
此时,原本包含 𝑁 个变量的庞大二次优化问题,瞬间坍塌成了一个只有两个变量、且带有一个线性等式约束($ \alpha_1 y^{(1)} + \alpha_2 y^{(2)} = \text{常数} $)的极小问题。
-
利用等式消元,这其实就变成了一个一元二次函数(抛物线)求极值的中学数学问题!无需复杂的矩阵运算,直接套公式就能算出 𝛼1 和 𝛼2 的解析解(然后根据 𝛼≥0 进行边界裁剪)。
-
不断重复上述“挑选两个变量 → 求解析解更新”的过程,直到所有的 𝛼 都收敛并满足优化条件为止。
-
通过 SMO 算法,SVM 完美避开了高昂的矩阵求逆运算,极其优雅且快速地解出了这个对偶 QP 问题,这也是为什么 SVM 在工业界能够大放异彩的底层算力保障。
三、支持向量分类器(Support Vector Classifer)
3.1 SVC的理解
| 图1 | 图2 |
|---|---|
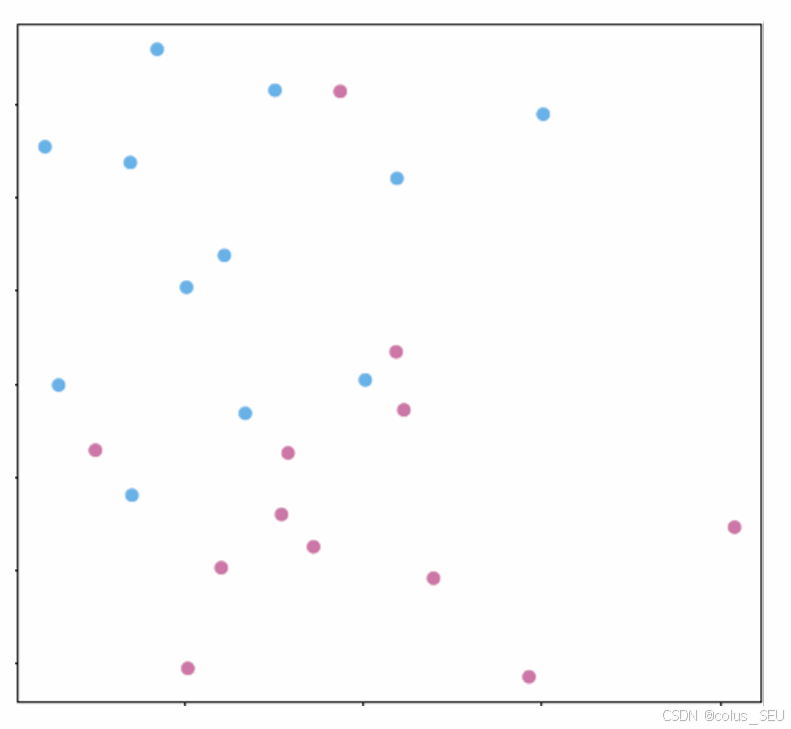 |  |
MMC 成立的前提是一个极其严苛的假设:类别必须能被一个线性的决策边界完美分开 。如图 1,当不存在分离超平面时, MMC 将会失效。即便数据真的是线性可分的,MMC 依然有很大的隐患。图 2 中展示了这样一种情况:仅仅因为在边界附近出现了一个位置稍微“突兀”的蓝点(用红圈标出),原本宽阔且合理的分类超平面就被迫发生了极其剧烈的倾斜 。这就暴露了 MMC 的致命弱点:它对个别观测数据点过于敏感 。这种被边缘异常值牵着鼻子走的特性,很容易导致模型对训练数据产生过拟合。
为了解决上述两个问题,我们需要引入支持向量分类器(SVC)。
SVC 给出的解决方案非常符合人类的哲学思维——允许犯错,适当妥协。与其死死追求一条完美的界线,SVC 允许部分训练样本出现在间隔的“错误一侧”,甚至允许它们直接越过超平面被分错类 。这种带有一定容错度的边界被称为“软间隔(Soft margin) 。如图:
3.2 SVC的数学建模
基于观测数据 $ (\vec{x}^{(i)}, y^{(i)}), y^{(i)} \in \{-1, 1\} $,求解支持向量分类超平面可以建模为以下优化问题:
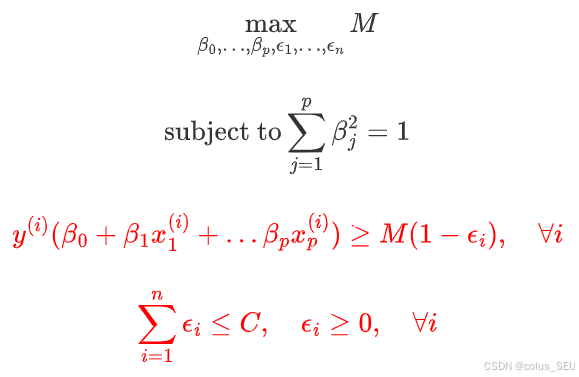
这里和 MMC 的不同之处在于:
1. 最伟大的创新:引入松弛变量 $\epsilon_i$ (Slack Variables)
$$ y^{(i)}(\beta_0 + \beta_1 x_1^{(i)} + \ldots \beta_p x_p^{(i)}) \geq M(1-\epsilon_i), \quad \forall i $$
原本在 MMC 中,等号右边是雷打不动的 𝑀。现在,我们给每一个数据点 𝑖 都配发了一张“特权卡”——松弛变量 𝜖𝑖≥0。
这张特权卡直接决定了数据点在空间中的命运,我们可以分三种情况来理解:
-
当 𝜖𝑖=0 时:等式右边依然是 𝑀。说明这个数据点是个“乖宝宝”,它老老实实地待在隔离带之外,或者刚好踩在隔离带边界上(完美满足原版 MMC 的要求)。
-
当 0<𝜖𝑖<1 时:等式右边变成了小于 𝑀 的正数。说明这个点“越界”了,它闯入了隔离带内部,但好在它还在这条虚线和中心超平面之间,没有被分错类。
-
当 𝜖𝑖>1 时:等式右边变成了负数!这是一个极其严重的警告,说明这个点不仅穿过了隔离带,还越过了中心的分类超平面,被彻底分错了类!
总结:松弛变量 𝜖𝑖 的本质,就是衡量第 𝑖 个数据点“偏离正确位置的程度”。
2. 宏观调控:预算上限 𝐶 (Budget)
$$ \sum_{i=1}^{n} \epsilon_i \leq C, \quad \epsilon_i \geq 0, \quad \forall i $$
既然有了特权卡 𝜖𝑖,那算法为了让间隔 𝑀 尽可能大,岂不是可以无限地给每个点发特权,让所有点都犯错?
为了防止模型“摆烂”,SVC 引入了最后一个约束:总预算 𝐶。
-
物理意义:你可以把 𝐶 想象成你能容忍的“总错误额度”。所有数据点的松弛程度加起来,绝对不能超过这个总额度 𝐶。
-
调参的艺术(Bias-Variance Tradeoff):
-
如果 𝐶 很小(比如接近 0):预算极低,模型对错误极其零容忍,几乎退化成了严苛的 MMC。此时隔离带会非常窄,试图完美分开训练集,导致低偏差、高方差(容易过拟合)。
-
如果 𝐶 很大:预算充足,模型变得非常宽容。它允许很多数据点闯入隔离带甚至被分错,以此来换取一个极其宽广、平稳的隔离带。此时模型不再被少数异常点带偏,呈现高偏差、低方差(更鲁棒)。
-
3.3 SVC 的求解
正如在 MMC 中一样,带有容错机制的 SVC 原始模型依然不方便直接求解,我们需要将其转化为标准的凸优化问题,并推导其对偶形式。
(注:在主流的机器学习代码实现如 scikit-learn 中,通常将容错预算 𝐶 作为惩罚项放在目标函数里。为了方便数学推导,我们采用标准的惩罚项形式。)
步骤 1:标准凸优化转化
我们将 SVC 的原问题等价转化为:
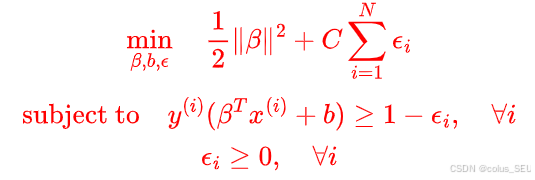
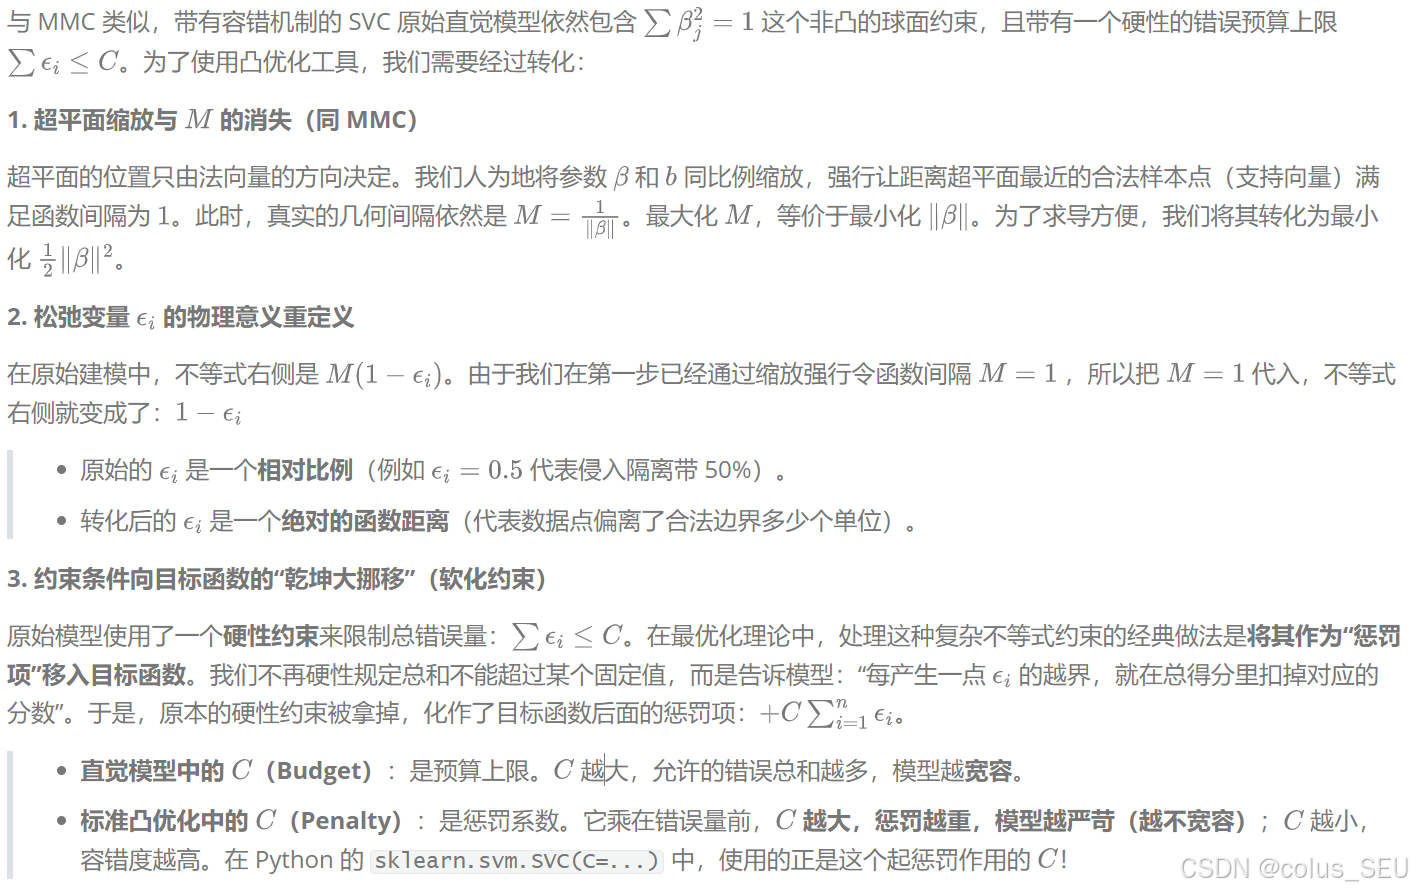
这里 𝐶 是惩罚系数。𝐶 越大,对分错的惩罚越重(越不宽容);𝐶 越小,容错度越高。该转化的推导如下:
步骤 2:构造拉格朗日函数 (Lagrangian)
因为有两组约束条件,我们引入两组非负的拉格朗日乘子:𝛼𝑖≥0 和 𝜇𝑖≥0。
$$ \mathcal{L}(\beta, b, \epsilon, \alpha, \mu) = \frac{1}{2} \|\beta\|^2 + C \sum_{i=1}^N \epsilon_i - \sum_{i=1}^N \alpha_i \left[ y^{(i)}(\beta^T x^{(i)} + b) - 1 + \epsilon_i \right] - \sum_{i=1}^N \mu_i \epsilon_i $$
步骤 3:求解对偶问题 (Dual Problem)
我们对主变量 𝛽、𝑏、𝜖𝑖 分别求偏导,并令其为 0:
-
对 𝛽 求偏导:
$$ \frac{\partial \mathcal{L}}{\partial \beta} = 0 \quad \Rightarrow \quad \beta = \sum_{i=1}^N \alpha_i y^{(i)} x^{(i)} $$
(结论与 MMC 完全一致!超平面依然是数据的线性组合。)
-
对 𝑏 求偏导:
$$ \frac{\partial \mathcal{L}}{\partial b} = 0 \quad \Rightarrow \quad \sum_{i=1}^N \alpha_i y^{(i)} = 0 $$
(结论与 MMC 依然完全一致!)
-
对 𝜖𝑖 求偏导:
$$ \frac{\partial \mathcal{L}}{\partial \epsilon_i} = C - \alpha_i - \mu_i = 0 \quad \Rightarrow \quad \alpha_i + \mu_i = C $$
因为 𝜇𝑖≥0,这个等式悄悄隐含了一个极其重要的限制:𝛼𝑖 必须小于等于 𝐶。
代回化简,见证奇迹:
现在我们把这三个结论代回拉格朗日函数 𝐿 中。
你会发现,包含 𝜖𝑖 的项变成了:∑(𝐶−𝛼𝑖−𝜇𝑖)𝜖𝑖。由于刚才求导得出 𝐶−𝛼𝑖−𝜇𝑖=0,所有的 𝜖𝑖 竟然奇迹般地全部消去了!
最终化简得到的 SVC 对偶问题为:
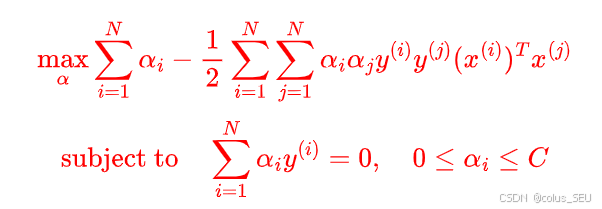
核心结论:SVC 的对偶目标函数,和 MMC 长得一模一样!
唯一不同的,仅仅是约束条件从 𝛼𝑖≥0 变成了 0≤𝛼𝑖≤𝐶。这也就意味着,SVC 同样继承了那个伟大的性质——无论是目标函数还是约束条件,依然只依赖于数据点之间的内积 $ (x^{(i)})^T x^{(j)}$ 。
3.4 SVC 的缺陷:引入 SVM
之前的 MMC 和 SVC 有一个致命的共同点:它们只能在空间中画“直”的线(或平直的超平面)。但现实世界的数据往往是非线性可分的。
想象你有一组医疗数据,你要根据 𝑋1(血压)和 𝑋2(血糖)来预测是否生病。结果画出散点图后你发现:健康的人(红点)全部集中在原点附近的一个小圆圈里,而生病的人(蓝点)像一个甜甜圈一样包围在外面。这个时候,你无论用 SVC 画出怎样倾斜的直线,都不可能把内部的圆和外部的环分开。SVC 彻底失效了。
破局之道:升维
既然在二维空间 (𝑋1,𝑋2) 里画不出曲线,数学家想出了一个极其狡猾的办法:我们不改模型,我们改数据!
我们可以人为地给数据增加新的特征维度。这些新维度是原有特征的非线性组合(比如多项式变换)。
最常见的操作是加入平方项和交叉项。我们把原本只有 2 个特征的空间,强行扩大(Expand)到一个包含 5 个特征的高维空间:
-
原始特征空间 (2D): (𝑋1,𝑋2)
-
扩大后的特征空间 (5D): $(X_1, X_2, X_1^2, X_2^2, X_1X_2) $
现在,我们把这 5 个特征喂给标准的线性 SVC。SVC 依然只懂画平直的超平面,所以它在 5 维空间里写下的超平面方程是:
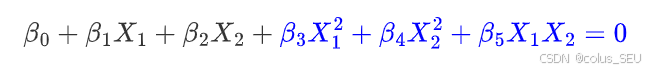
这个方程在 5 维空间里,确确实实是一个绝对平直的超平面
但是!如果我们把这个方程降维投影回原本的二维特征空间 (𝑋1,𝑋2) 去看,它是什么形状?
包含平方项和交叉项的方程,在二维平面上画出来,就是一个完美的椭圆或抛物线(非线性边界)!
核心结论:通过在低维空间中制造非线性特征(升维),我们让原本极其简单的线性 SVC 分类器,拥有了画出复杂非线性边界的超能力。这就是 Expanding Feature Space 的本质。
维度灾难
既然升维这么爽,我们为什么不无限地给数据加上 𝑋3,𝑋4 甚至更高次的特征呢?
因为算力会爆炸。
假设你原本有一张 256×256 像素的灰度图片,你的原始特征数是 𝑝=65,536。
如果你仅仅想把它扩大到包含所有二次交叉项的空间(即组合所有 𝑋𝑖𝑋𝑗),新的特征维度将暴涨到约 亿维𝑝22≈21.4 亿维!
这就产生了一个巨大的矛盾:我们极其渴望高维空间的线性可分性,但我们的计算机根本承受不了高维空间的计算量。
此时,我们在推导对偶问题时埋下的那个伏笔——对偶函数只依赖于数据点的内积 $ (x^{(i)})^T x^{(j)}$——即将在此刻爆发出最耀眼的光芒。它将引出整个支持向量机皇冠上的明珠:核技巧(The Kernel Trick),完美解决这个维度灾难。
四、支持向量机(Support Vector Machines)
4.1. 铺垫:对偶问题中的“内积”奇迹
在之前推导 SVC 的对偶问题时,我们发现了一个极其美妙的数学性质:无论是训练模型寻找 $\alpha$,还是面对新数据进行预测,算法根本不需要知道数据点的具体坐标,它只需要知道数据点之间的“内积(Inner Product)”。
对于任意两个数据点 $x^{(i)}$ 和 $x^{(j)}$,它们的线性内积定义为:
$$
\langle x^{(i)}, x^{(j)} \rangle = \sum_{k=1}^p x_k^{(i)} x_k^{(j)}
$$
最终的分类判别函数 f(x) 也可以写成仅仅依赖于内积的形式(注意,只有支持向量的 $\alpha_i > 0$):
$$
f(x) = \sum_{i=1}^n \alpha_i y^{(i)} \langle x^{(i)}, x \rangle + \beta_0
$$
推导如下:
在 SVC 的拉格朗日函数 $\mathcal{L}$ 中,我们为了求极小值,对法向量 $\beta$ 求了偏导并令其为 0:
$$
\frac{\partial \mathcal{L}}{\partial \beta} = \beta - \sum_{i=1}^n \alpha_i y^{(i)} x^{(i)} = 0
$$由此我们得到了 SVC 的一个结论:最优超平面的法向量 $\beta$ 本质上就是支持向量的线性组合:
$$
\color{blue}{\beta = \sum_{i=1}^n \alpha_i y^{(i)} x^{(i)}}
$$当我们面对一个新样本 x 时,我们原本的预测逻辑是看它在超平面的哪一侧:
$$
f(x) = \beta^T x + \beta_0
$$我们将上面那个蓝色公式里的 $\beta$ 整体代换进去:
$$
f(x) = \left( \sum_{i=1}^n \alpha_i y^{(i)} x^{(i)} \right)^T x + \beta_0
$$利用转置的分配律,把 x 乘进去:
$$
f(x) = \sum_{i=1}^n \alpha_i y^{(i)} (x^{(i)})^T x + \beta_0
$$因为 $(x^{(i)})^T x$ 就是两个向量的内积 $\langle x^{(i)}, x \rangle$,整理一下顺序得到:
$$
f(x) = \sum_{i=1}^n \alpha_i y^{(i)} \langle x^{(i)}, x \rangle + \beta_0
$$
4.2. 核技巧的数学本质 (The Kernel Trick)
核心定义: 在机器学习中,当我们谈论“支持向量机(SVM)”时,它特指使用了非线性核(Non-linear Kernel)来扩大特征空间的支持向量分类器(SVC)。
我们在“扩大特征空间”一节中提到,人为地增加多项式特征会导致维度灾难和算力爆炸。
核技巧的伟大之处在于:它提供了一种“作弊”的方法。
既然模型只需要“内积”的结果,我们能不能发明一种函数 $K(x^{(i)}, x^{(j)})$,我们只要把低维空间的两个点喂给它,它就能直接吐出这两个点在某个极高维空间里的内积结果,而我们根本不需要真的去算那些高维特征?
这个神奇的函数 K,就是核函数(Kernel Function)。
关于这个核函数的性质结论我们给一个简单证明:
我们以 RBF 核函数为例,同时假设数据最开始只有一个维度(即 x 和 z 都是标量),并且为了公式简洁,我们令 RBF 核函数中的参数 $\gamma = \frac{1}{2}$。此时,RBF 核函数的公式为:$K(x, z) = \exp\left(-\frac{1}{2}(x - z)^2\right)$
第一步:拆开平方项
我们将指数里面的完全平方公式展开:$K(x, z) = \exp\left(-\frac{1}{2}x^2\right) \cdot \exp\left(-\frac{1}{2}z^2\right) \cdot \exp(xz)$
第二步:祭出泰勒展开(核心机关)
前面两项是只跟 x 或只跟 z 有关的常数项,先不管。在高等数学中,指数函数 $e^u$ 可以用麦克劳林级数(泰勒展开的一种)展开成无穷多项的多项式:$e^u = \sum_{n=0}^{\infty} \frac{u^n}{n!} = 1 + u + \frac{u^2}{2!} + \frac{u^3}{3!} + \dots$
我们把 $u = xz$ 代入进去:$\exp(xz) = 1 + xz + \frac{(xz)^2}{2!} + \frac{(xz)^3}{3!} + \dots$
第三步:拼装出“无限维特征向量”
现在,把展开的无穷级数塞回原来的公式,并把属于 x 的部分和属于 z 的部分强行分开:
$K(x, z) = \exp\left(-\frac{1}{2}x^2\right) \exp\left(-\frac{1}{2}z^2\right) \left[ 1 \cdot 1 + x \cdot z + \frac{x^2}{\sqrt{2!}} \cdot \frac{z^2}{\sqrt{2!}} + \frac{x^3}{\sqrt{3!}} \cdot \frac{z^3}{\sqrt{3!}} + \dots \right]$
看出来了吗?中括号里的求和,完完全全就是两个向量的内积(点乘)形式:$a_1b_1 + a_2b_2 + a_3b_3 \dots$
这意味着,我们可以定义一个映射函数 $\phi(x)$,把原始的 1 维数据 x,变成一个拥有无数个维度的超级向量:
$$
\phi(x) = \exp\left(-\frac{1}{2}x^2\right) \begin{bmatrix} 1 \\ \frac{x}{\sqrt{1!}} \\ \frac{x^2}{\sqrt{2!}} \\ \frac{x^3}{\sqrt{3!}} \\ \vdots \\ \infty \end{bmatrix}
$$结论:
$$
K(x, z) = \phi(x)^T \phi(z) = \langle \phi(x), \phi(z) \rangle
$$这就完美证明了:算一个简单的 RBF 指数函数,在数学上绝对等价于“把 x 和 z 升维到包含了所有无限次幂的超级空间中,然后再做内积”。
我们将模型中所有的线性内积 $\langle x^{(i)}, x^{(j)} \rangle$ 直接替换为 $K(x^{(i)}, x^{(j)})$,SVC 就瞬间进化成了 SVM:
$$
f(x) = \beta_0 + \sum_{i=1}^n \alpha_i K(x, x^{(i)})
$$
4.3. 主流的核函数家族
PPT 中重点介绍了三种最常用的核函数,它们决定了分类边界的形状:
A. 线性核 (Linear Kernel)
$$
K(x^{(i)}, x^{(j)}) = \sum_{k=1}^p x_k^{(i)} x_k^{(j)}
$$
-
物理意义:这就是最原始的内积(没有升维)。使用线性核的 SVM,等价于标准的 SVC。它只能画出平直的超平面。
B. 多项式核 (Polynomial Kernel)
$$
K(x^{(i)}, x^{(j)}) = (1 + \sum_{k=1}^p x_k^{(i)} x_k^{(j)})^d
$$
-
物理意义:这里的 d 是多项式的最高次数(Degree)。
-
超能力:只需算这个简单的一元 d 次方公式,就等价于把特征空间扩大到了包含所有 d 次交叉项的庞大空间,并求了内积。它能在原始空间画出椭圆、抛物线等平滑的非线性边界。
C. 径向基核 (Radial Basis Function, RBF Kernel / Gaussian Kernel)
$$
K(x^{(i)}, x^{(j)}) = \exp \left( -\gamma \sum_{k=1}^p (x_k^{(i)} - x_k^{(j)})^2 \right)
$$
-
物理意义:$\gamma$ (Gamma) 是一个大于 0 的常数。括号里算的是两个点之间的欧氏距离的平方。
-
超能力 (极其恐怖):在数学分析中,将指数函数泰勒展开,会得到无穷级数。这意味着,RBF 核等价于将数据投影到了一个“无限维 (Infinite-dimensional)”的特征空间中寻找线性边界!
-
局部性:如果测试点 $x$ 距离支持向量 $x^{(i)}$ 很远,距离平方很大,加上负号求指数后 $K \approx 0$。这意味着只有距离测试点近的训练样本,才会对它的分类结果产生实际影响。
D. Sigmoid 核
$$
K(x^{(i)}, x^{(j)}) = \tanh \left( \gamma \sum_{k=1}^p x_k^{(i)} x_k^{(j)} + c \right)
$$
-
物理意义:公式中的 $\gamma$ (Gamma) 是缩放系数,c 是平移常数,$\tanh¥ 是双曲正切函数。它的物理本质是把两个数据点的线性内积结果,经过一次非线性的“S 型挤压”,映射限制在 (-1, 1) 的区间内。
-
超能力(跨界联动):它是 SVM 与人工神经网络(Neural Networks)之间的神奇桥梁!早在神经网络爆发之前,数学家们就惊奇地发现:当你为 SVM 装备了 Sigmoid 核函数时,这个 SVM 模型在数学上完全等价于一个包含单隐层的两层前馈神经网络(多层感知机 MLP)!此时,模型自动挑出的那几个“支持向量”,就精准地对应了神经网络隐藏层里的神经元节点。
-
局限性:虽然理论上很酷,但 Sigmoid 核有一个致命的缺点——它并不总是满足核函数的最高宪法“Mercer 定理”(即在某些参数下,它的 Gram 矩阵不是半正定的)。这意味着使用它时,原本完美的凸二次规划问题可能会遭到破坏,导致算法卡在局部最优解。因此在现代实际工程中,除非你要专门模拟浅层神经网络,否则大家首选的依然是极其稳定且性能恐怖的 RBF 核。
4.4. 为什么核技巧如此伟大?
-
避开维度灾难:我们用极小的计算代价(比如 RBF 只是算个欧氏距离再求个 e 的次幂),获得了在无限维空间中运算的效果。
-
非线性切割:高维空间中完美的平直超平面,投影回原始低维空间后,变成了能够极其灵活地包裹复杂数据的非线性边界。
-
计算效率:由于仅仅依赖于少数几个 $\alpha_i > 0$ 的“支持向量”,SVM 在面对非线性问题时,预测速度依然快得惊人。
五、SVM 用于多分类问题
SVM 在其底层数学建模时,其标签 $y^{(i)} \in \{-1, 1\}$,因此它本质上是一个二分类器(Binary Classifier)。但是现实任务(如手写体识别、图像分类)往往包含多个类别。
为了让 SVM 能够处理 K 个类别($K > 2$)的问题,学术界和工业界通常采用“拆分法”,即将多分类任务拆解为多个二分类任务的组合。最主流的方法有三种:
5.1 一对一 (One-Versus-One, OvO)
-
核心思想:在 K 个类别中,两两配对构建分类器。
-
模型数量:需要训练 $C_K^2 = \frac{K(K-1)}{2}$ 个独立的 SVM 二分类器。例如有 10 个类别,就需要训练 45 个分类器。
-
训练与预测:
-
训练:每个分类器只用这两个类别的数据进行训练,完全忽略其他类别的数据。
-
预测(投票制):面对一个未知新样本,让这 $\frac{K(K-1)}{2}$ 个分类器全部分类一遍,每个分类器都会投出一票。最后,得票数最多的那个类别即为最终预测结果。
-
-
优缺点:优点是每个分类器训练时使用的数据量很少,训练速度可能较快;缺点是分类器数量随类别数呈平方级增长。
5.2 一对多 (One-Versus-All, OvA / One-Versus-Rest, OvR)
-
核心思想:每次将其中一个类别作为正类,其余所有类别合并作为负类,构建分类器。
-
模型数量:只需要训练 K 个 SVM 分类器。
-
训练与预测:
-
训练:第 k 个分类器致力于将第 k 类与“非 k 类”分开。
-
预测(看置信度):将新样本输入到这 K 个分类器中,会得到 K 个决策函数值 $f_k(x) = \beta_k^T x + b_k$。这个值代表了点到超平面的有向距离,也就代表了置信度。我们选择 $f_k(x)$ 取值最大的那个类别作为最终结果。
-
-
优缺点:优点是分类器数量少;缺点是训练时正负样本极度不平衡(比如 10 个类,正负样本比例是 1:9)。
5.3 有向无环图法 (Directed Acyclic Graph, DAG-SVM)
-
核心思想:结合了 OvO 的训练优势和决策树的测试优势。它构建一个如同“淘汰赛”般的倒三角有向无环图。
-
模型数量:与 OvO 一样,训练 $C_K^2 = \frac{K(K-1)}{2}$ 个两两组合的二分类器。
-
训练与预测:
-
训练:同 OvO 完全一致。
-
预测(淘汰制):从倒三角的根节点(比如“类1 vs 类K”)开始测试。如果分类器判定样本不是类K,则类K 被彻底淘汰。顺着连线进入下一层节点,继续在剩余类别中两两对决。因为每一次判定都能绝对淘汰一个类别,所以面对 K 个类,只需要进行 K-1 次分类测试,就能到达叶子节点得出唯一结果。
-
-
优缺点:
-
优点:预测速度极快!将 OvO 的 $O(K^2)$ 测试时间缩短到了 $O(K)$;同时完美解决了 OvO 的“投票平局”问题。
-
缺点:存在错误累积(一失足成千古恨)风险。如果在上层节点分类器判断失误,把正确的真实类别淘汰了,后续的节点将再也没有机会纠正这个错误。因此,通常需要把区分度最高、最容易分类的节点放置在 DAG 图的顶层。
-
(注:在 scikit-learn 的 SVC 中,默认的多分类策略是 OvO;而在 LinearSVC 中,默认策略是 OvR。)
推荐阅读
SVM 资源汇总-CSDN博客https://blog.csdn.net/colus_SEU/article/details/160014354?spm=1001.2014.3001.5501 https://blog.csdn.net/colus_SEU/article/details/160014354?spm=1001.2014.3001.5501SVM 的终极视角:合页损失函数 (Hinge Loss) 与正则化-CSDN博客https://blog.csdn.net/colus_SEU/article/details/160017458?spm=1001.2014.3001.5501
更多推荐


 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)