
复杂流程调用大模型技巧
复杂流程调用大模型技巧
比如酒店AI客服,有订房业务、订餐业务、订票业务、客房服务业务,如果我们把所有业务办理的规则,都放在一个提示词里面,会导致提示词非常长,大模型处理慢,消耗token多。
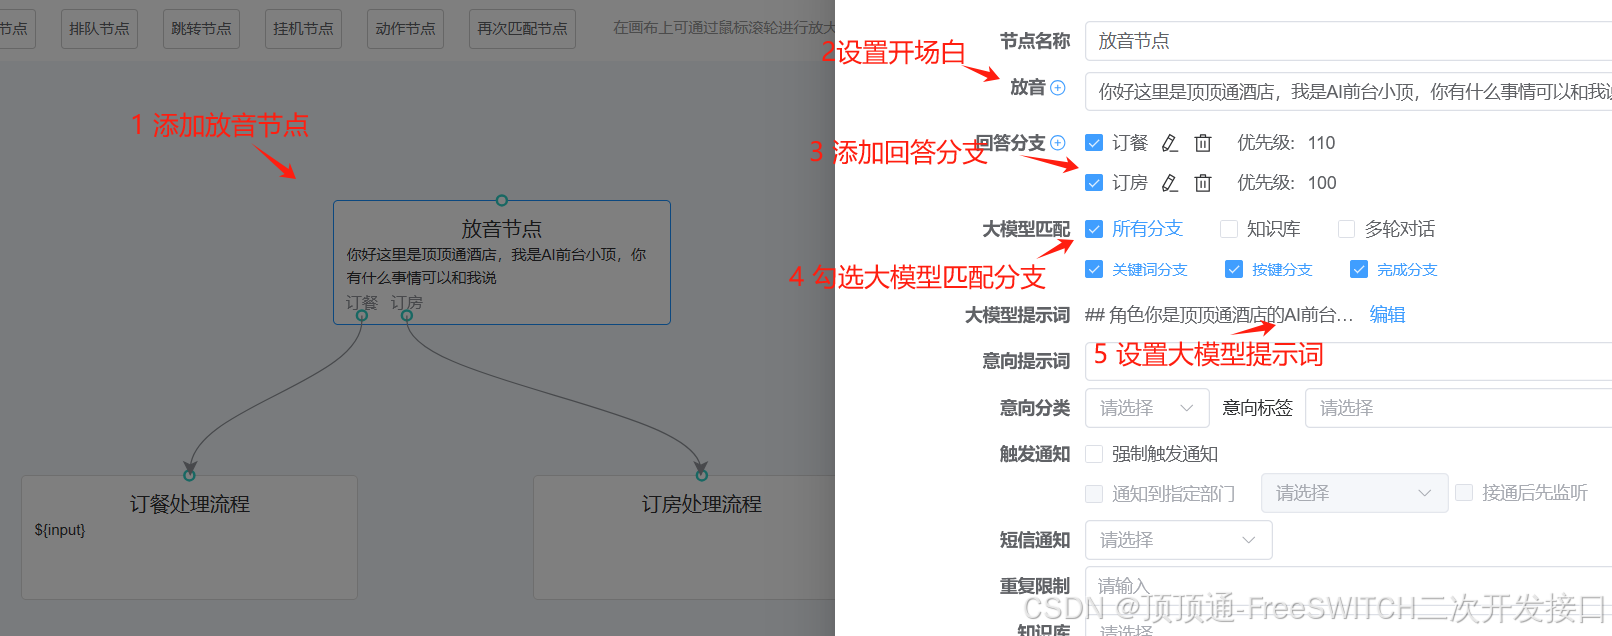
更好的做法是,先对问题按业务进行分类,然后一个业务写一个提示词。下面根据这个业务场景,做一个具体的例子。
|
Markdown |
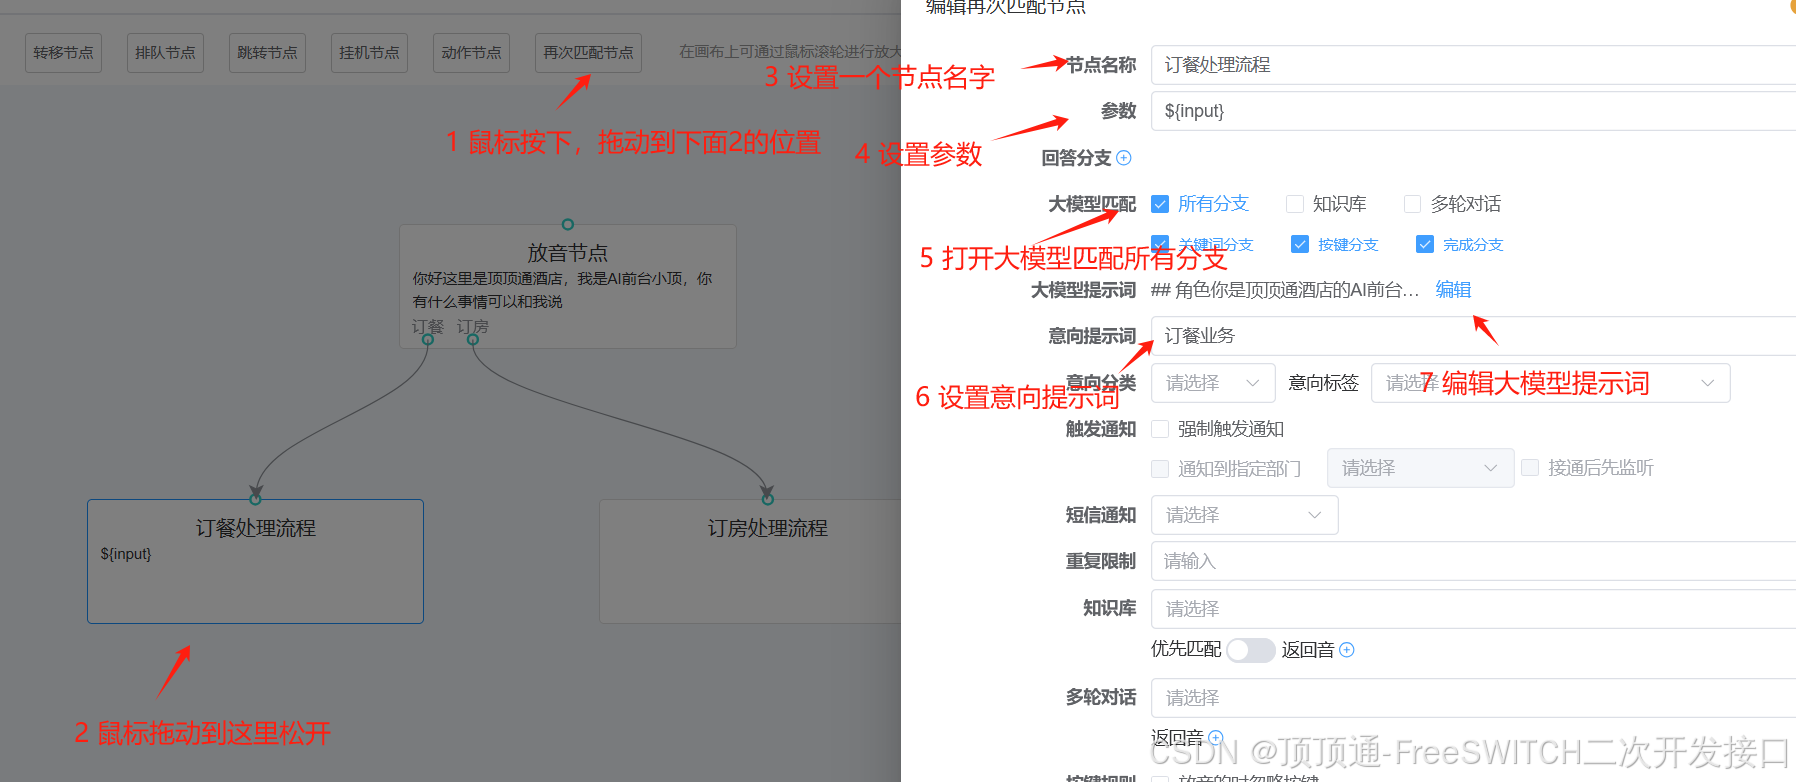
参数一定要填写 ${input}
|
Markdown |
餐厅剩余桌位情况 可以通过调用接口动态获取 比如 ${cti_http_get(http://ip/get?number=${cti_dial_number})},替换了餐厅剩余桌位情况下面的内容。
先做一个普通放音节点,去询问用户需要办理的业务,如果用户需要办理的业务有专门的处理流程,就切换到对应的流程去执行。
为什么办理业务的不是普通放音节点,而是再次匹配节点。因为普通节点必须设置一个放音内容,再次匹配节点不需要设置放音内容,可以让大模型生成放音内容。
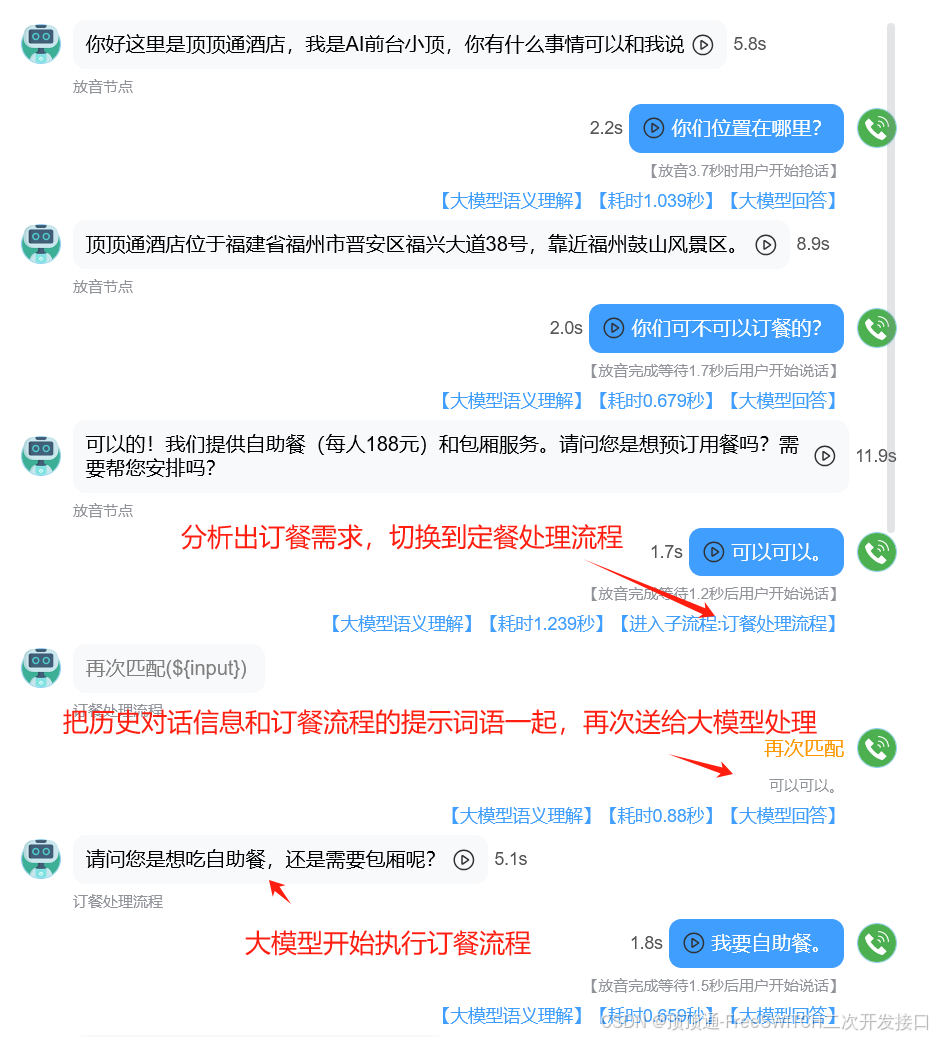
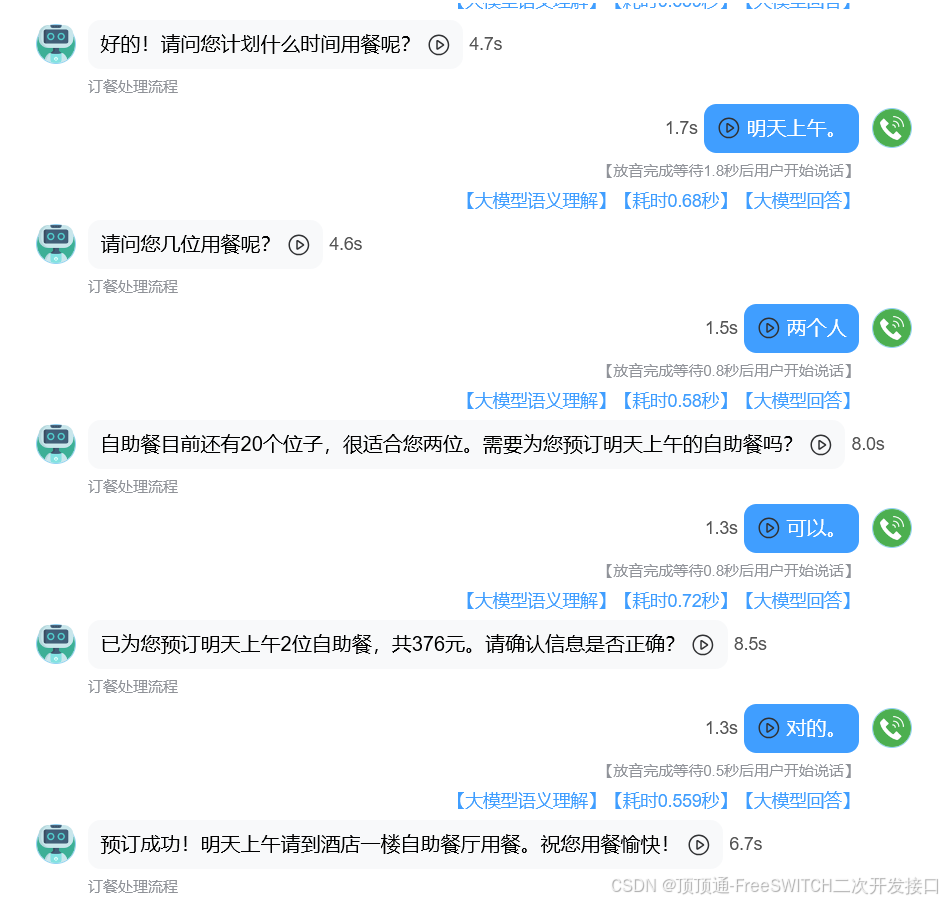
再次匹配节点的执行原理是:第一次进入就把历史对话信息和大模型提示词提交给大模型,让大模型生成回答。用户说话后的处理过程和普通放音节点一致。
普通节点的执行原始是:第一次进入播放放音内容,用户说话后才把历史对话信息和大模型提示词提交给大模型,让大模型生成回答。
2个区别是普通放音节点第一次进入是播放预设的放音,再次匹配节点第一次进入是把历史对话信息和大模型提示词提交给大模型,让大模型生成回答。第二轮对话2个处理逻辑完全一致。
更多推荐

 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)