
背压与流控机制:Flink 的压力传导之路
背压不是故障,而是系统自动限速机制。它让快的地方等慢的地方,避免整条链路失控。
一、为什么要理解背压
很多人在使用 Flink 时,都遇到过这些现象:
- 作业吞吐量突然下降
- 数据延迟越来越高
- Checkpoint 耗时持续增长
- Source 明明很快,却读不动数据
- 某个算子 CPU 很低,任务却整体hang住
表面看像是某个节点性能问题,实际往往是整条链路的速度失衡。在分布式流处理中,上游持续生产数据,下游持续消费数据。只要某一环节处理速度下降,压力就会沿着链路逐级向上传递,最终影响整个作业运行节奏。这个机制,就是 背压(Backpressure)。
理解背压,本质是在理解 Flink 如何维持整个系统的稳定运行。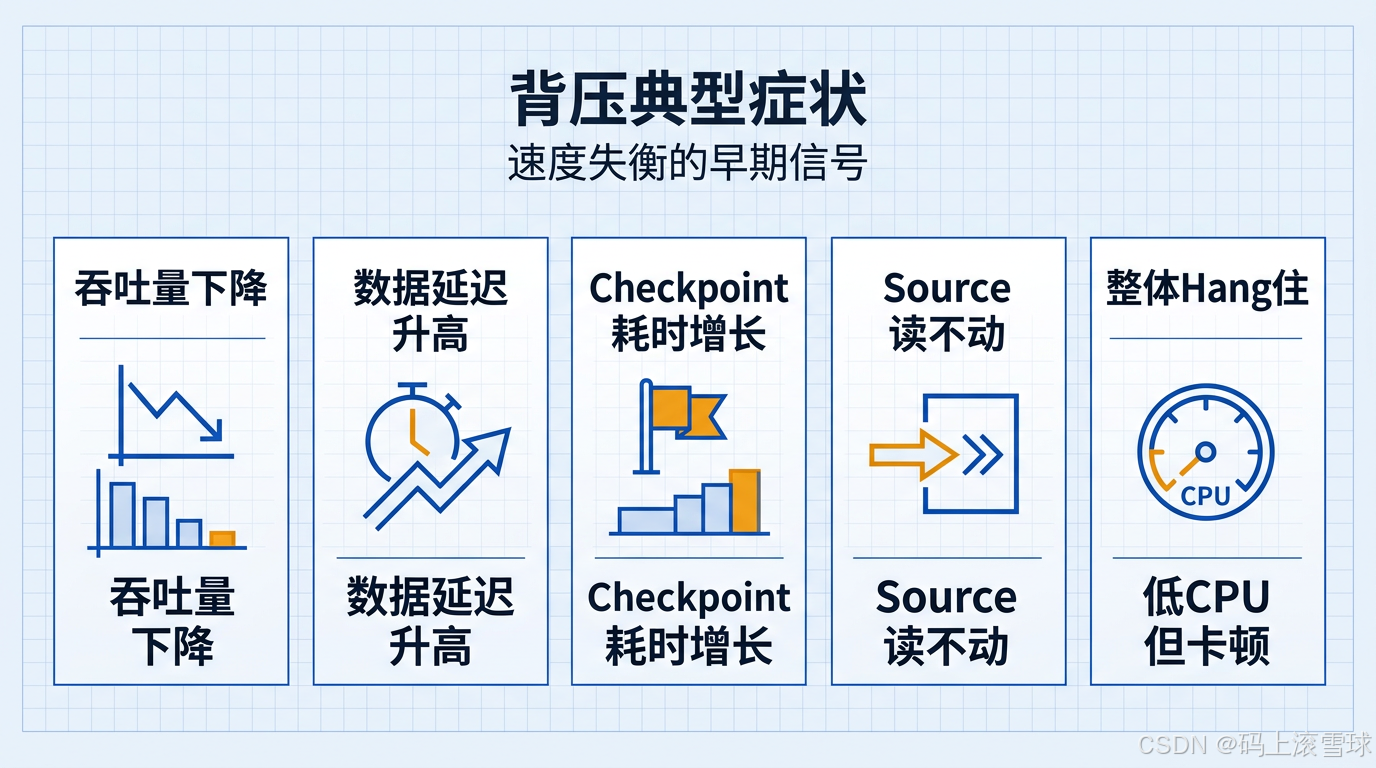
二、什么是背压
背压可以简单理解为:下游处理速度低于上游生产速度时,上游被迫减速甚至阻塞的现象。
例如一条作业链路:
Source → Map → KeyBy → Window → Sink
如果 Sink 写入外部系统变慢:
Sink 处理慢 → Window 输出堆积 → Map 发送受阻 → Source 消费降速
这就是压力反向传导的过程。它不是异常机制,而是 Flink 的一种自我保护能力。
如果没有背压控制,上游持续高速写出,最终会导致内存堆积、网络拥塞甚至任务崩溃。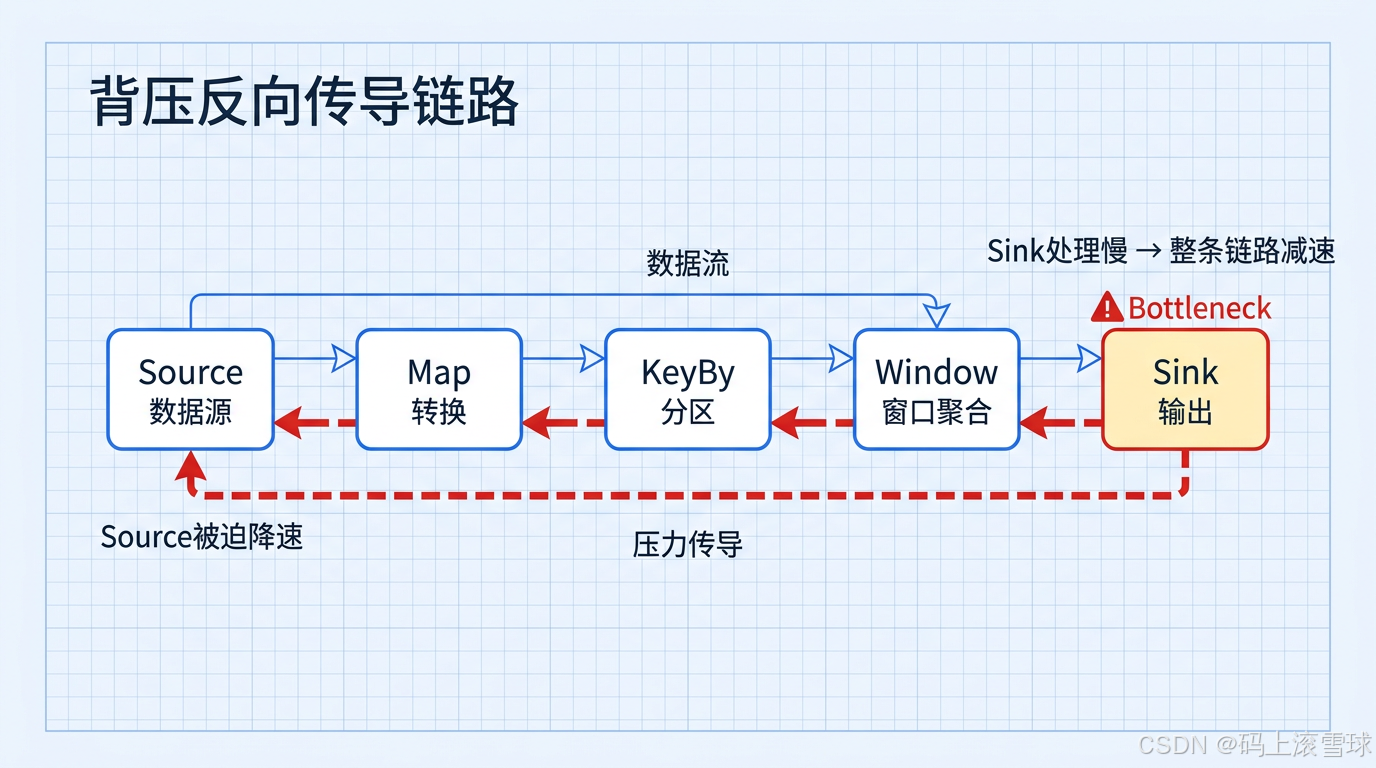
三、Flink 背压产生的底层原因
很多人以为背压是线程被锁住了,实际上在 Flink 中,背压核心原因通常是:
网络缓冲区(Network Buffer)供需失衡。
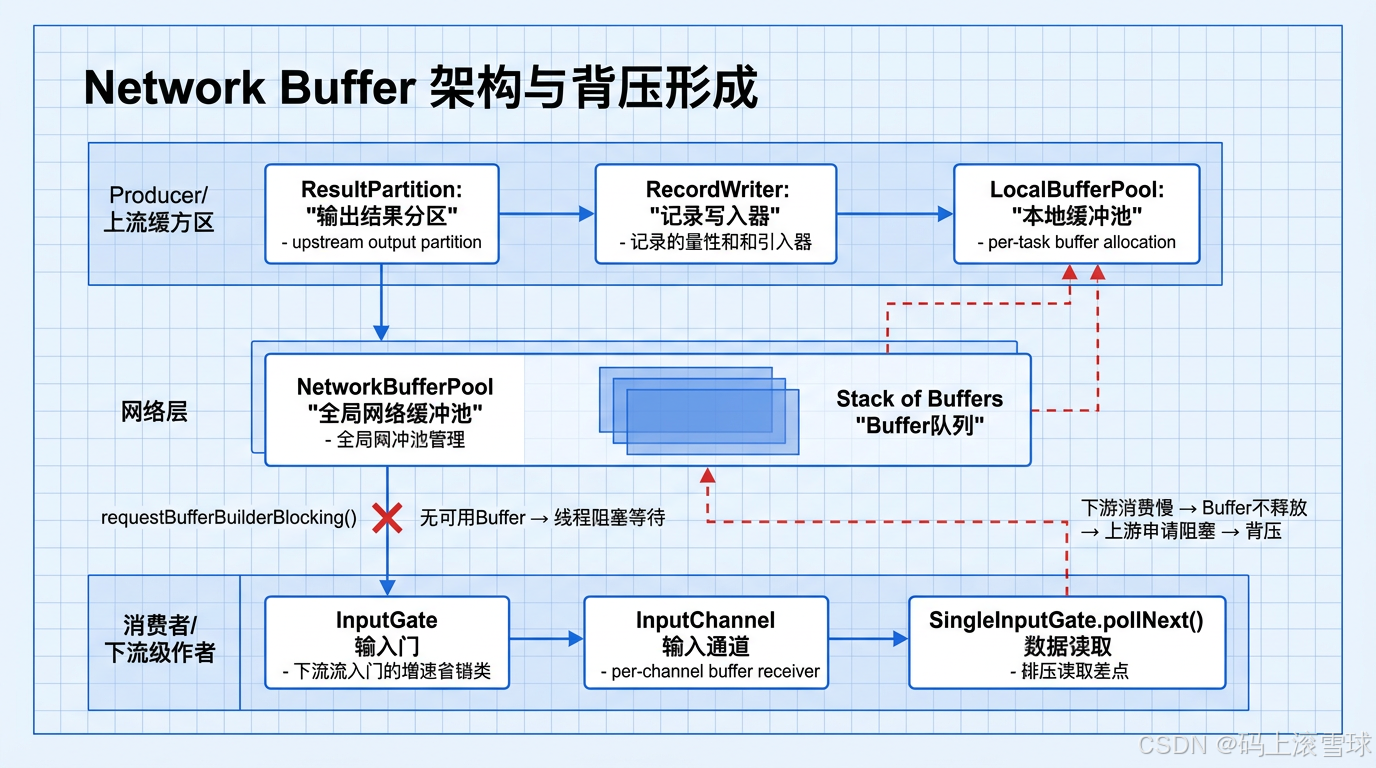
数据在算子之间传输时,不是直接逐条发送,而是先写入 Buffer,再批量发送。核心组件:
| 组件 | 作用 |
|---|---|
ResultPartition | 上游输出结果分区 |
InputGate | 下游输入消费入口 |
NetworkBufferPool | 全局网络缓冲池 |
LocalBufferPool | 单任务本地 Buffer 池 |
| Credit-Based Flow Control | 下游控制上游发送速率 |
当下游消费变慢时:
- Buffer 长时间得不到释放
- 上游申请不到新的可写 Buffer
- 数据发送阻塞
- 背压出现
四、源码解析:背压是如何形成的
1. 上游算子输出数据
算子处理完数据后,通过 RecordWriter 写出:
recordWriter.emit(record);
进入序列化逻辑:
RecordWriter.serializeRecord(serializer, record);
最终写入分区:
ResultPartitionWriter.emitRecord(...)
2. 申请可写 Buffer
数据写出前,需要从本地缓冲池申请 Buffer。Flink 1.20 常见路径会进入:
LocalBufferPool.requestBufferBuilderBlocking()
如果当前没有可用 Buffer,线程会等待。这就是背压在代码层最直接的体现:
上游线程想发数据,但没有可用 Buffer。
3. 为什么没有 Buffer
因为 Buffer 仍被下游占用,还未归还。
下游通过:SingleInputGate.pollNext()读取数据。
若消费速度慢:
- Buffer 积压在 InputChannel
- Buffer 无法及时 recycle
- 上游持续拿不到新 Buffer
最终形成完整链路:
下游慢
→ Buffer不释放
→ 上游申请Buffer阻塞
→ emit卡住
→ Source降速
五、Flink 流控机制:Credit-Based Flow Control
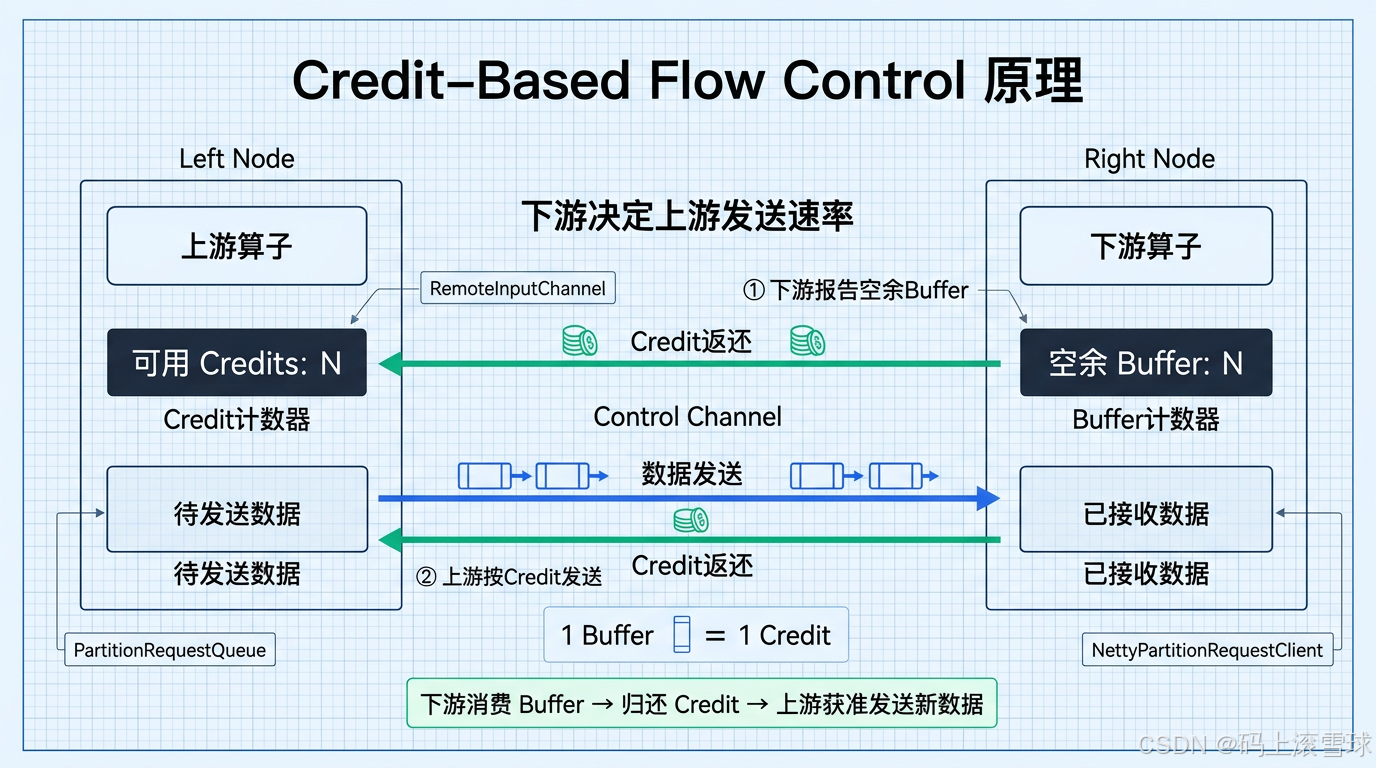
背压只是结果,真正维持系统稳定的是 流控机制。Flink 当前默认采用 Credit-Based Flow Control。
核心思想:不是上游想发多少就发多少,而是下游决定我还有多少空余 Buffer,你最多发多少数据。即:
- 每个可接收 Buffer 对应一个 credit
- 下游消费一个 Buffer,归还一个 credit
- 上游收到 credit 后才能继续发送
关键类
| 类 | 职责 |
|---|---|
RemoteInputChannel | 维护 credit 与远程拉取 |
PartitionRequestQueue | 控制网络发送队列 |
SingleInputGate | 多输入统一消费入口 |
NettyPartitionRequestClient | 网络请求客户端 |
注:本专栏均依据Flink 1.20版本源码
价值:这种机制避免了:
- 单节点 Buffer 被打满
- 网络洪峰冲击
- 下游 OOM
- 整条链路雪崩式积压
六、如何判断作业是否发生背压
1. Flink Web UI 指标(最直接)
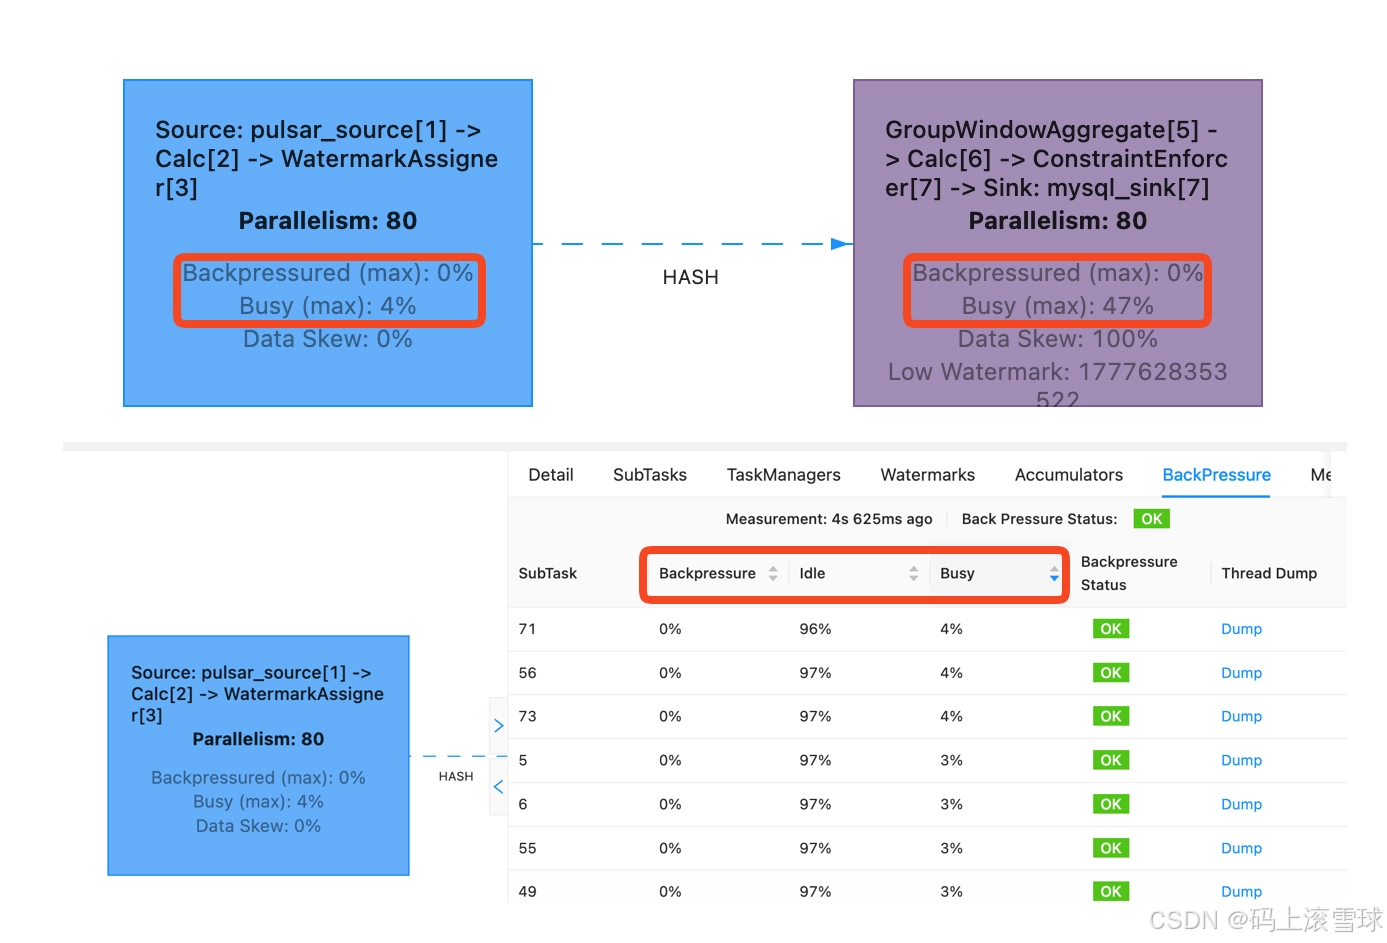
Task 背压指标通常展示三种状态:
| 指标 | 含义 |
|---|---|
| Idle | 空闲等待输入 |
| Busy | 正在处理数据 |
| BackPressured | 输出受阻 |
如果某算子:BackPressured = 85%,说明大量时间花在等待下游可写能力。
2. 常见线上表现
有以下现象可以往这个方向考虑:
- Source TPS 明显下降
- Sink 延迟升高
- CPU 不高但吞吐低
- Checkpoint duration 持续增加
- watermark 推进缓慢
七、背压治理方案(实战)
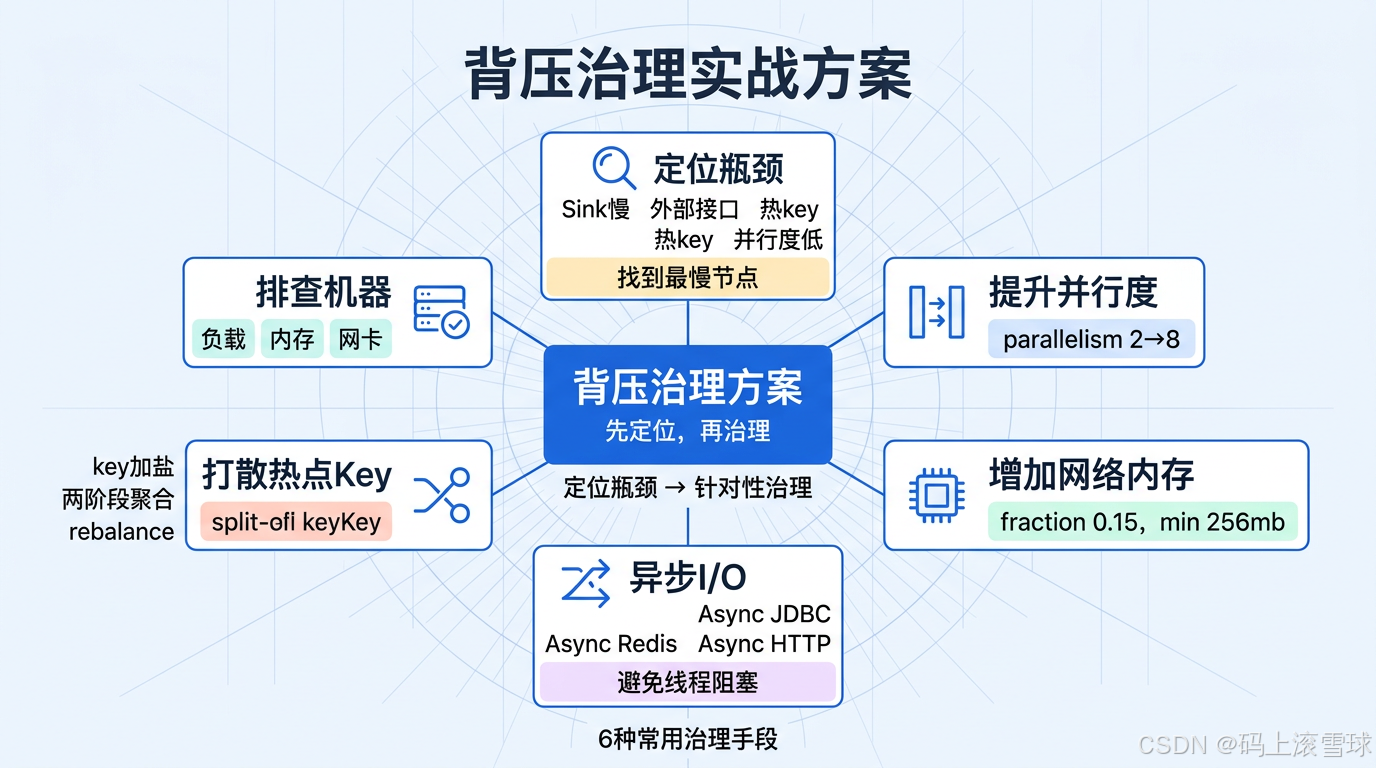
1. 找到最慢节点
多数背压根源在:
- Sink 写库慢
- 外部接口慢
- 热 key 导致窗口拥塞
- 单并行度过低
2. 提升并行度
如果最慢节点的 subtask 的busy程度都很高,说明当前并发无法处理现在的数据量,则需要提升并行度,例如:sink parallelism: 2 → 8,可直接缓解瓶颈算子压力。
如果发现增加并行度处理能力仍然变化不大,则需要确认 sink 对应服务端是否存在异常。
3. 增加网络内存
通过以下配置增加网络内存提升 Buffer 容量。:
taskmanager.memory.network.fraction: 0.15
taskmanager.memory.network.min: 256mb
taskmanager.memory.network.max: 1gb
4. 使用异步 I/O
通过异步I/O,避免 Sink 阻塞线程。例如:
- Async JDBC
- Async Redis
- Async HTTP
5. 打散热点 Key
如果发现Busy subtask 只有几个,且均为输入数据量高的,则是热点 key 让单个 subtask 承担过多压力,从而导致整体吞吐下降。可通过以下方式来缓解倾斜:
- key 加盐
- 两阶段聚合
- rebalance 后再聚合
6. 排查机器是否异常
如果是偶发的个别 busy,重启就恢复的情况,可以考虑是否对于 subtask 所在的底层机器存在故障,如负载高或内存、网卡硬件故障等情况。
八、背压与 Checkpoint 的关系
这是很多线上问题的根源,当背压严重时:
- Barrier 传播变慢
- 对齐时间变长
- aligned checkpoint 持续超时
- checkpoint interval 被拖垮
所以很多人看到 Checkpoint 慢,实际问题并不在 Checkpoint,而在数据链路堵塞。
九、总结:压力如何在系统中流动
我们可以这样理解 Flink 的背压机制:
| 环节 | 含义 |
|---|---|
| Sink 变慢 | 出口堵塞 |
| Buffer 堆积 | 仓位被占满 |
| 上游阻塞 | 生产线减速 |
| Source 降速 | 原料暂停进入 |
背压不是故障,而是系统自动限速机制。它让快的地方等慢的地方,避免整条链路失控。
Flink 正是通过 Buffer 管理与 Credit 流控,让分布式链路在高吞吐场景下依然保持稳定。当我们理解了数据如何流动、压力如何传导,下一个关键问题就是:
这些数据到底存在哪里?
Task 内存、状态内存、网络 Buffer 又如何划分?
下一篇,我们进入:《内存管理机制:从 Task 到 NetworkBuffer》
更多推荐


 11
 0
- 0


 已为社区贡献12条内容

所有评论(0)