
机器学习实践——L1和L2正则化处理过拟合
·
一.案例简介
创建100个数据,训练模型,分别模拟欠拟合、正好拟合、过拟合三种情况,并对于过拟合,使用L1和L2正则化进行优化处理
二.代码部分详解
1.导包
from sklearn.preprocessing import StandardScaler        # 特征处理

import numpy as np                                      #生成随机数
import matplotlib.pyplot as plt                         #可视化
from sklearn.linear_model import LinearRegression       # 正规方程的回归模型
from sklearn.linear_model import SGDRegressor           # 梯度下降的回归模型
from sklearn.metrics import mean_squared_error, root_mean_squared_error, mean_absolute_error  # 均方误差评估
import matplotlib
matplotlib.use('TkAgg')   # 解决后端错误
from sklearn.linear_model import  Lasso, Ridge          #L1,L2 正则化
2.模拟欠拟合
#1.模拟欠拟合

def dm01_under_fitting():
    #1准备数据
    #1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    #1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3 ,100)  #参1:最小值   参2:最大值   参3:生成个数
    #1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)   #参1:平均值  参2:标准差   参3:生成个数
    #1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    #2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    #print(f"处理后的数据{X}")

    #3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    #4.模型训练
    #4.1  创建模型对象
    estimator = LinearRegression()
    #4.2模型选练
    estimator.fit(X, y)         #注意使用处理后的标签X

    #5.模型预测
    y_pre = estimator.predict(X)

    #6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    #7.绘图
    plt.scatter(x, y)                   #绘制真实值
    plt.plot(x, y_pre, color = 'red')   #绘制预测值
    plt.show()
运行效果展示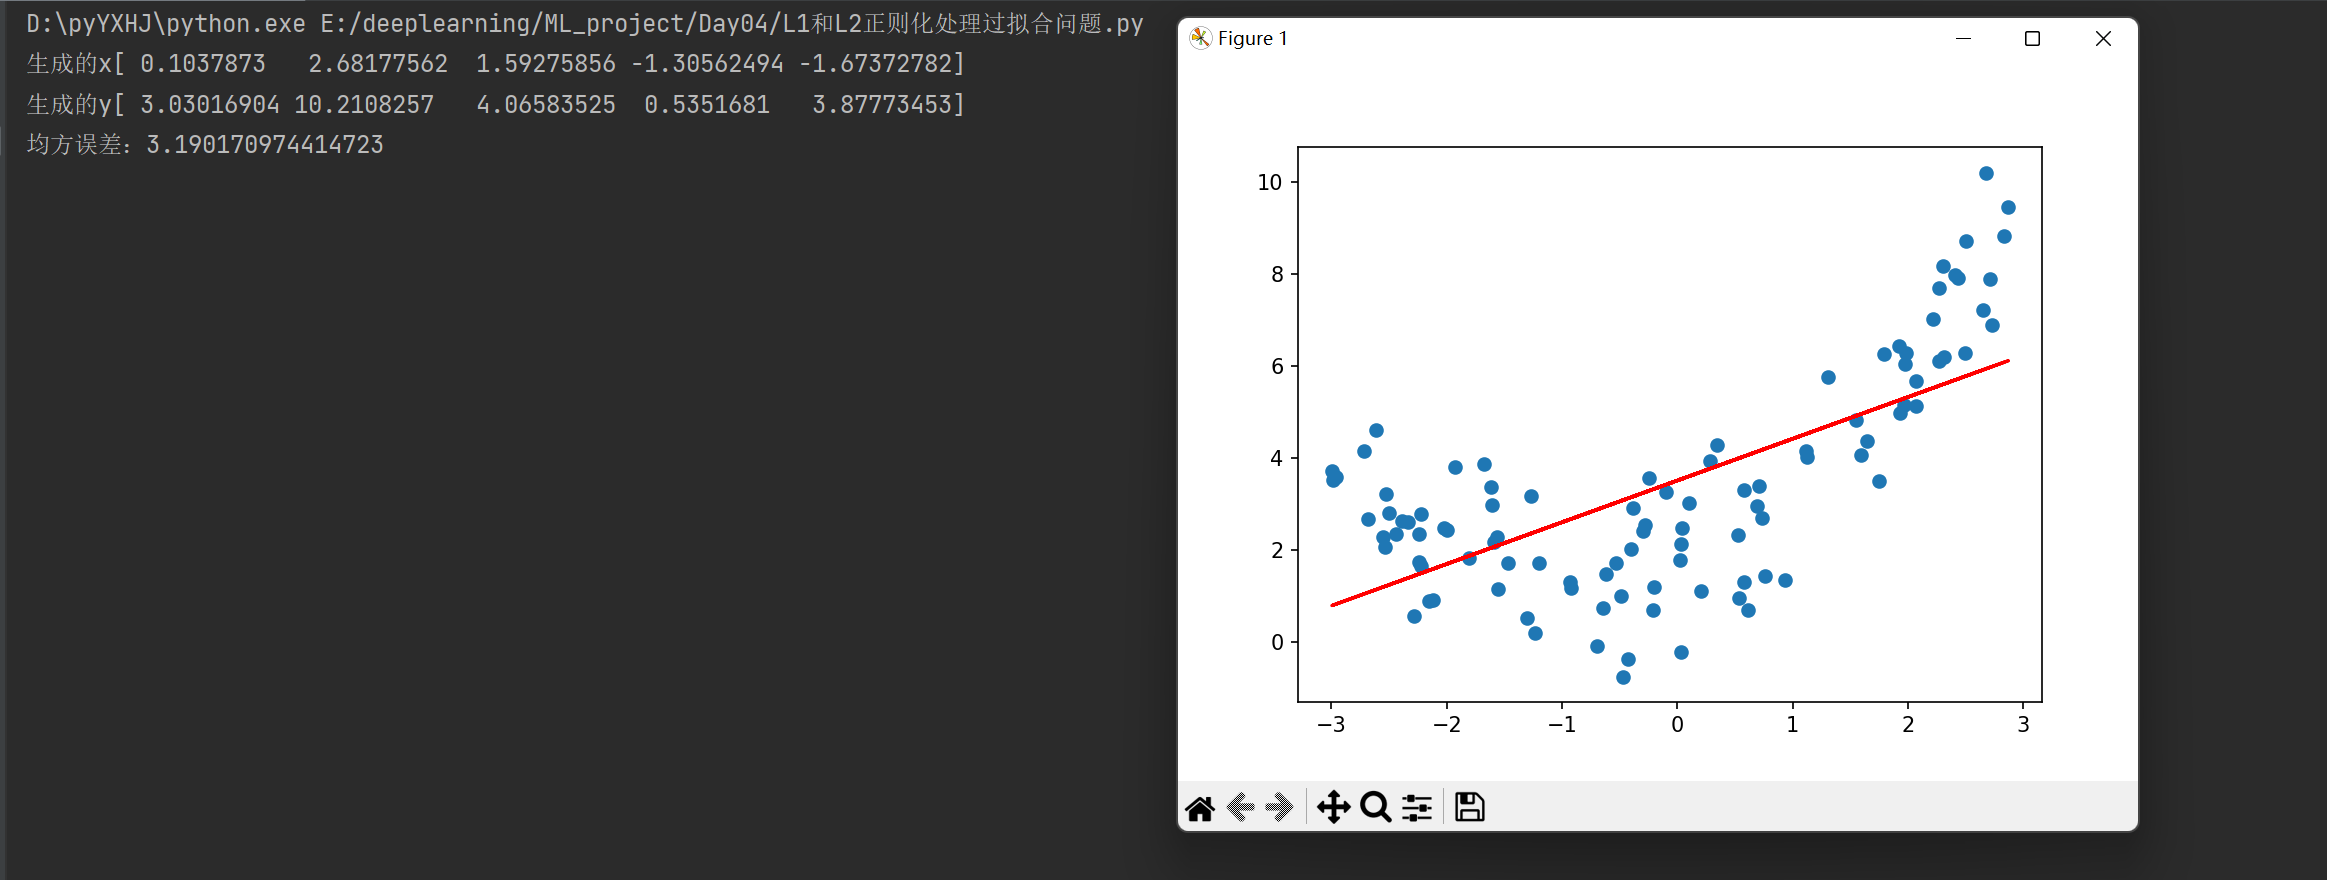
3.模拟正好拟合
#2  模拟正好拟合
def dm02_just_fitting():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X2 = np.hstack([X, X**2])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X2[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    estimator = LinearRegression()
    # 4.2模型选练
    estimator.fit(X2, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X2)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()
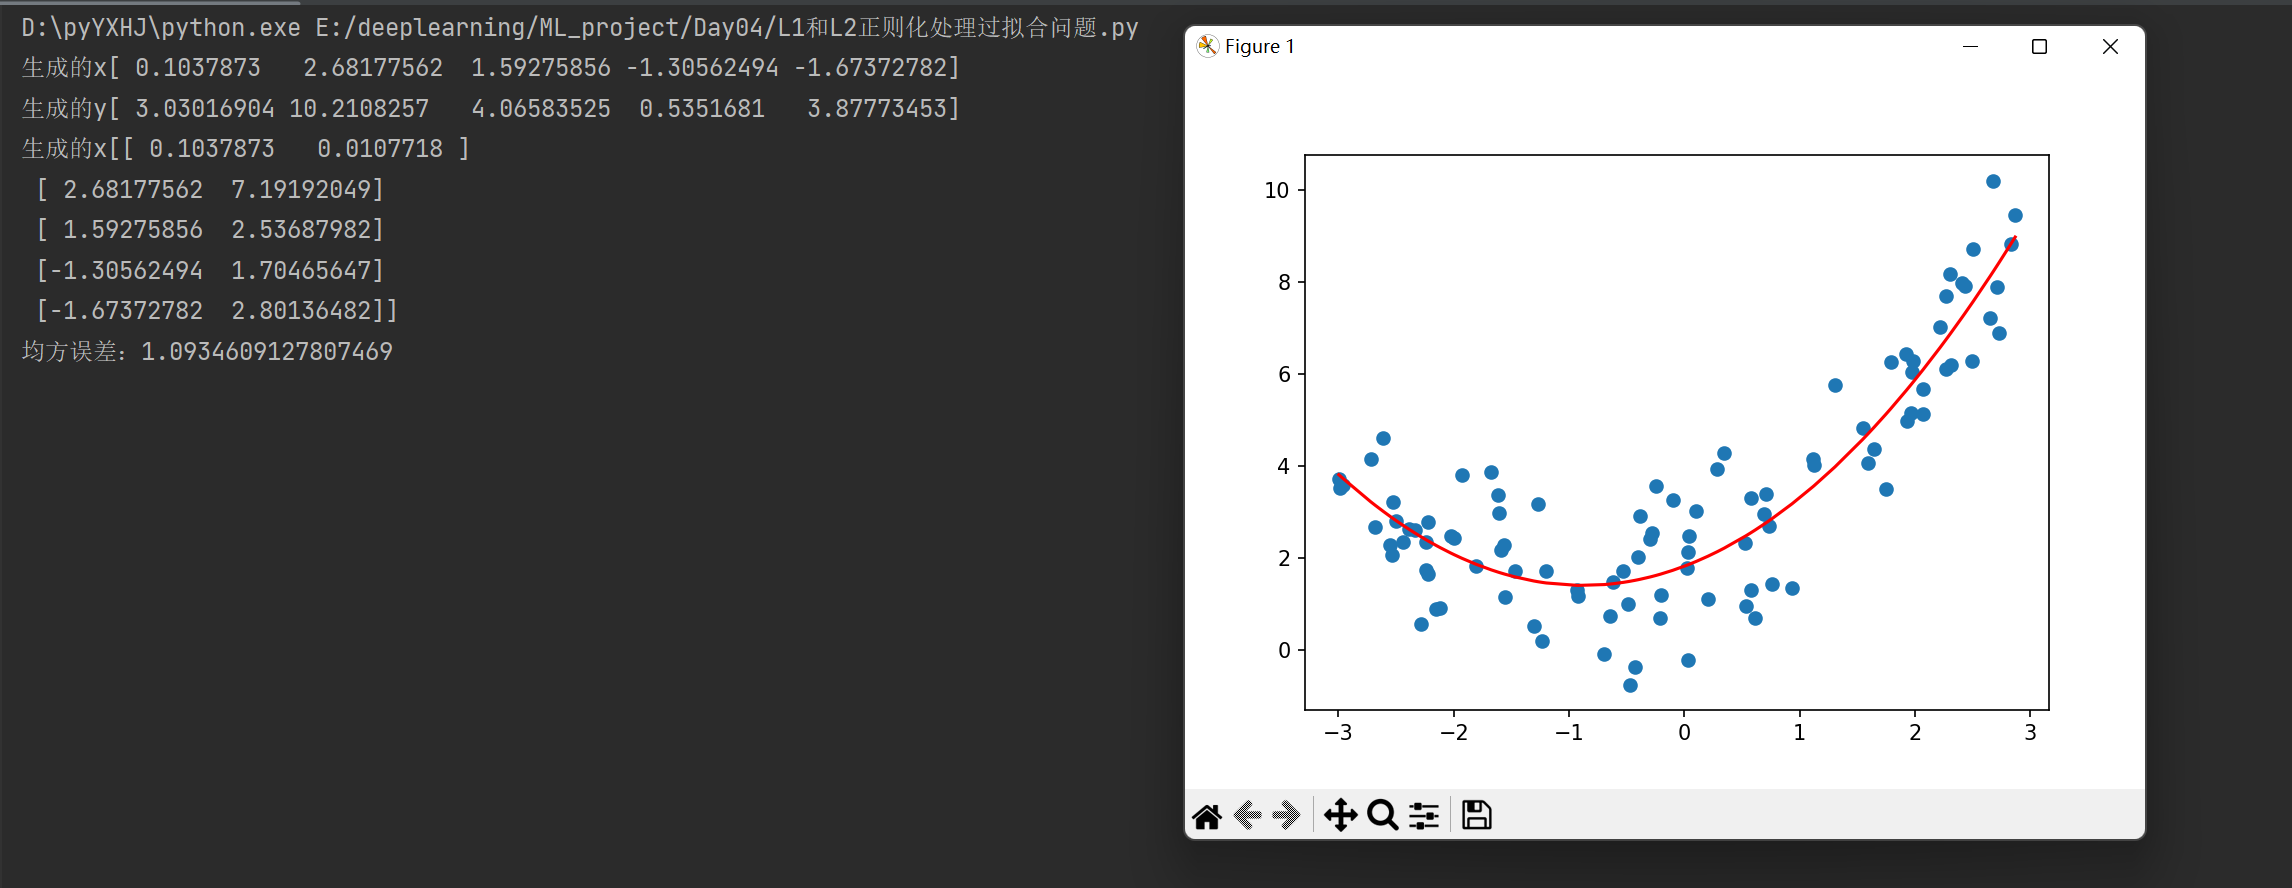
运行效果展示
4.模拟过拟合
#3模拟过拟合
def dm03_over_fitting():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X3 = np.hstack([X, X**2,X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X3[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    estimator = LinearRegression()
    # 4.2模型选练
    estimator.fit(X3, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X3)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()

5.L1正则化处理过拟合
#4
def dm04_L1_regularization():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X3 = np.hstack([X, X**2,X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X3[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    #estimator = LinearRegression()
    #创建L1正则化模型对象
    estimator = Lasso(alpha=0.1)    #alpha 为正则化系数,也是惩罚戏数
    # 4.2模型选练
    estimator.fit(X3, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X3)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()
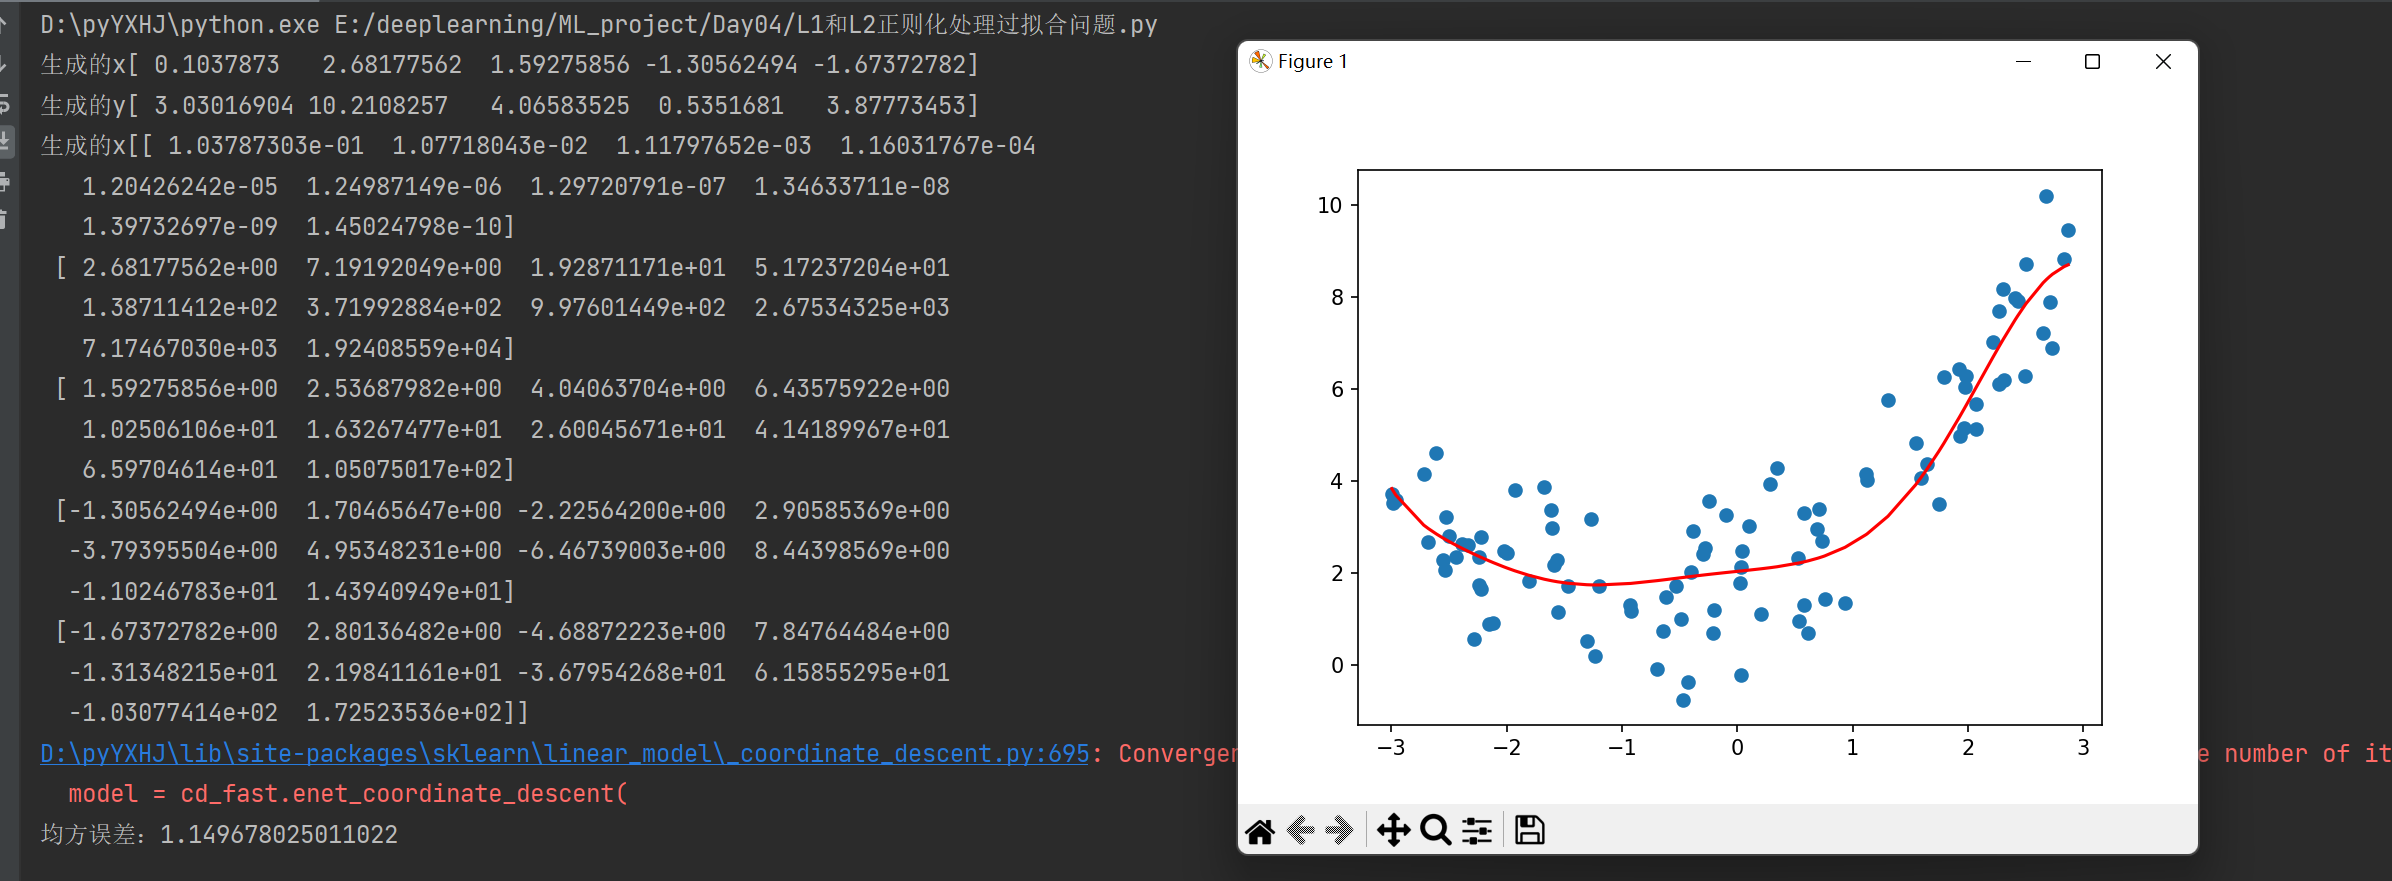
效果展示
6.L2正则化处理过拟合
#5 L2正则化
def dm05_L2_regularization():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X3 = np.hstack([X, X**2,X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X3[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    #estimator = LinearRegression()
    #创建L1正则化模型对象
    #estimator = Lasso(alpha=0.1)    #alpha 为正则化系数,也是惩罚戏数
    # 创建L1正则化模型对象
    estimator = Ridge(alpha=0.1)  # alpha 为正则化系数,也是惩罚戏数
    # 4.2模型选练
    estimator.fit(X3, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X3)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()
7.完整代码
from sklearn.preprocessing import StandardScaler        # 特征处理

import numpy as np                                      #生成随机数
import matplotlib.pyplot as plt                         #可视化
from sklearn.linear_model import LinearRegression       # 正规方程的回归模型
from sklearn.linear_model import SGDRegressor           # 梯度下降的回归模型
from sklearn.metrics import mean_squared_error, root_mean_squared_error, mean_absolute_error  # 均方误差评估
import matplotlib
matplotlib.use('TkAgg')   # 解决后端错误
from sklearn.linear_model import  Lasso, Ridge          #L1,L2 正则化


#1.模拟欠拟合

def dm01_under_fitting():
    #1准备数据
    #1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    #1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3 ,100)  #参1:最小值   参2:最大值   参3:生成个数
    #1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)   #参1:平均值  参2:标准差   参3:生成个数
    #1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    #2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    #print(f"处理后的数据{X}")

    #3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    #4.模型训练
    #4.1  创建模型对象
    estimator = LinearRegression()
    #4.2模型选练
    estimator.fit(X, y)         #注意使用处理后的标签X

    #5.模型预测
    y_pre = estimator.predict(X)

    #6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    #7.绘图
    plt.scatter(x, y)                   #绘制真实值
    plt.plot(x, y_pre, color = 'red')   #绘制预测值
    plt.show()


#2  模拟正好拟合
def dm02_just_fitting():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X2 = np.hstack([X, X**2])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X2[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    estimator = LinearRegression()
    # 4.2模型选练
    estimator.fit(X2, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X2)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()


#3模拟过拟合
def dm03_over_fitting():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X3 = np.hstack([X, X**2,X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X3[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    estimator = LinearRegression()
    # 4.2模型选练
    estimator.fit(X3, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X3)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()


#4
def dm04_L1_regularization():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X3 = np.hstack([X, X**2,X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X3[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    #estimator = LinearRegression()
    #创建L1正则化模型对象
    estimator = Lasso(alpha=0.1)    #alpha 为正则化系数,也是惩罚戏数
    # 4.2模型选练
    estimator.fit(X3, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X3)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()

#5 L2正则化
def dm05_L2_regularization():
    # 1准备数据
    # 1.1指定随机种子,每次生成的数据一致
    np.random.seed(23)
    # 1.2.随机生成x轴   100个数据,模拟:特征
    x = np.random.uniform(-3, 3, 100)  # 参1:最小值   参2:最大值   参3:生成个数
    # 1.3.基于X轴,通过线性公式,生成y轴100个数据,模拟标签
    y = 0.5 * x ** 2 + x + 2 + np.random.normal(0, 1, 100)  # 参1:平均值  参2:标准差   参3:生成个数
    # 1.4 查看生成的x轴 和 y轴 的数据
    print(f'生成的x{x[:5]}')
    print(f'生成的y{y[:5]}')

    # 2.数据预处理,把x轴特征,转换成1列多行数据
    X = x.reshape(-1, 1)
    # print(f"处理后的数据{X}")
    #2.2由于模型过于简单,增加一个特征列来增加模型的复杂度
    X3 = np.hstack([X, X**2,X**3, X**4, X**5, X**6, X**7, X**8, X**9, X**10])    #该函数作用:水平拼接,即:拼接两个数组,拼接后数组的行数不变,拼接后数组的列数等于拼接前列数之和

    print(f'生成的x{X3[:5]}')
    #print(f'生成的y{y[:5]}')

    # 3.特征工程,本案例不做了,直接用100条数据,先训练后预测

    # 4.模型训练
    # 4.1  创建模型对象
    #estimator = LinearRegression()
    #创建L1正则化模型对象
    #estimator = Lasso(alpha=0.1)    #alpha 为正则化系数,也是惩罚戏数
    # 创建L1正则化模型对象
    estimator = Ridge(alpha=0.1)  # alpha 为正则化系数,也是惩罚戏数
    # 4.2模型选练
    estimator.fit(X3, y)  # 注意使用处理后的标签X

    # 5.模型预测
    y_pre = estimator.predict(X3)

    # 6.模型评估
    print(f'均方误差:{mean_squared_error(y, y_pre)}')

    # 7.绘图
    plt.scatter(x, y)  # 绘制真实值
    #np.sort(x) :对x轴特征排序,默认是:升序
    #np.argsort :对x轴(特征)排序,返回排序后的索引
    plt.plot(np.sort(x), y_pre[np.argsort(x)], color='red')  # 绘制预测值
    plt.show()


if __name__ == '__main__':
    #dm01_under_fitting()
    #dm02_just_fitting()
    #dm03_over_fitting()
    #dm04_L1_regularization()
    dm05_L2_regularization()
三.总结
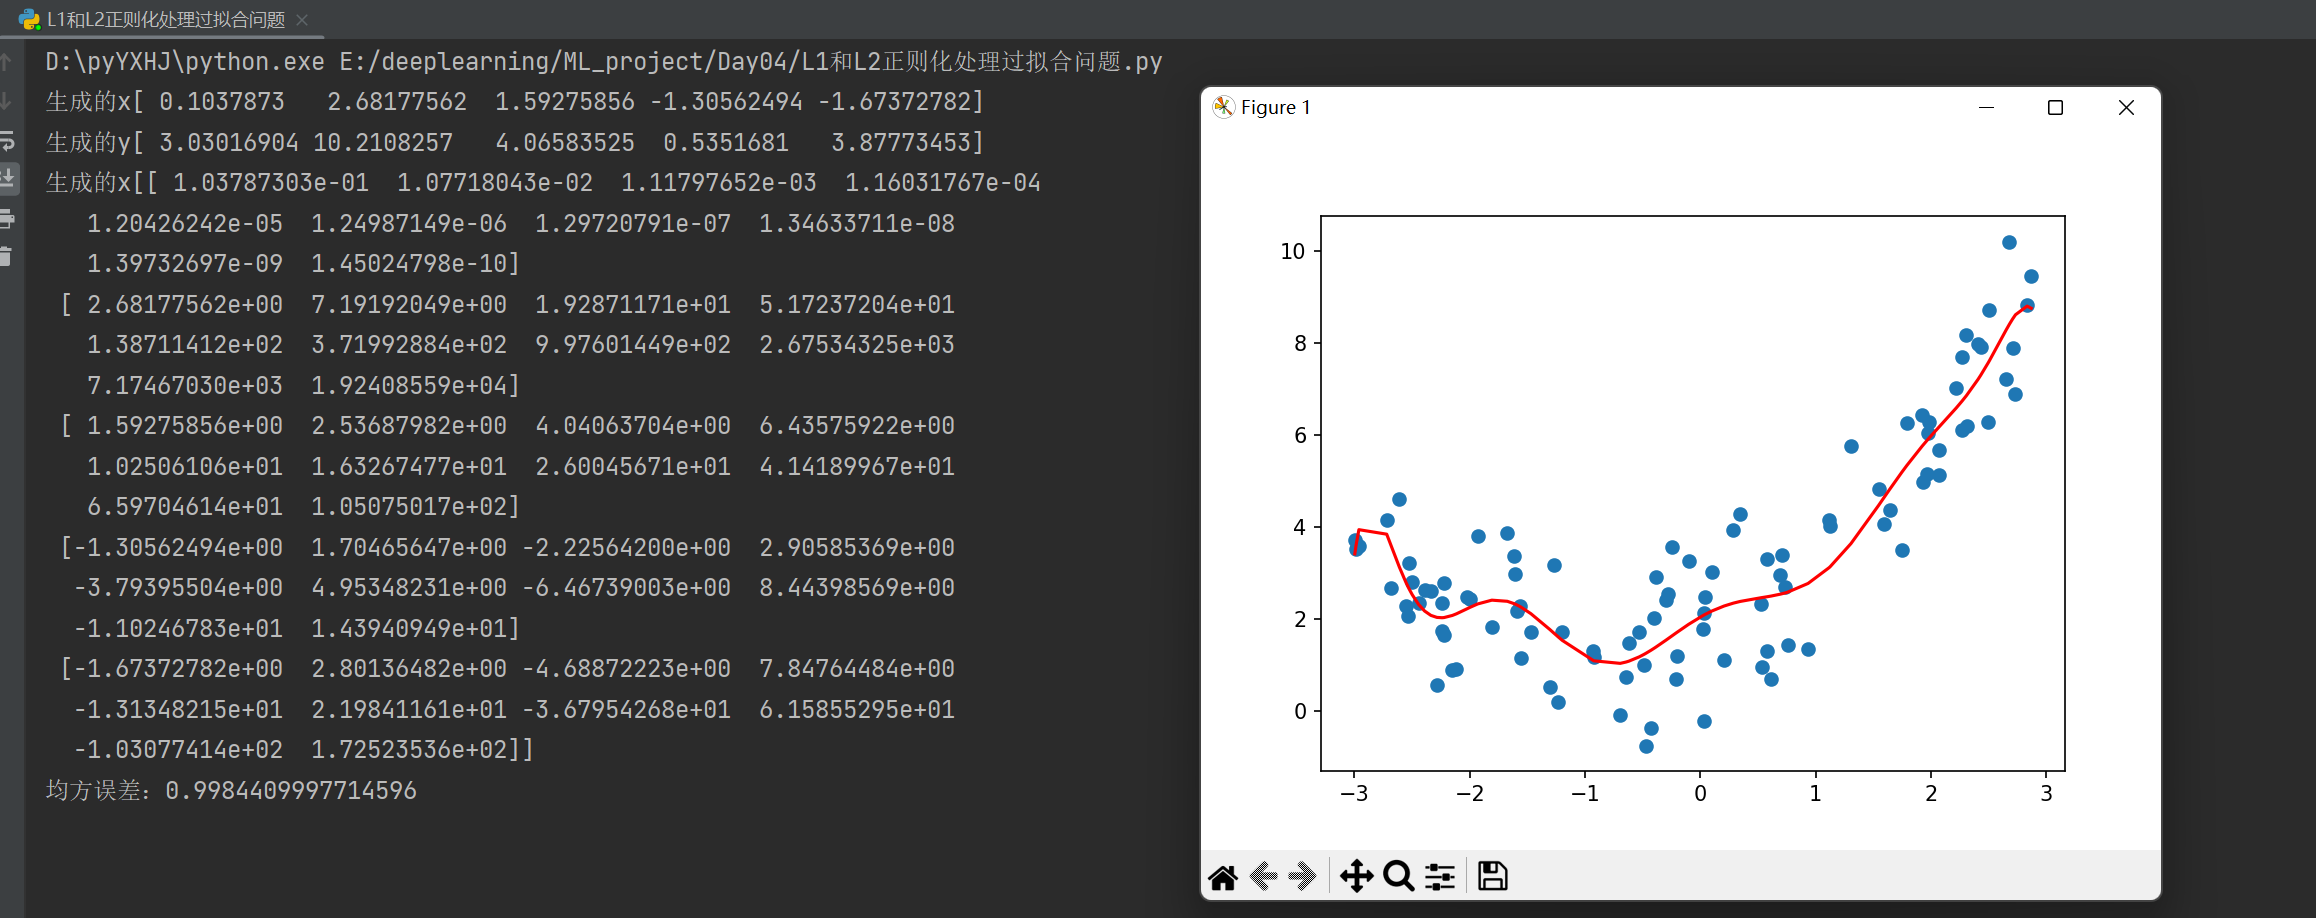
通过此案例,实践了L1和L2正则化处理过拟合,并且对比了两种方法的差异,L1对于简单任务种少量的重要特征的情况效果更好,而L2在实践中使用的更多
更多推荐

 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)