
【数据中台·6】血缘关系之那些踩过的坑
这是【数据中台】系列第6篇。上篇讲数据质量校验,这篇讲血缘关系建设。
上个月排查一个问题:某张报表的件数对不上。
我从ADS层往下追,追到DWS,发现DWS的数据是对的。那问题出在哪?
我得看DWS的数据流向了哪些下游表,哪些表做了二次计算。
打开血缘系统——傻眼了。
一张DWS表,连着十几条线,交叉重叠,有的指向ADS,有的指向另一张DWS,还有一条虚线连到某个我没见过的临时表。
我看了十分钟,没搞清楚"DWS这张表到底影响了哪些下游报表"。
最后只能手动去搜下游表的SQL,一张张看FROM了谁。
这件事让我明白一件事:血缘系统能展示"谁依赖谁",但解决不了"我这张表坏了会影响谁"这个核心问题。
一、字段对不上,硬对出来的
血缘建设之前,我们遇到的第一个坑是:找不到表。
业务方说"我要看每个网点的票数和件数",我心想这不简单吗,DWS层就有。
结果一查,上下游表的字段名对不上。
上游表叫一个名字,下游表叫另一个名字。我不知道它们是同一个字段。
搜全库字段名,找到好几个相似的,哪个才是?
最后的办法:跑临时SQL,逐个对比值。
-- 找上下游字段对应关系:对比值
SELECT a.field_a, b.field_b
FROM dws.dws_target_table a
LEFT JOIN dwd.dwd_source_table b
  ON a.join_key = b.join_key
WHERE a.ds = '20260501'
LIMIT 100
一对,值一模一样。确认了是同一个字段。
这件事花了我三天。
不是因为SQL难写,是因为我不知道该往哪找。DWS有十几个字段,上游DWD有几十个字段,逐个对值,像大海捞针。
根本原因是:没有元数据管理。
字段命名不规范,上游改了字段名不通知下游,数仓内部也没有字段级别的血缘记录。
每个人心里有一份"自己知道的对应关系",但没有文档化。人走了,关系就断了。
二、全局血缘,看着像蜘蛛网
字段对上之后,我们开始建血缘系统。
第一版方案很简单:把所有表的依赖关系全部画出来。
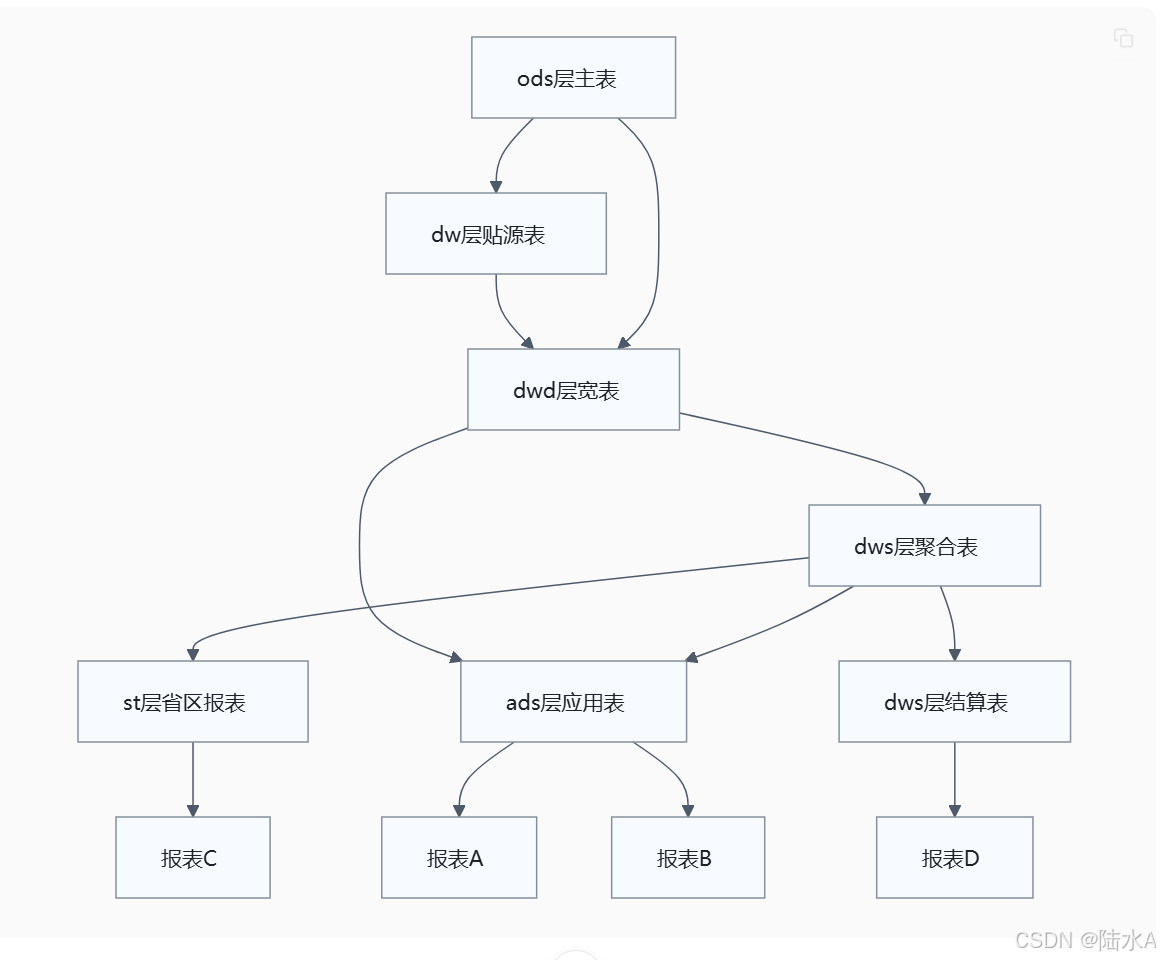
看着挺完整。实际上线后,表多了,连线就乱了。
200多张表,300多条依赖线,画出来像蜘蛛网。找一张表的影响范围,得从图的这头看到那头。
全局血缘的思路是对的,但解决不了日常排查的核心问题。
我每天最常问的不是"这张表依赖谁",而是"这张表坏了,会影响谁"。
全局血缘展示的是物理依赖关系,但我需要的是影响范围。
三、逐层展开:一个取舍
后来我们改了思路:默认只展示前后各一层,用户需要时再逐层展开。
核心逻辑:以当前表为中心,前置血缘展示上一层,后置血缘展示下一层。不多不少,刚好够用。
默认视图就这三张表。干净,一目了然。
用户想往前追?点击A表,展开A的前置血缘:
一层一层展开,直到追到ODS源头。
用户想往后追?点击C表,展开C的后置血缘:
逐层展开,直到追到最终报表。
好处很明显:默认视图不乱,需要详情时再展开。
坏处也明显:看全貌需要多次点击。
我们的取舍是:日常排查优先,全链路可以逐层追。
四、前置+后置:怎么实现的
这个优化的核心是前置血缘和后置血缘分开存储,逐层查询。
实现逻辑:
-- 查前置血缘(上游):只查一层
SELECT source_table
FROM metadata.table_lineage
WHERE target_table = '当前表';

-- 查后置血缘(下游):只查一层
SELECT target_table
FROM metadata.table_lineage
WHERE source_table = '当前表';

-- 用户点击展开时,递归查询
WITH RECURSIVE upstream AS (
  SELECT source_table, 1 AS depth
  FROM metadata.table_lineage
  WHERE target_table = '当前表'

  UNION ALL

  SELECT l.source_table, u.depth + 1
  FROM metadata.table_lineage l
  JOIN upstream u ON l.target_table = u.source_table
  WHERE u.depth < 10
)
SELECT source_table, depth
FROM upstream
ORDER BY depth;
每次只查一层,点击时再展开下一层。前端不一次性加载全链路,后端不一次性算全链路。
前置血缘:当前表←上游←上游的上游←…直到ODS源头。
后置血缘:当前表→下游→下游的下游→…直到最终报表。
五、1362张表,维护成本怎么控
血缘系统建起来容易,维护才是大问题。
我们现有1362张表,每张表都有元数据和血缘记录。表结构变更、字段增删、依赖关系变化——这些都需要实时更新。
手动维护?不现实。
我们的做法是:SQL解析 + 人工兜底。
SQL解析自动提取血缘
每次ETL任务执行时,自动解析SQL语句,提取FROM/JOIN的表名,写入血缘关系表。
-- 伪代码:解析SQL提取血缘
-- 输入:INSERT OVERWRITE TABLE target SELECT ... FROM source1 JOIN source2
-- 输出:target -> source1, target -> source2
这部分用正则就能搞定大部分场景。复杂SQL(子查询、CTE、视图嵌套)需要更完整的SQL Parser,我们用的是开源的。
人工兜底
自动解析覆盖率大概85%。剩下15%的边缘情况——临时表、手动执行的SQL、跨系统依赖——需要人工补充。
我们的机制是:每周跑一次血缘完整性检查,发现有表没有血缘记录的,自动告警给负责人。
变更通知
表结构变更时,自动通知下游依赖方。
这样做的好处是:变更不再靠口传。
以前上游改字段名,下游全靠人传人通知。现在系统自动通知,下游负责人收到告警后评估影响,该改的改。
六、血缘还能干什么
血缘关系不只是排查工具。建好之后,还能做几件事:
影响范围评估
业务方说"我要改这个字段的含义",我查血缘,发现这个字段被12张下游表引用。
以前我得逐个找,现在一查就知道。影响范围清清楚楚,改不改、怎么改,有数据支撑。
数据溯源
报表数据出了问题,从报表追到ADS,追到DWS,追到DWD,追到ODS。
血缘关系就是数据的"族谱",每一层都能追溯来源。
废弃表清理
有些表建了之后没人用,但谁也不敢删——怕删了影响别人。
查血缘:下游依赖为0,上游也没人写入。确认是废弃表,安全删除。
我们靠这个方法,清理了100多张废弃表。
写在最后
血缘建设不是一个技术问题,是一个工程问题。
技术上,递归查询、SQL解析、可视化展示——都不难。
难的是维护。
1362张表,每天都有变更。如果血缘记录跟不上变更速度,系统就成了摆设。
我们踩过的最大的坑,不是画不出血缘图,是画出来之后发现信息过载——全局血缘看着完整,但日常排查用不上。
最后的解决方案不是更复杂的算法,是一个取舍:聚焦直接下游,牺牲完整性换可用性。
血缘系统的价值不在于"展示完整链路",而在于"快速回答影响范围"。
能回答这个问题的系统,就是好系统。
下一篇:数据服务化
更多推荐
 10
 0
- 0


 已为社区贡献8条内容

所有评论(0)