
别再迷信长文本了,给大模型一万张纸不如给它一个好主管
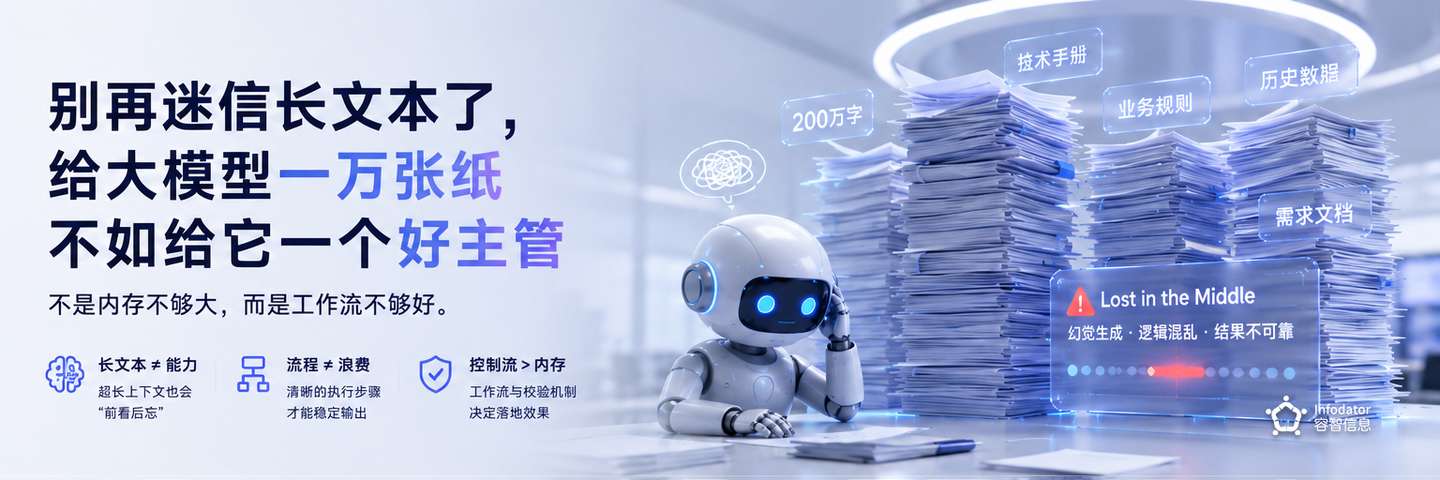
前几天(5/22),月之暗面(Kimi)又拿了20亿美元的新融资,估值飙到了140亿美元,继续主打他们的长文本智能体。很多人都在欢呼,说以后几百万字的小说、几整本的技术文档直接丢进去就完事了。但作为在一线带队攻坚AI工程化落地多年的老架构师,我今天想泼一盆冷水:光靠把上下文窗口(Context Window)无限拉长,根本解决不了企业级Agent落地的核心痛点。
很多写代码的兄弟有个思维误区,觉得AI之所以活干不好,是因为“记性不够好”或者“看书不够多”。他们以为只要把一万页的业务手册、API文档全塞进大模型的Prompt里,模型就能完美写出业务代码。结果呢?实测下来,面对超级长的上下文,模型经常“前看后忘”,或者在中间部分产生极其严重的幻觉,也就是业内常说的“Lost in the Middle”。
这就像有些CTO在管理团队时的误区:总以为给员工塞一堆资料、开一个超长的会,员工就能把活干好。关键不在这里,关键在于你有没有给他梳理出清晰的执行步骤和检查机制。
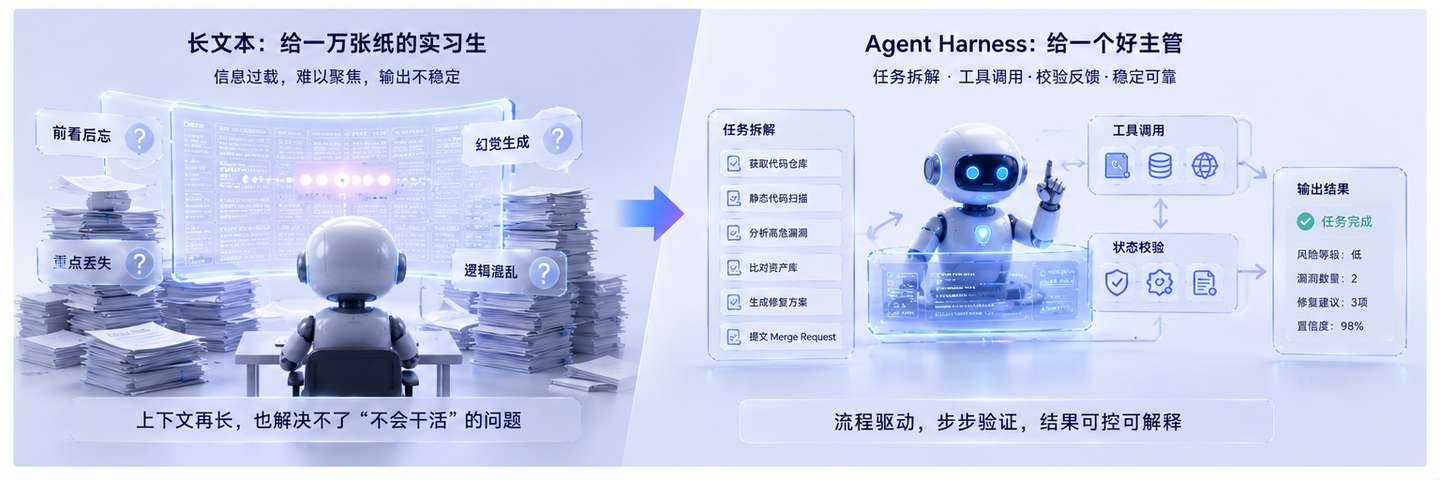
生活化类比 给大模型无限长文本窗口,就像给一个实习生一张大到能放下一万份文件的办公桌。桌子再大,他该摸鱼还是摸鱼,该搞砸还是搞砸。而DeepSeek全面转型的“Agent Harness”(智能体落地框架/工作流支架),就像是在办公室里安插了一个极其严厉、极懂流程的“带教主管”。主管把大任务拆成五步,第一步干完、检查通过了,才准干第二步。
在复杂的企业业务里,我们要的往往不是AI能一口气读多少书,而是它能不能精准地执行一个复杂的任务链条。比如一个“智能代码审计Agent”,它需要先去Git拉取代码,然后调用静态扫描工具,接着分析高危漏洞,再把漏洞信息和公司安全资产库进行比价,最后生成修复方案并提交Merge Request。
这个过程需要大模型频繁地和外部环境交互、调用各种API,并且在每一步进行逻辑推理和状态自我纠检。在这个过程中,控制流(Control Flow)和状态机(State Machine)的设计,比你拥有多大的“赛博内存”重要一万倍。
所以,别再盲目追求把几百万Token塞进模型里了。聪明的工程师应该去学习怎么用Agent Harness这样的框架来搭建健壮的业务管线(Pipeline),怎么设计高效的RAG(检索增强生成)路由,怎么做Agent的内存持久化(Memory Persistence)。把大任务拆碎,把流程做死,AI才能真正帮我们省下熬夜加班的头发。
讨论:
在你的实际开发中,你更倾向于使用Kimi这种超长上下文来暴力解决问题,还是倾向于用类似Agent Harness的复杂工作流架构来控制大模型?哪种方式在实际工程中更稳定?欢迎聊聊。
更多推荐
 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)