
hadoop集群和flink集群需要所有服务器都部署吗
在生产环境中,Hadoop 集群和 Flink 客户端并不是每台服务器都要装一遍的,它们遵循职能分离的原则。
1. Hadoop 集群:按角色分部署,不是“全装”
Hadoop 集群本身也不是所有服务器都装一样的组件,它分为两类角色-7-10:
| 节点类型 | 部署的组件 | 数量 |
|---|---|---|
| 主节点 (Master) | ResourceManager(YARN 总管)、NameNode(HDFS 总管) | 少量(通常是 1-3 台,用于高可用) |
| 从节点 (Worker) | NodeManager(YARN 工作进程)、DataNode(HDFS 数据存储) | 大量(计算和存储的提供者) |
结论:你只需要在所有从节点上安装 Hadoop 的 NodeManager 和 DataNode 组件即可。主节点只需要几台专门的服务器来跑管理角色-10。
2. Flink:不需要“部署”,只需要“客户端”
当你使用 YARN 模式(特别是 yarn-per-job 模式)运行 Flink 任务时:
-
Flink 不需要在每台服务器上安装守护进程,因为 TaskManager(工作进程)是由 YARN 在从节点的容器里动态拉起的。
-
你只需要在一台服务器上安装 Flink 客户端。
这个客户端的唯一使命是:
-
把你的任务 JAR 包上传到 YARN。
-
告诉 YARN:“帮我启动一个 Flink 集群(AppMaster)来跑这个 JAR”-9。
一旦任务提交成功,这台客户端机器即使关机,也不影响任务运行。
一句话概括:YARN 负责“养孩子”(启动和管理 TaskManager 容器),Flink 客户端负责“生孩子”(提交任务给 YARN 去生)。
3. 正确的部署架构图
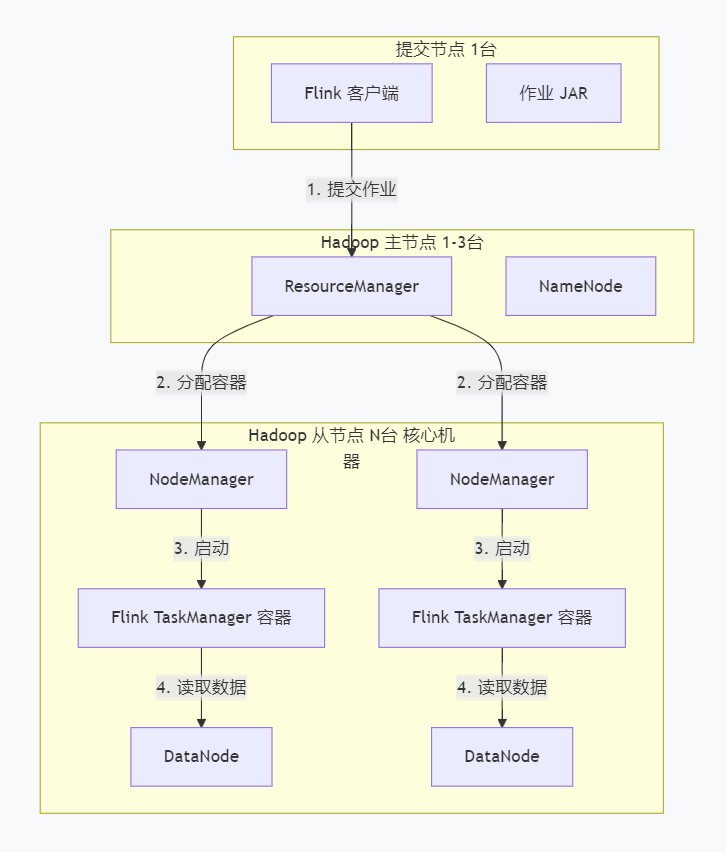
4. 部署检查清单
如果你正在搭建环境,可以参考这个列表:
在核心从节点(Worker 节点,若干台)上:
-
安装 Hadoop(DataNode + NodeManager 角色)
-
配置 YARN 相关参数(
yarn-site.xml等) -
确保
HADOOP_HOME环境变量正确 -
不需要 安装 Flink
在提交节点(Client 节点,只需 1 台)上:
-
安装 Flink 客户端(只需要解压包,不需要启动任何服务)
-
配置 Hadoop 客户端(因为 Flink 客户端需要读取 YARN 的配置来连接 ResourceManager)
-
设置
HADOOP_CONF_DIR环境变量,指向 Hadoop 配置文件目录-1
总结:只有承担计算存储的“从节点”才需要装 Hadoop 组件;只有负责提交作业的“提交机”才需要装 Flink 客户端。
更多推荐

 6
 0
- 0


 已为社区贡献8条内容

所有评论(0)