
必知必会:大模型训练通信开销计算详解与面试指南
为什么通信开销很重要?
通信开销如同隐匿的丝线,牵动着大模型训练的每一个环节。在分布式训练中:
- 显存墙:单个计算设备无法容纳大模型训练时所需的显存
- 通信墙:系统内不同计算设备需要进行密集的数据传输以满足信息同步等要求
符号约定
| 符号 | 含义 |
|---|---|
| Φ | 模型参数量(FP16精度下占用2Φ字节) |
| b | 批次大小(batch size) |
| s | 序列长度(sequence length) |
| h | 隐藏层维度(hidden dimension) |
| N | GPU数量 |
1. 集合通信原语详解
1.1 核心问题
- 分布式训练中 GPU 之间有哪些基础通信方式?
- 各通信原语之间有什么组合关系?
- 不同并行策略分别依赖哪些通信原语?
1.2 原文核心要点
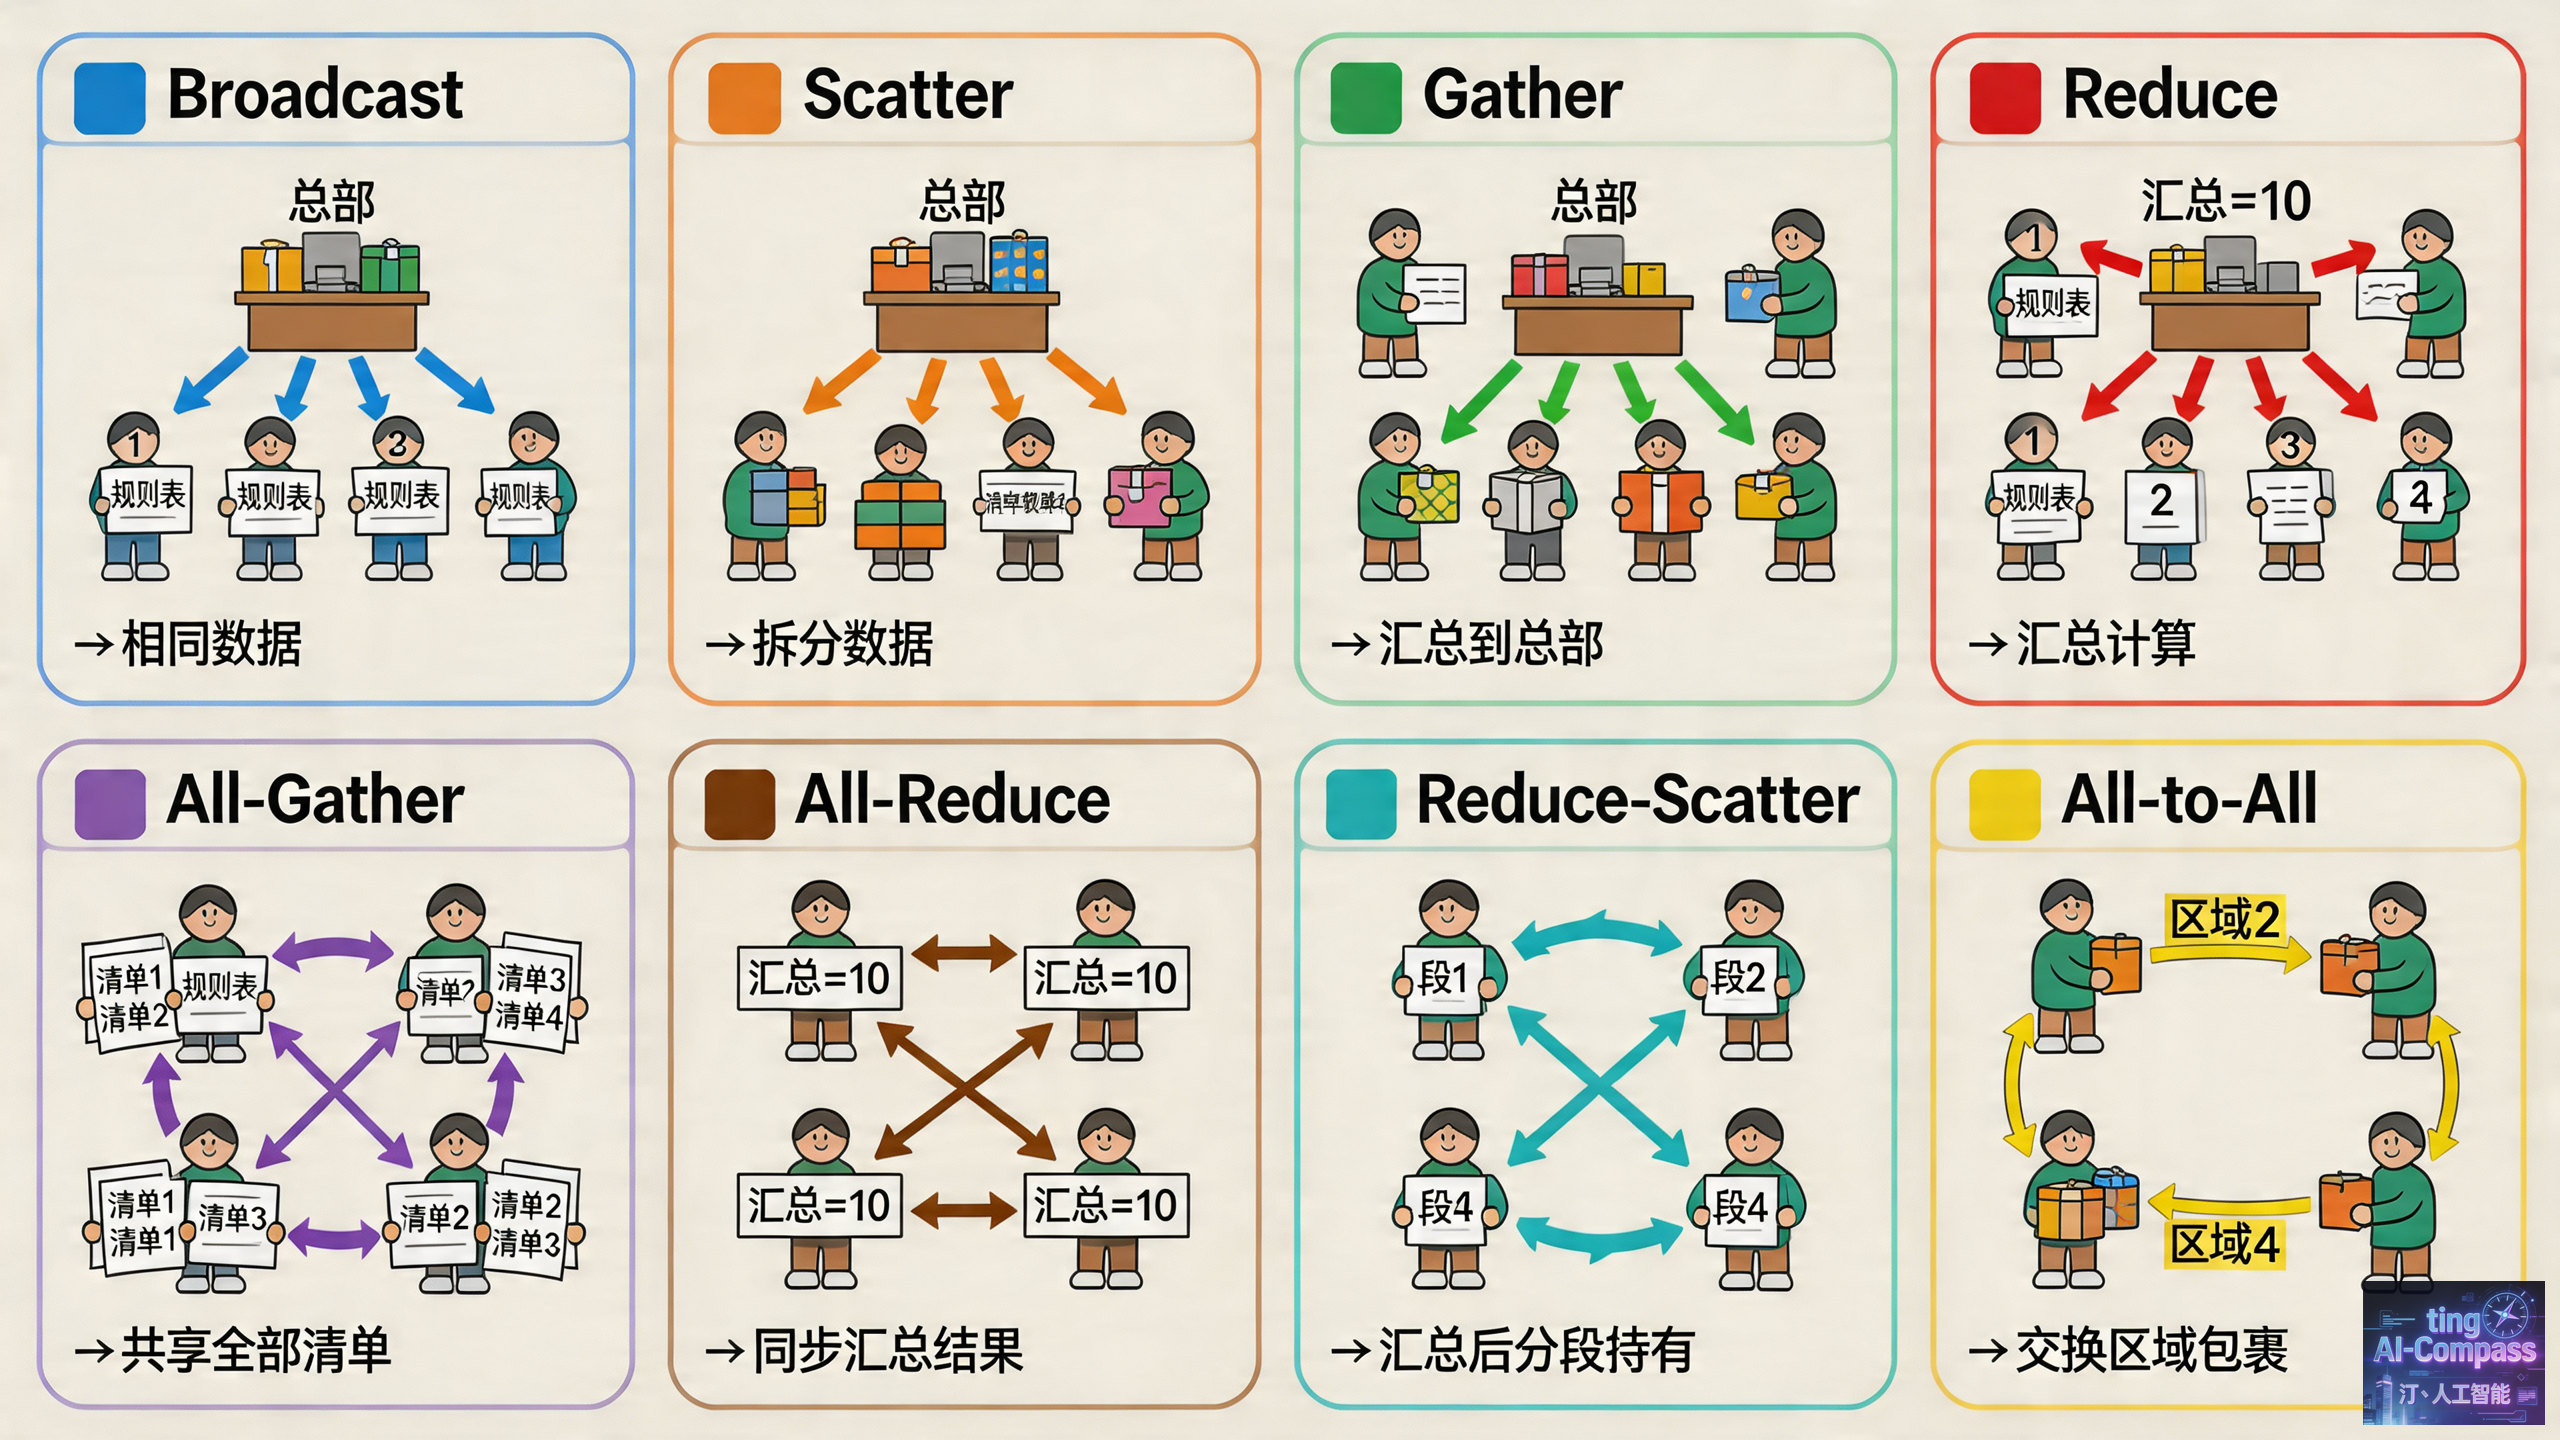
在分布式训练过程中,不同的 GPU 之间可以通过集合通信原语来传递模型参数、梯度等信息。核心原语包括 Broadcast、Scatter、Gather、Reduce、All-Gather、Reduce-Scatter、All-Reduce 和 All-to-All 八种,它们是所有并行策略的通信基石。
1.3 通俗理解
直观类比
想象你在一个快递分拣中心工作,有 4 个分拣员(GPU),每人负责一个区域的包裹:
- Broadcast(广播):总部发了一张新的分拣规则表,复印 4 份发给每个分拣员——每人拿到的内容完全一样
- Scatter(分发):一大批包裹到了,总部按目的地拆成 4 堆,每个分拣员只拿到自己负责区域的那堆——每人拿到的内容不同
- Gather(收集):每个分拣员把自己分好的包裹送回总部汇总——多方汇聚到一处
- Reduce(规约):4 个分拣员各自统计了自己区域的包裹数量,总部把 4 个数字加起来得到总数——汇总时带了"求和"计算
- All-Gather(全收集):每个分拣员把自己的分拣清单分享给所有同事——每人最终都有完整的全局清单
- All-Reduce(全规约):4 个分拣员各自统计包裹数,互相通信后每人都知道总数——边计算边共享
- All-to-All(全交换):每个分拣员有 4 类包裹,分别发给对应的同事——每人既发又收,完全交换
核心要点
- 原语是所有并行策略的通信积木,掌握原语就掌握了通信开销计算的基础
- All-Reduce 是最核心的原语,它可以分解为 Reduce-Scatter + All-Gather
- 不同原语对应不同的并行场景:数据并行用 All-Reduce,ZeRO 用 Reduce-Scatter + All-Gather,专家并行用 All-to-All
建立了直觉之后,下面我们用具体的示意图和对比表来严格定义这些通信原语。
1.4 八大通信原语
1. Broadcast(广播)
一个发送者,多个接收者
将一个GPU的完整数据复制到所有其他GPU上。
操作前:                    操作后:
┌───┬───┬───┬───┐         ┌───┬───┬───┬───┐
│ A │   │   │   │   →     │ A │ A │ A │ A │
└───┴───┴───┴───┘         └───┴───┴───┴───┘
GPU0 GPU1 GPU2 GPU3       GPU0 GPU1 GPU2 GPU3
应用场景:模型初始化时,将主节点的参数广播到所有工作节点。
2. Scatter(分发)
一个发送者,多个接收者(数据分片)
将一个GPU的数据切片后分发给不同GPU,每个GPU获得不同的部分。
操作前:                    操作后:
┌─────────────┐            ┌───┬───┬───┬───┐
│ A │ B │ C │ D │    →     │ A │ B │ C │ D │
└─────────────┘            └───┴───┴───┴───┘
    GPU0                   GPU0 GPU1 GPU2 GPU3
与Broadcast的区别:
- Broadcast:每个GPU收到完整相同的数据
- Scatter:每个GPU收到不同的数据片段
3. Gather(收集)
多个发送者,一个接收者
将多个GPU的数据收集到一个GPU上。
操作前:                    操作后:
┌───┬───┬───┬───┐         ┌─────────────┐
│ A │ B │ C │ D │    →    │ A │ B │ C │ D │  (其他GPU为空)
└───┴───┴───┴───┘         └─────────────┘
GPU0 GPU1 GPU2 GPU3            GPU0
4. Reduce(规约)
多个发送者,一个接收者(带计算)
将多个GPU的数据规约运算(如求和SUM、求最大值MAX、求乘积PROD)后发送到一个GPU。
操作前:                    操作后:
┌───┬───┬───┬───┐         ┌───────────────┐
│ A │ B │ C │ D │    →    │ A+B+C+D       │  (其他GPU为空)
└───┴───┴───┴───┘         └───────────────┘
GPU0 GPU1 GPU2 GPU3            GPU0
5. All-Gather(全收集)
多个发送者,多个接收者
= Gather + Broadcast
每个GPU都收集到所有GPU的数据。
操作前:                    操作后:
┌───┬───┬───┬───┐         ┌─────────────┬─────────────┬─────────────┬─────────────┐
│ A │ B │ C │ D │    →    │ A,B,C,D     │ A,B,C,D     │ A,B,C,D     │ A,B,C,D     │
└───┴───┴───┴───┘         └─────────────┴─────────────┴─────────────┴─────────────┘
GPU0 GPU1 GPU2 GPU3       GPU0          GPU1          GPU2          GPU3
6. Reduce-Scatter(规约分发)
多个发送者,多个接收者
在所有GPU上按维度执行相同的Reduce操作,再将结果发散到集群内所有GPU上。
操作前:                              操作后:
GPU0: [A0,A1,A2,A3]                 GPU0: [A0+B0+C0+D0]
GPU1: [B0,B1,B2,B3]       →         GPU1: [A1+B1+C1+D1]
GPU2: [C0,C1,C2,C3]                 GPU2: [A2+B2+C2+D2]
GPU3: [D0,D1,D2,D3]                 GPU3: [A3+B3+C3+D3]
7. All-Reduce(全规约)
多个发送者,多个接收者
= Reduce + Broadcast = Reduce-Scatter + All-Gather
在集群内所有GPU上都执行相同的Reduce操作,并将结果发送到所有GPU上。
操作前:                    操作后:
┌───┬───┬───┬───┐         ┌─────────┬─────────┬─────────┬─────────┐
│ A │ B │ C │ D │    →    │ A+B+C+D │ A+B+C+D │ A+B+C+D │ A+B+C+D │
└───┴───┴───┴───┘         └─────────┴─────────┴─────────┴─────────┘
GPU0 GPU1 GPU2 GPU3       GPU0      GPU1      GPU2      GPU3
8. All-to-All(全交换)
多个发送者,多个接收者(完全交换)
每个GPU将自己的数据发散到所有GPU,同时收集所有GPU的数据。
操作前:                              操作后:
GPU0: [A0,A1,A2,A3]                 GPU0: [A0,B0,C0,D0]
GPU1: [B0,B1,B2,B3]       →         GPU1: [A1,B1,C1,D1]
GPU2: [C0,C1,C2,C3]                 GPU2: [A2,B2,C2,D2]
GPU3: [D0,D1,D2,D3]                 GPU3: [A3,B3,C3,D3]
与All-Gather的区别:
- All-Gather:不同GPU向某一GPU收集到的数据相同
- All-to-All:不同GPU向某一GPU收集到的数据不同
1.5 通信原语对比表
| 原语 | 发送方 | 接收方 | 是否计算 | 典型应用 |
|---|---|---|---|---|
| Broadcast | 1 | N | 否 | 参数初始化 |
| Scatter | 1 | N | 否 | 数据分片 |
| Gather | N | 1 | 否 | 结果收集 |
| Reduce | N | 1 | 是(规约) | 梯度聚合到主节点 |
| All-Gather | N | N | 否 | ZeRO-3参数恢复 |
| Reduce-Scatter | N | N | 是(规约) | ZeRO梯度聚合 |
| All-Reduce | N | N | 是(规约) | 数据并行梯度同步 |
| All-to-All | N | N | 否 | 专家并行 |
组合关系:
- All-Reduce = Reduce + Broadcast = Reduce-Scatter + All-Gather
- All-Gather = Gather + Broadcast
1.6 小结
| 维度 | 说明 |
|---|---|
| 原语总数 | 8 种基础通信原语 |
| 核心原语 | All-Reduce = Reduce-Scatter + All-Gather |
| 通信模式 | 1→N、N→1、N→N 三种基本模式 |
| 选型依据 | 是否需要计算(规约)、是否需要全局同步 |
| 关键应用 | DP 用 All-Reduce,ZeRO 用 RS+AG,EP 用 All-to-All |
2. 数据并行的通信开销计算
2.1 核心问题
- 数据并行的工作原理是什么?
- 朴素 All-Reduce 和 Ring-All-Reduce 的通信量分别是多少?
- Ring-All-Reduce 为什么更高效?
2.2 原文核心要点
数据并行策略中,每个 GPU 保存完整模型副本,训练数据被拆分。各
更多推荐

 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)