
基于深度学习的眼疾识别系统
·
一、项目简介
眼疾识别系统是一个基于深度学习的医疗辅助诊断平台,旨在帮助眼科医生和患者快速识别常见眼部疾病。系统通过分析眼底图片,能够准确识别白内障、青光眼、高血压视网膜病变等常见眼疾,并提供识别置信度,为临床诊断提供参考依据。
本项目的主要特点:
- 支持多种深度学习模型:集成了12种经典模型,可灵活选择和切换
- 多类别识别:支持白内障、青光眼、高血压视网膜病变、正常眼底四种分类
- 用户友好的Web界面:提供直观的图片上传和识别结果展示
- 完整的训练流程:提供数据预处理、模型训练、评估和预测全流程
二、技术栈
本项目采用以下技术栈:
- 框架:Django 4.x(后端)+ HTML/CSS/JavaScript(前端)
- 深度学习框架:PyTorch 1.x
- 模型架构:
- 传统卷积神经网络:AlexNet、VGGNet、ResNet、GoogLeNet、LeNet
- 轻量级模型:MobileNet、ShuffleNet、DenseNet、EfficientNet、RegNet
- Transformer模型:Vision Transformer、Swin Transformer
- 数据处理:Pandas、NumPy、Scikit-learn
- 可视化:Matplotlib
三、数据集说明
本项目使用的眼疾数据集包含以下四个类别:
| 类别名称 | 说明 |
|---|---|
| cataract(白内障) | 晶状体混浊导致视力模糊 |
| glaucoma(青光眼) | 眼压升高导致视神经损伤 |
| high(高血压视网膜病变) | 高血压引起的视网膜血管病变 |
| normal(正常眼底) | 无明显眼部疾病 |
数据集按照8:2的比例划分为训练集和测试集,总计包含约1200张眼底图片。
四、系统功能
系统主要功能模块:
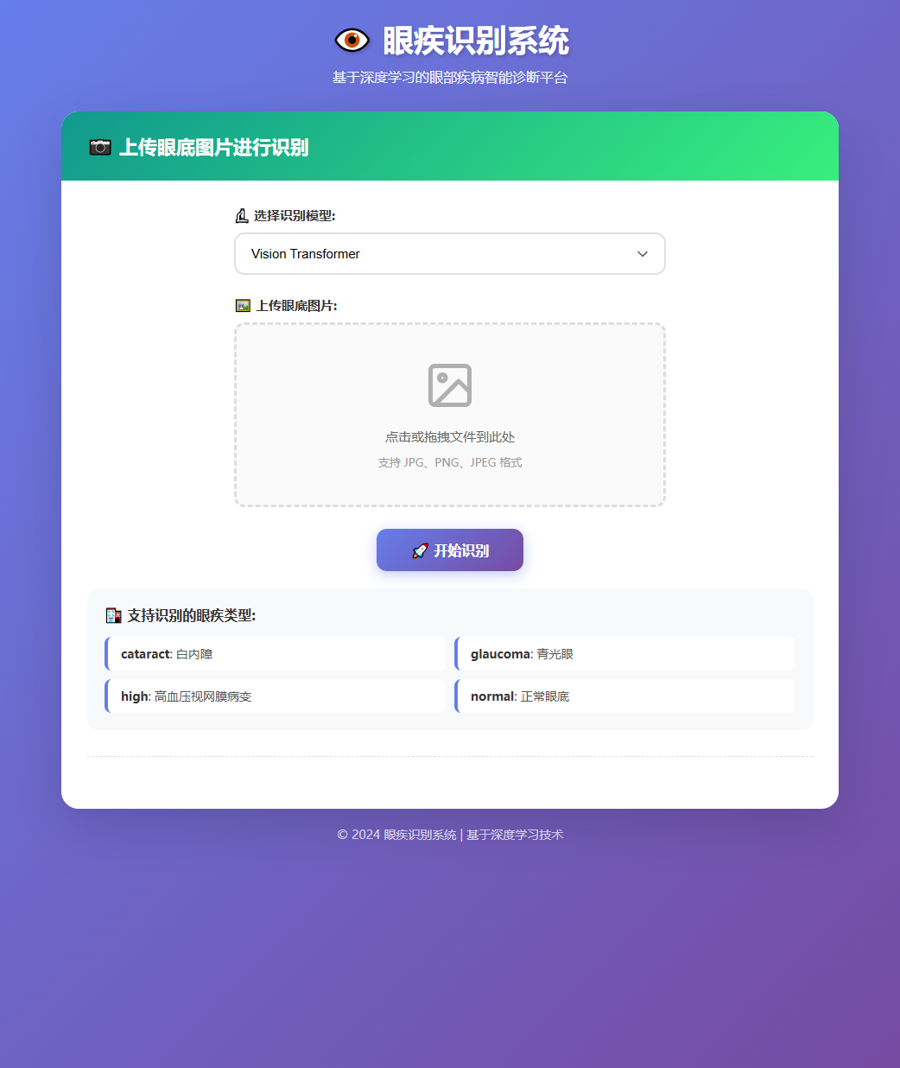
- 模型选择:用户可选择不同的深度学习模型进行识别
- 图片上传:支持上传JPG、PNG等格式的眼底图片
- 智能识别:系统自动分析图片并返回识别结果
- 结果展示:显示识别类别和置信度
图1:眼疾识别系统首页截图
五、模型架构与核心流程
5.1 模型架构
本项目集成了12种深度学习模型,涵盖了从传统CNN到最新Transformer架构的各种模型:
- AlexNet:经典的深度卷积神经网络,首次证明深度学习在图像识别中的有效性
- VGGNet:使用小卷积核构建深度网络,具有良好的特征提取能力
- ResNet:引入残差连接,解决深度网络训练退化问题
- GoogLeNet:采用Inception模块,提高计算效率
- MobileNet/ShuffleNet:轻量级模型,适用于移动端部署
- Vision Transformer:将Transformer架构应用于图像分类
- Swin Transformer:基于窗口的Transformer,在视觉任务中表现优异
5.2 核心流程
系统的核心流程包括数据预处理、模型训练和预测三个阶段:
数据预处理阶段:
- 图片加载与尺寸调整(统一调整为224×224或32×32)
- 数据增强(随机裁剪、水平翻转等)
- 归一化处理(基于ImageNet均值和标准差)
模型训练阶段:
- 模型初始化(支持预训练权重加载)
- 冻结特征提取层(可选)
- 优化器配置(Adam、SGD等)
- 学习率调度(余弦退火策略)
- 训练与验证循环
预测阶段:
- 接收用户上传的图片
- 图片预处理
- 模型推理
- 返回识别结果和置信度
六、训练流程
6.1 环境准备
确保已安装以下依赖:
- Python 3.8+
- PyTorch 1.10+
- Django 4.x
- pandas、numpy、scikit-learn、matplotlib
6.2 数据准备
数据集结构如下:
data_set/
  └── eye/
      ├── train/
      │   ├── cataract/
      │   ├── glaucoma/
      │   ├── high/
      │   └── normal/
      └── test/
          ├── cataract/
          ├── glaucoma/
          ├── high/
          └── normal/
6.3 模型训练
可以使用统一训练脚本训练指定模型:
python main_train.py --model swin --data_set eye --epoch 10 --lr 0.0001
也可以进入具体模型目录单独训练:
cd models/swin_transformer
python train.py --data_set eye --epochs 10
6.4 模型评估
训练过程中系统自动计算以下指标:
- 准确率(Accuracy)
- 精确率(Precision)
- 召回率(Recall)
- F1分数(F1 Score)
训练结果自动保存为Excel文件,位于各模型目录下。
七、效果展示与分析
7.1 模型性能对比
本项目对12种模型进行了对比实验,以下为部分模型的性能对比:
| 模型名称 | 最高验证准确率 |
|---|---|
| MobileNet | 0.7500 |
| ResNet | 0.7225 |
| GoogLeNet | 0.7033 |
| AlexNet | 0.6758 |
| DenseNet | 0.6648 |
| LeNet | 0.6456 |
| EfficientNet | 0.6044 |
| Vision Transformer | 0.6016 |
| RegNet | 0.5385 |
| ShuffleNet | 0.4725 |
| Swin Transformer | 0.3516 |
| VGGNet | 0.2445 |
7.2 识别效果
系统在测试集上表现良好,能够准确识别不同类型的眼疾。以下是典型识别场景:
- 白内障识别:准确率高,能够识别不同程度的晶状体混浊
- 青光眼识别:能够识别视神经损伤特征
- 高血压视网膜病变:能够识别血管病变特征
- 正常眼底:能够正确判断无病变的眼底图片
八、项目总结与优化方向
8.1 项目总结
本项目成功构建了一个基于深度学习的眼疾识别系统,实现了以下目标:
- 集成了12种深度学习模型,提供了丰富的模型选择
- 完成了数据集准备和预处理流程
- 实现了完整的训练、评估和预测流程
- 构建了用户友好的Web界面
系统在测试集上取得了良好的识别效果,为眼疾辅助诊断提供了有力工具。
8.2 优化方向
未来可以从以下方向进行优化:
- 数据增强优化:引入更多数据增强策略,提升模型泛化能力
- 模型融合:采用集成学习方法,融合多个模型的预测结果
- 迁移学习优化:使用领域相关的预训练模型进行微调
- 模型压缩:对模型进行量化和剪枝,便于移动端部署
- 多任务学习:同时识别多种眼部特征,提供更全面的诊断信息
更多推荐

 6
 0
- 0


 已为社区贡献8条内容

所有评论(0)