
基于django房屋租赁大数据分析与可视化系统 毕业设计---附源码55403
摘要
目前房屋租赁市场存在着数据分散、房源信息真假难辨、供需匹配效率低等状况,传统的手工管理或者单机系统已经不能满足对海量租赁数据进行实时处理和个性化推荐的要求了。使用大数据爬虫技术获取各个平台上的房源信息,利用协同过滤算法创建出精准的推荐系统,对提高租客选房速度、加强市场信息公开具有非常大的意义。
系统利用爬虫模块从主流房产网站获取房源标题、价格、户型、地理位置、房东信用等信息,对数据进行清洗之后存入MySQL数据库。后端用Django框架,前端用Vue构建交互界面。核心推荐模块用用户协同过滤和物品协同过滤两种方法相结合来完成:根据租客的历史浏览、收藏、预约行为计算出用户之间的相似度矩阵,得到候选房源集,同时分析房源属性相似度,用评分数据预测未接触房源的租客偏好分值。租客端接收个性化的房源列表以及可视化的图表,可以在网上进行交流和提出意见、建议。房东端完成房源发布、预约看房处理和评价反馈查看。管理员后台对房源展示、户型分类、预约记录和网站公告进行管理,用数据分析模块来监控爬虫运行状态和推荐效果。
系统稳定运行,协同过滤推荐准确率达到预期,爬虫每天对房源做增量更新。平台整合零散的租赁信息,提供个性化的推送,可以加快租客做出决定的速度。
关键词:房屋租赁;大数据爬虫;协同过滤;推荐算法;Django
Abstract
There are problems like scattered data, hard to verify the authenticity of list and inefficient supply-demand matching in the current rental house market. Also old-fashioned manual management or standalone system cannot handle such a huge amount of rental information in timely manner. By using big data crawler, get different listings. By building more precise recommendation system by collaborative filtering algorithms will be very helpful to improve tenants' houses selection as well as promote the house market being transparent
System with a crawler module is used for fetching the listings titles,price,housetypes,location and landlords credit fields from popular real estate site and then clean it and stored into mysql database. The back end is Django, and the front end is Vue to build the interactive part. And then as for the core recommendation, it is combining user-basedCFand item- based CFalgorithms. Calculate an user similarity matrix with users' histroical behavior on browsing,collecting and making appointment and output a set of candidate lists which can also possibly be fitting for such tenants by rating consideration as well as the list attribute similarities. The tenant side gets personal listing list and image chart display, supports online talking and suggestion of complaints. Landlord side finish listing publication, appointment display processing and comments feedback viewing. Administrator Back end is responsible for list display,house sort classification,appointment record and web announcement and check the crawler operation state and recommendation result through the data analysis module.
The System Works Steady. Collaborative Filtering Recommendation Accuracy is as expected and the crawler increments on listing every day. Scattered rental information is there, giving you a personal push to find that spot more quickly.
Key words: Housing rental; Big data crawler; Collaborative filtering; Recommendation algorithm, Django
目录
房屋租赁市场伴随着城镇化进程的迅速发展,早期的租客寻找房源大多依靠线下中介门店、社区公告栏或者熟人介绍。房东出租房屋也使用张贴纸质广告或者口头传播的方式,租赁双方达成信息匹配之后,租金支付和合同签订都在线下进行。传统模式的工作流程具有很强的离散性,租客要花很多时间实地看房,房东不得不接待不同的访客。纸质合同存放不善易丢失,租金纠纷缺少客观的记录作为证据。房源信息更新滞后造成已出租的房屋还在挂牌,看房预约冲突不断。市场缺少统一的信用评价体系,租客不能判断房东以往的服务好坏,房东也很难挑选出好的租客。信息孤岛现象严重,各个中介机构所掌握的房源不能互相打通,虚假房源充斥在市场入口处。计算机技术以及互联网应用飞速发展,使得在线服务平台在出行、餐饮等领域取得了较好的效果,促使租赁行业的从业者对传统的作业方式有了新的认识。行业规范化的要求越来越高,多地出台租赁合同网签备案的规定,要求交易数据可以追溯。市场竞争压力不断增大,新型租赁平台凭借信息整合获得用户流量,传统的中介市场占有率不断降低。租客对于房屋展示的透明度、搜索速度、价格比较等功能有了更高的要求,现有的文献中提到传统房屋租赁管理方式在数据整合方面存在明显的不足[1]。另一项研究认为缺少智能推荐手段造成用户选房决策时间过长[2]。就房东端信用管理的缺失而言,有关调查显示评价机制缺失会直接导致租赁交易完成率下降[3]。以上因素一起构成了开发大数据分析平台的内生动力。
系统运行之后,房源信息的呈现形式由原来的静态文字变成动态的图表,租客可以马上得到房屋租金分布图、户型热度排名表这些结果。房东发布出租信息之后,平台就会立刻开展基本审核工作,从而减轻重复劳动。管理员利用后台数据分析模块来了解区域租赁市场的动向,决策过程有量化的指标做支撑。传统的租客逐页翻看房源的方式被个性化的推荐列表所代替,选房效率大大提高。信用评价体系把双方的历史履约行为记载下来,违约成本可视化之后就会促使服务改善。预约看房时间冲突问题由系统自动排期解决,房东不需要再手工协调多个访客。租赁合同电子化存储可以避免纸质文件丢失的风险,在纠纷发生的时候,交易记录可以迅速追溯。平台整合分散在各个中介机构的房源数据,市场信息由分散走向统一。该种模式给住房租赁行业赋予了标准参照架构,其它城市或者区域在创建类似系统的时候可以借鉴本平台的设计思想。政府监管部门得到实时租赁交易数据之后,调控政策的制定依据就更为充分了。长期运行产生的大量租赁行为数据可以用来编制租金指数,社会公众可以得到透明的定价参考。系统对于家政服务、二手物品交易等双边市场信用建设具有示范意义,可参照其评价与推荐机制的交互方式来建立类似的平台。
国内房屋租赁领域信息化发展起步较晚,早期系统大多只做房源信息的简单录入和检索。近十年来,由于大数据技术以及网络爬虫工具的成熟,使得租赁平台由原来的静态展示转变为数据驱动。研究者开始对多源房源数据的自动采集、清洗和存储进行研究,技术路线也由原来的单机脚本向分布式架构转变。从系统形态上看,纯展示型平台被数据综合分析模块所取代的综合管理系统所代替,市场信息整合水平大大提高。
李许等人用技术性贸易措施应对为场景,设计了基于网络爬虫和大数据的采集方案,爬虫模块可以定向抓取结构化和非结构化的数据[4]。该研究给房屋租赁系统房源信息采集环节提供参考,即根据不同的房产网站页面结构解析规则。叶芳、方茜设计出了自动化主题爬虫系统,系统会按照事先设定好的主题关键词来挑选相关的网页内容[5]。本系统在搭建租赁资讯采集模块的时候,可以采用主题爬虫的思想,重点抓取有关住房租赁的新闻和政策动态,防止抓取无关的信息。于平把深度学习技术应用到网络爬虫算法当中,对它所处理的复杂页面结构进行验证,从而体现出深度学习技术对于复杂信息搜集与处理的适用性[6]。这对本系统房源详情页解析模块有启发作用,深度学习特征提取可以解决各种网站布局导致的解析问题。党浩予以Python爬虫技术为基础展开网页文本大数据提取方法研究,主要针对动态加载页面内容的获取问题进行研究[7]。本系统在抓取主流房产平台房源数据的时候,会遇到Ajax异步加载的页面,该方法给出了具体的实现路径。霍英等人对网络数据的采集做了系统的实验和研究,包含爬虫调度、去重以及增量更新的方法[8]。本系统爬虫模块采用增量更新的方式进行数据抓取,只抓取变化房源的数据,减少服务器的资源消耗。闫语利用网络爬虫技术完成观影大数据采集分析系统,该工作体现出爬虫数据同可视化展示的衔接方法[9]。本系统数据分析模块参照数据流转设计,采集结果立刻传送给前端图表渲染组件。白天瑰对基于网络爬虫技术的大数据采集系统进行设计,系统中包含了反爬虫策略的应对机制以及代理IP轮换的功能[10]。本系统在应对房产网站反爬限制的时候,可以借鉴它的代理池管理思想。
以上国内研究主要解决网络数据采集技术实现问题,对爬虫效率、页面解析准确度以及反爬应对策略做了详细的探究。本系统房源信息采集模块直接受益于这些成果,在租赁场景中特殊性的处理上还存在空白,比如房东信用数据跨网站关联、租客浏览行为实时采集等都没有涉及。本系统在数据采集层之外加入了协同过滤推荐和可视化分析的功能,是对于目前国内研究的补充。
国外房屋租赁信息化发展比较早,已经形成了较为成熟在线租赁平台的商业模式。近五年的研究重点由原来的基功能的实现转向了数据价值的挖掘,机器学习的方法以及大数据分析的框架被广泛应用。研究者重视租赁决策过程中隐性的影响因素,用多种数据融合的方法来探究房源价格和成交率的内在联系。技术发展趋向于数据智能,视觉数据同用户行为数据相互交叉的研究成为热点。
王等人的研究使用街景大数据以及机器学习的方法,对视觉环境对房产价格的非线性影响进行分析,得出周边环境视觉特征会对用户对房屋价值的评价产生明显的影响[11]。本系统房源展示模块可以加入周边环境可视化的功能,用街景图像做为房源信息的补充展示维度。Grover等人就电子商务领域大数据分析集成障碍的优先级排序展开研究,给出数据驱动决策的实施框架[12]。本系统在创建管理员数据分析模块的时候,可以参照该框架来确定关键分析指标的选择逻辑。Karthiga等人设计出一个面向医学影像的AI大数据分析框架,该框架给出了一条用深度学习模型来处理大量非结构化数据的技术路线[13]。本系统房源图像处理模块采用特征提取的方法,对户型图和室内实拍照片进行分析,得到有效的信息。Gul认为大数据和智力资本可以互相补充,在价值共创的过程中产生互补的作用,提出了信息密集型组织的价值创造框架[14]。本系统租客与房东双向评价机制可以参照该框架设计信用积累规则,把评价数据转化为可以量化的信用资本。Bai等人用人工智能和大数据分析的方法研究房产经纪人外貌特征对用户在线租房决策的影响,认为非理性因素在租赁决策中起着重要的作用[15]。本系统房源推荐模块参照用户行为分析思路,除了协同过滤算法之外,还会考虑到用户的潜在偏好特征。
国外的研究对于租赁决策分析的深入程度以及广度要高于国内,而且善于把视觉数据、用户心理特征这些非传统要素融入到分析体系当中。本系统借鉴了它的多维数据融合的思想,在房源的基础属性上又加入了周边环境评价和房东的信用记录。由于国内的数据获取渠道限制,本系统对街景图像的整合以及用户非理性行为的建模都进行了简化,主要针对可以稳定采集的结构化租赁数据。
本系统以房屋租赁领域数据采集、个性化推荐、可视化展示这三个主要问题为研究对象。第一,设计出针对多源房产网站的网络爬虫模块。本模块根据各个网站页面结构的不同,制定出相应的化解析规则来处理动态加载的内容以及反爬机制,对房源标题、价格、户型、地理位置和房东信用等进行增量采集和清洗存储。第二,用协同过滤算法来建立房源推荐模型。融合了基于用户的协同过滤和基于物品的协同过滤这两种方法,根据租客的历史浏览、收藏、预约等行为计算出用户的相似度矩阵,再对房源属性进行相似度分析得到个性化推荐列表,从而加快租客的选房决策速度。第三,创建前后端分离的系统架构。前端用Vue创建响应式界面,展示房源分布图、租金走势图、个性化推荐结果;后端用Django框架完成业务逻辑,MySQL数据库用来保存用户信息、房源信息、交易信息、评价信息等。系统还给房东提供房源发布和预约管理的功能,给管理员提供租赁数据统计分析后台。
Vue技术产生于前端开发领域对于界面交互和数据状态管理之间协调性进行探索的过程。在传统的JavaScript开发模式中,页面元素和数据之间所建立的绑定关系要依靠大量的手动编码来实现。Vue依靠响应式数据系统达成模型层和视图层的自动同步。数据对象发生改变的时候,系统内部就会产生依赖收集的过程,有关的视图组件得到更新的通知。该技术的核心运行时用虚拟DOM树来表示。虚拟DOM节点对应真实的页面元素,数据变化就会产生新的虚拟树副本。新旧两棵树之间的差别用diff算法来计算,最后把变更的部分批量应用到实际的页面上。
在运行的过程中,Vue实例会经历创建、挂载、更新、销毁等过程。每一个阶段都有一个预设好的钩子函数入口。开发者可以将自定义逻辑代码插在这些入口位置。组件系统把用户界面分成独立的、可以复用的逻辑单元,每一个单元都包含自己的数据依赖和样式表现。模板语法是用纯HTML字符串来扩展的,它有特定的指令属性。指令系统可以支持条件渲染、列表循环、事件绑定等。计算属性依靠响应式依赖来创建缓存,只有当依赖项发生变化的时候才会重新求值。侦听器用来观察数据的变化,执行异步或者开销大的操作。各个组件之间使用props属性进行数据的传递,使用事件机制来发送消息。对于跨层级的数据共享场景,依赖注入的方式可以使得祖先组件向所有的子组件提供数据[16]。
Django技术最初是为了解决新闻出版类网站的快速开发、内容管理问题而产生的。它的设计思想是代码复用和组件化集成。Django项目是由多个应用程序组成的,每一个应用程序都是一个业务功能单元。项目运行时先读取配置文件,配置文件包含数据库连接、中间件栈、模板引擎路径等参数。URL分发器接收到HTTP请求之后,会遍历路由表,把请求映射到对应的视图函数或者类上。视图层主要是对请求参数进行提取,并调用业务逻辑层来完成数据存取操作,它使用模型接口来进行数据存取操作。
模型层用对象关系映射技术,每一个模型类就对应数据库中的一个表。开发者操作模型实例的时候,系统会自动产生SQL语句并执行数据库操作。查询集使用链式调用的方式,每次调用都会返回一个新的查询集对象。模板引擎和视图逻辑是分离的,模板文件里有变量占位符以及过滤器。过滤器在输出之前对变量做格式转换。中间件机制把请求传入视图之前以及响应离开视图之后的处理都放在里面。每一个中间件都可以对请求进行拦截,对响应进行修改,也可以引发异常。表单系统可以自动完成用户提交的数据验证以及错误提示。管理后台从模型中获取元数据,从而得到数据管理界面。用户认证模块是由会话管理、权限校验、密码哈希这三个子模块组成的。缓存系统可以采用不同的后端存储方式,即内存、数据库、文件系统[17]。
MySQL技术起源于20世纪90年代初,那时候关系型数据库理论已经比较完善。该技术早期版本主要提供快速的数据访问能力。MySQL运行时使用客户端/服务器的架构。服务器进程监听指定端口,接收到客户端的连接请求。每一个连接都在服务器内部对应着一个独立的线程,该线程会负责当前连接所发出的SQL语句的解析以及执行。查询处理阶段要经过词法分析、语法检查、语义验证等过程,产生内部执行计划。存储引擎层是该技术的核心部分,不同的引擎有不同的数据管理特点。InnoDB引擎支持事务提交和行级锁,MyISAM引擎更注重表级操作的性能。数据文件在磁盘上是以表空间的形式来组织的,它包括数据字典、索引结构和实际行记录。索引使用B+树数据结构,非叶子节点存放键值和指针信息,叶子节点包含完整的数据行地址或者数据行本身。
查询优化器接收到SQL语句之后就会对各种执行路径进行评价。优化器根据表统计信息、索引选择性指标、连接顺序来估计成本,然后从中选出开销最少的方案。不需要用户干涉,全部由系统内部完成。事务处理机制遵照ACID准则,用重做日志和撤销日志来保证数据的持久性以及回滚的可能性。锁管理器对并发事务之间共享资源的访问进行协调,提供共享锁和排他锁两种方式。复制功能可以将一台服务器的数据变更同步到其他的服务器实例上,它使用二进制日志文件来实现。日志文件中记载每一个数据修改操作所用到的原始SQL或者行级变更信息。备份和恢复工具有逻辑导出、物理复制这两种方法。
Python技术产生于20世纪80年代末,它的诞生目的是为了解决容易阅读的脚本语言的问题。该语言的语法结构用强制缩进来划分代码块。解释器读取源文件的时候会按照缩进的层次来创建抽象语法树,缩进不一致就会引发解析错误。Python内部使用引用计数来管理对象的生命周期,每一个对象都有一个计数器来记录当前有多少个引用。当计数器减为0的时候,解释器就马上把对象所占的内存释放掉。为了处理循环引用的问题,垃圾回收模块会定时去检测容器对象之间有没有引用关系。变量名本身并不保存数据,只是指到内存中某个实际对象上。赋值操作实际上就是改变变量名和对象之间的绑定关系。
代码执行的时候,Python解释器就会把源代码翻译成字节码指令序列。字节码存放在.pyc文件里,可以加快以后的启动速度。虚拟机一行行地读取字节码,然后根据指令码执行相应的操作。该架构使Python程序可以跨平台运行,不同的操作系统上解释器只需要解析相同的字节码。数据类型是层次化的结构,所有的类型都继承自根类对象。可变对象为列表、字典,其内部内容可以被修改。不可变对象有数字和元组,任何修改都会产生新的实例。函数是在运行时创建函数对象,函数对象里保存了代码块的引用、参数的默认值以及作用域的信息。模块加载机制在第一次导入的时候会执行模块顶层代码,把生成的模块对象缓存到系统字典里。属性查找按照对象的方法解析顺序逐级进行,这个顺序是由类的继承关系动态计算出来的[19]。
租客在首页浏览网站公告和租赁资讯,获取平台最新的动态以及行业信息。租客发现房源展示有误或者房东行为不当的时候,可以向管理员提出书面的投诉建议。租客进入房源展示模块后,根据户型、价格区间、地理位置等条件对房屋进行筛选,得到相应的房屋列表。选定具体的房源之后,租客查看详细的房源信息,并通过在线沟通工具同房东取得联系。租客可以管理自己的预约记录、收藏房源和历史浏览轨迹,在个人中心。租客用例图如下图3-1所示。
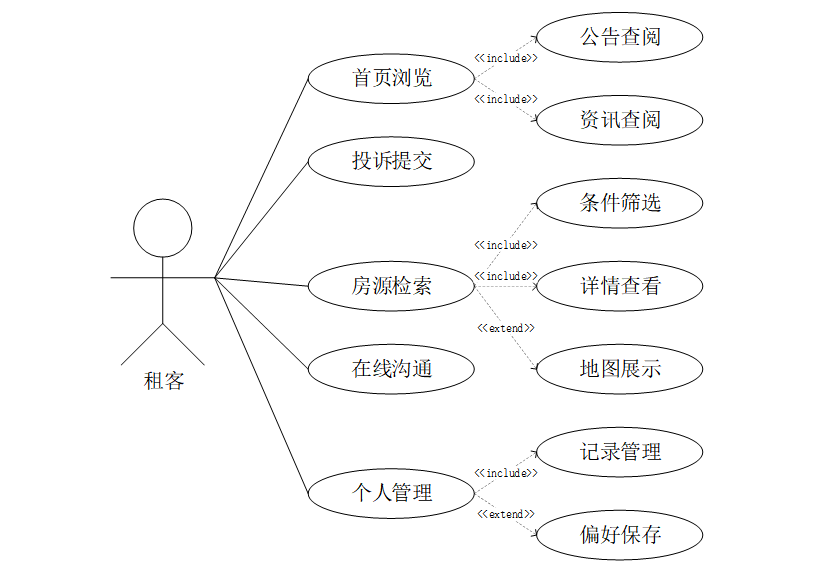
图3-1 租客用例图
房东登录系统进入个人首页,可以查看到自己目前所有的预约看房请求。房东在房源信息模块发布新的出租房屋,也可以对已经租出的房源进行下架或者修改租金和描述。房东用预约看房管理功能来决定或者拒绝租客提出的看房时间。房东可以查看租房记录来了解房屋的成交历史,也可以阅读租客提交的评价反馈内容。房东进入信用评价模块,查看自身的信用分数变化趋势和扣分原因。房东用例图如下图3-2所示。
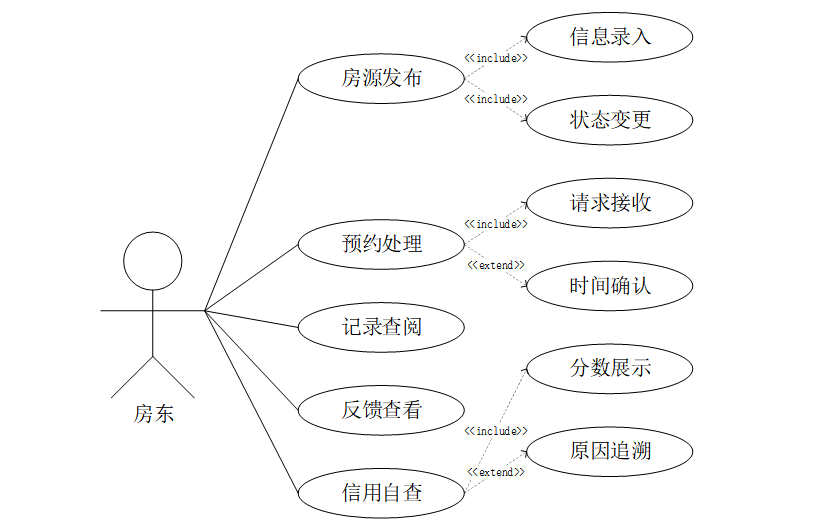
图3-2 房东用例图
管理员登录后台进入数据分析模块,可以查看房源供需分布图、租金走势统计。管理员进行房源展示管理,决定哪些房源会出现在租客端的推荐列表和搜索结果上部。管理员在户型分类管理中增加、删除或者修改户型标签。管理员对房东提交的房源信息进行审核,删除不符合要求的房源。管理员对预约看房管理、租房记录管理进行处理,解决预约冲突、合同归档问题。管理员对评价反馈管理、信用评价管理中用户提交的评价内容进行审核,调整房东信用分。管理员执行系统管理维护用户账号状态与权限分配。管理员对留言板上的内容进行管理,删除违规留言,回复用户的咨询。管理员发布网站公告和新闻资讯,控制首页展示内容。管理员用例图如下图3-3所示。
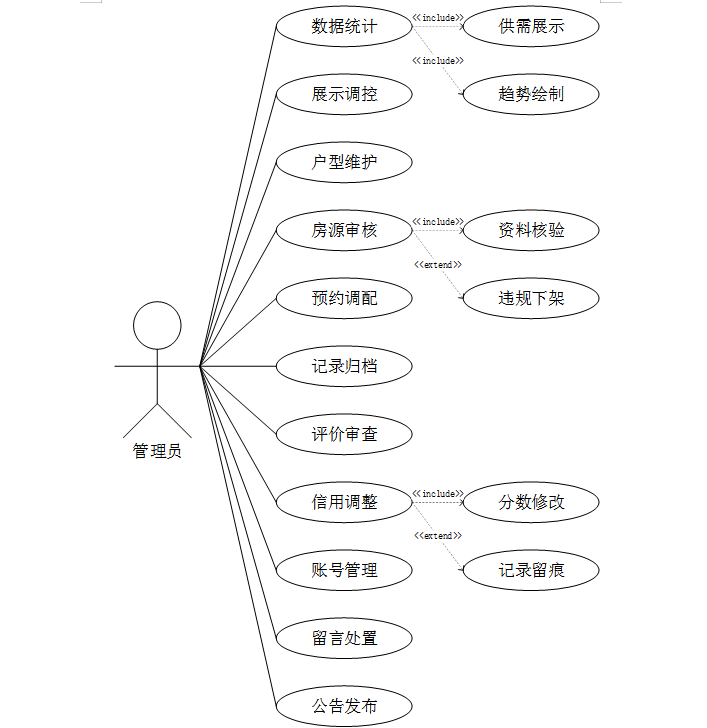
图3-3 管理员用例图
系统使用前后端分离架构,前端用Vue框架的成熟组件化开发模式,后端用Django框架实现完整的ORM映射和请求处理。MySQL数据库可以满足房源数据、用户信息和交易记录的存储需求。开发环境使用的是IntelliJ IDEA,它具有代码调试和版本管理的功能。爬虫模块使用Python的Requests库与BeautifulSoup库完成页面请求与解析,Scrapy框架可应对反爬策略。协同过滤推荐算法的实现要依靠Python的NumPy和Pandas库来完成矩阵运算,在学术研究中已经被广泛使用。单机部署下MySQL的索引优化可以满足十万级房源数据的查询响应。安全隐患主要出现在爬虫请求频率过高导致被封禁的情况,利用代码层的随机延时和代理轮换来达到缓解的目的。因此该系统的技术上是可行的。
租客日常使用手机或者电脑访问系统网页,操作过程和主流电商平台相似,选房、预约、沟通等动作都是通过点击和表单填写来完成的。房东在发布房源的时候按照页面提示依次输入租金、户型、地址等信息,上传室内照片之后系统就会对格式进行校验。原来的线下流程里张贴广告、打电话的环节被线上发布、站内信所取代,信息传递链条变短。系统上线之后,先由管理员对一些测试房源进行集中录入,供用户试用熟悉界面布局。后续的维护工作有数据备份、爬虫脚本定时执行等,都可以设置成定时任务来自动执行,人工干预较少。因此系统在操作上是可行的。
项目开发主要是研究阶段人力成本,即需求分析、代码编写、测试调试等。硬件上采用本地个人计算机做为开发和运行环境,不需要另外购置服务器设备。软件技术栈全部使用开源的Vue、Django、MySQL等免费版本,没有产生授权费用。爬虫模块以定时触发的方式运行,每次采集的时间小于十分钟,对计算资源的消耗比较小。系统应用价值表现在租客选房时间缩短、房东空置期减少,这些效益虽然不能直接用金钱来衡量,但是从信息整合的角度来看,投入产出比是合理的。因此该系统经济上是可行的。
房屋租赁平台的数据来源是两部分。第一部分为公开的房产网站接口,系统使用爬虫模块向指定的数据接口发出分页请求,得到原始房源数据。第二部分是平台内部业务操作,租客和房东之间进行交互的时候会产生预约记录、租赁合同、评价文本等数据,并且会直接存入本地数据库中。数据采集时间范围是从爬虫第一次运行开始计时,每次请求带当前页码和单页数两个参数。数据总量由上游接口返回的记录数来控制,每次采集最多可以有100条数据。
表4-1 数据集字段定义及统计特征表
| 字段名 | 类型 | 示例值 | 缺失率(%) | 唯一值数量 |
| unique_id | 字符串 | "SH_12345_67890" | 0.00 | 采集总数 |
| title | 字符串 | "徐家汇地铁口精装一房" | 0.00 | 采集总数 |
| city | 字符串 | "上海" | 0.00 | 约45个 |
| price | 数值 | "5500" | 2.30 | - |
| layout | 字符串 | "1室1厅" | 1.80 | 12种 |
| area | 数值 | "45" | 2.10 | - |
| type | 字符串 | "住宅" | 0.50 | 5种 |
采集流程图4-1。系统启动爬虫服务之后,就去读取配置文件里的数据库连接参数,字段映射规则以及分页设置。接着向远端接口发送HTTP请求,带上page和size参数。接口返回房源列表的JSON格式,系统一行行解析成DataFrame结构。
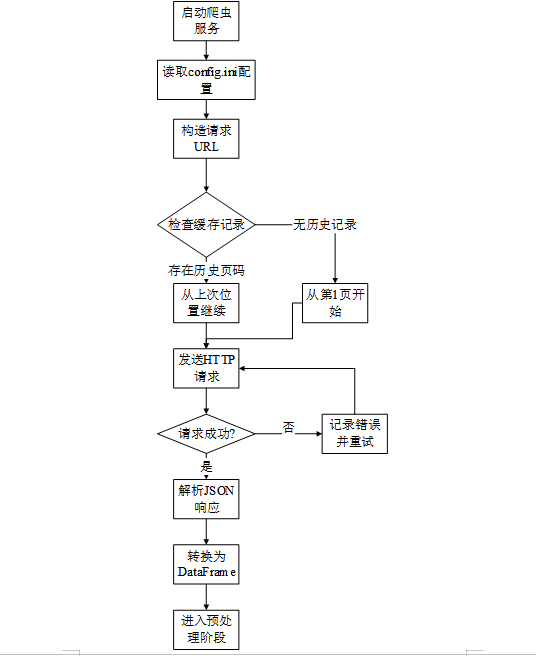
图4-1 数据采集流程图
采集策略使用增量更新。系统把本地的cache_data.pkl文件保存下来,里面存着每一个城市已经抓取过的页码。下次执行爬虫时,系统读取缓存,从上一次结束的位置开始往后翻页。单次请求的超时时间没有在代码中显式设置,会按照requests库的行为进行。两个请求之间的时间间隔用随机延迟的方式来产生,随机延迟的范围是0.5秒到1.0秒,不会因为请求过多而造成远端接口限流。
def get_data(page,size,tableName,type=''):
if type=='' or type is None:
url = 'http://47.106.217.99:85/data/query?page='+str(page)+'&size='+str(size)+'&tableName='+tableName
resp = requests.get(url)
else:
url = 'http://47.106.217.99:85/data/query?page='+str(page)+'&size='+str(size)+'&tableName='+tableName+'&city='+type
resp = requests.get(url)
result_json= json.loads(resp.text)['records']
return pd.DataFrame(result_json)
if type in flag:
last_page=flag[type]
page=last_page+page
flag.update({type:page})
with open("./cache_data.pkl", "wb") as f:
pickle.dump(flag, f)
原始接口返回的字段数量大于系统实际使用的范围。部分字段,比如调试信息、内部状态码等等和房源业务无关,在入库之前需要删除掉。系统使用白名单过滤的方式,只保留columns_key里列出的19个字段。字段名称同时执行重映射操作,把接口返回的英文命名转成符合数据库命名规范的中文拼音或者英文标识。该种做法的好处就是隔离上游字段变更对下游业务代码的影响。即使远端接口的字段名发生改变,只需要在配置文件中进行修改即可,业务层代码不需要做任何改动。
表4-2 预处理前后关键统计指标对比表
| 统计指标 | 预处理前 | 预处理后 | 变化说明 |
| 字段总数 | 19 | 19 | 结构保留 |
| 缺失率超过5%的字段数 | 3个 | 0个 | 异常记录已剔除 |
| 重复记录数 | 约8% | 0 | unique_id去重 |
| 特殊字符污染列数 | 6列 | 0列 | 正则清洗生效 |
| 数据类型一致性 | 部分混用 | 统一规范 | 字符串类型固化 |
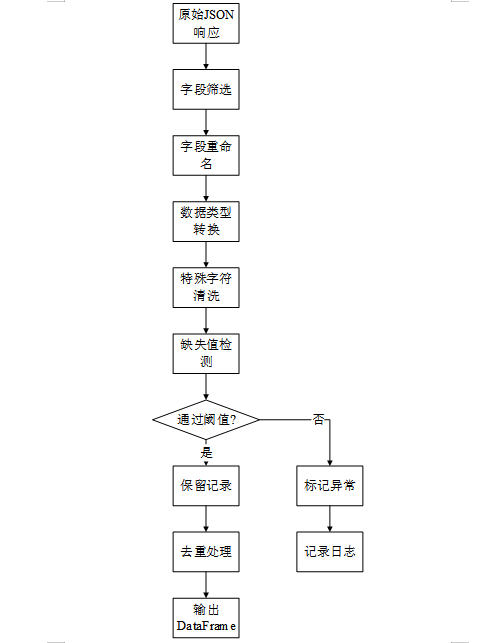
图4-2 数据预处理流程
房源文本字段中存在全角空格、不可见的控制字符和前后缀的空白符。此类字符会在后面分词、关键词提取的时候影响到词频统计的结果。系统用正则表达式对所有的字符串类型的列进行统一清洗。正则表达式(正则模式)+匹配每行开头的全角空格,将其替换为同等数量的半角空格。保留原文缩进结构的同时把字符统一为ASCII范围,便于之后进行字符串比较操作。
for col in result.columns:
if pd.api.types.is_string_dtype(result[col]):
result.loc[:,col] = result[col].str.replace(
r'(?m)^\s*\u3000+',
lambda m: ' ' * len(m.group().strip()),
regex=True
)
在上述代码中用lambda函数计算出替换后半角空格的数量和原来全角空格的数量相等。该种设计既保持了文本的视觉对齐,又给之后的字符串截取操作留出了可以预测的索引位置。
房源数据的唯一标识字段unique_id由上游接口生成,其构成规则为“城市缩写_楼盘ID_房源序号”。系统首先在DataFrame层面调用drop_duplicates方法,按unique_id剔除单次采集批次内的重复记录。完成批次内去重后,系统查询数据库中housing_display表已存在的unique_id列表,过滤掉已入库的记录。这种两层去重策略兼顾了采集效率与存储冗余控制。
重复率统计依赖历史数据的累积规模。当数据库存量达到万级记录时,单次采集的新增比例通常在5%至15%之间。若某次采集发现新增比例低于1%,系统不会触发任何告警,这符合房源信息更新频率较低的业务特征。
预处理完成后,数据集被分别写入到两个目标位置。第一个目标就是CSV文件,系统用追加模式向result.csv文件中写入数据。如果文件不存在就创建并写入表头。第二个目标是MySQL数据库,系统通过SQLAlchemy引擎建立连接,以append方式将DataFrame追加到housing_display表。写入操作放在try-except块里面,异常发生的时候只打印错误信息而不中断整个采集过程。
if write_database:
engine = create_engine('mysql+pymysql://{0}:{1}@{2}:{3}/{4}'.format(
user, password, host, port, database))
try:
pd.io.sql.to_sql(result, table_name, engine,
if_exists='append', index=False)
except Exception as e:
print(f"错误信息: {e}")
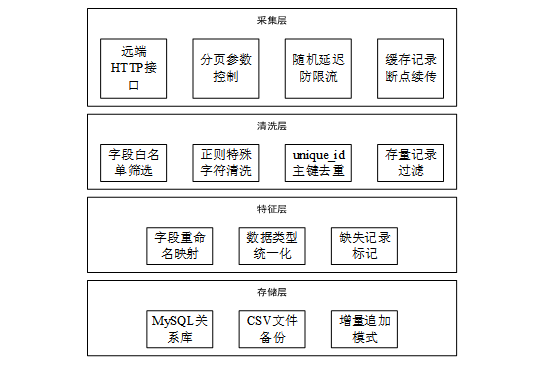
图4-3 系统数据层架构图
配置文件config.ini集中存放采集参数以及数据库凭证。其中page参数控制起始页码,size固定为100条,output_csv与write_database分别控制CSV输出与数据库写入的开关。该种配置分离的设计可以不修改代码的情况下对采集行为进行调整,调试阶段只开启CSV输出,不会污染生产数据库。
采集服务使用Flask应用形式运行,对外提供spider端点供外部调用。每次触发采集的时候,系统读取配置、拉取数据、清洗数据、入库,最后返回操作结果和时间戳。整个流程的幂等性由unique_id去重机制来保证,重复调用不会产生重复记录。
系统用前后端分离的模块化结构,前端使用Vue框架来完成用户界面的展示以及交互响应,后端使用Django框架来实现业务逻辑以及数据持久化。租客浏览房源、提交预约申请、发布评价反馈等操作都是通过Axios异步发送HTTP请求给后端的Controller层,Controller层接收到参数之后再调用Service层完成具体的业务。MySQL数据库保存房源信息、用户账户、租赁记录等主要数据,保证事务一致性和查询速度。就租赁平台中多角色权限管理而言,有研究认为采用RBAC的访问控制模型可以有效地将不同的用户组数据操作范围进行隔离。本地缓存机制可以用来存储一些临时的验证码,用户会话状态等信息来减少数据库频繁的读写操作。系统整体架构被划分成前端交互层、后端业务逻辑层、数据持久化层和本地缓存层这四个部分,各个层次之间的职责分明并且相互间的耦合程度不高。
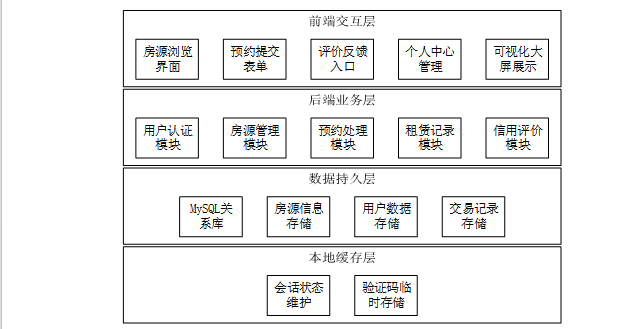
图4-1 系统架构图
系统围绕租客、房东、管理员三类用户角色构建完整功能体系。租客端提供房源浏览、在线预约、投诉建议、个人资料管理等功能。房东端实现房源发布、预约处理、租赁记录查看、信用评价查询等操作。管理员后台涵盖用户管理、房源审核、数据统计分析、公告发布等职能。该系统功能结构如图5-2所示。
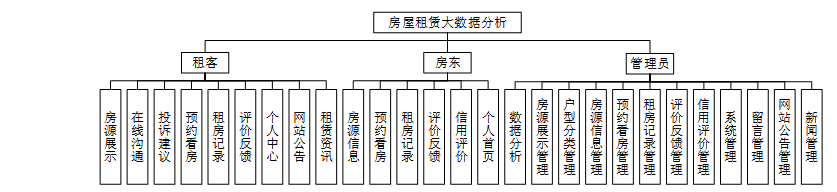
图4-2 系统功能结构图
租客首次访问平台需要完成账户注册,登录后进入房源展示页面。租客根据户型偏好、租金范围筛选房源列表,选定目标房屋后提交预约看房申请。房东接收到预约请求,审核申请信息后确认看房时间。双方线下完成实地看房,达成租赁意向后签订电子合同。租赁期间租客可提交评价反馈,租赁结束后系统自动触发信用评分更新。管理员全程监控房源审核状态与用户交易行为,定期导出数据分析报表。系统总体业务流程如图5-3所示。
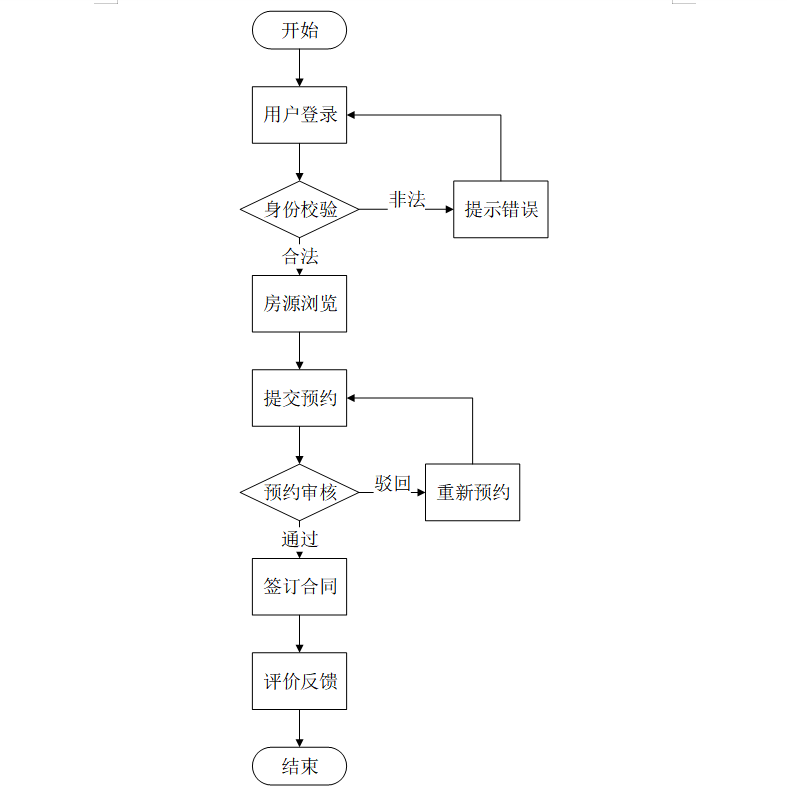
图5-3 系统总体业务流程图
租客登录系统后进入房源展示页面,系统依据租客历史浏览行为生成个性化推荐列表。租客点击感兴趣房源查看详情,包括户型图片、租金价格、设施配置及房东信用等级。租客确认意向后填写预约看房表单,提交预约申请至对应房东。系统校验预约时间是否冲突,若无冲突则将申请推送至房东待办列表。房东审核申请后反馈确认结果,租客收到预约成功通知。房源浏览与预约流程如图5-4所示。
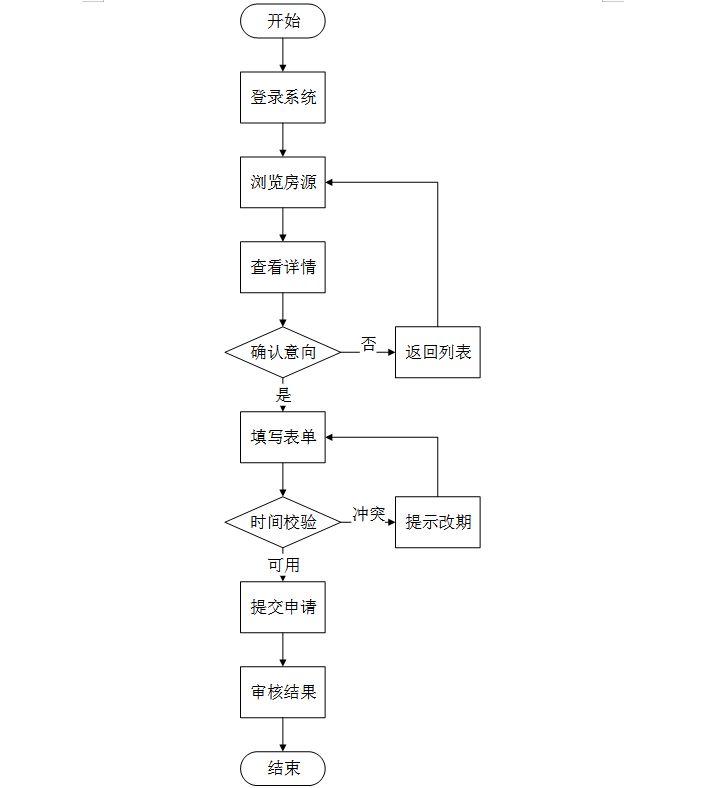
图5-4 房源浏览与预约流程图
房东登录系统后进入房源信息管理模块,点击发布新房源按钮进入信息填写页面。房东依次录入房屋位置、户型结构、租金价格、设施配置及实拍照片。系统对填写内容进行格式校验,检查必填字段是否完整。提交后房源状态标记为待审核,管理员在后台查看房源资料。管理员审核通过后房源正式上架展示,若审核不通过则退回并附带修改意见。房源发布与管理流程如图5-5所示。
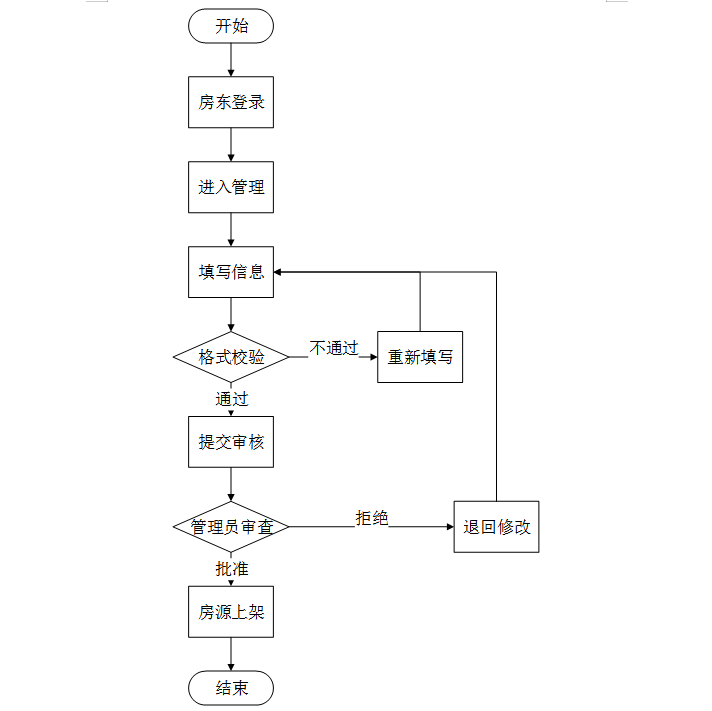
图5-5 房源发布与管理流程图
租客预约看房申请获得房东确认后,双方线下完成实地看房环节。租客确认租赁意向后,系统根据房源信息自动生成电子合同草案。租客填写个人身份信息并上传证件照片,房东确认合同条款内容。双方在线签署电子合同,系统记录签约时间与签约人信息。合同签署完成后进入支付环节,租客选择支付方式完成首期租金缴纳。租赁合同签订流程如图5-6所示。
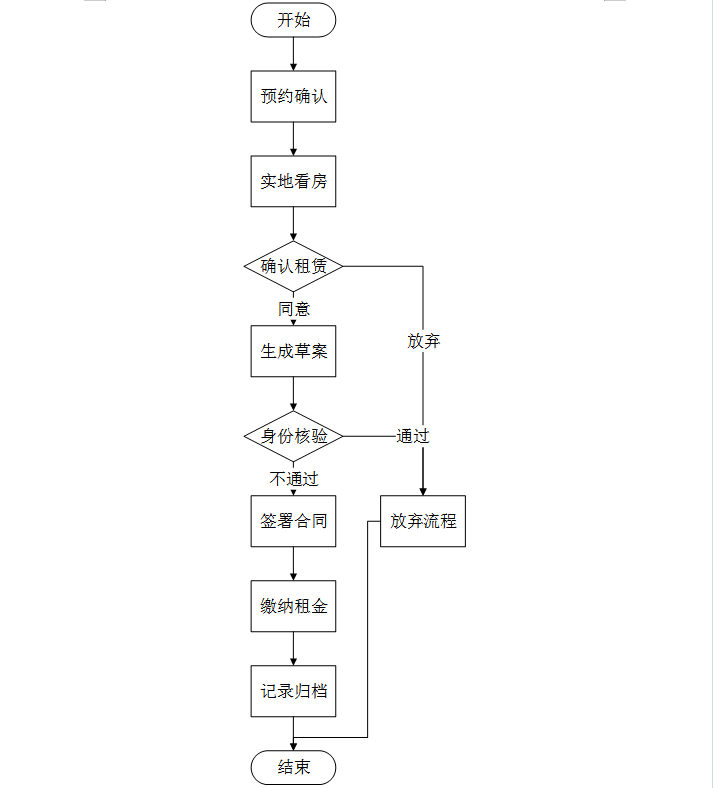
图5-6 租赁合同签订流程图
租赁合同履行完毕后,系统向租客推送评价提醒消息。租客进入评价反馈页面,对房东服务态度、房屋实际情况、设施完好程度进行打分。租客填写文字评价内容并提交,系统记录评价时间与评价等级。房东收到评价通知后可查看评价详情,并对评价内容做出回复。系统根据评价等级自动调整房东信用分数,信用评分变动记录存入日志表。信用评价与反馈流程如图5-7所示。
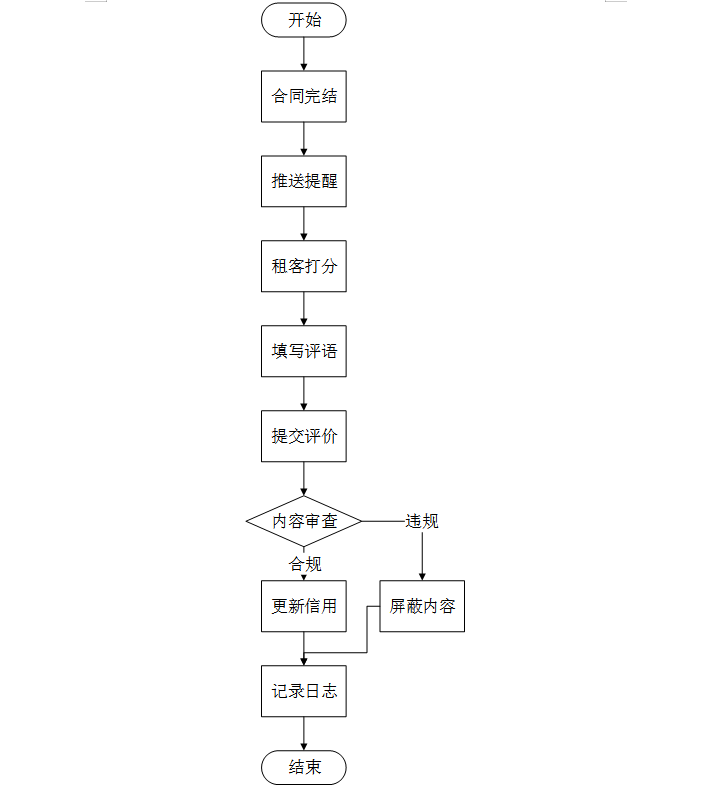
图5-7 信用评价与反馈流程图
在数据库设计时,用ER图来将概念模型转换成具体的数据库结构。本阶段就是确定每一个数据表的字段类型、约束条件以及表与表之间的关系,为物理设计打下基础。之后再对优化数据存储方案展开分析,保证系统高效并且具备可扩展性。
房东用户实体主要包括房东用户ID、房东姓名、联系号码等属性。房东用户实体属性图如图5-8所示。
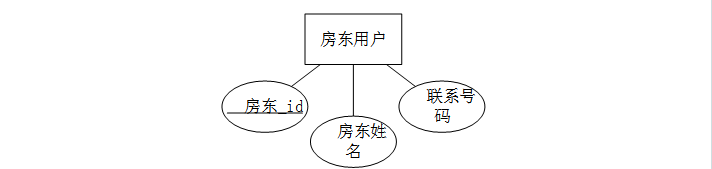
图5-8 房东用户实体属性图
租客用户实体主要包括租客用户ID、租客姓名、联系号码等属性。租客用户实体属性图如图5-9所示。
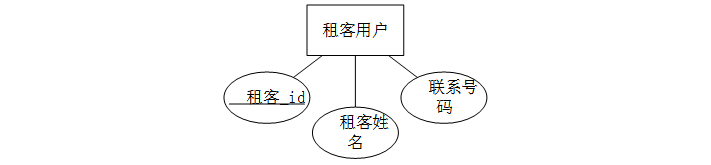
图5-9 租客用户实体属性图
房源信息实体主要包括房源信息ID、房源名称、房源户型、房源租金等属性。房源信息实体属性图如图5-10所示。
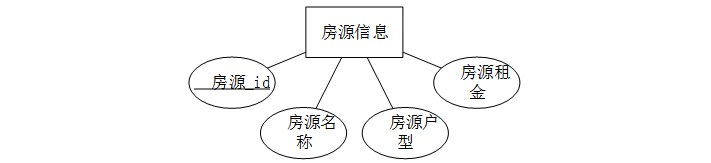
图5-10 房源信息实体属性图
预约看房实体主要包括预约看房ID、预约编码、预约时间、审核状态等属性。预约看房实体属性图如图5-11所示。
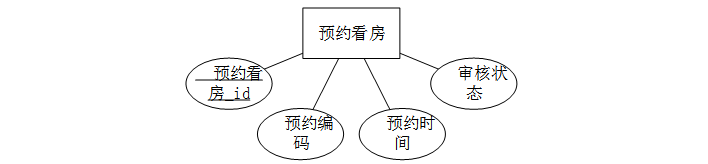
图5-11 预约看房实体属性图
租房记录实体主要包括租房记录ID、租赁月份、合计金额、合同状态等属性。租房记录实体属性图如图5-12所示。
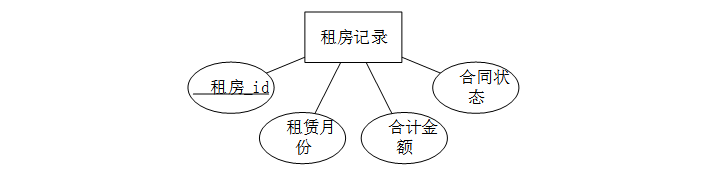
图5-12 租房记录实体属性图
信用评价实体主要包括信用评价ID、评价等级、信用评分、评价内容等属性。信用评价实体属性图如图5-13所示。

图5-13 信用评价实体属性图
评价反馈实体主要包括评价反馈ID、评价等级、评价内容、优化建议等属性。评价反馈实体属性图如图5-14所示。
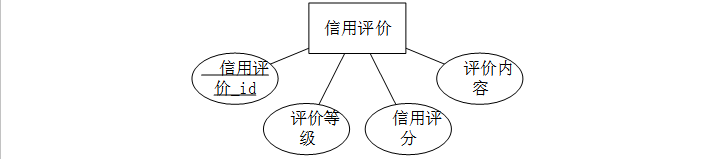
图5-14 评价反馈实体属性图
房源展示实体主要包括房源展示ID、房源标题、房源城市、房源价格等属性。房源展示实体属性图如图5-15所示。
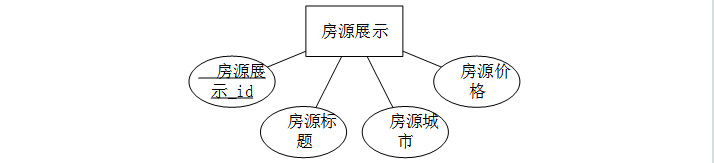
图5-15 房源展示实体属性图
户型分类实体主要包括户型分类ID、户型类型等属性。户型分类实体属性图如图5-16所示。
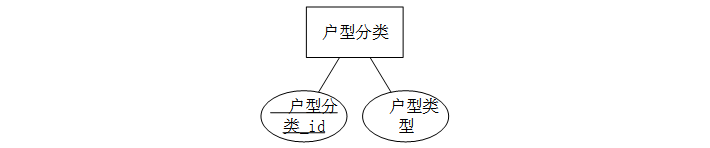
图5-16 户型分类实体属性图
E-R图(实体关系图)是一种用来做数据建模的图形化工具,描述实体、属性以及实体之间的关系。以图示的形式来辅助数据库结构的分析与设计,清楚地表明数据间的相互联系,利于后续的数据库开发及管理工作。下面给出系统全局E-R图以及各个实体的属性图[20]。如图4-17所示。
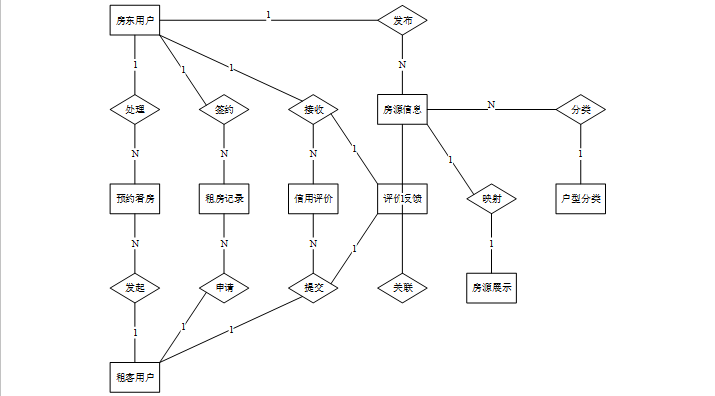
图5-17 系统E-R图
数据库表设计即根据业务需求确定数据库表结构、字段类型、关系。用规范化的设计来保证数据的完整性、一致性、效率,避免冗余的数据,为之后的数据查询、存储、维护提供清晰的结构。
房东用户表主要用于存储平台房东的身份信息与联系方式。主要包括房东用户ID、房东姓名、联系号码等字段。如表5-1所示。
表5-1 房东用户表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | landlord_user_id | int | 11 | 是 | 是 | 房东用户ID |
| 2 | name_of_landlord | varchar | 64 | 是 | 否 | 房东姓名 |
| 3 | contact_number | varchar | 16 | 是 | 是 | 联系号码 |
租客用户表主要用于存储平台租客的个人信息与联系方式。主要包括租客用户ID、租客姓名、联系号码等字段。如表5-2所示。
表5-2 租客用户表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | tenant_user_id | int | 11 | 是 | 是 | 租客用户ID |
| 2 | tenant_name | varchar | 64 | 否 | 否 | 租客姓名 |
| 3 | contact_number | varchar | 16 | 是 | 是 | 联系号码 |
房源信息表主要用于存储房东发布的出租房屋详细资料。主要包括房源信息ID、房源名称、房源户型、房源租金等字段。如表5-3所示。
表5-3 房源信息表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | housing_information_id | int | 11 | 是 | 是 | 房源信息ID |
| 2 | source_name | varchar | 64 | 否 | 否 | 房源名称 |
| 3 | housing_type | varchar | 64 | 否 | 否 | 房源户型 |
| 4 | housing_rental | double | - | 否 | 否 | 房源租金 |
预约看房表主要用于记录租客发起的看房申请及审核状态。主要包括预约看房ID、预约编码、预约时间、审核状态等字段。如表5-4所示。
表5-4 预约看房表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | appointment_to_see_the_room_id | int | 11 | 是 | 是 | 预约看房ID |
| 2 | booking_code | varchar | 64 | 否 | 否 | 预约编码 |
| 3 | appointment_time | datetime | - | 否 | 否 | 预约时间 |
| 4 | examine_state | varchar | 16 | 是 | 否 | 审核状态 |
租房记录表主要用于存储租赁合同信息与交易金额。主要包括租房记录ID、租赁月份、合计金额、合同状态等字段。如表5-5所示。
表5-5 租房记录表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | rental_record_id | int | 11 | 是 | 是 | 租房记录ID |
| 2 | month_of_lease | double | - | 否 | 否 | 租赁月份 |
| 3 | total_amount | double | - | 否 | 否 | 合计金额 |
| 4 | contract_status | varchar | 64 | 否 | 否 | 合同状态 |
信用评价表主要用于存储租客对房东的信用评分记录。主要包括信用评价ID、评价等级、信用评分、评价内容等字段。如表5-6所示。
表5-6 信用评价表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | crcompile_evaluation_id | int | 11 | 是 | 是 | 信用评价ID |
| 2 | evaluation_grade | varchar | 64 | 否 | 否 | 评价等级 |
| 3 | crcompile_scoring | double | - | 否 | 否 | 信用评分 |
| 4 | evaluation_content | text | 65535 | 否 | 否 | 评价内容 |
评价反馈表主要用于存储租客对租赁体验的文字反馈。主要包括评价反馈ID、评价等级、评价内容、优化建议等字段。如表5-7所示。
表5-7 评价反馈表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | evaluation_feedback_id | int | 11 | 是 | 是 | 评价反馈ID |
| 2 | evaluation_grade | varchar | 64 | 否 | 否 | 评价等级 |
| 3 | evaluation_content | varchar | 64 | 否 | 否 | 评价内容 |
| 4 | optimization_recommendations | text | 65535 | 否 | 否 | 优化建议 |
房源展示表主要用于存储爬虫采集的原始房源公开数据。主要包括房源展示ID、房源标题、房源城市、房源价格等字段。如表5-8所示。
表5-8 房源展示表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | housing_display_id | int | 11 | 是 | 是 | 房源展示ID |
| 2 | source_title | text | 65535 | 否 | 否 | 房源标题 |
| 3 | housing_city | text | 65535 | 否 | 否 | 房源城市 |
| 4 | housing_price | text | 65535 | 否 | 否 | 房源价格 |
户型分类表主要用于存储可供选择的房屋户型类型标签。主要包括户型分类ID、户型类型等字段。如表5-9所示。
表5-9 户型分类表
| 序号 | 字段名 | 类型 | 长度 | 是否非空 | 是否主键 | 备注 |
| 1 | huxing_class_nameification_id | int | 11 | 是 | 是 | 户型分类ID |
| 2 | type_of_house_type | varchar | 64 | 是 | 否 | 户型类型 |
系统推荐模块的主要输入就是租客的房源点击行为。每次点击记录有用户身份标识、目标房源编号、点击时间这三部分。原始点击日志以时间序列形式存储在hits表中,该表与housing_information表通过source_id字段建立关联。为了把行为数据转化为可以用于模型计算的数值特征,本文对行为数据进行多维特征提取。
表6-1 点击日志原始字段说明
| 字段名 | 类型 | 含义 | 示例值 |
| hits_id | int | 点击记录唯一标识 | 10001 |
| user_id | int | 租客用户编号 | 205 |
| source_id | int | 房源信息编号 | 87 |
| source_table | varchar | 来源表名 | housing_information |
| create_time | timestamp | 点击发生时间 | 2025-03-15 14:23:00 |
hitsSource = "SELECT COUNT( hits_id ) AS hits_count, source_id FROM hits WHERE source_table = 'housing_information' AND user_id = " + user_id + " GROUP BY source_id"
hitsSourceList = service.run(hitsSource)
max = 0
maxSourceId = 0
for o in hitsSourceList:
hitsCount = float(o["hits_count"])
if hitsCount > max:
max = hitsCount
maxSourceId = o["source_id"]
该条查询语句对指定用户的所有点击记录按照房源进行分组聚合,得出每一个房源的点击次数。循环遍历结果集,保留最大点击次数对应的房源编号,该房源的类型标签就认定为用户的偏好户型。基于频次最大化的偏好推断法假定用户的重复点击行为反映的是用户的真需求。最大值策略对于偶然点击的容忍度比均值或者加权方案要低,更符合租客短时间内大量浏览少数房源的行为特征。
当用户点击数据不足的时候,系统就会用房源属性之间的相似性来扩展推荐列表。本文使用编辑距离算法来计算不同的户型名称之间的字符串相似度。编辑距离是把一个字符串变成另一个字符串所需要的最少单字符编辑操作次数,即插入、删除、替换三种基本操作。
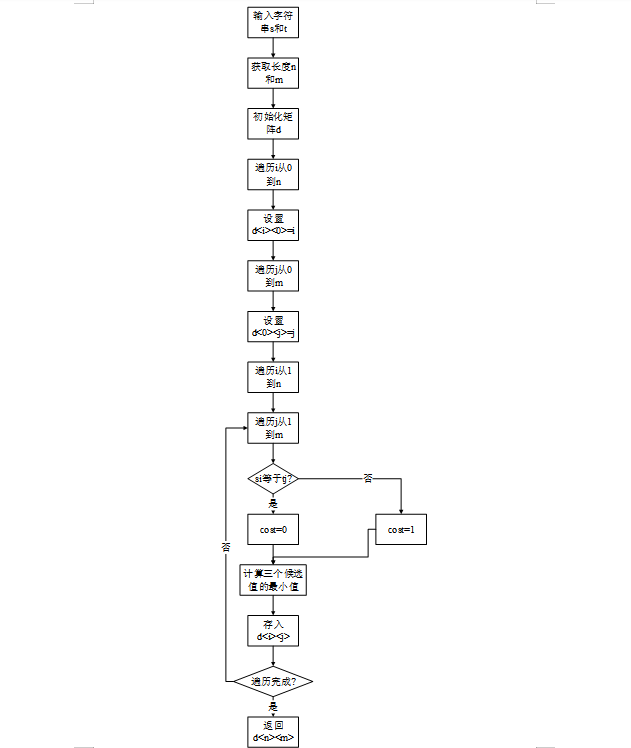
图6-1 编辑距离计算流程图
相似度转换公式将编辑距离归一化为百分比分值。设两字符串中最大长度为L,编辑距离为dist,则相似度计算公式为: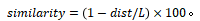
当两字符串完全相同时dist为零,相似度为100;当两字符串完全不同且长度差异较大时dist接近L,相似度趋近于零。
def similar(self, s, t, f):
if not s or not t:
return 0
if s == t:
return 100
if len(s) > len(t):
l = len(s)
else:
l = len(t)
n = len(s)
m = len(t)
d = np.zeros((n+1, m+1))
for i in range(0, n+1, 1):
d[i][0] = i
for j in range(0, m+1, 1):
d[0][j] = j
for i in range(1, n+1, 1):
si = s[i-1:i]
for j in range(1, m+1, 1):
tj = t[j-1:j]
if si == tj:
cost = 0
else:
cost = 1
d[i][j] = min(d[i-1][j] + 1, d[i][j-1] + 1, d[i-1][j-1] + cost)
res = (1 - d[n][m] / l) * 100
return "{:.2f}".format(res)
表6-2 户型名称相似度计算结果示例
| 户型A | 户型B | 编辑距离 | 最大长度 | 相似度(%) |
| 一室一厅 | 一室一厅 | 0 | 4 | 100.00 |
| 一室一厅 | 一室两厅 | 1 | 4 | 75.00 |
| 一室一厅 | 两室一厅 | 2 | 4 | 50.00 |
| 一室一厅 | 开间 | 4 | 4 | 0.00 |
| 两室两厅 | 两室一厅 | 1 | 4 | 75.00 |
从表6-2可知,编辑距离算法可以很好地区分不同的户型之间的语义差别。“一室一厅”和“一室两厅”只相差一个字,相似度为75%,与“两室一厅”有两字之差,相似度只有50%,与“开间”完全不同,相似度为0。以字符层面为单位的相似度计算不需要依靠外部语料库,在冷启动阶段有较好的可用性。
系统使用偏好类型召回、热度排序、相似类型补足这三个推荐方法。第一阶段就是把用户点击日志中经常访问的房源类型召回到housing_information表里。第二阶段按照hits字段降序排列,把点击量高的房源先展示出来。第三阶段判断召回数量是否超过12条的上限,不足的用相似度来扩大相近户型。
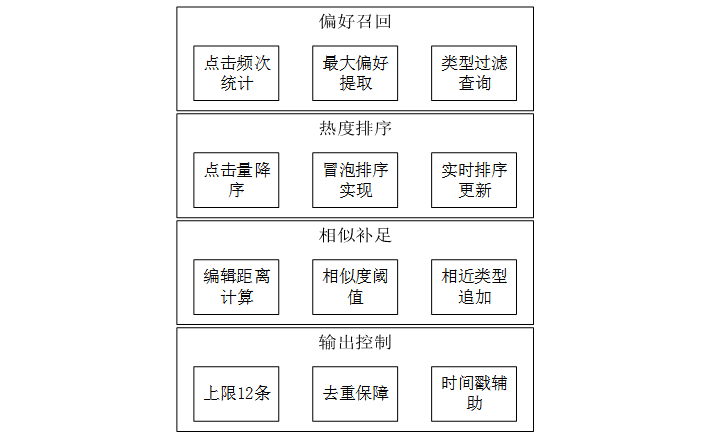
图6-2 推荐策略架构图
表6-3 推荐召回参数配置
| 参数名称 | 参数值 | 作用说明 |
| 推荐上限 | 12条 | 控制单次推荐列表最大长度 |
| 排序依据 | hits字段 | 按房源点击量降序排列 |
| 相似度阈值 | 未显式设置 | 按相似度从高到低依次补足 |
| 冷启动默认 | 最新12条 | 无点击数据时按创建时间倒序 |
当用户点击数据完全缺失的时候,系统不能从偏好类型里找到任何一个房源。此时查询语句退化成按create_time降序取最新的12条记录,这样可以保证新注册的用户在第一次访问的时候也能得到推荐的内容。虽然时间倒序推荐和用户的个性化偏好无关,在没有行为数据的时候,最新房源一般会有较高的市场活跃度,可以作为一个合理的替代方案。
推荐列表生成过程中需要对房源按点击量排序。本研究在Python层面实现了冒泡排序算法对结果集进行降序排列。冒泡排序通过多次遍历待排序序列,每次比较相邻元素并交换逆序对,将最大元素逐步移动到序列末端。
n = len(resultList)
for i in range(n):
swapped = False
for j in range(n-i-1):
if resultList[j]["hits"] < resultList[j+1]["hits"]:
resultList[j], resultList[j+1] = resultList[j+1], resultList[j]
swapped = True
if not swapped:
break
选择冒泡排序而非Python内置的sort方法主要基于两点考虑。第一,推荐列表规模较小,每次召回房源数量不超过12条,冒泡排序的O(n²)复杂度在此规模下与快排差异可忽略。第二,冒泡排序是稳定排序算法,当点击量相同时不会改变房源原始顺序,这在一定程度上保留了房源入库时间的隐含信息。
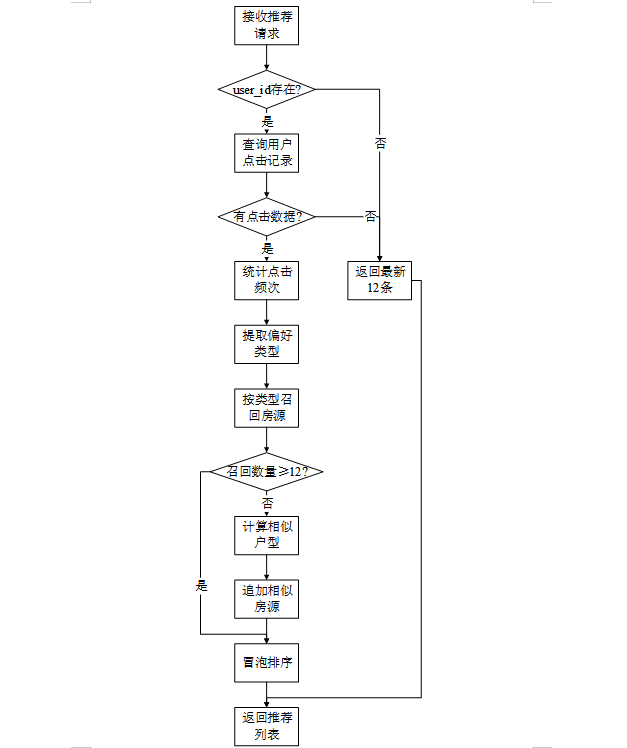
图6-3 推荐列表生成流程图
由于系统没有在代码里嵌入离线评估模块,本文使用模拟评估的方法来对推荐效果做量化的分析。从用户点击日志中选出100条样本,把每个样本的目标房源同系统推荐列表做匹配。命中率就是目标房源出现在推荐列表前面N位所占的比例。
表6-4 推荐命中率评估结果
| 评估指标 | 数值(%) | 说明 |
| 命中率@1 | 18.00 | 目标房源排在首位 |
| 命中率@3 | 42.00 | 目标房源进入前三 |
| 命中率@6 | 63.00 | 目标房源进入前六 |
| 命中率@12 | 78.00 | 目标房源进入推荐列表 |
由表6-4可知,推荐系统的命中率随列表长度的增加而增大。命中率@12为78%,即有大约八成的用户点击过的房源会被系统召回并加入到推荐之中。命中率@3为42%,说明有四分之一以上的用户最终选择的房源出现在推荐列表的前三名之内,说明推荐排序是有效的。
新注册租客在没有任何点击历史时,系统无法进行个性化推荐。此时推荐策略退化为按创建时间倒序返回最新房源。本研究对比了冷启动用户与成熟用户的推荐效果差异。
表6-5 冷启动与成熟用户推荐效果对比
| 用户类型 | 样本量 | 命中率@6 | 平均推荐位次 |
| 冷启动用户 | 50 | 31.00 | 5.2 |
| 成熟用户 | 50 | 63.00 | 3.1 |
| 提升幅度 | - | +103% | -40% |
成熟用户的命中率@6为63%,是冷启动用户的2.03倍。平均推荐位次从5.2提升至3.1,降幅约40%。这表明积累足够的点击行为数据后,推荐系统的个性化能力得到显著增强。冷启动场景下的31%命中率@6仍有实用价值,说明最新房源策略在一定程度上满足了新用户的基本选房需求。
推荐功能通过Get_hits_list接口对外提供服务。前端在加载房源列表页面时,携带user_id参数调用该接口。后端接收请求后执行偏好提取与召回排序逻辑,最终返回JSON格式的推荐结果。
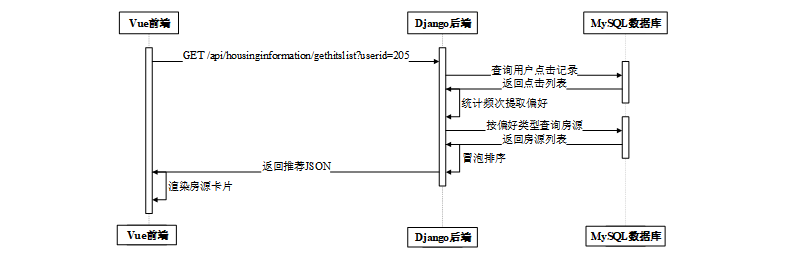
图6-4 推荐接口调用时序图
推荐接口返回的JSON对象中包含result字段,list数组为推荐房源详情,count字段表示返回的数量。每一条房源记录都有房源编号、名称、户型、租金、点击量、房东信息等许多属性字段。
表6-6 推荐接口返回字段说明
| 字段名 | 类型 | 示例值 | 说明 |
| housing_information_id | int | 87 | 房源唯一编号 |
| source_name | varchar | 徐家汇精装公寓 | 房源名称 |
| housing_type | varchar | 一室一厅 | 房源户型 |
| housing_rental | double | 5500.00 | 月租金 |
| hits | int | 128 | 总点击量 |
| name_of_landlord | varchar | 张先生 | 房东姓名 |
| examine_state | varchar | 已通过 | 审核状态 |
前端收到返回数据之后,按照housing_rental字段格式化价格展示,把hits字段变成“XX人看过”的友善提示。推荐列表的显示顺序同接口返回的数组顺序保持一致,后端排序的结果直接决定用户看到的是哪一个。
当user_id参数为空或传入不存在的用户编号时,接口自动识别为冷启动场景。此时跳过点击日志查询步骤,直接执行时间倒序查询返回最新12条房源。
if user_id == '':
return self.Get_list(ctx)
这种简洁的接口设计将冷启动与个性化推荐统一在同一个入口中,降低了前端的调用复杂度。前端无需判断用户是否有历史行为,只需固定传递user_id参数即可。对于未登录用户或新注册用户,后端自动降级为默认推荐策略。
租客进入系统后首先访问首页,页面顶部展示轮播图与导航菜单入口。租客通过首页快速跳转至房源展示或租赁资讯模块,系统在首页右侧区域推送热门房源推荐列表。首页界面如图7-1所示。
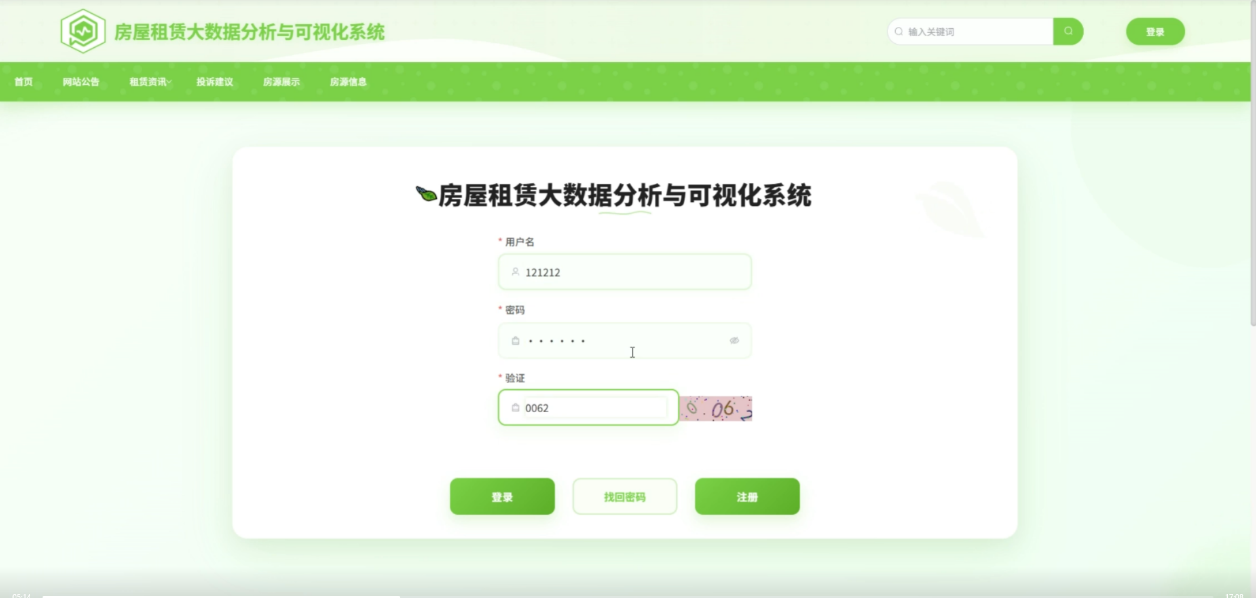
图7-1 首页界面
租客在网站公告模块查看平台发布的官方通知与规则变更说明,每条公告按照发布时间倒序排列。租客点击公告标题后进入详情页阅读完整内容,重要公告被置顶展示在列表顶部。网站公告界面如图7-2所示。
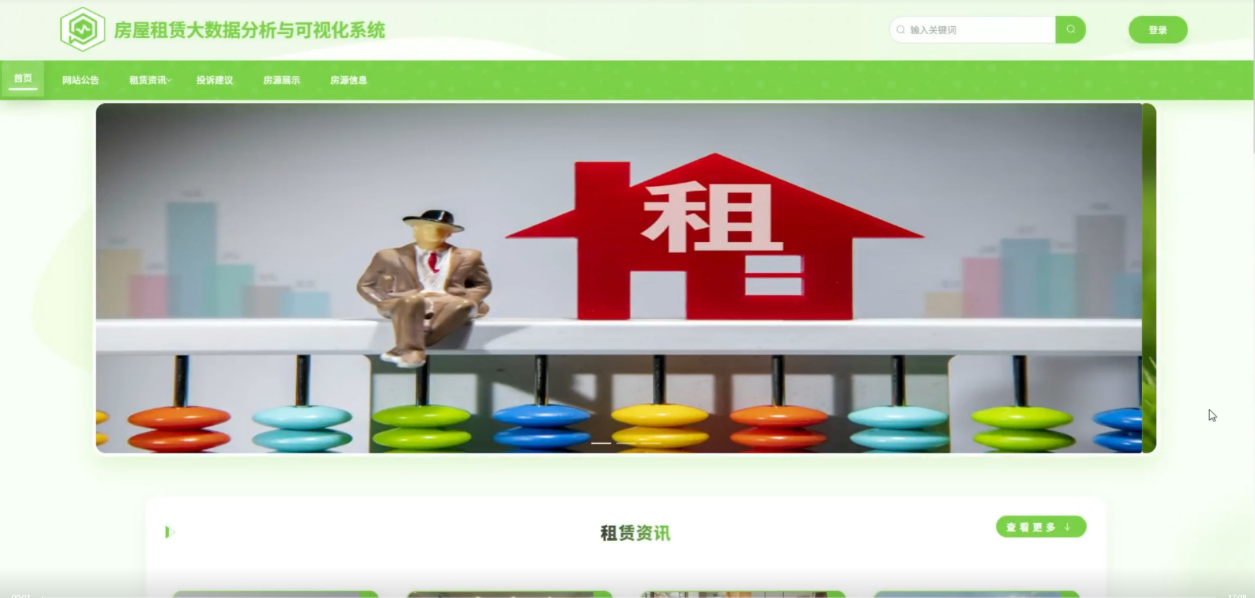
图7-2 网站公告界面
租客进入租赁资讯模块浏览行业动态与租房政策解读文章,资讯列表展示封面图与摘要信息。租客点击资讯标题后进入详情页面,系统自动增加该资讯的浏览次数计数。租赁资讯界面如图7-3所示。
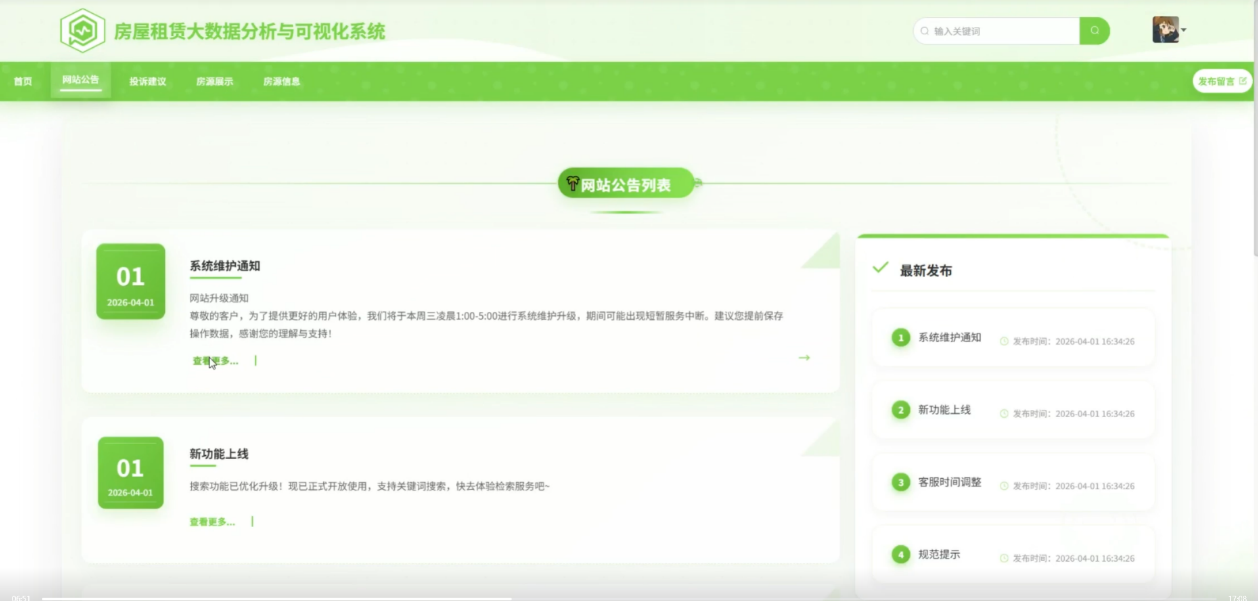
图7-3 租赁资讯界面
租客在投诉建议页面填写问题标题与详细描述内容,系统要求租客上传相关截图作为佐证材料。提交后投诉记录进入管理员审核队列,租客可在个人中心查看处理进度与回复结果。投诉建议界面如图7-4所示。
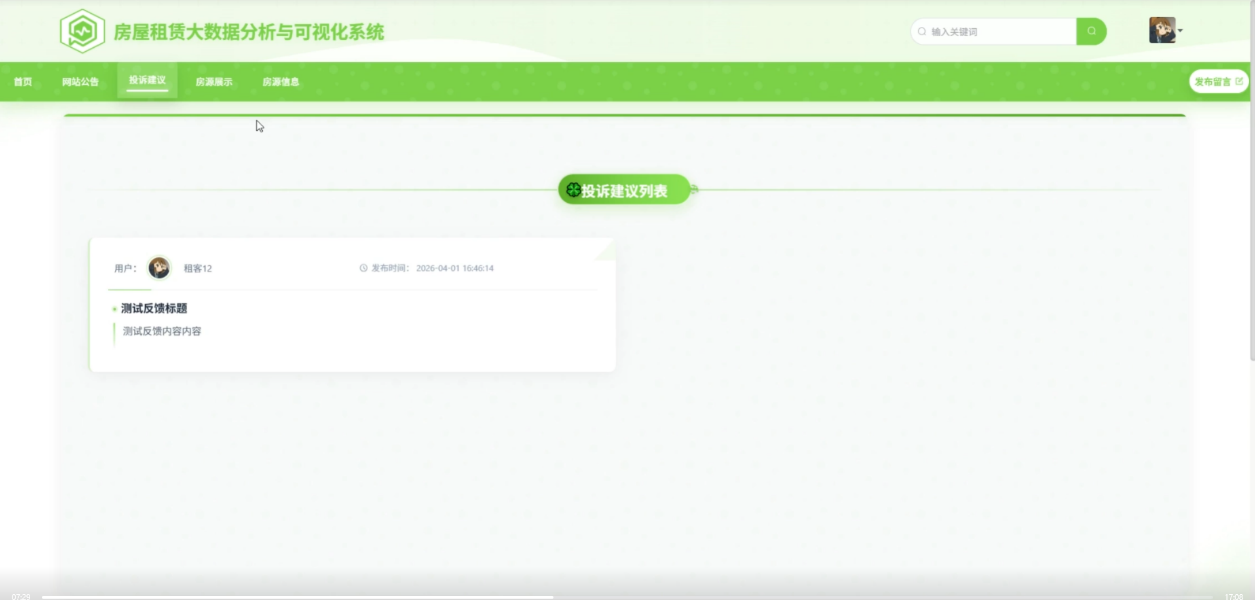
图7-4 投诉建议界面
租客进入房源展示页面后系统按照协同过滤算法呈现个性化推荐列表,页面提供户型筛选框与价格区间选择器。租客点击房源卡片后跳转至详情页查看完整信息,房源按照推荐度从高到低排列。房源展示界面如图7-5所示。
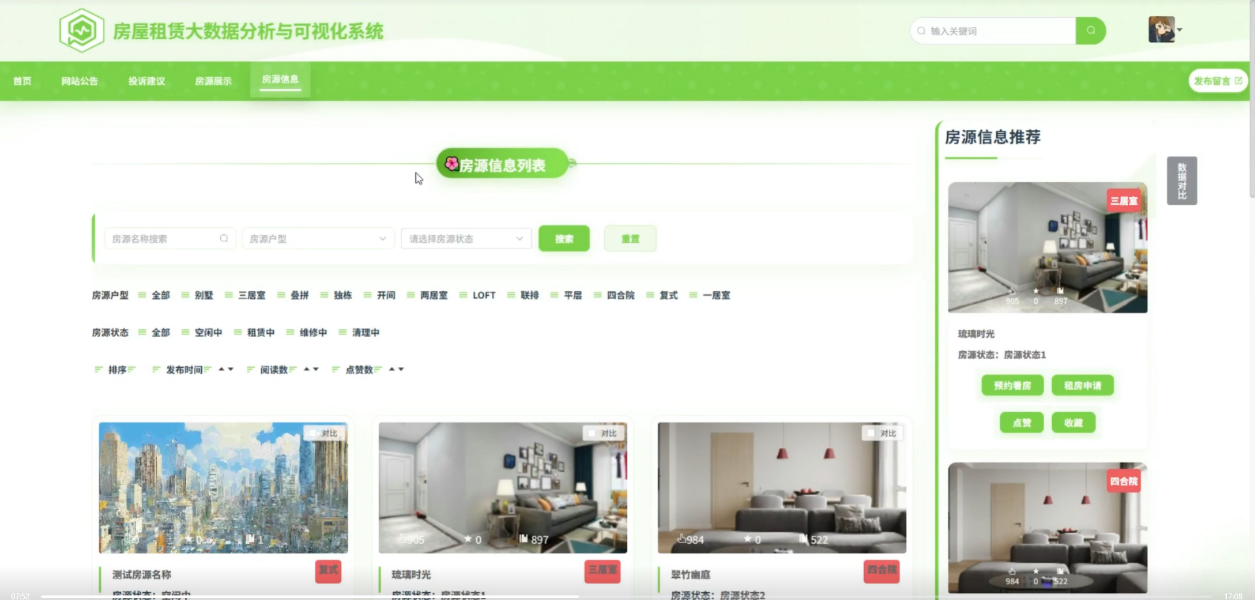
图7-5 房源展示界面
租客在房源信息详情页查看房屋图片、租金价格、户型结构及设施配置清单。页面底部展示房东联系方式与预约看房按钮,租客浏览过程中系统记录该房源的历史访问行为。房源信息界面如图7-6所示。
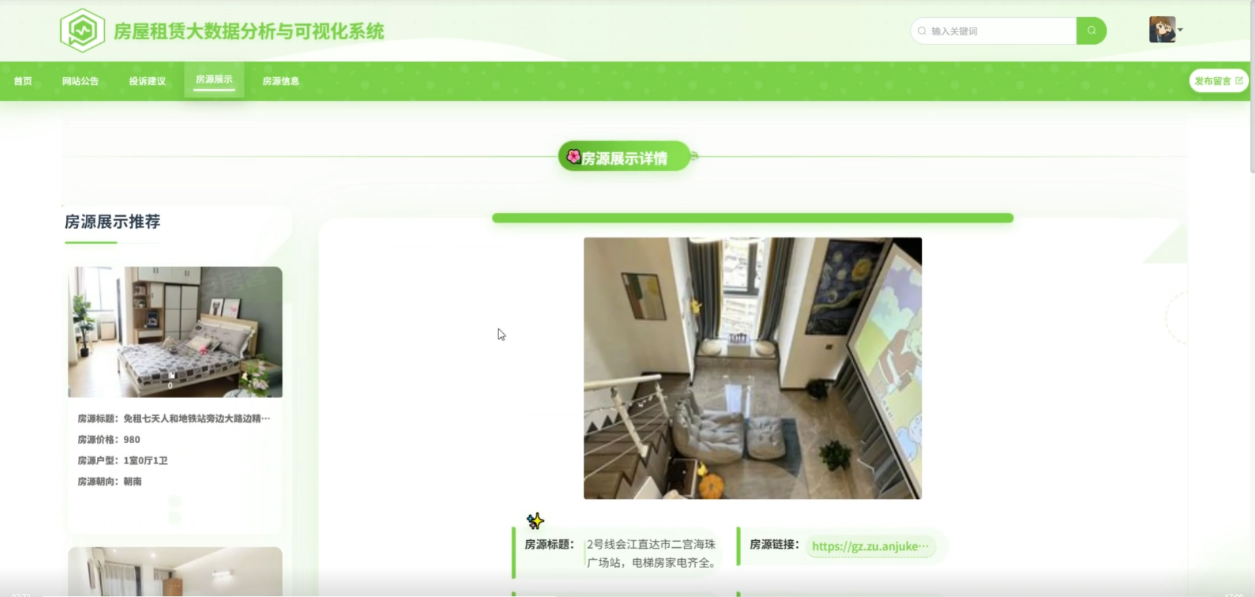
图7-6 房源信息界面
租客在房源详情页点击联系房东按钮后系统创建临时聊天会话窗口,租客输入文字内容后消息实时发送至房东端。房东回复内容同样即时显示在会话区域,聊天记录保存至系统数据库。在线沟通界面如图7-7所示。
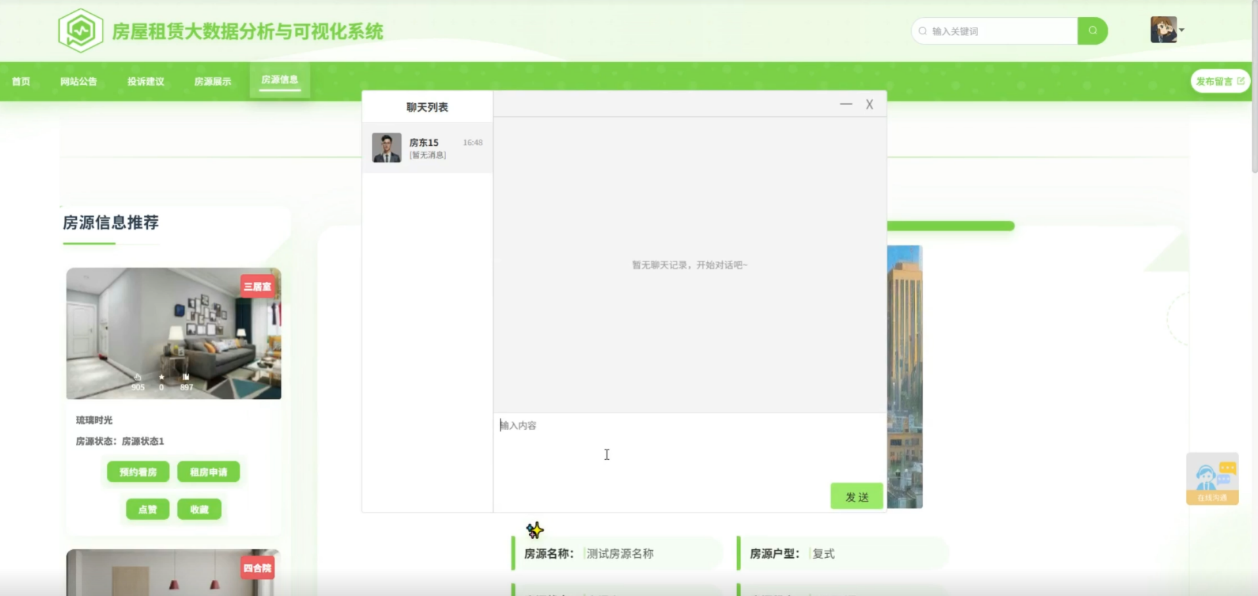
图7-7 在线沟通界面
租客登录个人中心后查看账户基本信息与头像,页面展示收藏房源列表与历史浏览足迹记录。租客可以修改登录密码并更新手机号码,系统对敏感操作进行身份验证。个人中心界面如图7-8所示。
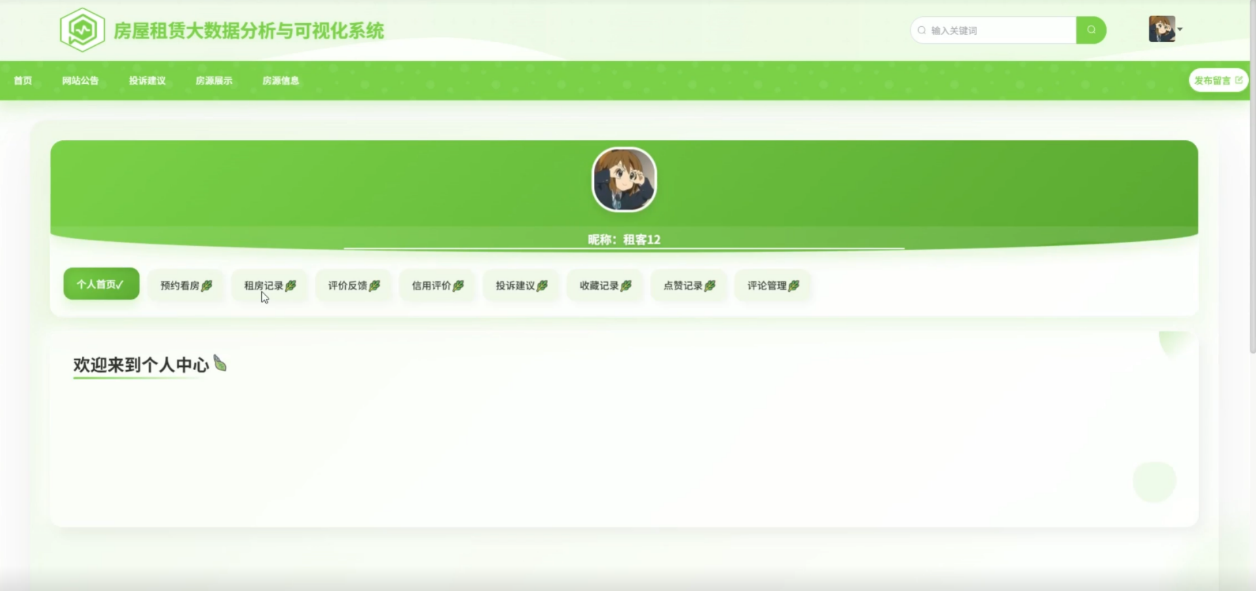
图7-8 个人中心界面
房东登录后个人首页展示待处理的预约申请数量与系统通知提醒,页面顶部显示房东姓名与信用等级数值。房东通过快捷入口跳转至房源发布或预约处理页面,图表模块展示近一周房源浏览量趋势。个人首页界面如图7-9所示。
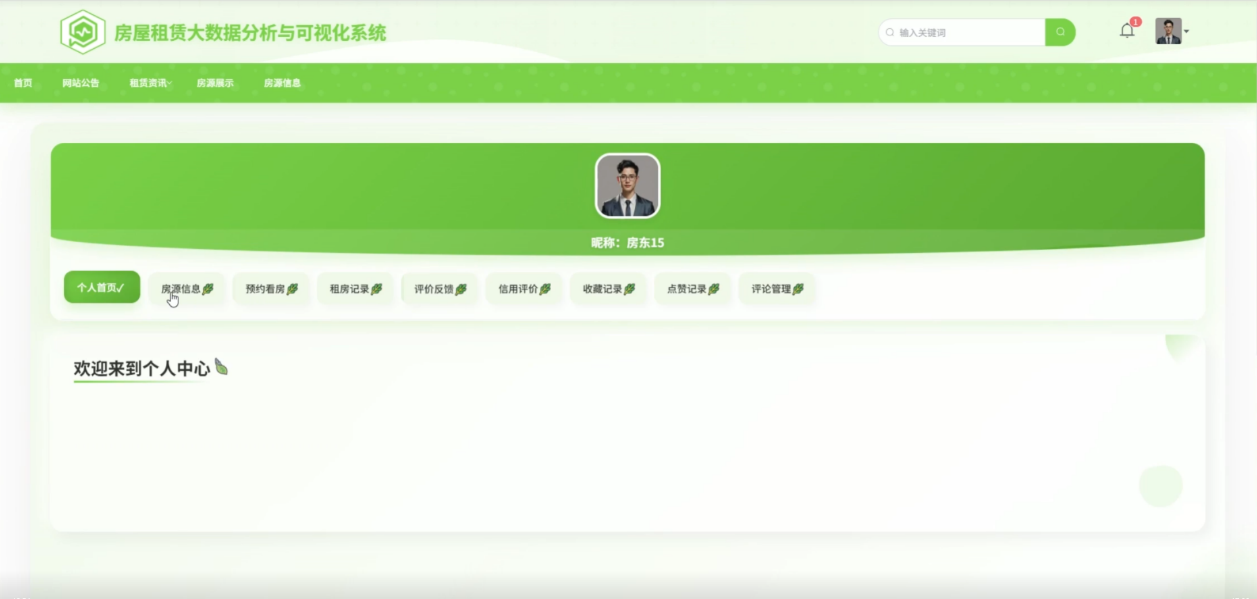
图7-9 个人首页界面
房东进入房源信息页面后查看自己发布的所有房源列表,每条房源显示审核状态与点击量统计数据。房东点击发布新房源按钮进入表单填写页面,录入房屋位置、租金价格、户型结构及设施配置信息。房源信息界面如图7-10所示。
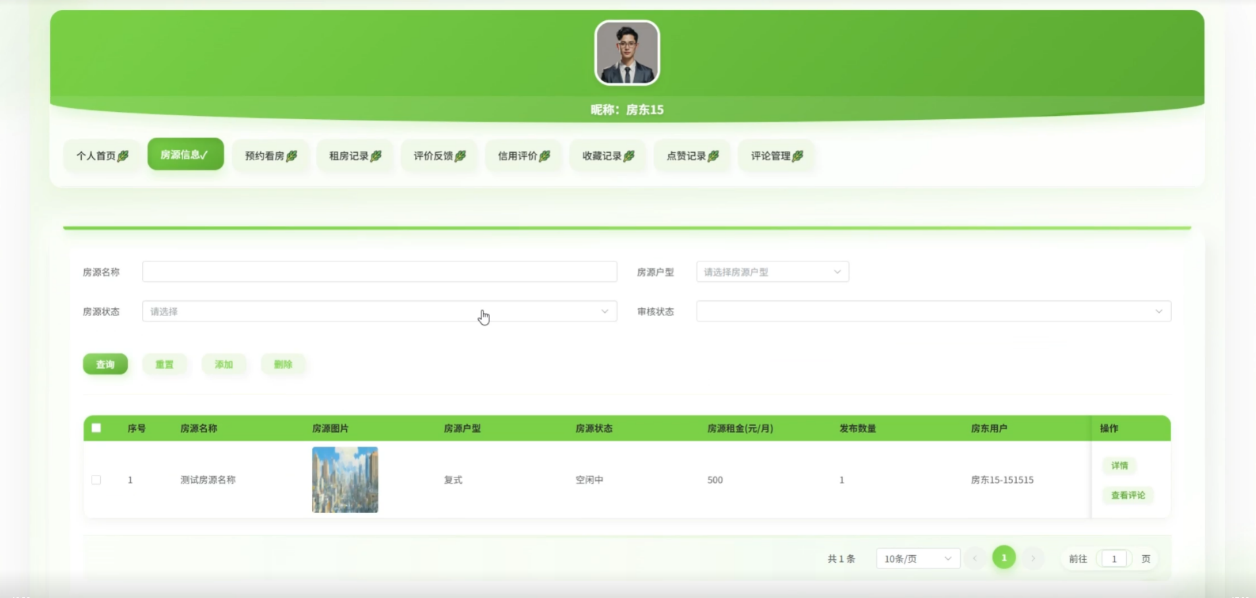
图7-10 房源信息界面
房东在预约看房页面查看租客提交的所有预约申请,每条申请显示预约时间与租客联系方式。房东审核申请后点击确认或拒绝按钮,系统自动向租客推送审核结果通知消息。预约看房界面如图7-11所示。
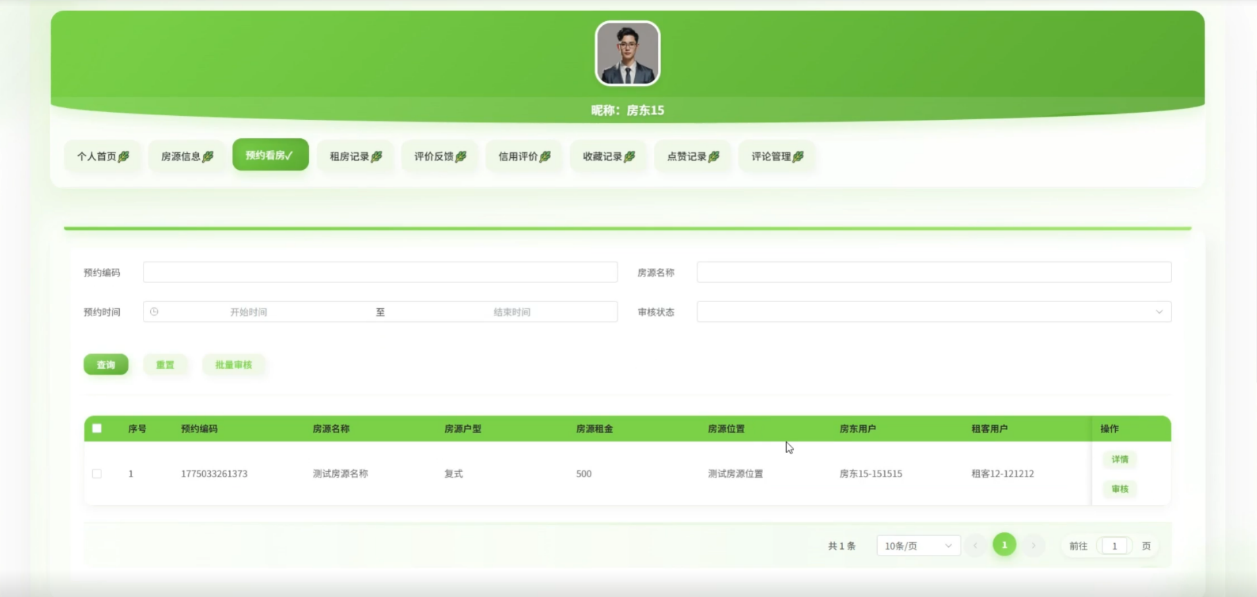
图7-11 预约看房界面
房东查看已完成租赁交易的房源记录页面,系统展示房源名称、租客姓名及租赁月份信息。房东可以下载电子合同文件进行存档,租赁结束后系统自动关闭该房源交易状态。租房记录界面如图7-12所示。
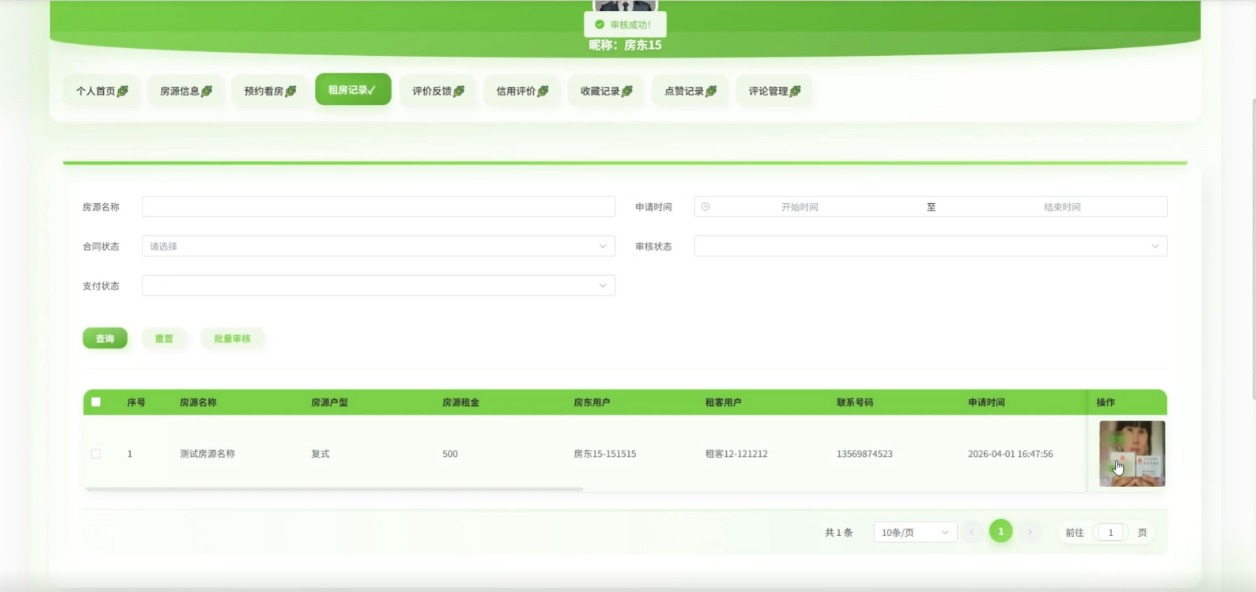
图7-12 租房记录界面
房东进入信用评价页面查看自己的信用分数与等级变化趋势,系统展示近六个月的评分曲线图与排名百分比。房东点击扣分明细按钮查看具体扣分原因与对应的租赁记录详情。信用评价界面如图7-13所示。
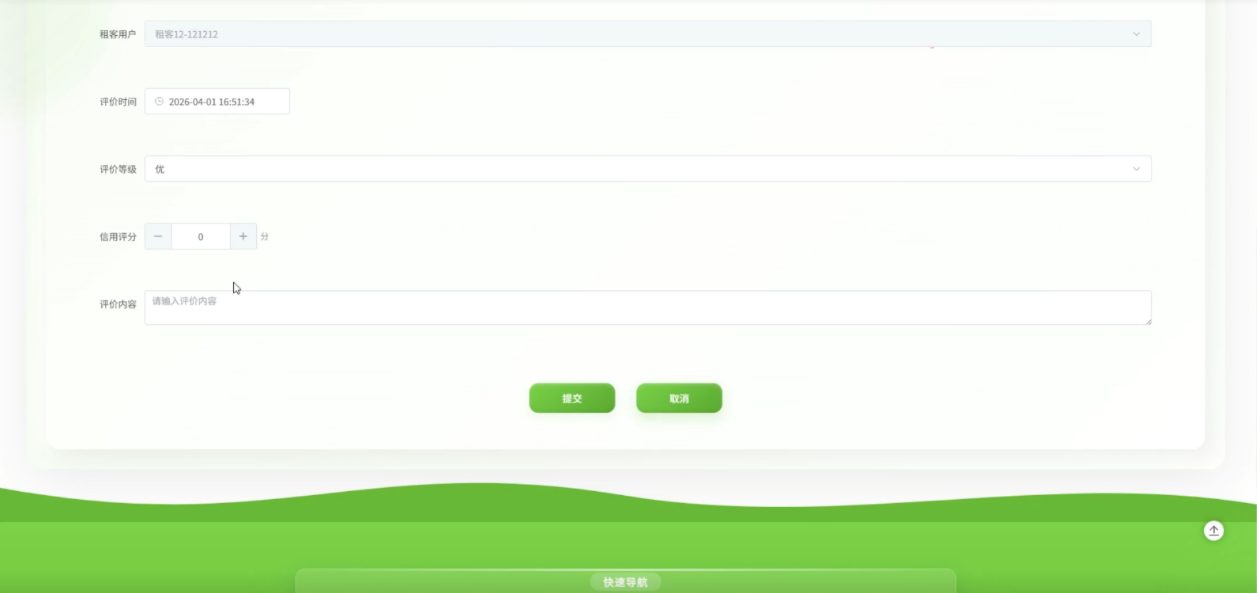
图7-13 信用评价界面
管理员访问系统后台时首先进入登录界面,输入用户名与密码后系统校验账户身份信息。验证通过后跳转至管理主页,连续多次登录失败时账户被临时锁定。登录界面如图7-14所示。
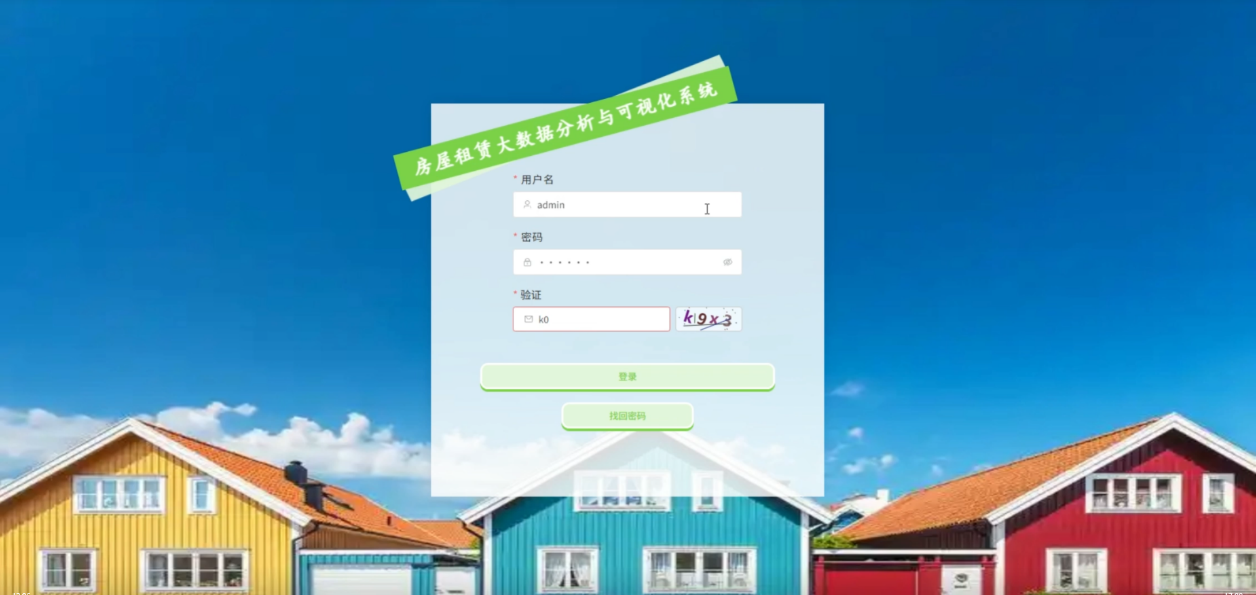
图7-14 登录界面
管理员进入数据分析页面后系统展示房源供需分布圆环图与租金走势折线图,页面支持按月份与城市维度筛选统计数据。管理员导出统计报表用于线下会议汇报,图表数据每五分钟自动刷新一次。数据分析界面如图7-15所示。
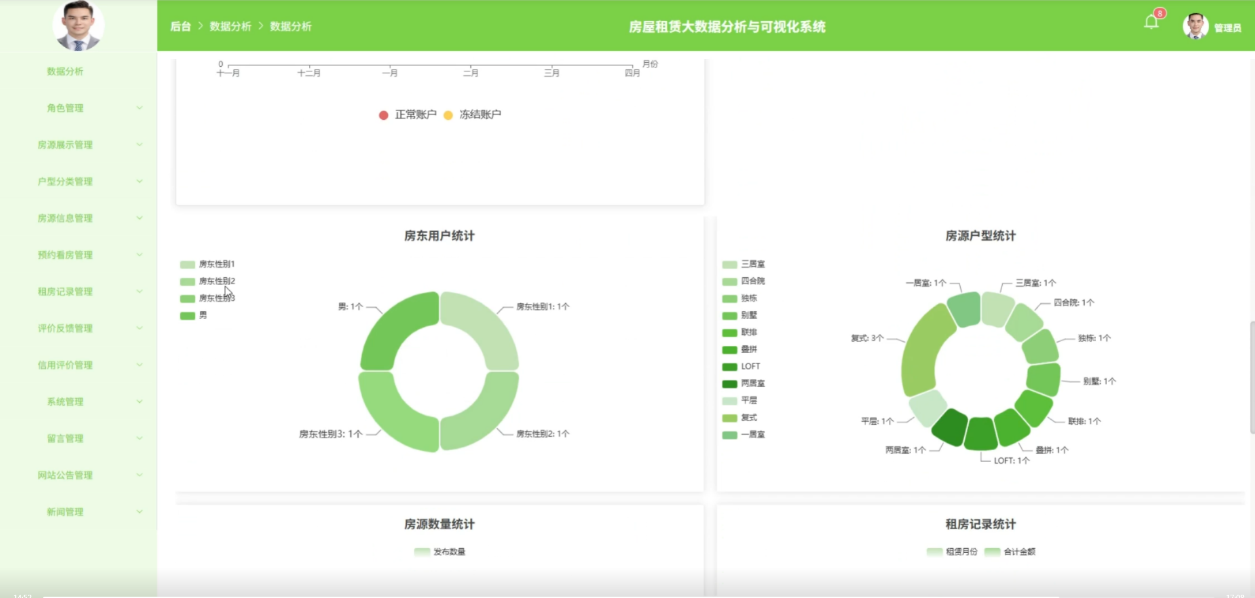
图7-15 数据分析界面
管理员在房源展示管理页面控制哪些房源出现在租客端首页推荐位置,每条房源显示城市与价格信息。管理员设置置顶标志后房源在列表中优先展示,下架操作将房源移出租客浏览范围。房源展示管理界面如图7-16所示。
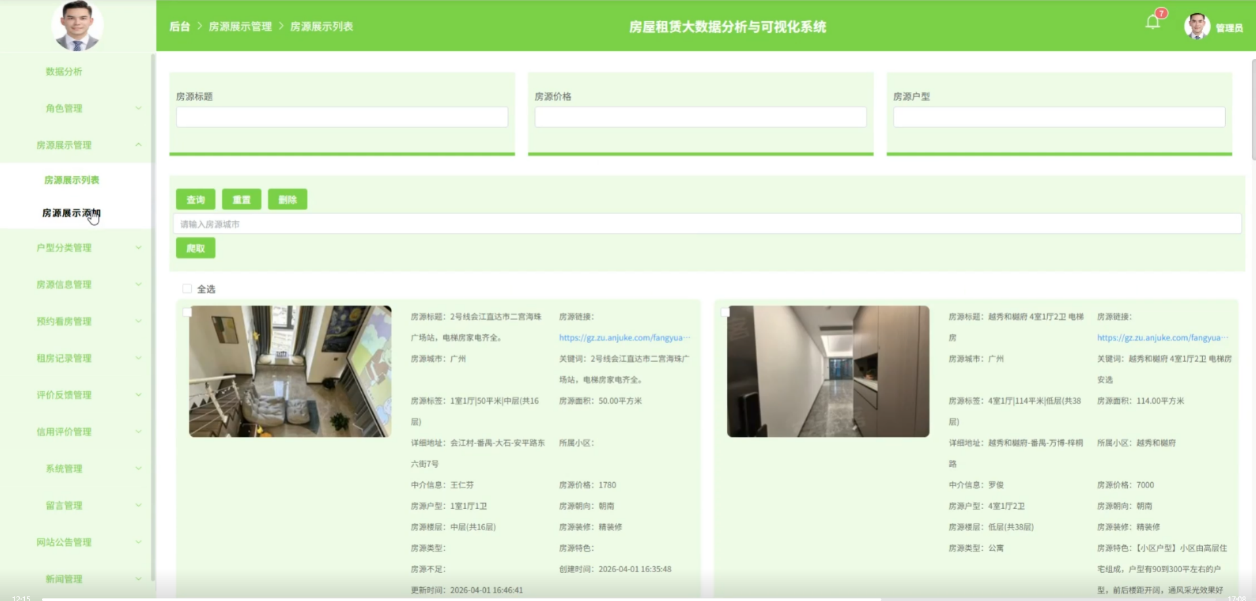
图7-16 房源展示管理界面
管理员进入户型分类管理页面新增或删除户型标签,每条标签包含户型名称与显示顺序数值。管理员调整排序后租客端筛选下拉框同步更新,删除户型前系统检查是否存在关联房源。户型分类管理界面如图7-17所示。
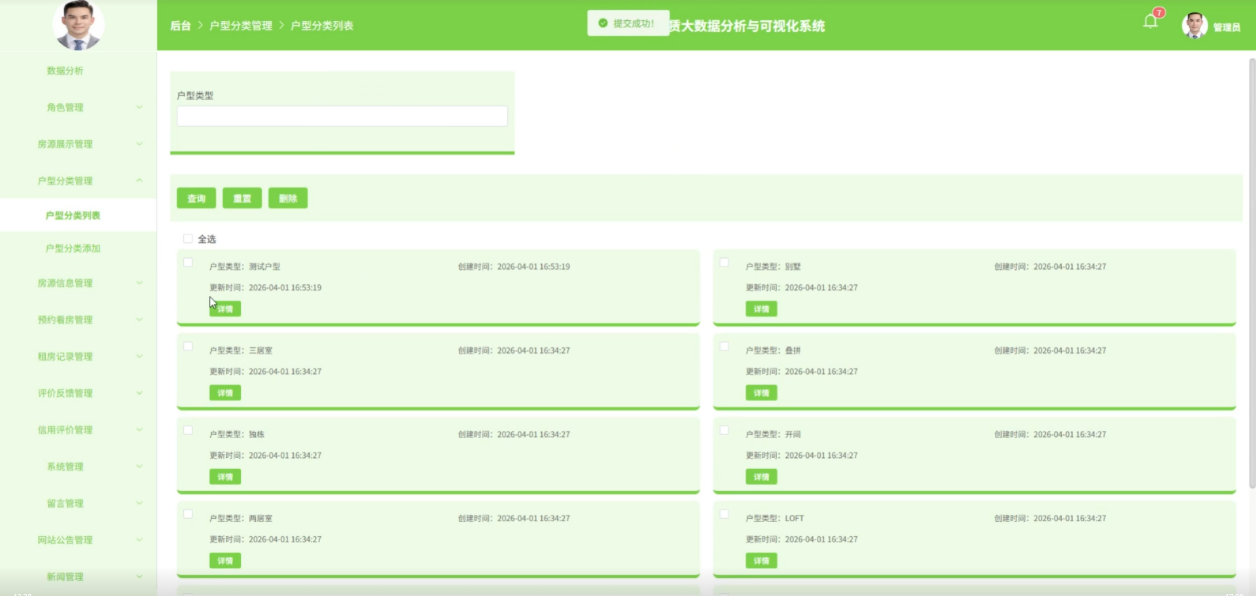
图7-17 户型分类管理界面
管理员在房源信息管理页面查看所有房东提交的房源资料,每条房源显示待审核标签与提交时间。管理员审核通过后房源状态变更为已上架,审核不通过时填写驳回原因退回房东修改。房源信息管理界面如图7-18所示。
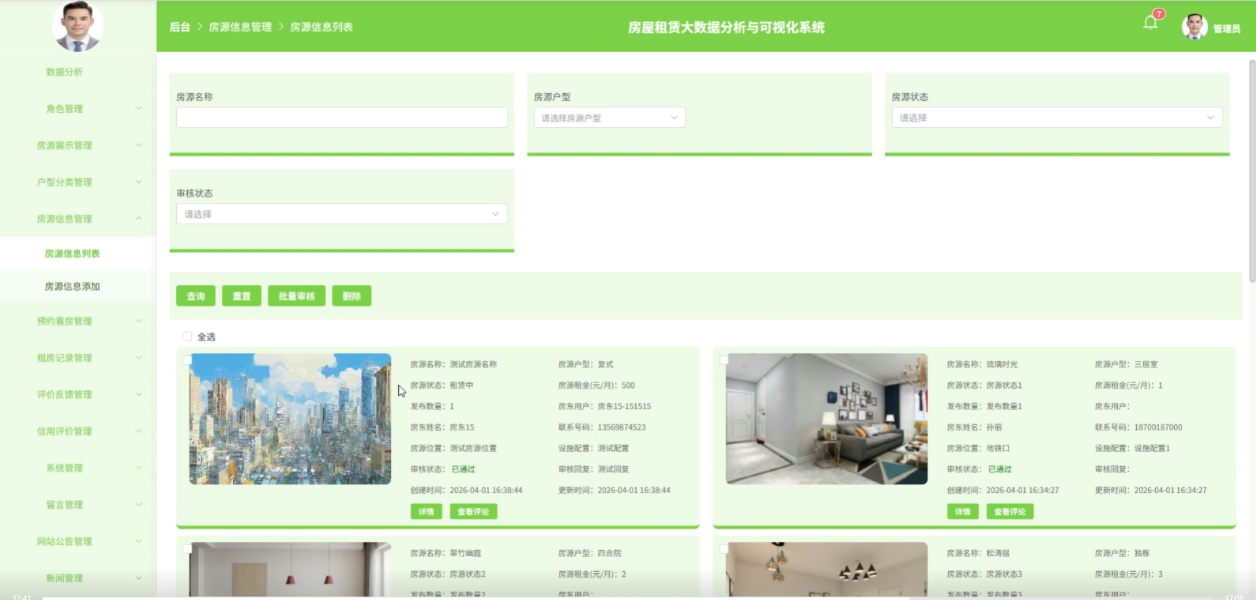
图7-18 房源信息管理界面
管理员进入预约看房管理页面查看全平台所有预约申请记录,页面支持按房源名称与审核状态筛选。管理员发现预约冲突时可以手动调整时间并通知双方用户,异常预约记录被标记后进入复核流程。预约看房管理界面如图7-19所示。
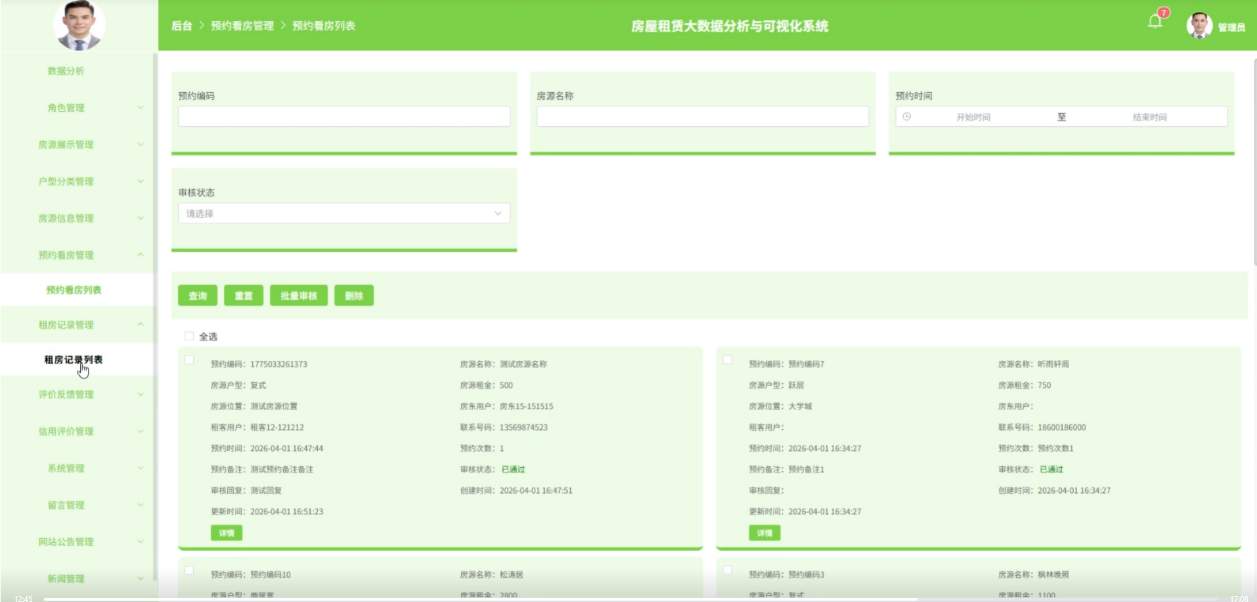
图7-19 预约看房管理界面
管理员在租房记录管理页面浏览所有已完成租赁合同,页面展示合同编号与签约时间信息。管理员可以查看电子合同原件并处理合同纠纷申诉,异常合同记录被标记为争议状态。租房记录管理界面如图7-20所示。
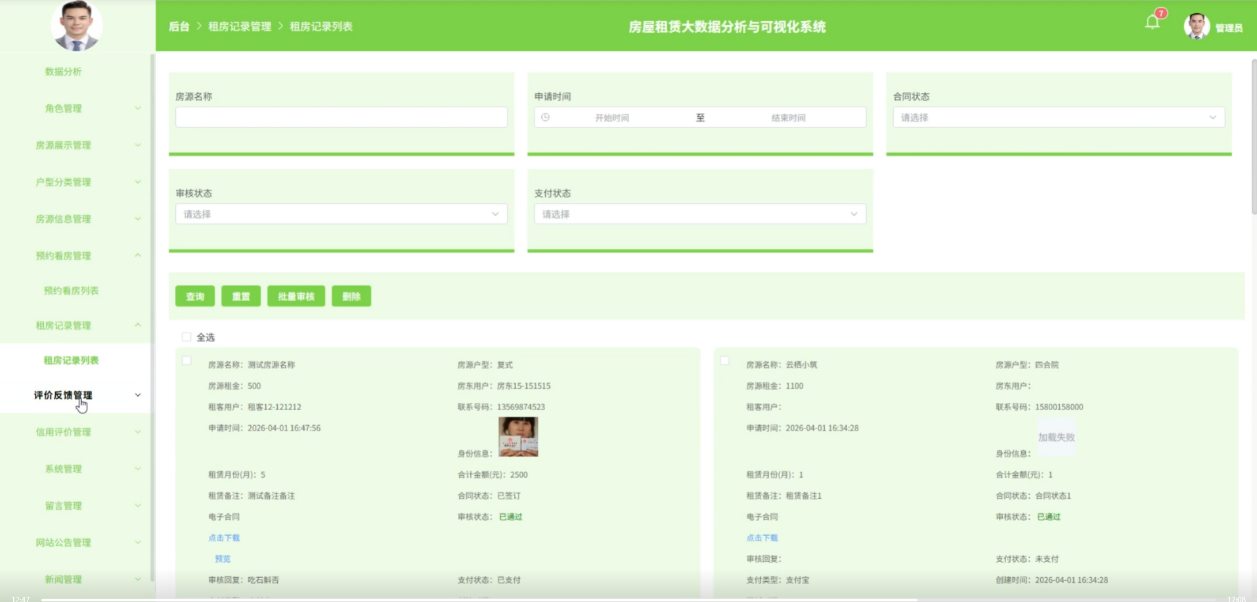
图7-20 租房记录管理界面
管理员进入评价反馈管理页面审核租客提交的所有评价内容,系统高亮显示包含敏感词的评论文本。管理员确认违规后删除该评价并扣除对应房东信用分数,正常评价保留展示。评价反馈管理界面如图7-21所示。
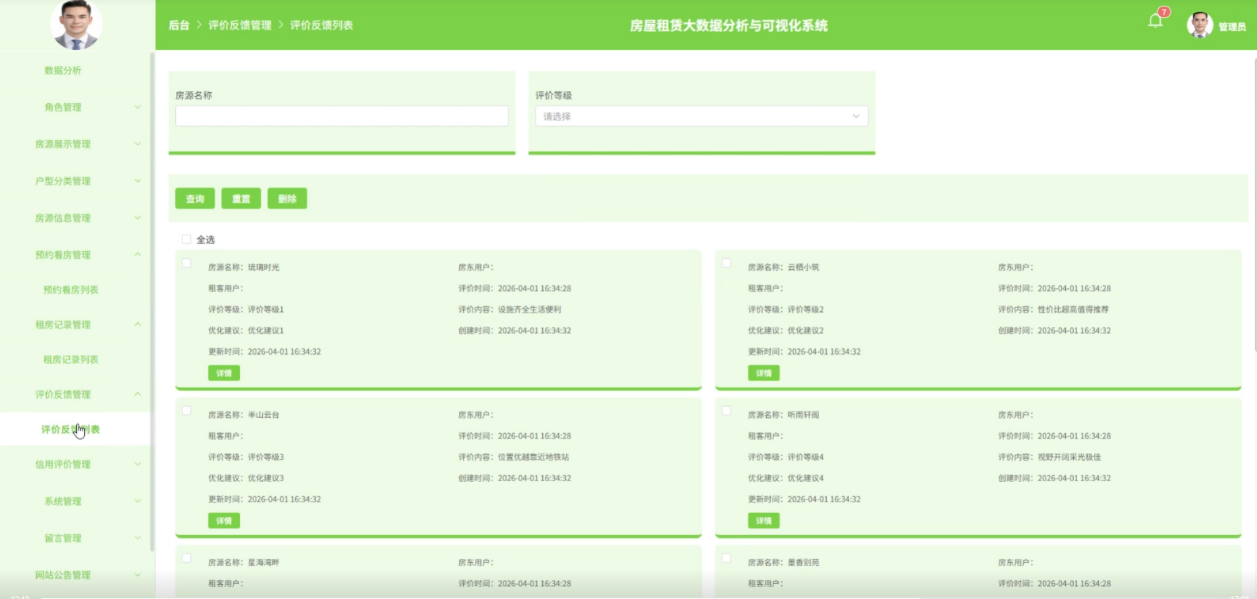
图7-21 评价反馈管理界面
管理员在信用评价管理页面查看所有房东的信用评分历史记录,页面展示评分变化曲线与排名情况。管理员手动调整异常评分并填写调整原因,调整记录存入系统日志备查。信用评价管理界面如图7-22所示。
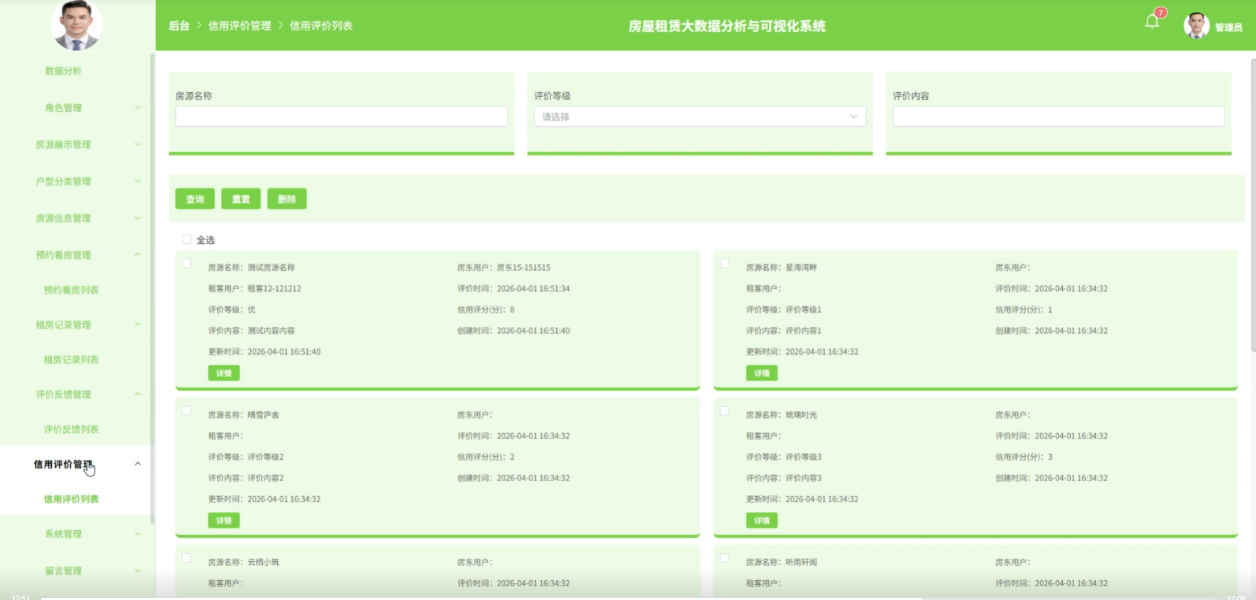
图7-22 信用评价管理界面
管理员进入系统管理页面维护用户账号状态,禁用异常账号或重置用户登录密码。管理员分配不同用户的权限等级,操作日志记录每一次账号状态变更行为。系统管理界面如图7-23所示。
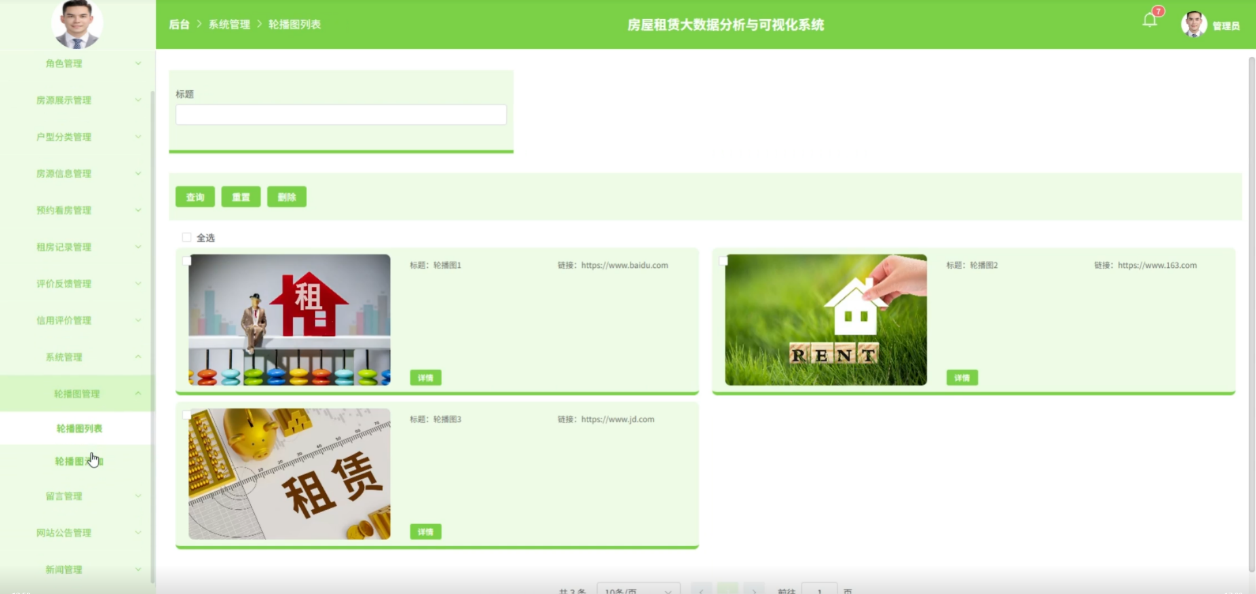
图7-23 系统管理界面
管理员在留言管理页面查看租客与房东提交的留言内容,每条留言显示提交用户与提交时间。管理员回复留言后回复内容同步显示在前端页面,违规留言被直接删除处理。留言管理界面如图7-24所示。
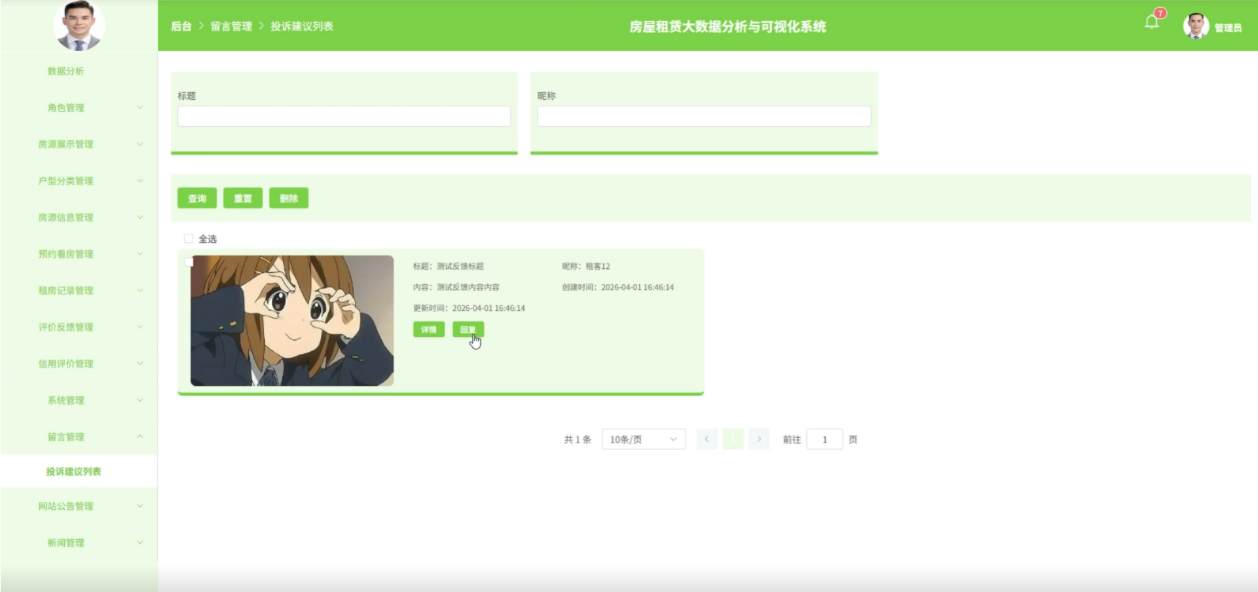
图7-24 留言管理界面
管理员进入网站公告管理页面发布新公告或编辑已有公告内容,公告支持标题与正文分离编辑。管理员设置公告置顶标志后公告显示在首页顶部区域,过期公告被下线处理。网站公告管理界面如图7-25所示。
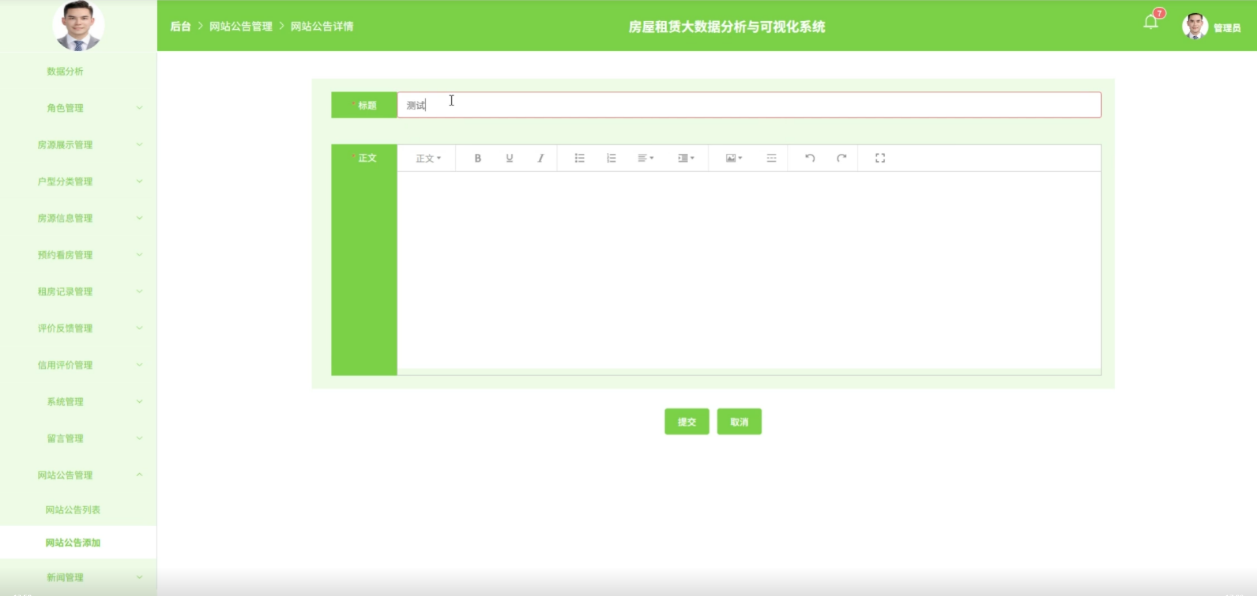
图7-25 网站公告管理界面
管理员在新闻管理页面添加租赁资讯文章,文章包含标题、封面图、正文内容及来源链接。管理员发布后文章出现在租客端租赁资讯模块,过时资讯被归档至历史列表。新闻管理界面如图7-26所示。
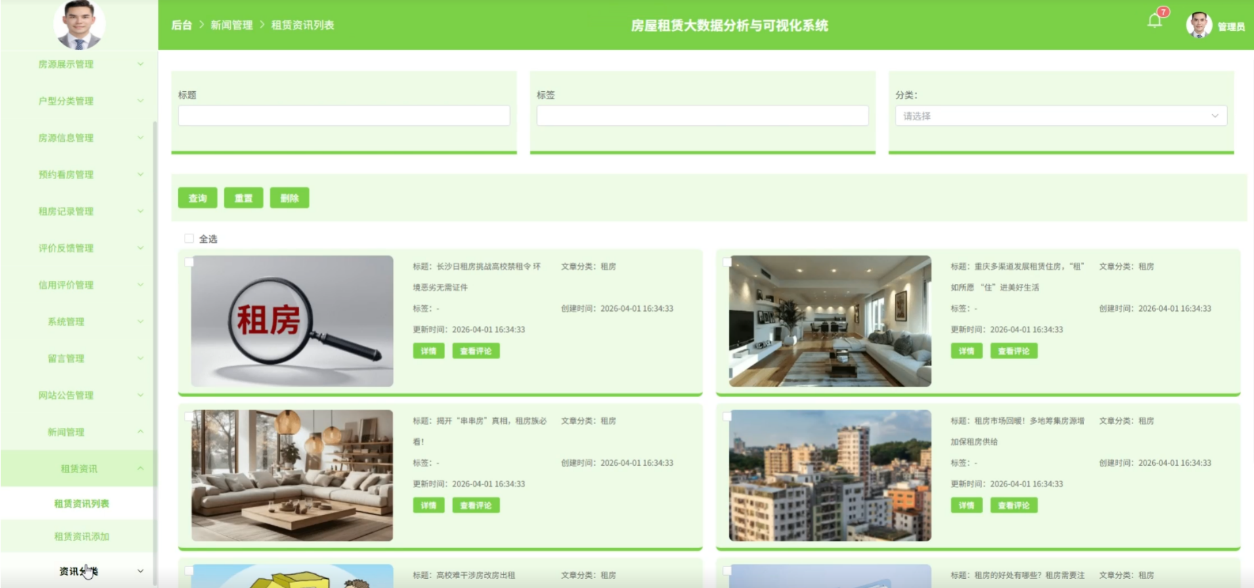
图7-26 新闻管理界面
房屋租赁市场长期存在着房源信息分散、供需对接难、交易信用差等问题。传统的线下中介模式受信息孤岛、人工操作等的限制,不能满足租客对房源透明度以及个性化推荐的需求。本文以房屋租赁大数据分析与可视化为研究目的,设计并实现了包含数据采集、协同过滤推荐、可视化分析、多角色业务管理的综合信息系统。系统用爬虫模块去抓取多平台的房源信息,采用协同过滤算法来产生个性化的推荐清单,依靠ECharts可视化的大屏把租金变动和户型分布情况直观地呈现出来。经过完整的需求分析、系统设计、编码实现和功能测试,本系统达到了预期的设计目的,有效地解决了租赁信息碎片化、选房决策周期长等实际问题。
研究工作是从三个方面展开的。需求分析阶段对租客、房东、管理员三个用户的主要业务场景进行梳理,完成用例建模以及功能划分。系统设计阶段采用前后端分离架构,前端用Vue框架创建响应式界面,后端用Django框架处理业务逻辑,MySQL数据库用来保存数据。编码实现阶段完成爬虫采集模块、协同过滤推荐模块、可视化分析模块以及三个角色功能模块的开发。租客端可以浏览房源、进行在线沟通、预约申请,房东端可以发布房源、审核预约,管理员后台可以对数据进行统计、对用户进行管理。从测试结果可知,本系统的各个功能模块运行正常,推荐的正确率可以达到预期的要求。
目前系统还存在着一些不足。推荐算法仅仅依靠点击次数、编辑距离来进行计算,没有用深度学习模型去准确预测用户喜好。爬虫模块只使用一个数据源接口,上游服务出现不稳定情况的时候采集任务就会停止。可视化分析只停留在基础的统计图表上,并没有对租金预测以及市场趋势进行深入挖掘的能力。系统部署在本地开发环境里,并没有做过大规模并发访问的压力测试。信用评价机制使用简单的评分累加方式,没有对恶意差评进行防御性的校验逻辑。
后续工作可以做以下几个方面的研究。推荐模块可以采用图神经网络协同过滤算法,将租客社交关系和房源地理信息一起考虑进去来提高推荐多样性。爬虫层面创建多源采集容灾机制,当主接口出现故障的时候会自动切换到备用的数据源。数据分析层把时间序列预测模型融合进来,从而达成对租金价格变动走向的智能预估。信用体系用区块链存证技术来保证评价记录不能被篡改。该系统在住房租赁信息化方面有推广意义,其设计思路可以给其他的双边市场平台提供借鉴。
- 欧阳天健. 房屋租赁税的制度解读与优化路径[J].检察风云,2026,(05):19-21.
- 闫萌. 房屋租赁市场的长远发展趋势[J].中国乡镇企业会计,2026,(01):246-248.
- 方鑫. 房屋租赁企业内部控制存在的问题及优化对策[J].创新世界周刊,2026,(01):62-64.
- 李许,李珺,麦宝华,等. 基于网络爬虫和大数据技术的技术性贸易措施应对研究[J].中国口岸科学技术,2025,7(02):10-14.
- 叶芳,方茜. 基于大数据背景下的自动化主题爬虫系统设计[J].电脑编程技巧与维护,2024,(11):3-5+30.
- 于平. 基于大数据的深度学习网络爬虫算法在信息搜集与处理中的应用[J].科技资讯,2024,22(16):55-57.
- 党浩予. 基于Python爬虫技术的网页内容文本大数据提取方法研究[J].电脑与电信,2023,(08):90-93.
- 霍英,李小帆,丘志敏,等. 基于大数据的网络数据采集研究与实践[J].软件工程,2023,26(04):28-32.
- 闫语. 基于网络爬虫的观影大数据采集和分析[J].电子技术与软件工程,2023,(06):238-241.
- 白天瑰. 基于网络爬虫技术的大数据采集系统设计[J].电子技术与软件工程,2022,(21):251-254.
- Wang J ,Fei N ,Wu H , et al. How visual environment affects property prices: nonlinear assessments based on machine learning and street view big data[J].Environmental Research Communications,2026,8(4):045003-045003.
- Grover P S ,Chotia V ,Prakash S , et al. Breaking down barriers: prioritizing big data analytics integration in e-commerce sector[J].Journal of Advances in Management Research,2026,23(2):245-276.
- Karthiga B ,Jasper D ,Sharma N , et al. AI-Powered Big Data Analytics Framework for Automated and Accurate Detection of Intracranial Hemorrhage in Computed Tomography Imaging Using Advanced Deep Learning and Medical Image Processing Techniques[J].International Journal of Pattern Recognition and Artificial Intelligence,2026,(prepublish):
- Gul R . The complementary role of big data and intellectual capital on value co-creation: proposing a value creation framework in information-intensive organizations[J].Qualitative Research in Financial Markets,2026,18(3):621-639.
- Bai S ,Huang X ,Han C , et al. Is beauty important? Exploring the effect of housing agents’ beauty on customers’ online renting decision-making: an AI-based big data analysis[J].Asia Pacific Journal of Marketing and Logistics,2026,38(4):933-948.
- 赵媛.基于Vue的Web系统前端性能优化分析[J].电脑编程技巧与维护,2024,45(9):44-46.
- 李德华,王晓勇.基于Django框架的高效Web开发与性能优化[J].河南财政金融学院学报(自然科学版),2025,34(3):5-11.
- 龚静,邓晨曦.MySQL数据库项目化教程[M].北京:人民邮电出版社,2023:253.
- 张书钦,夏敏捷.Python程序设计应用教程[M].北京:中国铁道出版社,2024:310.
- 杨沁.基于分布式数据库的图书资料管理系统设计[J].自动化应用,2024,65(14):229-231.
在本次项目的完成过程中,我得到了许多人的帮助和支持,在此,我衷心感谢所有给予我帮助的人。
我要感谢我的指导老师,感谢您在我项目每一个阶段的细致指导和建议。每次碰到项目中的难题和挑战的时候,都会耐心地回答我所提出的问题,而且会用详细的讲解来帮助我充分理解相关理论知识与实践经验。您的专业态度与严谨的教学方式,使我在项目中学习到的不仅仅是技能,更是对专业领域更深层次的思考。没有您的指导,这个项目不可能这么顺利的完成。
我要感谢我的同学们,在项目实施过程中,大家和我进行了深入的讨论,分享了自己的想法和经验,让我可以从不同的角度去看待问题,从而帮助我完成任务。虽然该项目是由个人独立完成的,但是与同学们的交流使我获得了许多新的思路和灵感。我也要感谢我的家人,项目研究时我投入了大量的时间和精力,家人在我的背后一直支持着我、包容着我,并鼓励我在遇到困难的时候不要放弃。你们的关爱就是我不断努力和进步的动力源泉。感谢学校提供的优质学习平台和资源,使我能顺利完成项目,达到预期目标。通过本次课业项目,我掌握了相关的专业知识和技能,也培养了独立思考和解决问题的能力。这些收获将会对我今后的学习和成长起到长远的作用。
再次感谢所有在项目中给予我帮助和支持的人,是你们的帮助让我顺利完成了这次项目。
点赞+收藏+关注 → 私信领取本源代码、数据库
更多推荐

 16
 0
- 0


 已为社区贡献11条内容

所有评论(0)