
XTuner 大模型完整微调实战教程(QLoRA 低成本单卡 / 多卡)
·
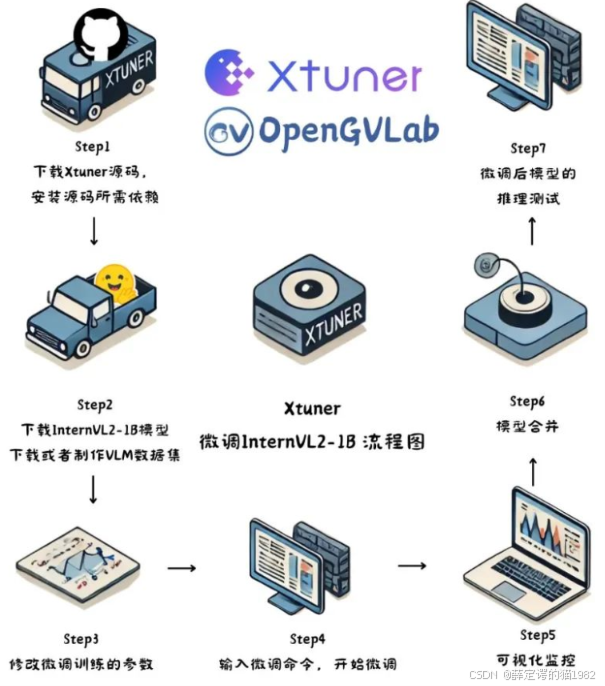
一、XTuner 简介
XTuner 是书生・浦语开源轻量化微调框架,主打 QLoRA 4bit 低成本微调,支持 InternLM、Qwen、Llama3 等主流基座,内置对话模板、训练监控、一键合并权重,兼容单卡 / 多卡 DeepSpeed 分布式,适合个人 24G 显卡微调 7B/13B 模型。
核心优势
- QLoRA 4bit 量化,单 24G 显卡可跑 13B;
- 统一对话数据集标准,适配单 / 多轮指令数据;
- 一键训练、一键合并 LoRA、配套 LMDeploy 推理;
- 原生集成 DeepSpeed,多卡显存分片优化。
二、环境搭建(Python3.10 + CUDA11.8+/12.x)
1. 创建虚拟环境
# 创建环境
conda create -n xtuner python=3.10 -y
conda activate xtuner

# 安装匹配CUDA的Torch(CUDA12.6示例)
pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu126
2. 安装 XTuner(源码完整版,含 DeepSpeed)
# 国内Gitee镜像(GitHub访问失败推荐)
git clone https://gitee.com/Internlm/xtuner.git
cd xtuner
# 全量依赖,包含deepspeed、lmdeploy
pip install -e ".[all]" -i https://mirrors.aliyun.com/pypi/simple/

# 验证安装
xtuner --version
三、数据集标准格式(适配你之前小聚认知数据)
XTuner 标准单轮指令格式(必须该结构,对应你转换后的文件)
[
    {
        "conversation": [
            {
                "input": "你是谁?",
                "output": "我是小聚,由Aron开发的AI助手。"
            }
        ]
    }
]
Alpaca 原始 json → XTuner 标准转换代码
import json

def alpaca2xtuner(alpaca_path, save_path):
    with open(alpaca_path, "r", encoding="utf-8") as f:
        raw_data = json.load(f)
    res = []
    for item in raw_data:
        ins = item["instruction"].strip()
        extra = item["input"].strip()
        ans = item["output"].strip()
        user_q = f"{ins}\n{extra}".strip() if extra else ins
        res.append({
            "conversation": [{"input": user_q, "output": ans}]
        })
    with open(save_path, "w", encoding="utf-8") as f:
        json.dump(res, f, ensure_ascii=False, indent=2)

if __name__ == "__main__":
    alpaca2xtuner("identity.json", "xtuner_identity.json")
四、基座模型准备(以 Qwen2.5-7B-Instruct 为例)
本地存放基座路径:./models/Qwen2.5-7B-Instruct
快速下载(modelscope)
from modelscope import snapshot_download
model_dir = snapshot_download("Qwen/Qwen2.5-7B-Instruct", cache_dir="./models")
五、复制并修改训练配置(QLoRA 4bit 单卡模板)
1. 查看官方预置配置
# 筛选Qwen相关配置
xtuner list-cfg -p qwen
# 复制qlora配置到当前目录
xtuner copy-cfg qwen2_5_7b_qlora_alpaca_e3 ./train_cfg.py
2. 核心配置文件 train_cfg.py 修改(分段注释)
###########################################################################
# PART 1 基础全局参数
###########################################################################
pretrained_model_name_or_path = "./models/Qwen2.5-7B-Instruct"  # 基座路径
data_files = "./xtuner_identity.json"  # XTuner数据集路径
max_length = 1024  # 上下文长度
batch_size = 4  # 单卡批次
accumulative_counts = 2  # 梯度累积,等效batch=8
max_epochs = 5  # 训练轮数,认知数据3-5轮足够
lr = 2e-4  # QLoRA标准学习率

# 训练过程实时测试样例
evaluation_inputs = [
    "你叫什么名字?",
    "是谁开发了你?",
    "Are you ChatGPT?"
]

###########################################################################
# PART 2 QLoRA 配置(显存核心)
###########################################################################
lora = dict(
    type="QLoRAConfig",
    r=8,  # LoRA秩,小认知数据r=8/16足够
    lora_alpha=16,  # 一般r*2
    lora_dropout=0.1,
    bias="none",
    task_type="CAUSAL_LM",
    bits=4,  # 4bit量化,单24G可跑7B/13B
    lora_target_modules=[
        "q_proj", "v_proj", "k_proj", "gate_proj", "up_proj", "down_proj"
    ]  # Qwen专属目标层
)

###########################################################################
# PART 3 数据集加载(固定无需改动)
###########################################################################
dataset = dict(
    type="load_dataset",
    path="json",
    data_files=data_files,
)
dataset_map_fn = None  # 已经是标准格式,不用转换

###########################################################################
# PART 4 训练器、保存策略
###########################################################################
trainer = dict(
    type="SupervisedFinetuneTrainer",
    optim_type="AdamW",
    warmup_ratio=0.05,
    save_steps=100,
    save_total_limit=3,
    output_dir="./work_dirs/qwen7b_xiaoju_lora"
)
六、启动训练
1. 单机单卡(24G 显卡推荐)
xtuner train train_cfg.py
2. 单机多卡(4/8 卡,自动启用 DeepSpeed)
# 使用0、1、2、3四张卡
CUDA_VISIBLE_DEVICES=0,1,2,3 NPROC_PER_NODE=4 xtuner train train_cfg.py
3. 训练输出目录说明
work_dirs/qwen7b_xiaoju_lora/
├── last_checkpoint/       # 最终LoRA权重
│   └── hf/                # HuggingFace格式adapter
│       ├── adapter_config.json
│       └── adapter_model.bin
├── epoch_*.pth            # 每轮权重快照
└── train_cfg.py           # 备份配置
七、训练后操作:LoRA 权重合并完整模型
LoRA 只是小适配器,需要和基座合并才能给 vLLM/LMDeploy/Ollama 部署
# 格式:xtuner convert merge 基座路径 LoRA-hf目录 合并输出目录
xtuner convert merge \
./models/Qwen2.5-7B-Instruct \
./work_dirs/qwen7b_xiaoju_lora/last_checkpoint/hf \
./models/qwen7b_xiaoju_full \
--max-shard-size 2GB
八、两种测试方式
方式 1:直接加载 LoRA 对话(无需合并,快速验证)
xtuner chat ./models/Qwen2.5-7B-Instruct \
--adapter ./work_dirs/qwen7b_xiaoju_lora/last_checkpoint/hf \
--prompt-template qwen2.5
方式 2:合并后 LMDeploy 高性能推理
pip install lmdeploy
# 启动对话
python -m lmdeploy.pytorch.chat ./models/qwen7b_xiaoju_full
# 启动API服务
lmdeploy serve api_server ./models/qwen7b_xiaoju_full --port 8000
九、DeepSpeed 多卡配置扩展(显存不足场景)
修改train_cfg.py末尾添加 deepspeed 配置,ZeRO2 均衡显存速度
deepspeed = dict(
    zero_optimization=dict(
        stage=2,
        offload_optimizer=dict(device="cpu", pin_memory=True),
        overlap_comm=True
    ),
    fp16=dict(enabled="auto"),
    bf16=dict(enabled="auto")
)
十、常见踩坑解决方案
- OOM 显存溢出 降低
batch_size、开启bits=4QLoRA、多卡启用 ZeRO3; - 模型不认识人设,输出错乱 检查数据集格式为
input/output标准结构,训练轮数增加至 5 轮; - 对话模板错位,训练推理不一致 训练与推理
prompt-template必须完全匹配(qwen2.5/llama3 等); - GitHub 拉取 XTuner 超时 切换 Gitee 镜像安装;
- 合并权重报错路径不存在 hf 文件夹必须是
last_checkpoint/hf,不要直接传入 epoch 快照。
十一、硬件选型参考
表格
| 显卡显存 | 支持模型 | 微调方案 |
|---|---|---|
| 16G | 1.8B/3B | QLoRA 4bit,batch=1~2 |
| 24G | 7B/13B | QLoRA 4bit,batch=4~8 |
| 48G + 双卡 | 20B | DeepSpeed ZeRO3 多卡微调 |
更多推荐

 8
 0
- 0


 已为社区贡献15条内容

所有评论(0)