
从 Karpathy 手写 BPE 到 CS336 `train_bpe` 作业实现
从 Karpathy 手写 BPE 到 CS336 train_bpe:一次从 0 到通过测试的实现与优化记录
这篇文章记录的是我完成 CS336 Assignment 1 中
train_bpe的过程。它不是一篇只贴最终答案的文章,而是尽量还原从“能理解 BPE 核心逻辑”到“适配作业要求”,再到“通过测试并做性能优化”的完整路径。
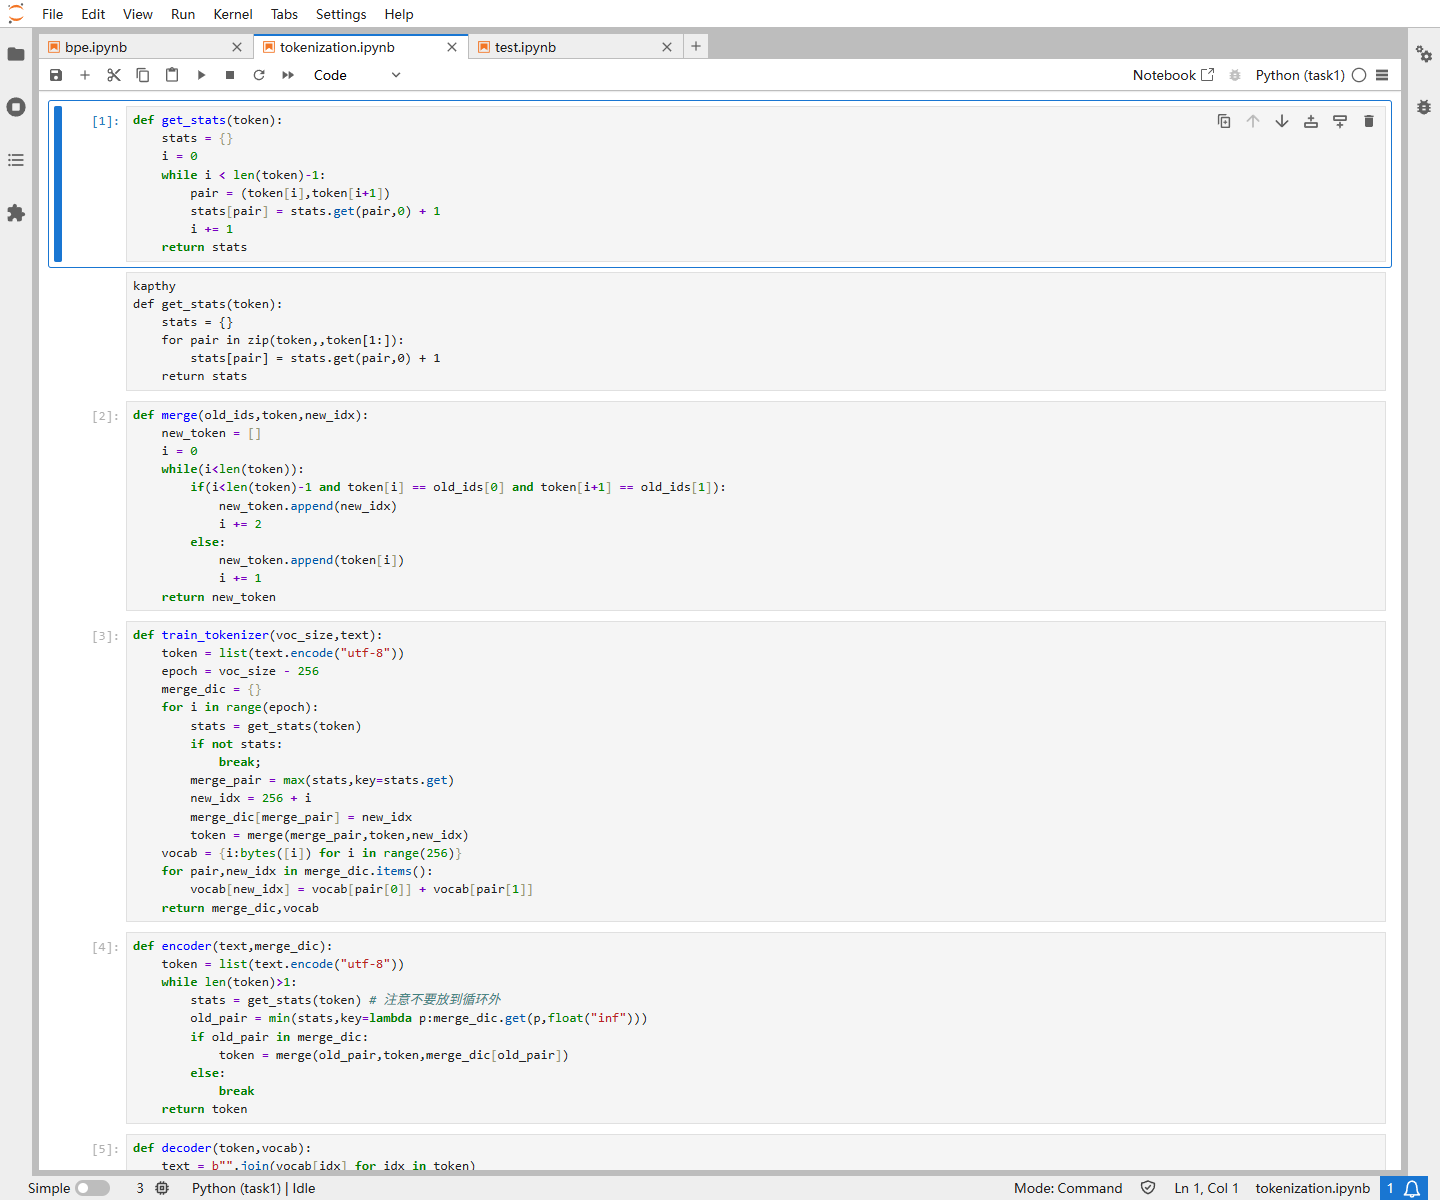
我一开始是跟着 Karpathy 的视频手写 BPE 核心代码:
视频链接:Karpathy 手写 Tokenizer / BPE
Karpathy 的版本非常适合入门,因为它把 BPE 拆成了几个很直观的动作:
- 统计相邻 token pair 出现次数;
- 找到出现次数最高的 pair;
- 把这个 pair 合并成一个新的 token id;
- 重复这个过程,直到 vocab 达到目标大小。
但是 CS336 的作业不是只要求我们写一个“能跑起来的 BPE demo”。它要求输出符合测试接口,处理 special tokens,使用 GPT-2 正则做预分词,并且在 tie-break、vocab、merges 的 bytes 格式上和参考实现保持一致。后面还会遇到速度测试,因此这件事最后变成了一个典型的工程问题:先保证正确性,再用数据找到瓶颈,最后在时间和空间之间做取舍。
1. 从最小 BPE 开始:核心逻辑其实很简单
最小版本的 BPE 可以拆成三个函数。
第一个函数是 get_stats,它统计当前 token 序列里所有相邻 pair 的频率:
def get_stats(token_list):
    stats = {}
    for token in token_list:
        for pair in zip(token, token[1:]):
            stats[pair] = stats.get(pair, 0) + 1
    return stats
第二个函数是 merge,它把指定 pair 替换成新的 token id:
def merge(old_ids, token_list, new_idx):
    new_token_list = []
    for token in token_list:
        new_token = []
        i = 0
        while i < len(token):
            if i < len(token) - 1 and token[i] == old_ids[0] and token[i + 1] == old_ids[1]:
                new_token.append(new_idx)
                i += 2
            else:
                new_token.append(token[i])
                i += 1
        new_token_list.append(new_token)
    return new_token_list
第三步是训练循环:
统计 pair 频率 -> 选择最高频 pair -> 生成新 token id -> merge -> 更新 vocab
这个版本的好处是非常容易理解。它直接对应 BPE 的核心思想:把经常一起出现的相邻 token 合并起来。
但是它还不能直接通过 CS336 的 train_bpe 测试。
2. CS336 作业要求和手写版本的差距
CS336 测试调用的是:
run_train_bpe(input_path, vocab_size, special_tokens)
它要求返回:
vocab: dict[int, bytes]
merges: list[tuple[bytes, bytes]]
这和最小手写版本有几个关键差别。
第一,作业要求根据 special_tokens 分割文本。特殊 token 不能被普通正则切碎,也不能和普通文本跨边界合并。
第二,普通文本还要用 GPT-2 的正则做 pre-tokenization:
gpt2pat = re.compile(
    r"""'s|'t|'re|'ve|'m|'ll|'d| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+"""
)
这里的 pre-token 可以先理解成“还没进入 BPE 合并之前的预切分片段”。它不是最终 token,只是先把文本按 GPT-2 规则切成比较稳定的小块,再进入后面的 merge 过程。
第三,BPE 是 byte-level BPE。基础 vocab 是 0 到 255,每个 id 对应一个单字节:
vocab = {i: bytes([i]) for i in range(256)}
第四,merges 不是 int pair,而是 bytes pair。例如不是:
(97, 98)
而是:
(b"a", b"b")
第五,tie-break 需要按 bytes 比较,而不是按 int token id 比较。
这几个细节看起来都不复杂,但它们会直接影响测试结果。
3. 第一个坑:vocab 和 merges 不能最后才统一转 bytes
我一开始的想法是:训练时先用 int token id,最后再把 vocab 和 merges 统一转成 bytes。这个想法很自然,因为 BPE 的训练过程确实更容易用整数表示。
但后来发现这样会影响 tie-break。
CS336 参考实现要求当两个 pair 出现频率相同时,按照 pair 对应的 bytes 比较。也就是说,选择最高频 pair 时不能只写:
merge_pair = max(stats, key=lambda p: (stats[p], p))
因为这里比较的是 int token id。前面 merge 出来的新 token id 会越来越大,直接比较 int 会和 bytes 级比较不一致。
正确方向是训练过程中同步维护 vocab:
merge_pair = max(stats, key=lambda p: (stats[p], vocab[p[0]], vocab[p[1]]))
这要求每一轮 merge 后立刻更新:
new_idx = 256 + len(special_tokens) + i
vocab[new_idx] = vocab[merge_pair[0]] + vocab[merge_pair[1]]
merges.append((vocab[merge_pair[0]], vocab[merge_pair[1]]))
所以最终训练流程从:
先训练 int merges -> 最后生成 bytes vocab 和 bytes merges
改成了:
选择 pair -> 更新 vocab -> 更新 merges -> 更新 token 序列
这个改动看起来只是顺序调整,但它解决了两个问题:
- 下一轮如果 pair 中包含新 token id,也能找到它对应的 bytes;
merges可以直接保存成测试要求的tuple[bytes, bytes]。
4. 正确性之后真正容易卡住的是 speed test
如果你也是第一次写 Python 版本的 BPE,很可能会经历这样的过程:
核心逻辑写出来了
special_tokens 和 GPT-2 regex 也接上了
vocab / merges 的 bytes 格式也对齐了
普通正确性测试看起来没问题
但一跑 speed test, 发现时间过不了
这是正常的。因为最直观的 BPE 写法,本质上是每一轮都全量扫描:
第 1 步: 遍历所有 token, 统计所有相邻 pair
第 2 步: 遍历所有 pair, 找出现次数最高的 pair
第 3 步: 遍历所有 token, 把最高频 pair merge 成新 token
第 4 步: 进入下一轮, 重复上面三件事
这个写法非常适合理解算法,但不适合直接应对 CS336 的速度测试。
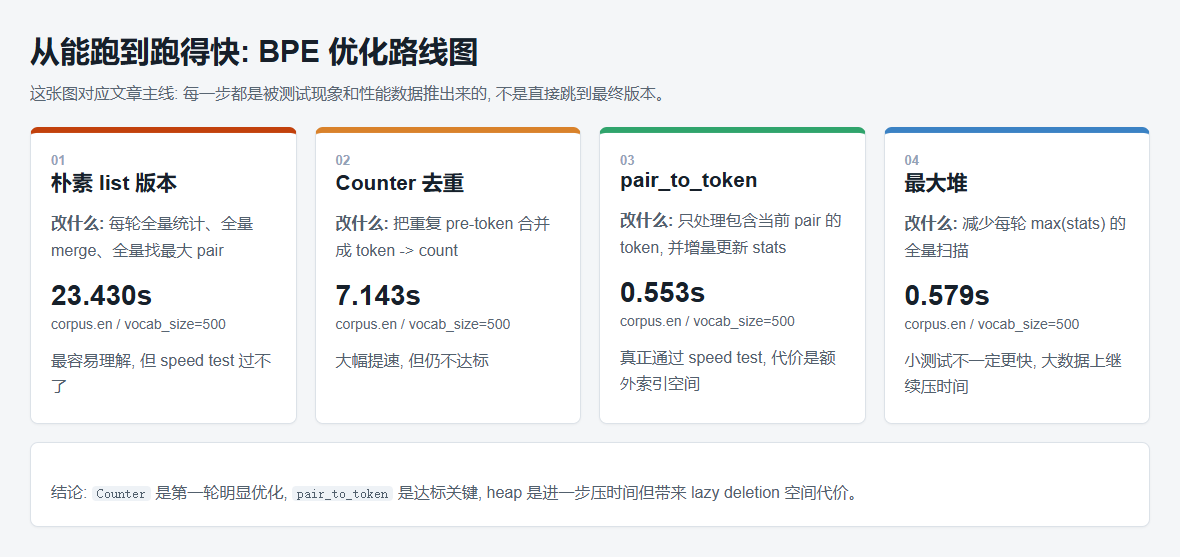
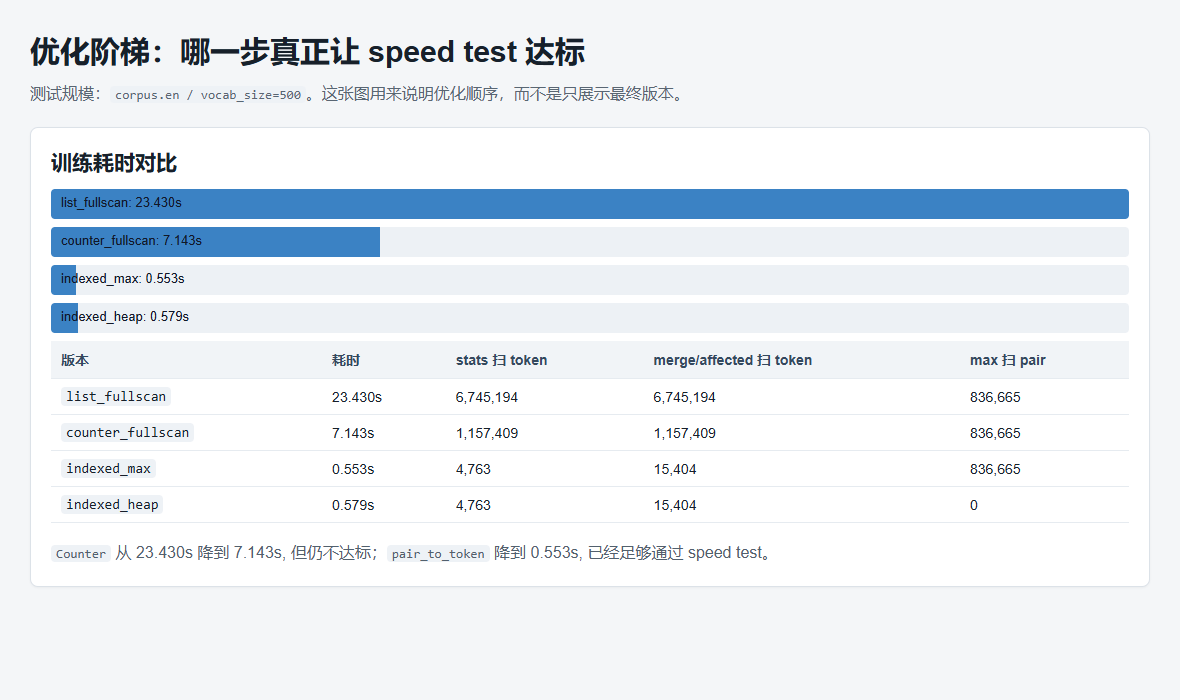
我把几个版本在 corpus.en / vocab_size=500 上做了对比。下面不是 JSON 截图,而是从 benchmark_outputs/corpus_en_500/benchmark_results.json 里摘出来的关键字段:
list_fullscan:    23.430s
counter_fullscan:  7.143s
indexed_max:       0.553s
indexed_heap:      0.579s
这组数值来自 benchmark_outputs/corpus_en_500/benchmark_results.json,这里只保留最关键的 elapsed_sec 字段。
这组数据很重要。它说明优化不是一步到位的:
- 朴素 list 版本最容易写,但最慢;
Counter版本已经明显变快,但仍然不达标;pair_to_token版本才是通过 speed test 的关键;- heap 版本是继续压时间,不是通过测试的必要条件。
术语速查
| 名词 | 含义 |
|---|---|
list_fullscan | 最朴素的版本,pre-token 直接存成 list,每轮都全量扫描。 |
counter_fullscan | 先用 Counter 去重计数,但每轮仍然全量扫描 token。 |
indexed_max | 在 Counter 基础上加 pair_to_token,只处理受影响的 token,但每轮还要用 max(stats) 找最大 pair。 |
indexed_heap | 和 indexed_max 一样,只是把 max(stats) 换成最大堆。 |
tracemalloc | Python 的内存分配跟踪工具,这里看的不是系统总内存,而是训练阶段的 Python 峰值分配。 |
Counter | Python 的计数器字典,token -> count,适合先把重复 pre-token 合并起来。 |
pre-token | GPT-2 正则切出来的预切分片段,还不是最终 BPE token。 |
special_tokens | 需要原样保留的特殊字符串列表,不参与普通切分和合并。 |
vocab | int -> bytes 的词表,记录每个 token id 对应的字节内容。 |
merges | 按创建顺序保存的合并记录,元素是 tuple[bytes, bytes]。 |
stats | 当前所有 pair 的频率字典。 |
pair_to_token | 反向索引,记录某个 pair 出现在哪些 token 里。 |
heap_pushes / heap_pops | heap 里总共 push / pop 了多少次。 |
heap_stale_pops | 弹出来但已经过期、不能再用的 heap 记录。 |
5. 优化前先看数据:为什么会想到 Counter
新手最容易犯的一个错误,是一上来就想改循环、改细节、改下标访问。但在做性能优化之前,最好先问一个问题:数据本身长什么样?
我对 TinyStories 5M 样本做了统计:
total pre-token: 1,263,131
unique pre-token: 8,126
duplicate ratio: 99.36%
再看完整 TinyStories 训练集:
total pre-token: 536,158,470
unique pre-token: 59,887
duplicate ratio: 99.9888%
top_text_tokens[:5]: [(".", 41764510), (",", 23284330), (" the", 20828576), (" and", 19475966), (" a", 15063529)]
这几项是直接从 benchmark_outputs/tinystories_train_full_1000/data_distribution.json 里摘出来的关键字段,不是整段 JSON 截图。
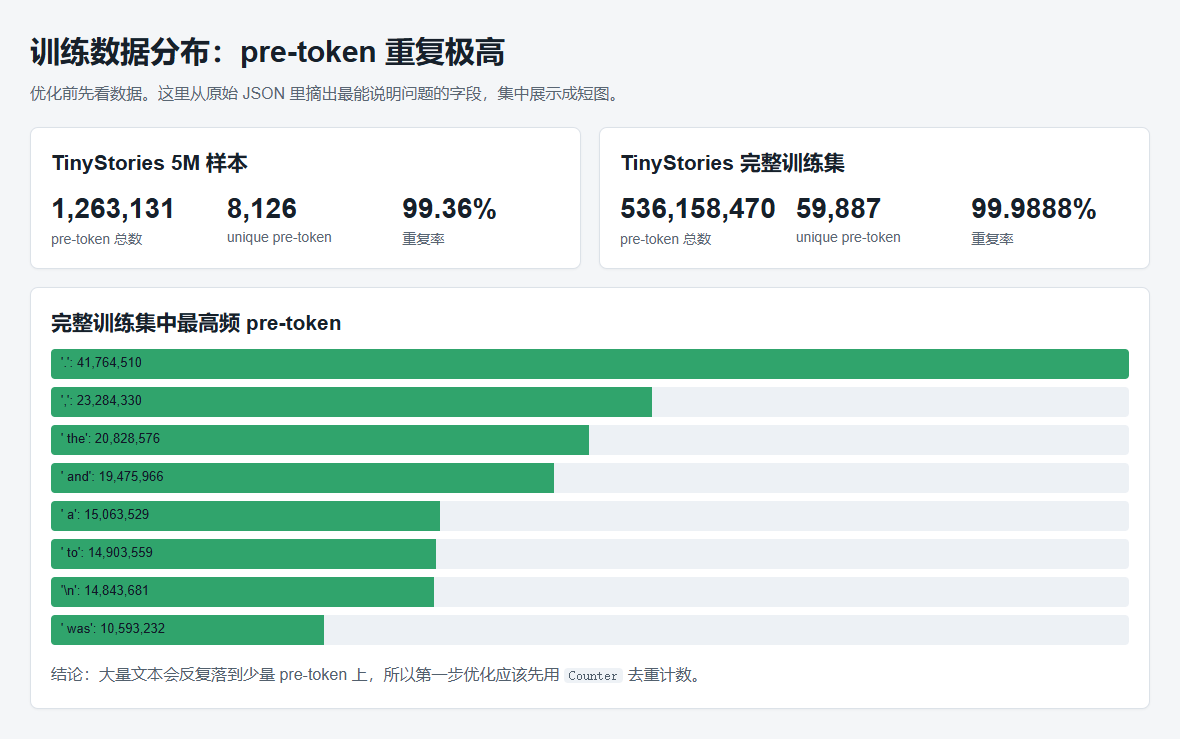
这个结果很直观:pre-token 重复非常多。
如果我们把所有 pre-token 都直接放进列表:
token_list = [tuple(text.encode("utf-8")) for text in new_text_list]
那么像 " the"、" and"、"." 这种高频 token 会被重复处理很多次。每一轮统计 pair 时,它们会重复参与循环;每一轮 merge 时,它们也会重复参与扫描。
所以第一步优化不是上复杂数据结构,而是先把重复 token 合并掉:
unique_token_list = Counter(tuple(text.encode("utf-8")) for text in new_text_list)
Counter 做的事情可以理解成:
原来:
token, token, token, token, ...

现在:
token -> count
之后统计 pair 时,不再把同一个 token 处理很多遍,而是处理一次,然后把它的贡献乘上 count:
def get_stats(unique_token_list):
    stats = {}
    for token, count in unique_token_list.items():
        for pair in zip(token, token[1:]):
            stats[pair] = stats.get(pair, 0) + count
    return stats
这一步优化后的效果是:
list_fullscan:    23.430s
counter_fullscan:  7.143s
这组数值也来自同一个 benchmark 结果文件。
这已经是非常大的提升。但如果目标是 CS336 speed test,它还不够。
这里的关键教训是:Counter 解决了“重复 token 被重复处理”的问题,但没有解决“每一轮仍然要扫描所有 unique token”的问题。
6. 第二步优化:pair_to_token 把全局扫描改成局部扫描
Counter 之后,代码通常会长这样:
for token, count in unique_token_list.items():
    # 看这个 token 里有没有当前 merge_pair
    # 如果有就 merge, 如果没有也得扫过去
问题在于:某一轮选中的 merge_pair 往往只出现在一部分 token 里。
举个例子,当前要 merge 的 pair 是 (97, 98),也就是 bytes 里的 a b。如果某个 token 是:
(120, 121, 122) # xyz
它里面根本没有 (97, 98),这一轮就不可能被修改。继续扫描它只是浪费时间。
所以第二步优化的核心想法是维护一个反向索引:
pair_to_token[pair] = set(tokens)
它表示:某个 pair 出现在哪些 token 里。
例如:
(97, 98, 99)      # abc
(100, 97, 98)     # dab
那么:
pair_to_token[(97, 98)] = {
    (97, 98, 99),
    (100, 97, 98),
}
这样一来,每轮 merge 时就不需要遍历所有 token,而是直接找到受影响 token:
for token in list(pair_to_token[old_ids]):
    ...
这一步最容易写错的地方,是只更新 token,却忘了同步更新 stats 和 pair_to_token。
比如原来有一个 token:
a b c d
如果这一轮把 b c 合并成 x,那么 token 会变成:
a x d
旧 pair:
(a, b), (b, c), (c, d)
都应该从 stats 和 pair_to_token 里减掉。
新 pair:
(a, x), (x, d)
应该加进去。
所以 pair_to_token 优化不是“只少扫几个 token”这么简单,它真正做的是增量维护:
删除旧 token 的 pair 影响
加入新 token 的 pair 影响
更新 token_counts
记录 changed_pairs
做完这一步,速度变化非常明显:
counter_fullscan: 7.143s
indexed_max:      0.553s
也就是说,优化到 pair_to_token 这一步,已经足够通过 CS336 的 speed test。
但是这一步也有代价。我们除了 token_counts,还要额外维护:
stats
pair_to_token
在 corpus.en 上,tracemalloc 观察到的训练阶段峰值内存大致是:
counter_fullscan: 1.70 MB
indexed_max:      4.03 MB
indexed_heap:     6.95 MB
这组数值来自 benchmark_outputs/space_corpus_en_500/space_tradeoff_results.json 的 results 字段。
这里的含义是:
counter_fullscan: 1.70 MB:只维护Counter版本的训练阶段峰值内存;indexed_max: 4.03 MB:额外维护stats和pair_to_token后,峰值内存增加;indexed_heap: 6.95 MB:再额外维护 heap 后,峰值内存继续增加。
所以这里第一次出现了明确的工程取舍:
为了过 speed test, 我们用更多空间换掉了大量重复扫描。
这一步是值得做的,因为它直接解决测试超时问题。
7. 第三步优化:继续盯上 max(stats)
做到 pair_to_token 后,merge 阶段已经很快了。但如果继续 profile,会发现还有一个固定成本:
merge_pair = max(stats, key=lambda p: (stats[p], vocab[p[0]], vocab[p[1]]))
这行代码每一轮都会扫描所有 pair。
在 TinyStories 5M 上,indexed_max 的统计里有一项:
max_pair_scans: 3,668,036
这说明即使我们已经避免了全量扫描 token,找最大 pair 仍然在反复扫描 stats。
于是第三步优化是维护最大堆。
堆里保存的元素是:
(count, vocab[pair[0]], vocab[pair[1]], pair)
前三项就是比较用的 key:
出现次数
第一个 token 的 bytes
第二个 token 的 bytes
最后一项 pair 是真正要 merge 的 int pair。
这里有一个实现选择:
- 可以手写最大堆,练习
push/pop/ 上浮 / 下沉; - 也可以用 Python 标准库
heapq,通过负数或者封装对象模拟最大堆。
我这里手写了最大堆。这样能更清楚地理解堆在做什么,但如果放到生产代码里,我会优先考虑标准库版本,因为更短、更稳定。
在 TinyStories 5M 上,普通 benchmark 的结果是:
counter_fullscan: 32.448s
indexed_max:       2.274s
indexed_heap:      1.714s
在完整 TinyStories 训练集的 merge 训练阶段:
indexed_max:  3.450s
indexed_heap: 2.610s
可以看到,heap 在更大的数据上确实能继续压缩时间。但它不是通过 CS336 speed test 的必要条件,因为 indexed_max 已经可以过。
8. heap 的真实代价:lazy deletion 带来的空间堆积
最大堆优化有一个新问题:stats[pair] 是会变化的。
每次 merge 后,一些 pair 的 count 会减少,一些 pair 会消失,一些新 pair 会出现。理论上我们应该把 heap 里的旧记录也同步更新。但 heap 不擅长“找到任意旧元素并修改它”,如果强行做,代码会复杂很多。
所以我采用了 lazy deletion。
逻辑是:
while heap:
    item = pop(heap)
    pair = item[3]
    if pair in stats and item[0] == stats[pair]:
        merge_pair = pair
        break
也就是说:
新记录直接 push 到 heap
旧记录先留在 heap 里
每次 pop 出堆顶时再检查它是否过期
如果过期, 丢掉并继续 pop
这种方式代码简单,但会留下空间问题:过期记录可能长期堆在 heap 里。
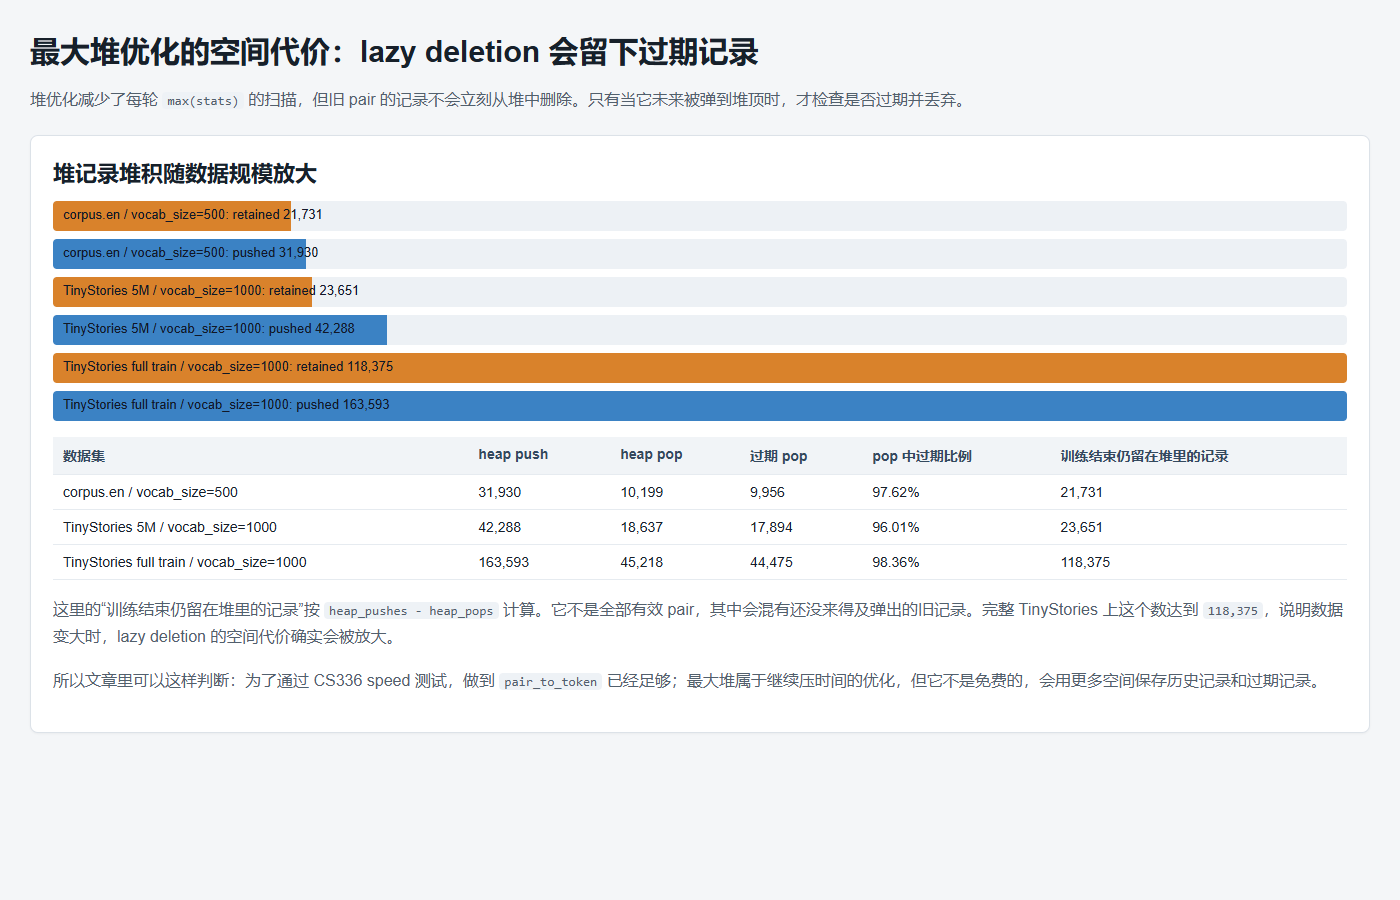
完整 TinyStories 上,heap 相关数据是:
heap_pushes = 163,593
heap_pops = 45,218
heap_stale_pops = 44,475
训练结束仍留在堆里的记录 = 118,375
这些值来自 benchmark_outputs/heap_accumulation_summary.json,我这里只保留了最关键的几个字段。
其中:
训练结束仍留在堆里的记录 = heap_pushes - heap_pops
这几个字段可以这样理解:
heap_pushes:训练过程中一共往 heap 里放入了多少条候选 pair 记录;heap_pops:训练过程中一共从 heap 顶部弹出了多少条记录;heap_stale_pops:弹出来之后发现已经过期的记录,也就是它的 count 已经和当前stats[pair]对不上;heap_pushes - heap_pops:训练结束时还留在 heap 里的记录数,其中可能混有还没来得及弹出的旧记录。
这些留在 heap 里的记录不一定都是有效 pair,里面会混有还没来得及弹出的旧记录。
这就是 heap 优化的空间 trade-off。
所以这里的结论不能写成“heap 一定更好”,而应该写成:
为了通过 CS336 speed test, pair_to_token 已经足够。
如果还想进一步压缩 max(stats) 的时间, 可以引入 heap。
但 heap + lazy deletion 会把一部分旧记录长期留在堆里, 数据集越大, 这个空间代价越明显。
这个判断比“代码又快了一点”更重要。
9. 最后再看完整训练集:瓶颈已经转移到预分词
当 merge 阶段从几十秒降到几秒级后,再继续只盯着 merge 循环,收益会越来越小。
我又对完整 TinyStories 训练集做了预分词阶段的 profile:
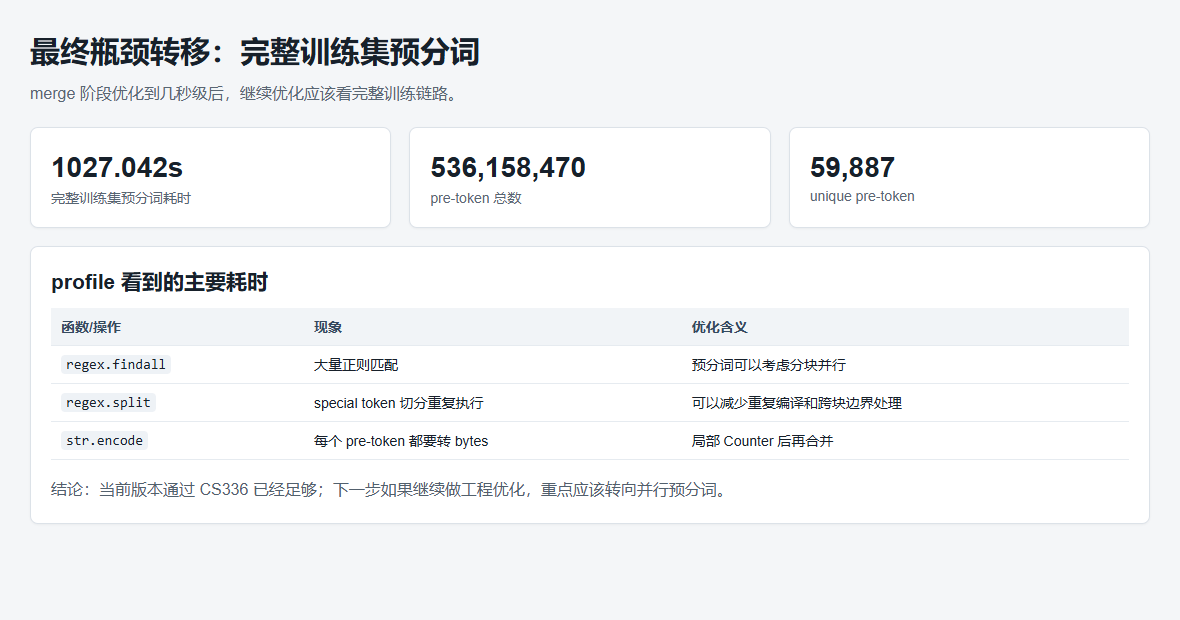
结果:
完整训练集预分词耗时: 1027.042s
function calls: 1,426,132,856
total pre-token: 536,158,470
unique pre-token: 59,887
这组数值来自 benchmark_outputs/pretokenize_full_train/pretokenize_full_train_summary.json 和对应的 pstats 结果。
主要耗时集中在:
regex findall
regex split
str.encode
这说明优化过程进入了下一阶段:merge 训练已经不是主要瓶颈,真正慢的是读取文本、special token 切分、GPT-2 正则预分词和编码统计。
如果继续做下一步优化,我会优先考虑:
- 分块读取训练文件;
- 多进程做 GPT-2 正则预分词;
- 每个进程局部统计 Counter;
- 最后合并各个 Counter。
这部分我没有继续展开,因为当前目标是完成 CS336 train_bpe,而不是实现一个生产级 tokenizer trainer。
10. 最终结果
最终 tests/test_train_bpe.py 三个测试全部通过:
tests/test_train_bpe.py::test_train_bpe_speed PASSED
tests/test_train_bpe.py::test_train_bpe PASSED
tests/test_train_bpe.py::test_train_bpe_special_tokens PASSED

3 passed in 1.68s
完整代码仓库:
https://github.com/hurrypeter02-cmd/assignment1-basics-main
11. 最终代码
下面是最终通过测试版本的核心代码。为了方便阅读,我把注释整理成了正常中文;代码逻辑和当前实现保持一致。
import regex as re
from collections import Counter,defaultdict


def better(value1,value2):
    return value1[:3]>value2[:3]

def push(heap,ct_vcabs_pairs):
    heap.append(ct_vcabs_pairs)
    son = len(heap)-1
    father = (son-1)//2
    while son>0:
        if better(heap[son],heap[father]):
            tmp = heap[father]
            heap[father] = heap[son]
            heap[son] = tmp
            son = father
            father = (son-1)//2
        else:
            break
def pop(heap):
    if not heap:
        return None
    max_value = heap[0]
    last = heap.pop()
    if not heap:
        return max_value
    heap[0] = last
    father = 0
    son1 = 2*father + 1
    son2 = 2*father + 2
    son = son2 if son1<len(heap) and son2<len(heap) and not better(heap[son1],heap[son2]) else son1
    # son 取 son1 的情况下可能越界,此时无需 pop ,直接返回即可,下面的 while 循环条件恰好帮助进行了条件筛选
    while son<len(heap):
        if better(heap[son],heap[father]):
            tmp = heap[father]
            heap[father] = heap[son]
            heap[son] = tmp
            father = son
            son1 = 2*father + 1
            son2 = 2*father + 2
            son = son2 if son1<len(heap) and son2<len(heap) and not better(heap[son1],heap[son2]) else son1
        else:
            break
    return max_value
def init_heap(stats,vocab):
    heap = []
    for pair,count in stats.items():
        push(heap,(count,vocab[pair[0]],vocab[pair[1]],pair))
    return heap
# 优化代码:merge_pair = max(stats,key=lambda p:(stats[p],vocab[p[0]],vocab[p[1]]))

def get_stats(unique_token_list):
    stats = {}
    pair_to_token = defaultdict(set)
    for token,count in unique_token_list.items():
        for pair in zip(token,token[1:]):
            stats[pair] = stats.get(pair,0) + count
            pair_to_token[pair].add(token)
    return stats,pair_to_token # 方便后续 merge 或者 get_stats 不用遍历全局 token ,只需要遍历出现 pair 的 token

def merge(old_ids,unique_token_list,new_idx,stats,pair_to_token):
    old_idx1, old_idx2 = old_ids
    changed_pairs = set()
    for token in list(pair_to_token[old_ids]):
        if not token:
            continue
        new_token = []
        count = unique_token_list[token]
        i = 0
        while(i<len(token)):
            if(i<len(token)-1 and token[i] == old_idx1 and token[i+1] == old_idx2):
                new_token.append(new_idx)
                i += 2
            else:
                new_token.append(token[i])
                i += 1
        # 更新 affected_token
        for pair in zip(token,token[1:]):
            stats[pair] -= count
            changed_pairs.add(pair)
            if stats[pair] <= 0:
                del stats[pair]
            pair_to_token[pair].discard(token)
            if not pair_to_token[pair]:
                del pair_to_token[pair]
        # 删除旧 token 痕迹
        for pair in zip(new_token,new_token[1:]):
            stats[pair] = stats.get(pair,0) + count
            changed_pairs.add(pair)
            pair_to_token[pair].add(tuple(new_token))
        del unique_token_list[token]
        unique_token_list[tuple(new_token)] += count
        # 更新 相关变量
    return unique_token_list,stats,pair_to_token,changed_pairs

def run_train_bpe(input_path,vocab_size,special_tokens):
    with open(input_path,'r',encoding='utf-8') as f:
        text = f.read()
    new_st = []
    for st in special_tokens:
        st = re.escape(st)
        new_st.append(st)
    split_parten = "|".join(new_st)
    text_list = re.split(split_parten,text)
    new_text_list =  []
    gpt2pat = re.compile(r"""'s|'t|'re|'ve|'m|'ll|'d| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+""")
    for text in text_list:
        new_text_list.extend(re.findall(gpt2pat, text))
    # 根据 special_tokens 和 GPT-2 正则进行预分词, 不同 pre-token 之间不能合并

    unique_token_list = Counter(tuple(text.encode("utf-8")) for text in new_text_list)
    # 将去重后的 text 转换成 token tuple, 并用 Counter 统计重复次数

    vocab = {i:bytes([i]) for i in range(256)}
    for i,st in enumerate(special_tokens):
        vocab[i+256] = st.encode("utf-8")
    # 初始化 vocab, 基础字节 token 是 0-255, special_tokens 接在后面

    epoch = vocab_size - 256 - len(special_tokens)
    merge_dic = []
    stats = {}
    for i in range(epoch):
        if not unique_token_list:
            break;
        if not stats:
            stats,pair_to_token = get_stats(unique_token_list)
            heap = init_heap(stats,vocab)

        merge_pair = ()
        while(heap):
            ct_vcabs_pairs = pop(heap)
            pair = ct_vcabs_pairs[3]
            if ct_vcabs_pairs and pair in stats and ct_vcabs_pairs[0] == stats[pair]:
                merge_pair = ct_vcabs_pairs[3]
                break
        # 懒更新 heap 最大堆,O(1) 时间返回 最大 count 的 pair

        new_idx = 256 + len(special_tokens) + i
        vocab[new_idx] = vocab[merge_pair[0]] + vocab[merge_pair[1]]
        merge_dic.append((vocab[merge_pair[0]],vocab[merge_pair[1]]))

        unique_token_list,stats,pair_to_token,changed_pairs = merge(merge_pair,unique_token_list,new_idx,stats,pair_to_token)
        # 增量更新 stats ,同时维护 pair_to_token

        for pair in changed_pairs:
            if pair in stats:
                push(heap,(stats[pair],vocab[pair[0]],vocab[pair[1]],pair))
        # 维护更新 heap 最大堆

    # vocab 和 merges 在训练过程中同步维护, 保证 tie-break 能按 bytes 比较, 并直接得到测试要求的 bytes merges
    return vocab,merge_dic
12. 总结
这次实现 train_bpe,最有价值的不是最后那份代码,而是中间这些判断:
第一,算法 demo 和作业实现不是一回事。BPE 核心逻辑很短,但真正通过测试还需要处理接口、special tokens、GPT-2 regex、bytes 输出和 tie-break。
第二,性能优化要先看数据。TinyStories 的 pre-token 重复率非常高,所以 Counter 去重是自然的第一步。
第三,pair_to_token 是通过 speed 测试的关键。它用额外空间建立反向索引,把每轮全量遍历改成局部更新。
第四,最大堆不是必要优化。它能进一步减少 max(stats) 的扫描,但 lazy deletion 会留下过期记录,数据集越大,堆里的历史记录越明显。
第五,当 merge 阶段优化到几秒级后,瓶颈会转移到预分词。下一步真正值得做的是并行预分词,而不是继续只优化 merge 循环。
13. 反思
为什么 GPT2、CS336,都是byte-level ?
换句话说,为什么 merge_dic 不存 (id1,id2)—> new id,为什么 vocab 不存 id —> (id1,id2) ?
- 使用 int ,显然占用内存大了
- 使用 int ,decode 会触发递归调用,不够快,不够直观
更多推荐


 7
 0
- 0


 已为社区贡献10条内容

所有评论(0)